Пределы оптоволокна: Эпизод I. Скрытая математика
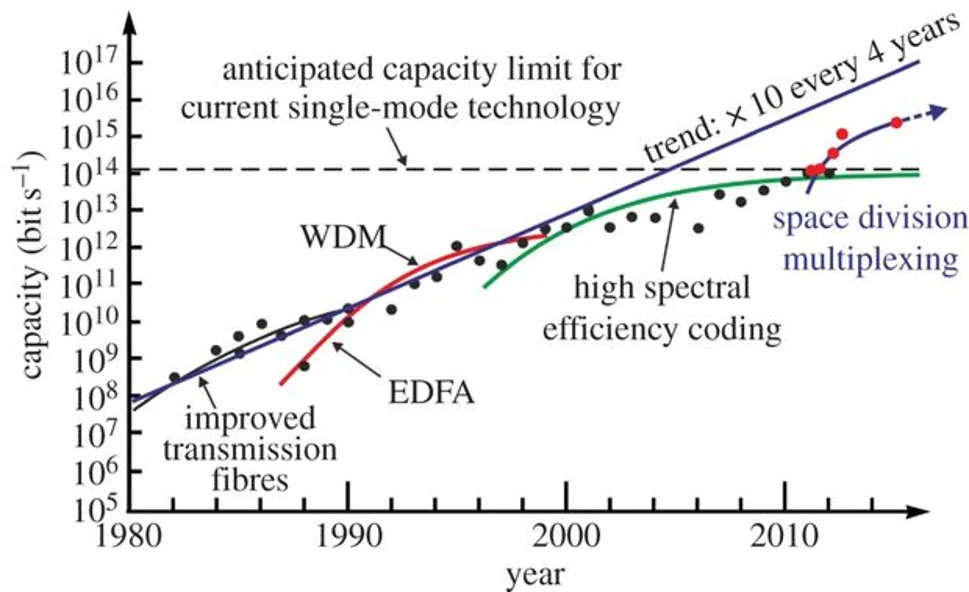
Динамика роста скорости передачи данных в оптоволокне [1]. Точки на графике отражают рекордные показатели, продемонстрированные на OFC — главной профильной конференции исследователей, посвятивших себя изучению передачи информации сквозь стекло.
Многие наслышаны об оптоволокне как о фундаментальной основе магистральных каналов связи (желающие досконально изучить принцип его работы могут ознакомиться с превосходным ликбезом). По трансокеанским световодам круглосуточно циркулируют зетабайты анимаций с котиками и контента, сгенерированного искусственным интеллектом, причем вероятность возникновения ошибки при передаче бита удерживается на астрономически низком уровне 10^-10 — проще говоря, один сбой приходится примерно на гигабайт информации. Разумеется, потребность в наращивании пропускной способности неумолимо возрастает, породив собственный аналог закона Мура для оптоволоконных систем: пропускная способность удваивается или даже удесятеряется каждые четыре года. Данная серия публикаций посвящена исследованию физических и теоретических барьеров скорости передачи данных в световодах, оценке их предельных значений и возможности преодоления этих ограничений на практике.
TL;DR
Никакого финала пока нет, так как цикл статей находится в процессе написания, и развязка последует позже.
Дисклеймер: автор не претендует на абсолютную академическую точность, ставя своей задачей интуитивно понятное объяснение фундаментальных концепций «на пальцах» и с привлечением базового математического аппарата для формирования четкого представления о теоретических и физических барьерах.
Как уже отмечалось, скоростные показатели устремляются вверх с впечатляющей динамикой. Наглядное подтверждение тому — представленный ниже график лабораторных рекордов. Разумеется, триумф в стенах научно-исследовательской лаборатории не означает, что рядовой абонент сможет подключить гигабитный тариф нового поколения уже на следующий день: путь от экспериментального образца до коммерческой эксплуатации преграждают долгие годы оптимизации, разработки протоколов, стандартизации и прочих рутинных процедур.
Каким же образом достигаются столь колоссальные скорости? Представьте, что перед вами стоит задача переслать файл по оптическому каналу с максимально возможной оперативностью. Какие рычаги оптимизации имеются в вашем распоряжении? На практике их насчитывается всего три с половиной:
-
Предварительное сжатие файла — очевидно, что распаковка архива сокращает объем передаваемого трафика. Однако этот аспект лежит вне плоскости физических ограничений самого оптоволокна, поэтому при расчете пропускной способности канала мы его опускаем.
-
Увеличение плотности информации, приходящейся на один символ,
 (понятие символа мы детально разберем далее).
-
Наращивание частоты следования символов, то есть количества передаваемых в секунду единиц,
 .
-
Задействование параллельных независимых каналов в количестве
 штук.
С учетом сказанного результирующая скорость передачи выражается формулой:

Мы последовательно разберем каждый из компонентов; в текущем материале мы сфокусируемся на первых двух факторах и обсудим классические теоремы Шеннона для каналов, свободных от шумов и подверженных помехам.
Как измерить информацию?
Прежде всего необходимо выработать единое понимание того, что именно представляет собой информация в рамках теории связи и какими методами ее можно измерить. Исчерпывающий ответ на этот вопрос дал Клод Шеннон в своей эпохальной работе «Математическая теория связи» (к слову, его диссертация также отличается исключительной доступностью изложения). Он предложил следующую абстрактную модель: имеется стохастический источник, заданный конечным набором возможных исходов (образующих алфавит, где каждый элемент выступает в роли отдельного символа) и вероятностями их появления  . Предполагается, что выбор каждого нового символа статистически независим от предыстории. Приемное устройство, в свою очередь, способно безошибочно идентифицировать любой символ принятого алфавита.
В рамках такой парадигмы Шеннон трактовал информацию как меру рассеяния неопределенности. Поскольку процесс измерения однозначно фиксирует полученный символ, уровень неопределенности падает до нуля, а значит, объем извлеченной информации в точности равен исходной неопределенности. Задача свелась к математической оценке этой меры, известной как информационная энтропия. Сформируем интуитивно оправданные требования к целевой функции  , определяющей среднее количество неопределенности на один символ:
-
Функционал не должен зависеть от материального носителя алфавита. Иными словами, величина
 инвариантна к тому, кодируется ли сообщение знаками рукописного текста или уровнями электрического напряжения -5, 0 и 5 вольт при идентичном распределении вероятностей
 .
-
Мера должна быть непрерывной функцией от вероятностей
 : малейшие вариации в распределении обязаны приводить к столь же незначительным изменениям энтропии. Данное требование критически важно для корректного распространения модели на случай иррациональных вероятностей.
-
При равной вероятности исходов расширение алфавита должно увеличивать энтропию. В качестве предельного случая рассмотрим односимвольный алфавит: он абсолютно бессодержателен, поскольку адресат заранее знает поступающий знак, и никакой новой информации не возникает. Двухсимвольный алфавит уже несет ненулевой объем информации, так как исход предсказать нельзя.
-
Отойдем от сухой академической формулировки в пользу более прозрачного аналога. Энтропия сообщения не должна измениться, если исходный алфавит перекодировать в новый при условии сохранения взаимно однозначного соответствия. Например, имея базовый алфавит «а» и «б», можно составить производный: аа=А, аб=Б, ба=В, бб=Г. Замена символов исходного текста новыми знаками не уничтожит старую информацию и не породит никакой принципиально новой.
Сформированная система требований оказалась на редкость элегантной и жесткой: этим критериям удовлетворяет единственное семейство математических функций:

Множитель перед суммой носит произвольный характер и отражает лишь выбор единиц измерения, фактически позволяя менять основание логарифма:

Классическими основаниями выступают:
-
число Эйлера, измеряющее энтропию в натах;
-
двойка, соответствующая измерению в битах.
Наибольшее распространение получил бит, поскольку он отражает бинарный выбор и обладает наглядной физической интерпретацией: энтропия задает нижний предел среднего числа вопросов в формате «да/нет», которые необходимо задать для определения результата измерения.
В качестве примера рассмотрим алфавит {A: 0.1, B: 0.1, C: 0.4, D: 0.4}. Его энтропия составляет примерно **1.71 бита**. Это означает, что при идеальной стратегии опроса потребуется в среднем **1.71 вопроса**, чтобы выяснить переданный символ. Для одиночного знака оптимальный алгоритм выглядит следующим образом:
-
Это символ C? (При положительном ответе мы угадываем за 1 шаг с вероятностью 0.4; при отрицательном переходим к следующему этапу).
-
Это символ D? (Угадывание за 2 шага с вероятностью 0.4; иначе переходим к финалу).
-
Это символ A? (Финальный вопрос, позволяющий автоматически идентифицировать оставшийся вариант; совокупная вероятность дойти до этого шага равна 0.2).
Вычисляем среднее количество шагов: 1 × 0.4 + 2 × 0.4 + 3 × 0.2 = 1.8 вопроса. Полученное значение слегка превышает теоретическую энтропию (1.71 бита). На первый взгляд может показаться, что алгоритм неоптимален, однако для изолированного символа улучшить этот результат невозможно.
А что произойдет, если мы попытаемся распознать пару символов? Поэлементный опрос потребует 3.6 вопроса при суммарной энтропии 3.42. Однако переход к комплексным вопросам о комбинациях из двух знаков позволяет снизить показатель до 3.52 вопросов (или 1.76 вопроса в пересчете на один символ). По мере удлинения текстовых последовательностей среднее число вопросов на символ неотвратимо приближается к энтропии источника. Таким образом, энтропийный предел достижим, но лишь в асимптотике для длинных сообщений.
Вряд ли читатель сомневается в практической значимости описанной теории для современных информационных технологий.
Во-первых, архитектура хранения данных полностью подчиняется этим законам. К примеру, жесткий диск оперирует байтами — целыми числами, состоящими из 8 символов бинарного алфавита в диапазоне от 0 до 255. Обращаясь к ячейке памяти, процессор фактически ведет с накопителем диалог в формате «да/нет», считывая уровни напряжения. Всего контроллеру требуется задать ровно 8 вопросов, что эквивалентно 8 битам информации — отсюда и происходит термин «8-битные числа».
Во-вторых, информационная энтропия определяет абсолютный теоретический предел для алгоритмов сжатия данных без потерь. Для абсолютно случайной равновероятной битовой последовательности сжатие невозможно в принципе, поскольку каждый «бит-символ» несет ровно один бит информации. В дальнейших рассуждениях мы будем исходить из того, что по оптоволокну передается именно такой массив.
Добавим шума
Реальные каналы связи неизбежно подвержены воздействию помех и шумов, искажающих передаваемые сигналы. Опишем эту ситуацию формально: передатчик транслирует последовательность символов  , а приемник регистрирует набор
 . Мы вольны гибко настраивать распределение вероятностей на передаче
 , в то время как характеристики канала считаются заданными в виде условных вероятностей
 , где
 отражает шанс принять символ
 при условии отправки
 .
Какой полезный объем информации способен пропустить такой тракт?
Оценим остаточную неопределенность сообщения на стороне приемника после фиксации символа . Располагая распределениями  и
 , мы можем применить теорему Байеса для вычисления апостериорных вероятностей
 , определяющих шанс отправки
 при фиксации
 . Таким образом, для каждого принятого символа вычисляется локальная энтропия:

Поскольку на выходе канала мы получаем различные знаки  с вероятностями
 , усредним полученный результат по всему множеству возможных исходов для оценки среднего остатка неопределенности (эта величина носит название условной энтропии):

Вспомнив определение информации как меры сокращения неопределенности, найдем средний объем данных, извлекаемых приемником, как разность между исходной энтропией источника и нескомпенсированным остатком неопределенности:

Указанная метрика известна как взаимная информация; она характеризует объем сведений о величине x, доступных по результатам измерения y (обладая свойством симметрии). Разумеется, любой канал стремятся использовать на пределе возможностей. Имея свободу в выборе  , пропускную способность определяют путем максимизации взаимной информации по всем возможным входным распределениям (фактически выполняя оптимальное перекодирование данных с учетом особенностей физической среды):

Классическим иллюстративным примером служит двоичный симметричный канал, где передатчик транслирует нули и единицы, а помехи с вероятностью  инвертируют значение бита. Максимум взаимной информации в такой системе достигается при равной вероятности отправки нулей и единиц (0.5) и выражается следующим образом:

Разберем частные случаи. При  взаимная информация равна единице: тракт функционирует безупречно, и каждый переданный символ доставляет ровно один бит полезных данных. Любопытно, что инвертирование каждого бита также оставляет взаимную информацию равной единице — для восстановления исходного сообщения достаточно лишь повторно инвертировать принятый сигнал.
Иными словами, канал, стабильно ошибающийся в каждом знаке, несет ровно столько же информации, сколько и идеальный тракт. Проблема кроется не в самом факте ошибки, а в ее непредсказуемости.
Гораздо более интригующие результаты возникают при промежуточных значениях вероятности сбоя. Так, при 11% ошибок взаимная информация падает до 0.5 — иными словами, на каждый переданный символьный бит приходится в среднем лишь полбита полезных сведений.
Ситуация выглядит парадоксально: передав 1000 бит, мы получаем 890 корректных знаков и 110 искаженных. Однако теория информации утверждает, что в нашем распоряжении имеется лишь 500 бит полезных данных. Создается впечатление, будто строгая наука безжалостно конфисковала 390 бит, действуя в сговорчивом альянсе с телекоммуникационными монополистами.
Тем не менее конспирологические гипотезы придется отложить. Трудность заключается в том, что приемник должен реконструировать первоначальное сообщение. Если передатчик отправил комбинацию 01001101, а на другом конце приняли 01011101, у принимающей стороны нет встроенного механизма определения того, какой именно бит был поврежден.
Разумеется, можно прибегнуть к наивному и громоздкому алгоритму:
-
Передатчик отправляет массив данных.
-
Приемник фиксирует поток.
-
Стороны устанавливают сеанс связи.
-
Производится побитовое сличение.
-
Ошибки устраняются вручную.
Метод работает!
Но имеется небольшой изъян.
Весь смысл высокоскоростной передачи данных изначально заключался в том, чтобы избежать необходимости дублировать отправку исходного массива.
Следовательно, требуется принципиально иной подход.
Коррекция ошибок
Наиболее примитивный способ защиты заключается в трипликации символов: вместо каждого знака передается тройка идентичных копий. Так, для отправки сообщения 010 по каналу транслируется последовательность 000 111 000. Приемник восстанавливает исходный бит методом голосования большинства в каждой тройке. Если вероятность базовой ошибки в канале равна  , то шанс итогового сбоя на приемнике составит
 (когда искажены все три бита) плюс
 (при повреждении двух бит из трех). Для 11-процентного уровня канальных шумов подобное кодирование снижает долю ошибок на выходе до 3%. Результат далек от идеала, но заметно лучше исходного.
Что происходит с точки зрения теории информации? Энтропия дублированного сообщения 000 111 000 остается равной энтропии оригинала (согласно третьему свойству). Однако информационная емкость одного переданного символа падает с 1 до 1/3 бита, поскольку теперь на один полезный бит расходуется три физических знака. Пожертвовав скоростью передачи ради избыточности, мы повысили надежность. Возникает закономерный вопрос: можно ли ценой дальнейшего снижения скорости добиться абсолютно безошибочной связи? И если да, то насколько сильно придется уменьшить пропускную способность?
На этот вопрос отвечает теорема Шеннона для канала с шумом: объем полезной информации на один символ  не должен превышать пропускную способность канала:

Данное утверждение также справедливо в асимптотическом пределе длинных последовательностей. Так, для рассмотренного случая с  (
 ) для надежной передачи 1000 исходных бит потребуется транслировать суммарно около 2000 знаков с учетом служебной избыточности.
Интересным вырожденным случаем является точка  , где взаимная информация обращается в нуль. Это значит, что такой канал не переносит никаких полезных сведений, и никакой корректирующий код не способен спасти ситуацию. На этом фундаментальном факте базируется абсолютная криптографическая стойкость шифра Вернама (побитового сложения по модулю два со случайной гаммой, известного как «одноразовый блокнот»).
К сожалению, теорема Шеннона носит неконструктивный характер: она лишь констатирует факт существования эффективных кодов, не предоставляя готовых алгоритмов. Тем не менее на практике инженерам удалось разработать великолепные семейства корректирующих кодов: относительно короткие коды Хэмминга (удаленные от теоретического предела), BCH-коды и современные стандарты телекоммуникационной индустрии — LDPC-коды, оперирующие блоками длиной от 16 до 64 тысяч символов и заслуживающие отдельного подробного рассмотрения. Обычно передаваемый блок состоит из комбинации исходных информационных бит и проверочных сумм, сформированных по правилу XOR.
В настоящем математическом вступлении мы формализовали понятия неопределенности и информации, связав их с игрой в «угадайку» о числе необходимых вопросов в формате «да/нет», а также изучили принципы передачи данных через зашумленные каналы. В следующей части мы привсем в уравнение физику процессов, рассмотрев особенности распространения сигналов по оптоволокну и те виды шумов, которые лимитируют объем информации на один символ.
До встречи!
-
Richardson, D., Fini, J. & Nelson, L. Space-division multiplexing in optical fibres. Nature Photon 7, 354–362 (2013). https://doi.org/10.1038/nphoton.2013.94
Похожие статьи
 Интервью с Роджером Пенроузом: о Вселенной, сознании и пространстве-времени
 Первая часть 16-й проблемы Гильберта: перебор схем 8-й степени с ограничениями
 У астероида неожиданно нашли кольца: ученые в недоумении
 Кого ждет рынок труда России в 2032 и 2040 годах: демографический анализ Росстата
 Первопроходцы открывают морские пути
 Новое редкое доказательство найдено для теоремы о четырёх красках
 Сколько близких звезд мы упустили из виду?
 18 снимков наглядно покажут колоссальные масштабы нашей вселенной