Сколько инструментов давать языковой модели: гипотеза, которую опроверг замер
Арсенал нашего ИИ-оркестратора насчитывает более девяноста инструментов, предназначенных для манипуляций с табличными данными, текстовыми документами, электронной почтой, задачами, веб-ресурсами, презентациями и прочими сущностями.
В процессе обработки входящих запросов нейросеть на каждом этапе определяет, какой именно инструмент задействовать. Возникает закономерная дилемма: стоит ли предоставлять ей весь спектр возможностей разом или ограничиться лишь релевантными пунктами?
Наш оркестратор спроектирован гибким: он успешно взаимодействует как с массивными облачными моделями, так и с компактными решениями, способными функционировать на потребительских видеокартах. Базовый жизнеспособный конфиг выглядит так: RTX 3090 (24 ГБ) вкупе с Qwen3.6 (27B).
Главный ориентир — добиться от этого минимального рабочего сета высокой производительности и достойного качества решения корпоративных кейсов.
Очевидно, что стратегии селекции инструментов для легковесных и тяжеловесных моделей должны разниться, однако выработка идеального алгоритма — задача нетривиальная.
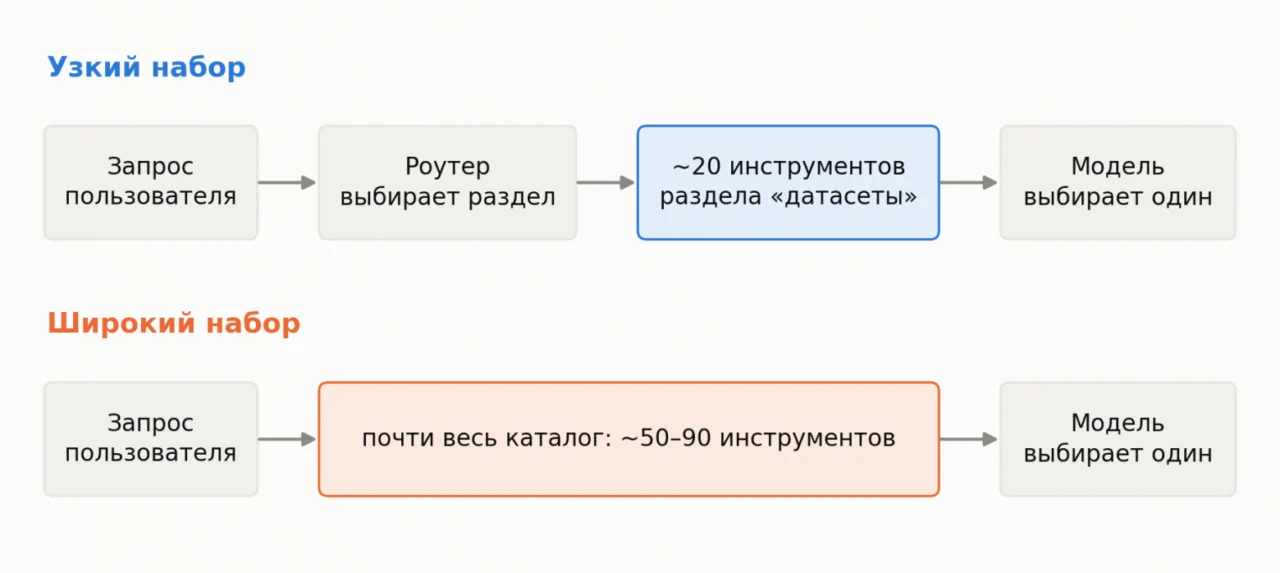
Традиционный подход заключается в том, что оркестратор выкатывает модели полный каталог, предоставляя ей самостоятельность в выборе подходящего инструмента. Именно так поступают разработчики Hermes, OpenClaw и Ouroboros, не практикуя фильтрацию по смыслу текстового запроса. Некоторые из этих систем для слабых моделей с ограниченным контекстом задействуют специальный режим: нейросети передают лишь реестр с наименованиями, краткими аннотациями и функцией «подключения», давая ей возможность самостоятельно находить и подгружать нужное. Подобные агенты ориентированы на передовые фронтир-модели класса Claude или GPT-5, способные удерживать в памяти сотню инструментов без деградации качества. Моя же цель иная — запустить систему на локальной модели 27B в изолированном контуре, где суженный спектр демонстрирует ощутимо лучшие результаты.
Анатомия суженной выборки
Архитектура предельно прозрачна. Перед вызовом основной модели активируется роутер, который анализирует текст запроса и определяет тематическую категорию (например, «датасеты», «почта», «презентации»), а затем сужает поиск до конкретного подраздела. В итоге модель получает не девять десятков описаний, а около двадцати, оставаясь в неведении относительно существования остальных опций на данном этапе.
Маломощная модель: превосходство узкого пула
В августе я провел бенчмарк для локальной версии Qwen 27B, развернутой на одиночной RTX 3090. Тестовый массив включал 49 пользовательских кейсов, прогнанных дважды за день при единственном варьируемом параметре — объеме списка кандидатов. Ограниченный набор выдал 43 корректных решения из 44, тогда как полный — лишь 39. При полноразмерном списке контекст раздувался в 2,7 раза, а время выполнения возрастало на треть. Вероятно, более детальная спецификация инструментов позволит довести точность до абсолюта, но текущие метрики таковы.
Любопытно проанализировать локализацию сбоев. Все ошибки пришлись на одну группу инструментов со схожей семантикой наименований: команда «объедини датасеты» ошибочно ушла в «управление датасетами», запросы на построение графиков и переименование колонок были классифицированы как «анализ датасета», а извлечение контента с новостных ресурсов подменилось сырой загрузкой веб-страницы вместо глубокого парсинга.

Слабые модели ошибаются системно, путая близкие по смыслу сущности. Следовательно, узкий набор помогает не столько за счет лаконичности, сколько за счет устранения похожих друг на друга альтернатив.
Рабочая гипотеза: сильным моделям нужен широкий охват
Еще в июле я запустил пилотное тестирование на скромной выборке из восьми запросов, сопоставив локальную модель с GPT-4.1. Результаты разделились: локальный ИИ показал 7/8 на узком пуле и 6/8 на широком, в то время как GPT-4.1 продемонстрировала зеркальную динамику — 7/8 на узком и 8/8 на широком. На суженном наборе флагманская модель не справилась с комплексным запросом, затрагивающим сразу две доменные области, поскольку нужный инструмент просто выпал из поля зрения. Интуитивно напрашивался красивый вывод: компактным моделям показано ограничение контекста, а мощным — свобода выбора. Направление эффекта коррелирует с возможностями модели. Исходя из этого, я заложил в оркестратор гибкую настройку: логика роутинга теперь привязывается к конкретной архитектуре и автоматически адаптируется при смене модели в панели управления.
Безусловно, восемь кейсов — не повод для железобетонных выводов, но отличный стимул для полноценного исследования.
Масштабный замер: две облачные модели и четыре сценария
В сентябре я прогнал весь тестовый корпус через две облачные нейросети — GigaChat-2-Max и gpt-oss 120B — во всех четырех предусмотренных в системе конфигурациях селекции. Сам корпус остался неизменным, однако за прошедшее время реестр инструментов расширился до 91 позиции.

В обоих случаях узкая выборка одержала верх как по метрикам точности и объему контекста, так и по задержке отклика. Изначальная гипотеза о том, что мощным моделям требуется широкий спектр, на данных образцах не подтвердилась.

Что скрывалось за фасадными ошибками
Детальный разбор каждого сбоя показал, что половина из них вовсе не являлась архитектурными промахами. Так, все три неудачных кейса GigaChat на узком наборе представляли собой вполне логичные уточняющие вопросы: «укажите идентификатор проекта» или «в каком слоте находится датасет?». Если трактовать конструктивное уточнение как валидный ответ, итоговый результат достигает абсолютных 44 из 44. Однако тестовый корпус изначально запрограммирован засчитывать уточнения как успех лишь в одном случае из 49 — это был директивный выбор логики поведения платформы, а не техническое ограничение модели. Не исключено, что более совершенные описания инструментов позволили бы улучшить этот показатель.
Обратная сторона медали: риски узкой выборки
У суженного пула есть критический недостаток, превосходящий по тяжести любую неверную маршрутизацию. Если роутер не распознает ни одну из категорий, система ошибочно интерпретирует запрос как академический вопрос на общие знания, игнорирует инструменты и генерирует галлюцинацию.
Для запроса вроде «что такое OKR» это корректно. Но рассмотрим живой диалог: «Определите перечень активных устройств в корпоративной сети». Роутер не находит подходящего раздела, модель остается без инструментария и выдает пользователю бодрый ответ: «Инициирую сканирование сети…», подробно расписывая план действий в текстовом виде без единого фактического вызова функции. Два шага подряд, ноль обращений к API и железобетонная уверенность в голосе.

К слову, корректная реакция на команду поиска устройств в сети выглядит иначе: исполнительные модули агента изолированы соображениями безопасности, и прямого доступа к инфраструктуре у него нет. Правильный путь — честно заявить об ограничениях и предложить альтернативные сценарии. Но чтобы модель вела себя конструктивно, а не имитировала бурную деятельность, нельзя лишать ее базового функционала.
Главный вывод: удостоверьтесь, что тестовая среда в точности воспроизводит пайплайн боевого продукта. Иначе вы получите абсолютно точные и воспроизводимые метрики чего угодно, но только не реальной системы.
К каким выводам я пришел?
Логику роутинга необходимо конфигурировать на уровне самой модели, а не всей системы глобально. Именно поэтому параметры маршрутизации задаются индивидуально, а смена модели в административной панели автоматически подтягивает профиль роутинга. Для всех трех моделей, протестированных на полномасштабном корпусе, оптимальным оказался именно узкий набор. Тезис о том, что «фронтирам нужен широкий охват», пока остается не подтвержденной гипотезой — ее валидация требует полноценного тестирования на передовых моделях, а не на микровыборке из восьми запросов. Ваши результаты могут отличаться, и мне было бы крайне интересно обсудить этот опыт в комментариях.
Чек-лист для тех, кто планирует проводить подобные замеры:
— Проводите кросс-тестирование режимов на едином корпусе, в рамках одной сессии, на идентичной модели. Выборка должна быть репрезентативной.
— Фиксируйте версию слепка данных: каталог инструментов разрастается, и спустя месяц те же метрики могут отражать совершенно иную реальность.
— Изолируйте уточняющие реплики от критических промахов — это принципиально разные типы поведения ИИ.
— Тщательно аудируйте системные промпты и схемы описания инструментов, доступные модели. Они оказывают решающее влияние на качество селекции.
— Убедитесь, что тестовая оценка полностью повторяет продуктовый контур, включая финальные этапы обработки ответов.
возможностью посмотреть.*
Похожие статьи
 Генпрокуратура Калифорнии вызвала OpenAI на допрос из-за кибератак
 Китай разработает марсианскую карту в масштабе 1:5 000 000
 Toshiba направит $380 млн на увеличение производства жёстких дисков для дата-центров ИИ
 Калифорния первой в США запретила увольнять работников на основе решений ИИ
 Секрет чипов AMD из 2000-х: что объединяет Xbox 360, HTC HD2, Xperia Play и LG Optimus
 Впервые большинство корпоративных ИТ-систем размещено за пределами собственныx дата-центров
 Как устроена ИИ-инфраструктура 2026 года: почему для работы LLM нужна не одна видеокарта
 Яндекс 360 добавил правила доступа для отдельных дисков и учёт нагрузки в Трекере