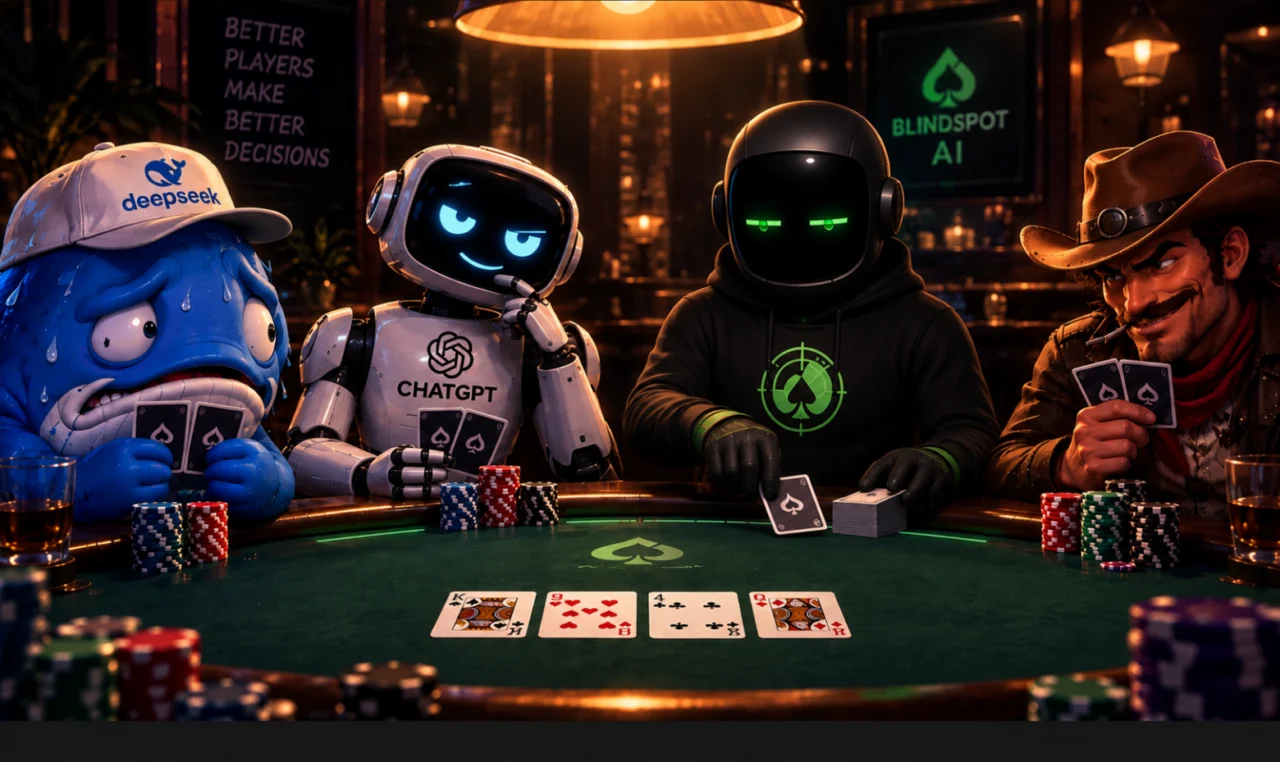
Почему ChatGPT отлично рассуждает о покере, но ужасно в него играет
DeepSeek не рыба. Он кит с Extra High Reasoning.
Ранним утром вас встречает заголовок: новейшая GPT Astra за одну ночь справилась с одной из величайших математических головоломок человечества. И тут в голову закрадывается заманчивая мысль: раз языковая модель столь прозорлива, почему бы не отправить её за покерный стол зарабатывать вам деньги? Глядишь, и ежемесячная подписка наконец окупится 🙂
-
делаем скриншот экрана и отправляем в нейросеть
-
поступаем строго по её рекомендациям
-
???
-
ПРОФИТ
Можно даже полностью автоматизировать процесс, разработав утилиту по аналогии со вспомогательным софтом для прохождения собеседований.
Звучит как безупречный план? Абсолютно. Как катастрофически провальный план. И вот почему…
В свежем исследовании от GTO Wizard фигурирует любопытный бот под названием Always Fold. Вся его игровая тактика сводится к единственному действию — мгновенному сбросу карт. Абсолютно любых. Во всех ситуациях. Он за всю жизнь ни разу не заглянул в свой карманный сектор, поскольку в этом просто нет смысла.
Его показатель против передового покерного искусственного интеллекта составляет минус 64.6 bb/100 (количество больших блайндов, утраченных в расчете на сотню раздач — этот параметр нам еще пригодится).
В свою очередь, GPT-4o продемонстрировала в аналогичном испытании результат в минус 64.9.
Иными словами, модель, способная написать блестящую диссертацию о картах-блокерах, поляризации диапазонов и минимальной частоте защиты, выступает за суконным столом чуть слабее, чем бездумный автосброс вслепую. Предыдущая GPT-4 ушла в минус на 136, продемонстрировав результат вдвое хуже абсолютной трусости. Grok 4 с активированным глубоким рассуждением показал минус 60, едва-едва опередив примитивного робота.
Пока вы свыкаетесь с горькой правдой о том, что лёгких денег не предвидится, давайте разберем причины фиаско и оценим, есть ли у языковых моделей реальное будущее в покере.
Суть проведенного тестирования
Эксперты GTO Wizard опубликовали открытый бенчмарк для безлимитного холдема тет-а-тет. Концепция предельно прозрачна: существует виртуальный оппонент, действующий почти в рамках равновесия Нэша. В 2022 году этот бот разгромил признанного чемпиона компьютерной дисциплины Slumbot с результатом +19.4 bb/100 по итогам 150 тысяч раздач. Для понимания масштаров: элитный профессионал удерживает показатель около +5 bb/100. Именно в этом зазоре и кроется пропасть между сильным регуляром и совершенным алгоритмом.
Против этого грозного соперника выставили тринадцать коммерческих языковых моделей в режиме zero-shot: им скармливали текстовое описание раздачи с требованием выдать вердикт, размер ставки и обоснование. Никаких сторонних калькуляторов эквити или вспомогательного софта — исключительно собственные когнитивные способности ИИ.
Нельзя не отметить безупречный методический подход. Покеру свойственна дисперсия: даже виннеры могут неделями уходить в минус из-за банального невезения. Поэтому авторы интегрировали систему AIVAT, которая нивелирует фактор удачи и втрое сокращает стандартное отклонение. Представленные ниже цифры отражают не капризы фортуны, а чистое качество принятых решений.
|
Участник |
bb/100 (с поправкой на дисперсию) |
|
Элитный профессионал (ориентир) |
≈ +5 |
|
GPT-5.3 Extra High reasoning |
−16 ± 3 |
|
Claude Opus 4.6 |
−20.4 ± 8.6 |
|
Gemini 3.1 Pro |
−30.8 ± 4.5 |
|
Always Fold (бот-автосброс) |
−64.6 ± 3.3 |
|
GPT-4 |
−136.2 ± 25.6 |
|
Uniform Random (случайный выбор) |
−284.9 ± 30 |
Технологический скачок впечатляет: за неполные три года линейка GPT преодолела путь от −136 до −16. Изначально никто не гарантировал, что нейросети вообще способны оперировать скрытыми данными, однако они справились, причем весьма оперативно.
Тем не менее, называть вещи своими именами все же стоит. Рекордный результат в −16 bb/100 обошелся в $1041 и 446 часов машинного времени. Более свежая и ресурсоемкая модификация GPT-5.4 Extra High сожгла бюджет в $1915 при 636 часах расчетов, показав при этом чуть более слабый перформанс. Это уровень заурядного любителя, заглянувшего на вечерний турнир. Рисковать реальными активами здесь категорически не рекомендуется.
И вот тут кроется главная интрига: ровно эта же нейросеть способна сгенерировать такой экспертный разбор раздачи, перед которым померкнут консультации рядового тренера стоимостью 40 долларов в час.
Две диаметрально противоположные парадигмы интеллекта
Чтобы осознать природу столь глубокого разрыва, следует обратиться к подлинным владыкам покерных алгоритмов.
Libratus (2017 год). Уверенно переиграл четверку сильнейших профи в хедз-ап противостоянии. В основе лежит метод CFR (Counterfactual Regret Minimization) по принципу Монте-Карло: программа проводит миллиарды симуляций сама с собой, минимизируя на каждом шаге сожаления об упущенной выгоде. Никакой мистики — чистая итеративная математика. Затраты ресурсов составили порядка 25 миллионов процессорных ядро-часов.
Pluribus (2019 год). Аналогичная методология, масштабированная на шесть участников, что экспоненциально сложнее, поскольку при трех и более игроках равновесие Нэша теряет статус гарантии. Тем не менее, элита пала и здесь. Любопытная деталь: базовая стратегия Pluribus была просчитана всего за восемь суток на одном 64-ядерном сервере, обойдясь примерно в $144 по спотовым тарифам. Во время реальных сессий на принятие решений уходило от секунды до тридцати трех.
Сто сорок четыре доллара. Тестирование одной языковой модели в рамках бенчмарка стоило в тринадцать раз дороже — и завершилось полным провалом.
Куда интереснее другое. Pluribus понятия не имеет о существовании блефа. Он не штудировал покерную литературу, тематические форумы или разборы на YouTube. Ему неведомы концепции позиционного преимущества, инициативы или полублефа. Нейросеть сформировала всю механику самостоятельно через внутренние симуляции, а ее весовые коэффициенты лишены профильных терминов — оперируют исключительно цифрами. Попытка выяснить у программы мотивацию обречена на провал: у нее нет вербального ответа, зато есть безупречное вероятностное распределение.
Языковые модели функционируют с точностью до наоборот. Они усвоили абсолютно всё, созданное человечеством по теме покера: блоги, учебники, стенограммы трансляций. При этом они не сыграли по-настоящему ни единой партии.
Перед нами две взаимодополняющие грани мастерства. Напрашивающийся вывод очевиден:
Pluribus умеет превосходно играть, но не способен ничего объяснить. ChatGPT блестяще объясняет, но играть совершенно не умеет.
К слову, между ними существует промежуточное звено, о котором сегодня незаслуженно забывают. PokerSnowie (2013 год), детище создателей BackgammonSnowie. Нейросеть, сыгравшая с собой триллионы раздач, до релиза PioSolver служила для целого поколения игроков проводником в мир неэксплуатируемых стратегий. Именно Snowie излечил комьюнити от привычки переоценивать слабые топ-пары.
Однако Snowie разделяет недуг Pluribus, выступая в несколько ином амплуа. Он не является солвером в чистом виде: программа не вычисляет равновесие для текущего спота, а экстраполирует паттерны на основе тренировочной выборки. Метод безотказен, пока текущая ситуация совпадает с датасетом, но дает сбой при отклонениях от нормы. Аудит его решений невозможен — в ответ на запрос аргументации выдается безапелляционное «потому что».
Выстраивается элегантная координатная ось: CFR производит расчеты. Snowie полагается на интуицию. LLM ведет повествование. И по какой-то причине мы искренне ждем, что финальный компонент автоматически овладеет функционалом двух предыдущих.
Три фундаментальные причины, почему анализ дается лучше практики
Утечки в оперативном восприятии
Проблема носит не столько стратегический, сколько перцептивный характер, что делает ее особенно обидной.
Авторы бенчмарка проанализировали внутренние цепочки рассуждений GPT-5.3 Extra High — наиболее успешной модели из списка — и выяснили, что примерно в 2% случаев она банально путает собственные карманные карты. Одномастные номиналы принимаются за разномастные и наоборот. Ошибка обычно зарождается на префлопе, в момент раздачи, и шлейфом тянется сквозь всю сессию, заставляя нейросеть до самого ривера выискивать несуществующие флеш-дро.
У более ранних версий показатель ошибок существенно выше. Вот аутентичная цитата из умозаключений Claude Opus 4.5:
«На руках 9♦ 7♠ при борде K♦ 4♣ 3♠ K♠ — абсолютный мусор, пара и дро отсутствуют, есть лишь гатшот на шестерку. На стол легли парные короли, две пики…»
В действительности структура борда выглядела как 8♦ 4♣ 3♠ K♠ 5♦.
Модель утратила восьмерку с пятеркой, вообразив второго короля и заметив спаренный стол, после чего выдала внешне безупречный, профессионально звучащий и абсолютно логичный разбор. Только совершенно другой ситуации.
В этом и заключается корень зла. Рассуждение безупречно. Исходные данные — нет. А в покере одна неверно истолкованная карта обесценивает математическое ожидание (EV) всего задействованного спектра.
Правдоподобность как антипод игрового баланса
Второй фактор залегает гораздо глубже и вряд ли поддается простой корректировке. Полноценный солвер выдает в качестве результата не ультимативный вердикт, а вероятностное распределение:
3-бет 27% | кол 61% | фолд 12%Это не признак неуверенности алгоритма. Это и есть сама стратегия: с конкретной комбинацией в данной позиции необходимо осуществлять 3-бет в 27% случаев, определяя действие с помощью генератора случайных чисел. Не ради красоты, а во избежание предсказуемости.
Языковая модель выдает лишь одно, наиболее «очевидное» действие. Ее обучали именно этому, и в девяноста девяти прикладных сферах из ста подобный подход идеален.
Для покера это смертный приговор. Оппонент, неизменно выбирающий самый благоразумный ход, становится прозрачным и крайне уязвимым для эксплуатации.
Бенчмарк демонстрирует это воочию. Исследователи визуализировали диапазоны моделей в матрице 13×13, оценив защиту большого блайнда со стороны GPT-5.3. Картина показательна: 3-беты применяются лишь с премиум-руками, все прочее уходит в колл. Спектр открытия также несбалансирован из-за искаженных частот.
Переводя на доступный язык: когда эта модель повышает ставку, вы доподлинно знаете ее руку. Не «догадываетесь», а знаете наверняка. Она сама транслирует это своими действиями, пусть и не словами.
Данный изъян невозможно устранить патчем в следующем обновлении. У нейросети отсутствует внешний источник случайности, привязанный к конкретной комбинации, и нет никаких предпосылок для его появления. Целевая установка модели — выдать наилучший ответ, тогда как покер периодически требует совершать заведомо неоптимальные манипуляции.
#### LLM унаследовали человеческие ментальные ловушки
Архитектура обучалась на массивах текстов, сгенерированных людьми. А люди склонны оценивать покер через призму результатов: «колл оказался верным, у него же был блеф». Это классическая ошибка мышления, известная как results-oriented thinking (оценка по исходу) — наиболее опасное и живучее когнитивное искажение в дисциплине. Стратегическое решение нельзя измерять постфактум по финальному банку; его правомочность определяется исключительно объемом информации, доступной в момент совершения хода.
Именно эту ошибку LLM воспроизводит с пугающей точностью. Продемонстрируйте модели раздачу целиком, включая карманные карты оппонента, и попросите проанализировать флоп — она с энтузиазмом докажет правоту колла, ведь в итоге там действительно обнаружился блеф.
Практическое применение в реальных условиях
Раз уж языковые модели не годятся на роль самостоятельных покерных движков, возможно, мы изначально возлагали на них не те задачи? Собственно, с подобных размышлений и стартовала практическая фаза моего эксперимента.
На начальном этапе все выглядело архаично: играл по классике самостоятельно, натыкаясь на сложный спот, переключался в ChatGPT, детально описывал позиции, стеки, борды и экшен, получая экспертную оценку. Результаты впечатляли. Однако вскоре пришло осознание, что текстовый интерактив в духе «а теперь удерживай в памяти, что на флопе банк составлял 7000» быстро утомляет.
Очевидное технологическое решение напросилось само собой: вместо очередного запроса в веб-интерфейсе я начал писать промпты внутри среды Cursor.
Пускай игровой движок удерживает актуальные данные по картам, позициям, стекам, размеру банка, показателям SPR, pot odds и истории действий. В свою очередь, языковая модель получает на вход полностью сформированный контекст раздачи и занимается тем, что удается ей лучше всего: анализом и разъяснением нюансов для пользователя. Так родился инди-проект https://poker-blindspot.tech, где игроку предстоит одолеть роботов в турнирном формате. После каждого хода система выставляет оценку на предмет соответствия GTO-принципам, а по завершении раздачи можно запросить углубленный разбор от LLM.

Сайт заработал, но заставить нейросеть выдавать глубокую и безошибочную аналитику оказалось отдельным квестом.
Эксперименты с вендорами показали следующее: DeepSeek регулярно путает номиналы, игнорирует дро и демонстрирует слабое понимание игровой динамики. Похоже, киты в данном контексте действительно не рыбы — по крайней мере, за покерным столом.
Gemini справлялся с картами лучше, но испытывал трудности с оценкой диапазонов оппонентов.
Наилучшие результаты продемонстрировала GPT-5.5. Тем не менее, просто скормить ей историю раздачи оказалось недостаточно: потребовалось внедрить свод строгих регламентов, предварительно обогатив запросы всей служебной информацией, которой уже располагает игровой бэкенд.
Параметры банка, глубина стеков, эффективный стек, SPR и шансы банка уже рассчитаны движком. Применяйте их в готовом виде и не пытайтесь пересчитывать самостоятельно.
Мы полностью оградили модель от арифметических вычислений, преподнося всю математику на блюдечке. Карманные карты соперника вынесены в изолированный блок с жестким маркером «запрещено использовать для оценки текущего решения» — привет упомянутой выше склонности оценивать исходы задним числом. Разделение обязанностей принесло плоды: движок производит вычисления, LLM формулирует выводы.

Заключение
Эволюция показателей от −136 до −16 за трехлетний отрезок вызывает искреннее уважение, и меня вовсе не удивит, если через пару лет нейросети начнут уверенно обыгрывать людей. Базовое понимание скрытой информации и блокеров уже сформировано, а ведь на старте это казалось недостижимым.
Однако на данном этапе критически важно соблюдать профильное разделение труда. Вычисление частот — прерогатива CFR-алгоритмов. Разъяснение глубинных причин этих частот — зона ответственности языковых моделей. Смешение ролей неизбежно порождает либо немую машину, либо красноречивого собеседника, безнадежно сливающего боту-автосброщику.
Поэтому при проектировании продуктов на базе LLM в сферах со строгой математической логикой — не доверяйте им подсчеты. Производите вычисления самостоятельно, передавая модели готовый результат. Пусть она занимается тем, что получается у нее безупречно: увлекательным повествованием.
Похожие статьи
 Как разгадать загадку университетского квеста
 Обязаны ли мы использовать квантовые компьютеры для познания химии?
 Искусственный интеллект усугубляет цифровой разрыв
 Династия киборгов: как две сотни агентов возвели цивилизацию
 Когда агент перерастает самого себя
 Строение протона: новые данные
 Что такое нанометры
 ИИ заберет тексты и код. Но это никогда не было главной работой человека. Часть 2