Как ИИ-агенты за три недели оцифровали мой семейный архив и к чему это привело
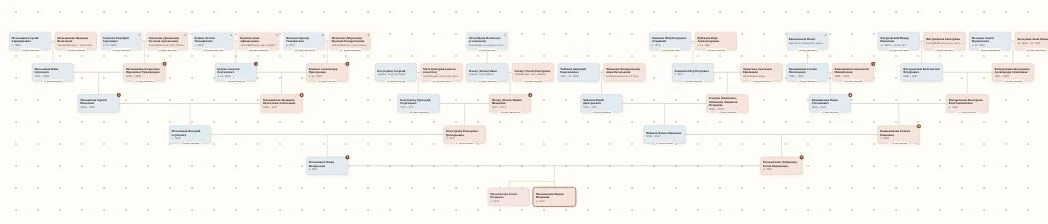
Древо: шесть поколений на одном экране
Всего за три недели совместная работа с двумя искусственным интеллекта позволила мне сформировать открытую летопись моего рода: 597 человек, 648 документов и фотографий, а также записи, уходящие вглубь веков вплоть до 1705 года. Итогом этого эксперимента стали два независимых open-source проекта: движок для семейных веб-ресурсов gene-archive и специализированный MCP-сервер genealogy-mcp, обучающий любых цифровых ассистентов корректному поиску предков без вымыслов и фальсификаций.
В материале подробно описан весь пройденный путь: от стартового запроса к нейросети до разработки собственных инструментов и MCP. Главное внимание уделено тем принципам и ограничениям, которые были заложены в агентов ради достижения безупречной достоверности.
1. Идея: отдать семейный архив агенту
Всё началось с увесистой папки семейных реликвий: свидетельств о появлении на свет и заключении брака, рукописного древа и горстки старых снимков. 25 сентября я передал эти оцифрованные материалы ИИ-агенту с единственной задачей: проанализировать всё и выстроить точные родственные связи.
Именно полноценный агент, а не банальный чат-бот, необходим потому, что генеалогический поиск — это всегда многоступенчатые цепочки. К примеру, в документе указан населенный пункт. Агент проверяет его по старинным уездным справочникам, не обнаруживает, скрупулезно изучает весь перечень на нужную литеру и констатирует отсутствие такого объекта. Затем он обнаруживает его в иной губернии — с точно такими же фамилиями коренных жителей. И незамедлительно валидирует находку по военным архивам, где всплывают уроженцы этого села с нашими фамилиями. И всё это — на протяжении первых суток.
По прошествии первой недели стало очевидно, с какими задачами модель справляется блестяще:
-
расшифровка почерков и дореволюционной орфографии в метрических книгах позапрошлого века — пусть с погрешностями, но несравненно быстрее человека;
-
обработка огромных массивов информации: губернских памятных книжек, адрес-календарей, архивных описей и неиндексированных сканов на FamilySearch;
-
синтез разрозненных сведений: метрика, справочник кооперативных товариществ и мемуары современницы складываются в цельную биографию человека, о котором прежде помнили лишь имя.
Столь же стремительно выявились и слабые места нейросети. Изначально отчество одного из прапрадедов было прочитано неверно, но ошибку удалось устранить сопоставлением с тремя другими метриками. Слишком соблазнительно привязать к древу полных тезок. Об этом пойдет речь в блоке об извлеченных уроках: именно там родились регламенты, впоследствии интегрированные в движок и MCP.
Насколько глубоко: одиннадцать поколений
Наиболее протяженная ветвь насчитывает одиннадцать поколений вверх от моих дочерей, упираясь в крестьянина из тульской глубинки середины XVIII столетия. Самая ранняя метка в базе датирована приблизительно 1705 годом — по возрасту женщины из ревизской сказки 1745 года. В других ответвлениях архивные поиски достигают 1730-х годов (тульские селения), 1770-х (Бессарабия) и середины XIX века (духовенство, кубанские и кавказские казачьи сословия).
Каждая историческая эпоха требует работы со специфическими типами документов:
|
Период |
Источники |
Где обнаружены |
Что раскрывают |
|---|---|---|---|
|
1930–1950-е |
фронтовые сводки, учетные карточки пленных, репрессивные списки |
«Память народа», Национальный архив Финляндии, Arolsen, базы политзаключенных |
участие в войнах, плен и трагические аресты |
|
1914–1920 |
картотеки Первой мировой войны, эмиграционные анкеты |
gwar.mil.ru, справочники беженцев |
боевые ранения, пленения, маршруты исхода из страны |
|
1860–1917 |
метрики, памятные книги, адрес-календари, послужные списки |
FamilySearch, каталоги архивов, полнотекстовые базы archive.org, НЭБ |
факты рождения, бракосочетания, восприемников, чины и должности |
|
1811–1858 |
ревизские сказки, исповедные росписи |
непроиндексированные сканы на FamilySearch, расшифровки историков-энтузиастов |
домохозяйства, возраст членов семей |
|
1745–1795 |
материалы ранних ревизских переписей |
неиндексированные сканы на FamilySearch |
фундаментальный пласт: имена и отчества крестьянских общин |
Углубляясь в прошлое дальше XIX века, исследователю приходится опираться исключительно на ревизские сказки — поподворные подушные переписи. Они лишены цифровых указателей: перед нами тысячи кадров рукописных документов XVIII столетия в каталогах FamilySearch, рассортированные по уездам и годам. Агент самостоятельно находит нужную пленку по описи, выкачивает весь массив кадров и просматривает их до искомого селения. После чего выстраивает ретроспективу от ревизии к ревизии: 1858 → 1850 → 1834 → 1816 → 1811 → 1782 → 1745, кропотливо сверяя личные данные и возраст. Исследователю-человеку на подобную рутину требуются недели в читальных залах, тогда как нейросеть справляется за один вечер — вплоть до срабатывания лимитов сервера.
Здесь же кроется важная оговорка. Возраст в ревизиях вычислялся приблизительно, поэтому он снабжен пометкой «около». А начальные звенья самой глубокой линии до сих пор значатся как «предположительные»: в 1780-х годах семейство перебралось на новый хутор, и преемственность между переписями зафиксирована лишь на основе совпадения имен и возрастов, а не прямым упоминанием. Искусственный интеллект не стал выдавать желаемое за действительное — именно такого уровня надежности мы от него и добивались.
2. Личный сайт-архив
Спустя три дня объем находок стал столь велик, что потребовалась удобная площадка для систематизации и демонстрации родственникам. Так 28 сентября возник наш проект семейного интернет-архива. На сегодняшний день его репозиторий насчитывает около 590 коммитов, подавляющая часть которых выполнена ИИ-агентами.
Архитектура намеренно предельно лаконична:
-
Единый массив данных. Абсолютно всё — персоны, семьи, документальные подтверждения, географические точки, поисковые журналы и правки — сосредоточено в файле
family_tree.json. Это облегчает агенту чтение и редактирование, а git фиксирует всю эволюцию. -
Цифровая индексация вместо имён. Персоны значатся как
I###, семьи — какF###, документы — какS###. Каждая сноска трансформируется в интерактивную кнопку, наглядно демонстрирующую первоисточник любого утверждения. -
Предварительная валидация. Скрипт
validate.pyотсекает битые ссылки, упоминания несуществующих документов и некорректный формат дат (не соответствующих ISO/GEDCOM). При обнаружении дефектов сборка блокируется. -
Статичная генерация и миниатюрный сервер. Python-компилятор формирует страницы на основе JSON, а бэкенд задействован исключительно для обработки комментариев. Процесс деплоя затрагивает лишь измененные файлы и занимает около минуты.
Как устроен архив: от карточки к летописи
Генеалогическое древо — лишь точка входа. Сам архив многослоен, причем все уровни компилируются из единого источника. Родные воспринимают сайт как художественное повествование, поэтому каждый пласт представляет собой связный текст, а не сухую таблицу.
Для чего нужно столько текстовых описаний? Именно они возвращают предков к жизни. Большинство родственников старшего поколения мы застали в преклонных годах либо знаем лишь по скупым отголоскам воспоминаний. Но стоит погрузить их в исторический контекст — и картина меняется. Прапрадед, значившийся в документах лишь как «служащий в поволжском городе», предстает обаятельным молодым кооператором, которого летом 1916 года запечатлела в дневнике случайная попутчица: «лихач-кудрявич, очень милый, простой и серьёзный». И эти букли отчетливо видны на его юношеском фотографическом портрете.
Прадед перестает быть безликой датой на мемориальной плите, превращаясь в рядового пехотного полка, получившего ранение осеньки 1916 года. Его тесть круглый год пропадал на заработках в Москве, а родное селение жены фигурировало в документах под тремя разными именами, два из которых происходили от фамилий прежних землевладельцев. Личность проявляется через окружение: восприемников, свадебных поручителей, сослуживцев, соседей. Именно поэтому структура архива сетевая: из карточки можно шагнуть к локации, оттуда — в главу «Историй», а затем к первоисточнику.
Персональная карточка. Включает блоки дат, географии и родственных связей, под которыми располагается подробная биографическая хроника. Подобными очерками обеспечено 510 из 597 персон, суммарный объем текстов приближается к 250 тысячам символов. Для агента установлены жесткие критерии:
-
это повествование о судьбе, а не технический лог: формулировки вроде «отчество скорректировано 25.09» недопустимы;
-
запрещено дублировать данные, уже представленные в шапке карточки (родителей, хронологию, места захоронений);
-
каждый подтвержденный факт снабжается отсылкой к скану, а семейные предания маркируются вводными фразами «со слов…», «в семье передавали…»;
-
сомнительные гипотезы выносятся в отдельный блок «Неподтвержденные сведения», причем термин «вероятно» сохраняется для точности.
Географические точки. 61 точка на карте с цветовой дифференциацией ветвей и отображением миграций. Каждая локация обладает собственной страницей: состояние «тогда» и «сейчас» (волость/уезд в сравнении с современным районом и областью), исторические наименования, справка о владельцах, приходе и учебных заведениях, хроника семейных событий и перечень архивных фондов для дальнейших изысканий. География порой объясняет судьбы лучше дат — будь то село, где мужчины традиционно уходили на отхожие промыслы в Москву, либо бессарабская деревня, где крестьяне наделялись землей при князе Кузе.

«История». В этом разделе разрозненные карточки складываются в единое полотно рода, представленное в трех форматах:
-
«Летопись» из двух частей. «Истоки» освещают каждую линию с момента фиксации первых записей. «Век перемен» рассказывает о трансформациях XX столетия: персидских и анатолийских походов, волнах эмиграции, политических репрессиях и бессарабском быте. Текст синхронизирован с картой и таймлайном, а имена кликабельны.
-
«Двенадцать историй» — емкие сюжеты, привлекающие к сайту наибольший интерес родных: от «бабушки-графини», оказавшейся княжной, до сельской знахарки, дважды арестованного ветеринара и фронтовой переписки.
-
Детская адаптация — те же сюжеты, изложенные языком, доступным школьникам.
Завершают раздел подразделы «Белые пятна» и «Куда направлять запросы». Неизвестность стимулирует живой интерес близких и побуждает их делиться воспоминаниями.
Семейный форум и лента обновлений. В «Вопросах» аккумулируются темы, разрешить которые могут лишь живые родственники, оставляющие ответы прямо на странице. Лента «Что нового» оперативно оповещает о свежих находках с указанием точного времени. Главный принцип здесь — знакомить близких со всей предысторией обнаружения (вовлекая восприемников, свидетелей и исторический контекст), а не ограничиваться формальными уведомлениями.
Книжное издание. Из этих же баз данных формируется макет книги «Семь родов» для твердой печати в формате 170×240 мм: первая часть содержит сюжетные главы, вторая — детальные статьи по родам, а вероятные родственники вынесены в приложение. PDF-версия рендерится через headless Chrome посредством Paged.js.
Портал мультиязычен (русский, английский, румынский — ввиду проживания части родни в Молдове). Любое упущение перевода приводит к прерыванию сборки.
Наибольшую ценность обрело вовлечение родственников. Они активно комментируют материалы прямо на портале (за две недели набралось более 80 реплик) и передают старые снимки из домашних архивов. Искусственный интеллект обрабатывает комментарии, внедряет корректировки и верифицирует каждую правку («✓ Учтено — что сделано»). Визуальный ряд подвергается нейросетевой реставрации, о чем рассказано ниже.
Пайплайн реставрации
Поток семейных фотографий потребовал выстраивания конвейера с участием двух агентов: один производит реставрацию, второй осуществляет контроль качества. На текущий момент восстановлен 151 снимок, на что потребовалось 25 рабочих заданий и 12 итераций доработки.
-
Пакетное задание. Формируется пул примерно из восьми кадров с указанием исходных путей и целевых директорий для черно-белой (
<снимок>-bw.jpg) и цветной (<снимок>-color.jpg) версий. Codex получает узкоспециализированную задачу без сопутствующих текстовых отчетов, во избежание «галлюцинаций». Параллельно запускается три-четыре потока:codex exec -C . -s workspace-write "Выполни <бриф>" < /dev/null. -
Восстановление. Задействуются встроенные возможности генерации изображений Codex в режиме editing по единому промпту: архивное восстановление конкретного снимка, устранение царапин, заломов, загрязнений и выцветания при абсолютном сохранении лиц, возраста, причесок, костюмов, наград, надписей и штампов фотоателье. Категорически запрещено что-либо приукрашивать, удалять или дорисовывать. Первоначальные попытки задействовать классические алгоритмы Pillow и OpenCV не увенчались успехом.
-
Обеспечение независимости вариантов. Цветная версия создается не на основе черно-белого варианта, а строго из оригинала во избежание накопления артефактов искажения. Codex самостоятельно сопоставляет результат с первоисточником, совершая не более двух попыток на каждый вариант.
-
Автономная верификация. Claude Code инспектирует каждую пару в сравнении с оригиналом по параметрам лиц, возраста, количества персонажей, текстовых меток и цифр. Типичные сбои: на совхозном транспаранте цветом было выведено 4937 взамен 4597, а черно-белый вариант самовольно сменил лозунг; пожилая женщина на реставрации выглядела неестественно молодо; на паспарту проступала фамилия мастера, неразличимая на оригинале.
-
Точечная коррекция. Текст на фото воспроизводится побуквенно с неизменным требованием: «если точная передача невозможна, оставь размытым, но не выдумывай». Неустранимые сомнительные детали сопровождаются пояснительной сноской.
-
Публикация. Специальный скрипт формирует манифест: датировка извлекается из описания, а к каждой паре прилагается примечание о методике и предположительной палитре. Система блокирует публикацию, если исходник повернут относительно восстановленной копии, выполняя проверку поворотов на 0, 90, 180 и 270 градусов. На сайте реставрация демонстрируется параллельно с оригиналом через интерактивный переключатель, причем эталонным документом остается первоначальный снимок.
Спешно потребовалось реализовать еще две защитные меры. Ныне живущие родственники надежно скрыты от поисковых роботов (используется тег noindex, они исключены из карты сайта). Вдобавок документ, удаление которого запросила семья, помечается флагом hidden и автоматически вычищается из веб-интерфейса и GEDCOM-выгрузки при сборке.
Что нашлось: три истории
Имена опущены намеренно — важнее логика построения архивных цепочек.
Княжна из ногайского рода
О прапрабабушке по линии жены в семье сохранилось лишь имя и ветхая карточка. В адрес-календаре Киевской губернии за 1901 год она зафиксирована как служащая сиротского суда и титулом «княжна». В послужном списке ее предполагаемого брата происхождение указано открыто: «из князей Нагайского племени Кубанской области». По перечням 1872 года род был локализован в двух ногайских аулах Кубани.
Дальнейшие следы рассеялись по миру. Кадетский портрет одного из братьев обнаружился в альбоме выпуска 1906 года с автографом великого князя Константина Константиновича. Анкета беженки в Королевстве сербов, хорватов и словенцев свидетельствует о прибытии из Севастополя в январе 1921 года. В американских реестрах отец другой дочери фигурирует под латинизированным именем. Зафиксирована кончина выпускника Донского кадетского корпуса в Буэнос-Айресе в 1961 году, а также захоронение во Франции. Родство подтверждается не фамилией, а совпадением девичьей фамилии матери в анкетных данных двух братьев.
Карточка из лагеря военнопленных
Изначально военные базы выдали лишь одну строку: брат прабабушки пал в финском плену. Спустя две недели отыскалась его лагерная карта: в плену с 29 августа 1941 года, по гражданской специальности шофёр, артиллерист. Через месяц обнаружился лагерь № 9 у портового города Кеми — крупнейший распределитель советских военнопленных в Финляндии.
В графе извещения кириллицей указаны супруга и адрес в подмосковном населенном пункте. Так впервые выяснилось, что он состоял в браке. На обороте проставлена дата гибели «1.12.42» с формулировкой причины: дизентерия. Однако в фонде Национального архива Финляндии фигурирует 1 декабря 1941 года.
Агент не стал заниматься гаданием, а проанализировал лагерную статистику: в декабре 1941 года здесь зафиксировано 428 смертей, тогда как в декабре 1942-го — всего четыре. Следовательно, верна первая дата. Окончательную точку поставит личное дело из финского архива, шифры конверта уже известны. Мемориал на лагерном кладбище уцелел: обелиск гласит: «Здесь похоронено 1648 советских военнопленных».
Метрическая запись 1905 года: в местечке Каменка Киевской губернии крестят младенца — сына земского врача. Агент изучил сканированный оригинал: восприемницей выступает «дворянка Мария Николаева Давыдова, девица». Каменка являлась родовым гнездом Давыдовых, где собирались декабристы и где Петр Ильич Чайковский (чья сестра была замужем за одним из представителей семейства) подолгу жил и создавал свои произведения в период с 1865 по 1893 год.
Самым любопытным оказалось дальнейшее поведение ИИ. Проверив вторичную литературу, он обнаружил упоминание каменских Давыдовых в эпистолярном наследии самого композитора (в академическом собрании сочинений) — и самостоятельно удалил с сайта красивое, но документально неподтвержденное предположение из популярного источника. Именно ради подобного хладнокровия и выстраивались жесткие алгоритмические регламенты.
3. Движок: отделяем код от семьи
Спустя десять дней стало очевидно, что разработанная архитектура представляет самостоятельную ценность не только для нас. 7 октября состоялся релиз первой версии gene-archive — генератора сайтов семейных хроник. За неделю вышло пять обновлений, актуальная версия — 0.5.0. На официальной странице доступно демонстрационное древо вымышленного семейства.

Основной труд заключался в декомпозиции. В личном проекте кодовая база и семейные материалы переплелись: вопросы к родственникам были вшиты в компилятор, личные тексты — в шаблоны, а фамильные ветви — в скрипты. В движке всё это вынесено в конфигурационный файл (site.json) и стандартизованные структуры данных, регламентированные JSON-схемой.
Набор возможностей пополнился следующими функциями:
-
Интерфейсный редактор. Если в нашем случае правки вносили агенты, то рядовой семье необходимы удобные формы. Предусмотрены роли, предварительная валидация перед сохранением, блокировка одновременного редактирования и фиксация изменений от имени реального автора. Читатель может инициировать исправление прямо из персональной карточки.
-
Интеграция с GEDCOM. Поддерживается импорт из MyHeritage, Ancestry, Gramps и экспортирование в трех режимах: полная версия, выгрузка для сервиса Geni и безопасная публикация для открытых ресурсов без указания имен живых людей.
-
Защита персональных данных на уровне структуры. Информация о ныне живущих персонах ограничивается лишь именем. Хронология, локации и документы полностью элиминируются из публикуемого файла данных, а не просто скрываются визуальными средствами.
-
Модуль «Кем приходятся». Точное вычисление степеней родства («троюродный дядя», «свояченица») на трех языках. Родственники обращаются к этой функции чаще, чем к графическому древу.
-
Автономный поиск. Обработка имен, селений и терминов из расшифровок с учетом грамматических падежей, дореформенной орфографии и латиницы выполняется локально в браузере, что позволяет размещать проект на бесплатных статичных хостингах.


Технологический стек намеренно консервативен: чистый Python без тяжелых зависимостей (Pillow подключается опционально для миниатюр), ванильный JavaScript без громоздких фреймворков и Leaflet для карт. Портал развертывается на GitHub Pages или любом веб-сервере, а комментарии с редактором обслуживаются командой gene serve либо Docker-контейнером. Семейный архив должен пережить смену не одного поколения модных фреймворков.
Важнейшая деталь: каждый новый инстанс сайта комплектуется файлом AGENTS.md — сводом инструкций для Claude Code и Codex, поясняющим структуру данных, правила внесения находок и допустимые ограничения. Движок изначально проектировался в расчете на гибридное наполнение людьми и искусственным интеллектом.
Лицензирование выполнено под AGPL-3.0: программный код разрешено модифицировать и использовать, однако сервисы на базе измененного движка должны оставаться открытыми. На сами семейные архивы — персональные данные, тексты и медиафайлы — требования лицензии не распространяются.
4. MCP: чтобы метод работал с любым ассистентом
Движок определяет принципы хранения и визуализации. Однако наивысшую ценность представляет методология поиска: знание локаций метрических книг конкретных губерний, специфики работы с различными базами данных, правил трактовки старинных календарных дат и критериев достоверности родственных связей. Ранее эти алгоритмы существовали в виде инструкций AGENTS.md и ментальных моделей ИИ. 12 октября мы упаковали этот опыт в универсальный MCP-сервер genealogy-mcp.
Model Context Protocol (MCP) представляет собой стандарт интеграции инструментов с цифровыми ассистентами. Единый сервер подключается к Claude Desktop, Claude Code, ChatGPT, Cursor и VS Code, делая наработанную методологию независимой от конкретного вендора.

Состав сервера:
-
Справочник по 114 архивам и репозиториям в 55 государствах. Для каждого ресурса описано содержимое и специфика эффективного поиска, а также актуальное местонахождение фондов упраздненных исторических губерний с учетом изменения границ.
-
24 специализированные утилиты генеалога. Вариации имен, девять систем транслитерации, старый календарный стиль, вычисление дат по церковным праздникам, церковнославянская нумерация, расчеты родства, анализ ДНК и шаблоны официальных архивных запросов.
Программная реализация критериев доказательства. Функция
check_matchсопоставляет обнаруженную запись с эталоном по каждому параметру. Два независимых совпадения (помимо имени) подтверждают родство, одно трактуется как вероятное, а при наличии противоречий требуется привлечение третьего источника. -
Поисковая память. Локальный проект фиксирует персон, источники с полными шифрами, зацепки и все поисковые сессии (включая тупиковые с нулевым результатом), исключая дублирующие запросы.
Особый интерес представляет механизм интеграции находок, реализуемый командой gene apply. Правки от ИИ проходят те же валидационные процедуры, что и изменения пользователя через веб-интерфейс: проверки, регистрацию в журналах правок и поисковых запросов, коммит в git от имени создателя и перекомпиляцию сайта. Перед сохранением ассистент демонстрирует планируемые изменения и ожидает подтверждения. Аналогичный алгоритм функционирует при работе со стандартными файлами GEDCOM из MyHeritage или Gramps, где перезаписываются лишь модифицированные строки с созданием резервной копии.
Интеграция с Claude Code выполняется одной командой:
claude mcp add genealogy -- uvx genealogy-mcp
Для Claude Desktop предусмотрена установка в один клик через файл .mcpb, пакет опубликован в PyPI и официальном каталоге MCP. Сетевая активность ограничена исключительно запросами поиска, инициированными пользователем в рамках целевого ресурса.
Ряд ограничений заложен сознательно: утилиты, посредством которых мы выкачивали сканы из закрытых хранилищ, не включены в состав сервера, поддерживающего лишь открытые индексы (Internet Archive, WikiTree, Open Archives, Wikidata). Для прочих баз данных сервер генерирует прямые ссылки и навигационные подсказки для ручного поиска.
Уроки: чему пришлось научить агентов
За три недели журналы правок и поисковых запросов зафиксировали 286 и 440 записей соответственно. Это не показатель низкого качества, а основа надежности: агент непрерывно проводит самопроверку, а эволюция каждого факта абсолютно прозрачна. Без соблюдения этих принципов доверять архиву было бы невозможно.
Однофамилец не тождественен родственнику, а отчество не гарантирует отцовство. Модель склонна стремиться к установлению связей, воспринимая совпадение фамилии и населенного пункта как неоспоримое доказательство. Это правило закреплено на первом месте в инструкциях, а в MCP преобразовано в программный код: необходимы как минимум два независимых совпадения помимо имени. Сомнительные гипотезы маркируются как вероятные или отправляются в наработки, отображаясь на сайте пунктирными линиями.
Расшифровка исключительно по графическому оригиналу. Располагая датой из стороннего документа, модель склонна «видеть» ее и в текущей метрике. Каждое поле считывается визуально, неразборчивые фрагменты фиксируются как нечитаемые. Аналогичное требование действует при реставрации изображений: самовольно дорисованые надписи недопустимы.
Регистрация каждого изменения в системном журнале. Фиксируются исходное состояние, внесенная правка, причины и доказательная база. Фиксируются даже безрезультатные поиски, чтобы исключить повторное обращение в тупиковые ветви.
Скрупулезный обход всего пула источников. Обнаружив зацепку в одной базе, агент склонен концентрироваться исключительно на ней. Инструкции предписывают использовать полный перечень ресурсов и отчитываться о проверенных и непроверенных направлениях.
Разделение зон ответственности между агентами. Над проектом параллельно трудятся Claude Code и Codex. Сборка и деплой сериализованы через блокировку, перед фиксацией изменений выполняется git status во избежание пересечений. Задачи по реставрации фото передаются Codex в изолированном виде, исключающем составление пространных текстовых отчетов.
Автоматизированный контроль верстки. Перед каждым релизом Playwright тестирует сайт в эмуляторах Safari (на iPhone и десктопе) и Chromium. При двукратном сбое сборка отменяется.
Отдельной сложностью остается взаимодействие с архивными платформами. FamilySearch блокирует IP-адреса (ошибка 429) примерно после трех тысяч загруженных кадров. Капчи на «Памяти народа» вводятся вручную. Часть российских государственных ресурсов функционирует исключительно с отечественными криптосертификатами, а ряд зарубежных баз доступен только из-за рубежа. Кроме того, существуют действия, накладывающие категорический запрет на самовольную активность агента: отправка писем в государственные архивы и живым родственникам выполняется исключительно после моего подтверждения.
Как попробовать
Развертывание персонального семейного сайта:
pip install "gene-archive[images]"
gene init my-family --example
gene serve my-family
Подключение поискового ассистента к Claude Code:
claude mcp add genealogy -- uvx genealogy-mcp
Задайте ассистенту вопрос: «Помоги найти прадеда. Вот что мне известно…»
-
Движок: github.com/igormel81/gene_archive, демонстрация на вымышленном роде, лицензия AGPL-3.0.
-
MCP-сервер: github.com/igormel81/genealogy-mcp, доступен в PyPI и официальном каталоге MCP, лицензия MIT.
Буду признателен за issues, рассказы о ваших генеалогических поисках и предложения по расширению каталога архивных источников.
Похожие статьи
 Вычисления на логарифмической линейке: умножение и деление
 Как искусственный интеллект покоряет большую математику: от Навье — Стокса до упаковки сфер и Lean
 Магия кино до CGI: как снимали без компьютерной графики, секреты Лукаса и первые ЭВМ на съемочной площадке
 Срок актуальности ИИ-бенчмарков сократился вдвое — до 19 месяцев
 Искусственный интеллект и грядущее планеты
 Эволюция и закат плазменных телевизоров
 Осень. Срочно зовите Перельмана — я доказал гипотезу Римана
 Как нейросети обходят классический поиск при сборке кубика Рубика с помощью CayleyPy