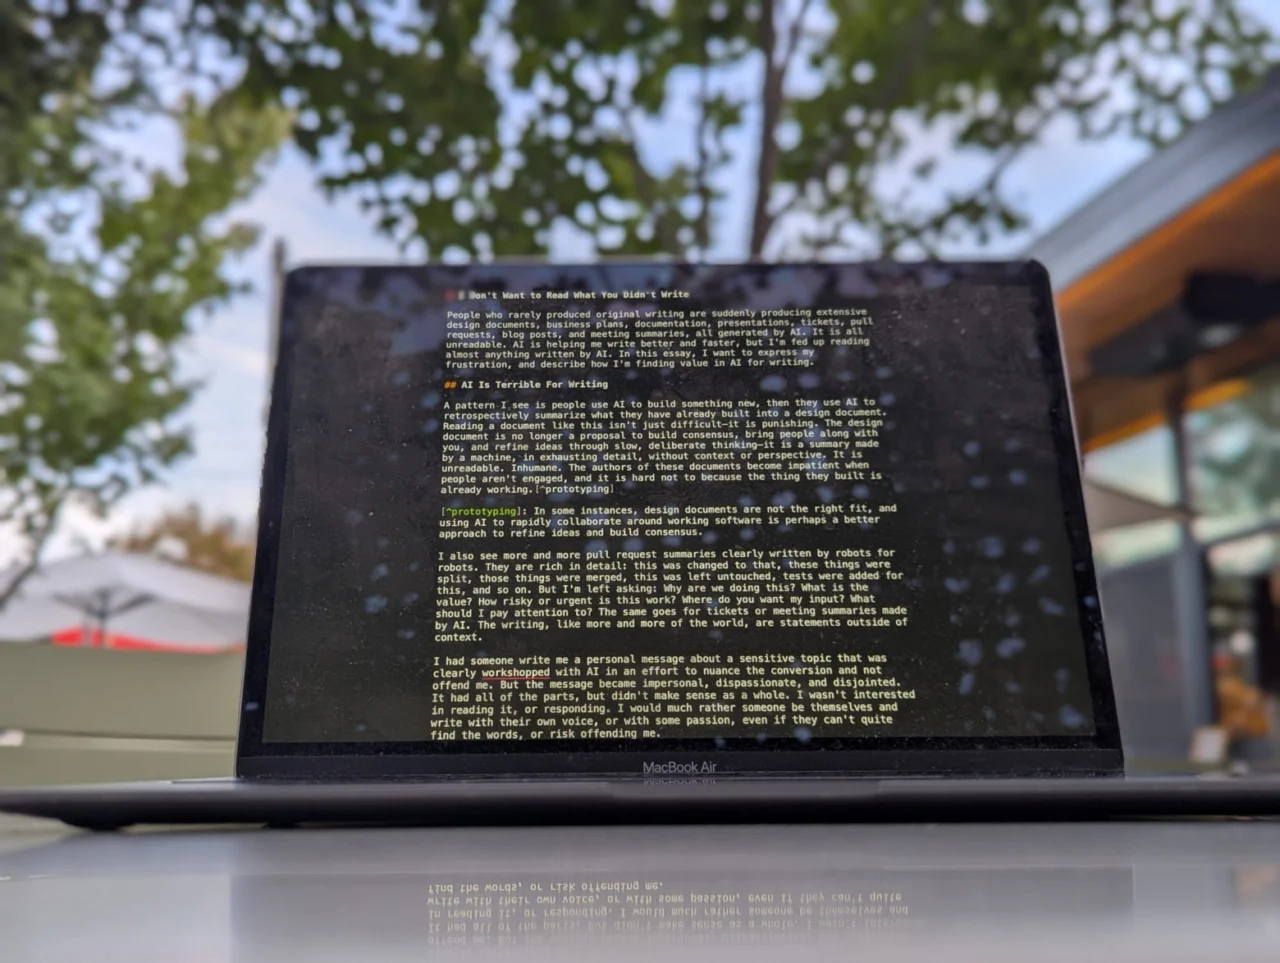
Укажите заголовок, который нужно перефразировать
Люди, которые раньше почти ничего не сочиняли самостоятельно, теперь массово штампуют масштабные проекты, стратегии, техзадания, презентации, тикеты, пул-реквесты, статьи и протоколы встреч. Всё это за них делают языковые модели. Беда в том, что читать подобные тексты невыносимо. Нейросети действительно помогают мне писать быстрее и качественнее, однако меня уже откровенно тошнит от контента, созданного искусственным интеллектом. В этой статье я хочу высказать своё наболевшее и заодно поделиться тем, в чем лично для меня кроется истинная ценность ИИ при работе с текстом.
ИИ пишет отвратительно
Я замечаю типичную тенденцию: человек привлекает нейросеть для генерации концепции, после чего с помощью той же нейросети задним числом упаковывает всё это в дизайн-документ. Вникать в такую бумагу — настоящее испытание. Подобный документ перестаёт быть живым предложением для поиска компромиссов и постепенного обсуждения идей; он превращается в машинную выжимку, перегруженную нудными деталями, но полностью лишённую контекста и авторской позиции. На выходе мы получаем бездушную, нечитаемую массу. «Авторы» подобных опусов искренне возмущаются, когда их никто не читает, хотя и поделом — ведь сам созданный ими продукт при этом работает[1].
Более того, я всё чаще натыкаюсь на описания пул-реквестов, которые явно написаны роботами для роботов. Там скрупулезно перечислено каждое движение: это перенесли туда, то разбили на модули, здесь объединили, это не трогали, а вот тут накинули тестов. Но у меня неизбежно возникают вопросы: зачем мы вообще всё это затеяли? В чём практическая польза? Насколько это критично и срочно? Чего ждут от меня лично? Куда смотреть в первую очередь? То же самое касается тикетов и автоматических конспектов. Текст, как и многие сферы нашей жизни, стремительно превращается в набор бессвязных тезисов.
Однажды мне пришло личное сообщение на деликатную тему, которое очевидно было сгенерировано нейросетью — чтобы учесть все тонкости диалога и случайно никого не обидеть. В ту же секунду послание утратило всякую человечность, превратившись в мертвую, корявую конструкцию. Все элементы вроде бы на месте, но единого целого не ощущается. Читать это и тем более отвечать желания не было никакого. Уж лучше бы автор написал всё своими словами — пусть неуклюже и задев меня за живое, зато искренне.
Нормальные человеческие отношения всегда строятся на уязвимости и риске. В общении с ИИ нет ни того, ни другого, а попытки обезопасить себя от этого напрочь убивают сам смысл коммуникации. В своём эссе Resist Summary, к которому я постоянно возвращаюсь, Саймон Сэррис метко заметил:
Я убежден, что человек должен писать опираясь исключительно на собственный опыт и переживания, транслируя читателю свое уникальное видение жизни и происходящего.
Пожалуй, самым ленивым и оскорбительным примером использования ИИ в моей практике стало то, когда в ответ на мои замечания по чьей-то идее мне прислали… краткую выжимку моих же комментариев, сгенерированную нейросетью! Огромное спасибо! Сам бы я сформулировать лучше, конечно же, не смог[2].
У вас есть контекст, которого нет у меня
Некоторое время назад Синтия Данлоп представила результаты исследования Report: How developers react to AI-scented blog posts, посвященного восприятию текстов, созданных искусственным интеллектом. Большинство респондентов признались, что если они подозревают авторство нейросети, то сразу бросают чтение (78%) и стараются больше не иметь дел с таким автором (71%). Брайан Кэнтрилл очень точно прокомментировал эту работу в своем эссе The revolt of the reader: «натолкнувшись на продукт работы LLM, наш мозг прямо посреди предложения дергает за аварийный рычаг катапультирования, пытаясь нас спасти».
Самым показательным итогом опроса стало то, что абсолютное большинство участников (98%) предпочитают оригинальный текст автора — со всеми его огрехами и особенностями, — нежели идеализированную, но пустую переработку от ИИ. Искреннее творчество остается одним из лучших мостиков между людьми. Это сразу напомнило мне слова создателя C++ Бьёрна Страуструпа, сказанные им на панельной дискуссии о писательстве больше десяти лет назад:
Когда я читаю книгу и слышу в мыслях голос автора со всеми его характерными интонациями и словесными привычками, я понимаю, что это нечто поистине прекрасное. Если же текст выглядит как сухая академическая выжимка, значит, перед нами просто очередная сухая академическая выжимка. В этом плане очень полезно выступать с докладами. Многих людей я буквально «слышу», когда читаю их работы, и это великолепно.[3]
Если вы самостоятельно формулируете промпты для нейросети, результат часто оказывается весьма достойным. Но не стоит путать это с настоящим мастерством слова. Когда вы читаете сгенерированный материал, у вас уже есть колоссальный массив фоновых знаний — вы сами задавали вводные, определяли рамки и скармливали модели исходники (документацию, код, логи, метрики, графики). Вы способны окинуть взглядом результат и мгновенно отсеять зерна от плевел. Вы сами были частью этого творческого акта, соединив в себе и запрос, и ответ. Вы привнесли в машину живую человеческую мысль. Однако когда вы пересылаете этот же текст кому-то другому, у того человека этого контекста нет. Он не участвовал в процессе, а потому ему невероятно трудно понять, что здесь действительно важно, а что — «вода». Ему приходится продираться через каждую строчку, изучая внутренности механизма в надежде хоть за что-то зацепиться. Ничего удивительного, что в какой-то момент он просто закрывает вкладку.
В чем же реальная польза ИИ для письма
Недавно я завершил работу над научной статьей[4]. Я активно привлекал ИИ на всех этапах, что здорово сэкономило время и сделало процесс более увлекательным. При этом нейросеть не написала ни единого предложения от себя. Я работал в LaTeX, а в качестве контекста передавал модели требования к оформлению журнала, шаблон, все ранее опубликованные в издании выпуски, исходный код исследуемых систем, а также конфигурации, логи и продакшн-метрики.
Написав очередной абзац, я обычно просил модель перепроверить фактуру по коду, конфигам или логам. Например, корректно ли указаны индексируемые столбцы базы данных или порядок сортировки строк в Parquet-файлах. Пока ИИ занимался проверкой, я не терял мысли и спокойно переходил к следующему фрагменту. Это помогало вовремя замечать огрехи и неточности. Примечательно, что обратная схема — когда я просил нейросеть самостоятельно написать абзац по моим наброскам или описанию кода — не сработала ни разу. Этот результат всегда отправлялся в корзину: его было неприятно читать, да и фактологических ошибок хватало.
Еще одна задача, где ИИ оказался незаменим для поддержания рабочего темпа — это оформление библиографии. Утомительные поиски деталей в статьях, на сайтах или в книгах, ручное заполнение BibTeX-формата и расстановка ссылок жутко отвлекают. Вместо этого я просто оставлял в тексте пометки для нейросети, формулируя, какая именно ссылка мне нужна, и продолжал писать дальше, не теряя концентрации[5].
Кроме того, ИИ проявил себя великолепным и подчас безжалостным редактором, блестяще исправляющим орфографию и пунктуацию. Он предлагал изящные варианты упрощения громоздких и запутанных конструкций[6]. Модель отлично справлялась с генерацией графиков на TikZ, избавив меня от необходимости штудировать синтаксис. Более того, ИИ отловил тончайшую логическую ошибку в одном из абзацев — оплошность, которую пропустили все четверо квалифицированных рецензента, досконально знающих систему[7].
Единственное, с чем ИИ справился на абсолютную пятерку — это написание аннотации (abstract). Самого сухого, механического и безликого раздела всей работы. В итоге я вставил её в статью вообще без правок. Впрочем, это закономерно: модели превосходно умеют суммаризировать, абстрагироваться и сжимать готовую суть.
Сможет ли ИИ когда-нибудь стать хорошим автором?
Было бы наивно недооценивать вершины, которые со временем покорятся искусственному интеллекту. Мы находимся лишь на заре эпохи LLM, и большинство современных моделей натасканы на максимальную точность, буквальность и корректность, а не на полет фантазии. Как метко подметил Мурат Демирбас в своей блестящей статье The Safest Job from AI may be Writing, эволюция текстов, создаваемых LLM, уперлась в потолок: в отличие от программирования, математики или финансов, в письме крайне трудно сформулировать четкие критерии и верифицируемый результат[8].
Поскольку у нейросетей нет внутренней ментальной модели живого читателя, они занимаются лишь банальной оптимизацией вероятностей появления следующего слова на базе гигантских датасетов. Они физически не способны прочувствовать читателя, потому что у них нет за плечами прожитой человеческой жизни. И у них напрочь отсутствует личная заинтересованность в предмете.
Меня заинтересовали два недавних проекта, направленных на борьбу с «искусственностью» в текстах. Первый — это ASD-STE100 Simplified Technical English, стандарт технического письма, зародившийся еще в 80-х годах в недрах аэрокосмической индустрии. Он включает в себя строгий словарь, а также свод грамматических и стилистических норм. Энтузиасты даже адаптировали ASD-STE100 специально для работы с ИИ-моделями[9]. Разумеется, это решение не универсально, но оно отлично подходит для создания четких, однозначных инструкций и регламентов. Обязательно протестирую его на руководствах по развертыванию.
Трудно с этим не согласиться. Брайан начал экспериментировать с Pangram для отсева сгенерированного мусора и ввел жесткое правило: все публичные материалы его компании Oxide должны проходить проверку в Pangram, подтверждающую их человеческое происхождение. Подобные инициативы способны защитить нас от вала ленивого и низкосортного контента[10].
Когда слова бессильны
Когда мы беремся за перо, значение наших слов далеко не всегда сводится к сухой фактологии и краткости. Вспомните поэзию, художественную прозу, тексты песен, мифологию, сатиру или драматургию. Иэн Макгилкрист, один из глубочайших мыслителей современности, пишет в своем труде The Matter with Things: «Чем значительнее тема, тем больше усилий приходится прилагать, пытаясь облечь ее в языковую форму». Попросите нейросеть подсказать безотказный способ влюбиться в кого-нибудь: модель выдаст гладкий текст, создающий иллюзию смысла. Но имитируя человеческую эрудицию и понимание, ИИ оперирует фактами совсем иначе, чем тот, кто пропустил этот опыт через себя. Живое целое невозможно препарировать на запчасти без катастрофической потери смысла.
Лобовой подход неизбежно убивает саму суть явления. Точно так же существуют вещи, которые поддаются выражению лишь намеком. Чтобы передать истинную глубину или сказать нечто принципиально новое, нам вечно приходится выходить за флажки повседневного языка, проявляя чуткость к тому, что выражено между строк.
Утверждение о том, что корпоративная документация, технические отчеты или научные труды должны нести в себе долю неопределенности, а не только выводы и графики, кому-то покажется ересью. Но реальная инженерия, реагирование на инциденты, разработка продуктов, аудит безопасности, постановка целей и тысячи других задач — это творческие процессы, по определению сопряженные с неопределенностью. Нарратив здесь порой важен ничуть не меньше, чем сухие цифры. Нам свойственно наделять LLM чертами сильных системных аналитиков лишь потому, что они способны перелопатить гигантские пласты информации. Однако, возвращаясь к словам Саймона Сэрриса, напомним: «нарратив сопротивляется компрессии», а «противоположность аннотированию — это внимание к деталям».
Как бы мы ни стремились к линейной логике, деятельность толкового системного инженера — точно так же, как работу хорошего антрополога или психолога — невозможно втиснуть в рамки тезисов и уж тем более коротких выжимок. Мы мыслим и фиксируем наблюдения не по жестким лекалам. Даже при фиксации фактов неизбежно теряется часть контекста, ведь наблюдатель — неотъемлемая его часть. Настоящая инженерная работа всегда оставляет пространство для исследования, готовности столкнуться с неизвестным, выстраивания тонких взаимосвязей и банального удивления. В привычном обиходном лексиконе просто не всегда находятся подходящие слова[11].
Суть любых кратких выжимок — ускорение процесса. Но платой за это становится отказ от построения собственной, глубокой ментальной модели. Больше всего меня пугает то, что, не имея в голове сложной структуры представлений, человек разучивается замечать неявные взаимосвязи, которые растворяются в процессе компрессии. Вместе с ними исчезает и внимание к деталям.
Заключение
Я не хочу жить в реальности, где вы скармливаете нейросети важные вещи, получая на выходе нечитаемую выжимку, а я потом пытаюсь расшифровать ее с помощью другой нейросети. Мне нужен вы — со всеми вашими изъянами и уникальным почерком. Мне важна ваша авторская оптика, ваше понимание прекрасного, качества, времени и отношений. Мне нужно чувствовать вас. Мне необходимо, чтобы вы отсеяли шелуху и показали, что имеет истинную ценность. Я отказываюсь читать суррогаты фактов, оторванные от реального опыта и человеческих связей. Как справедливо отмечает Иэн Макгилкрист, наш способ присутствия в мире формирует саму ткань этого мира, а иной реальности у нас нет[12].
Перепоручая машине рутину, вы рискуете заказать не то, что вам на самом деле нужно, а то, с чем машина справляется лучше всего. Если алгоритм отлично умеет делать краткие выписки и вы делаете на него ставку, вы начинаете формулировать вопросы так, чтобы подстроиться под удобные для него ответы. Это похоже на обучение машины вашим потребностям, но параллельно вы переучиваете самих себя смотреть на мир через узкую щель шаблонов. Какие же вопросы при этом выпадают из нашего поля зрения?
Пожалуй, в перспективе ценность осознанного письма будет только расти. Авторы, которые пишут ради осмысления, глубокой рефлексии, созидания или поиска смыслов между строк, продолжат создавать подлинные произведения. Те же, кто никогда не умел писать, теперь просто станут кнопконажимателями фабрик по производству контента.
По мере того как объемы сгенерированного хлама будут расти, мы, вероятно, начнем замечать деградацию самих себя — возможно, потому, что мы сами стали мыслить более поверхностно. Одержимость поспешной определенностью сужает нашу человечность. Порой куда важнее не находить нужных слов. Я не хочу читать то, чего вы не писали.
-
Разумеется, бывают ситуации, когда дизайн-документы избыточны, и здесь оперативная совместная работа с кодом при поддержке ИИ оказывается куда эффективнее для согласования идей. ↩︎
-
Был и другой показательный случай: команда слаженно вела проект через компромиссы на wiki-страницах. Новоприбывший участник захотел продавить свои правки. Вместо того чтобы пройти через непростой процесс обсуждения с коллективом, он просто скормил всю текущую документацию нейросети, сгенерировал новую страницу и залил ее поверх чужих трудов, протолкнув свои изменения. ↩︎
-
Эту цитату я уже приводил в материале Techniques for Improving Your Technical Writing. ↩︎
-
Речь идет о созданной мной архитектуре базы данных, которую я рассчитываю представить на Conference on Innovative Data Systems Research (CIDR). ↩︎
-
К примеру, я просто писал в скобках
{TODO: reference the Amazon Aurora paper}, а всю рутину по оформлению доверял модели. ↩︎ -
Я регулярно использую нейросеть для редактуры своего блога — свежий взгляд со стороны придает уверенности перед публикацией. Но я строго запрещаю ей переписывать текст или искажать мою тональность. Только поиск стилистических и логических ляпов. ↩︎
-
Я разбирал структуру log-structured merge (LSM). Изначально мы называли поколения Gen1, Gen2, Gen3. В тексте статьи я обобщил концепцию до стандартных L0, L1, L2. Из-за этого мои коллеги, привыкшие к старой терминологии, при вычитке запутались и не заметили мою ошибку, где я случайно перепутал индексы. ИИ же нашел эту нестыковку моментально. ↩︎
-
Еще одна любопытная статья на тему ограничений ИИ в писательстве и проблемы авторского голоса — материал Джасмин Сан The Human Skill That Eludes AI: Why can’t language models write well?, опубликованный в журнале The Atlantic. ↩︎
-
Спасибо Крису Риккомини за наводку на этот стандарт. ↩︎
-
Желающим углубиться в тему рекомендую выпуск подкаста Oxide and Friends с основателем Pangram Максом Сперо. Там обсуждается интересное наблюдение: люди, постоянно использующие LLM, на удивление легко распознают их почерк, в то время как те, кто с ними не работает, слепы к этому. Также там разбираются попытки реверс-инжиниринга промптов для оценки доли участия нейросети в тексте. ↩︎
-
Лучшие системные архитекторы, которых я знаю, как правило, прекрасно владеют словом. Убежден, что этот навык не потеряет актуальности, а лишь возрастет в цене. Как резюмирует Мурат Демирбас в финале своего эссе: «Возможно, сама разработка ПО постепенно трансформируется в разновидность творческого письма, где мнение значит больше, чем жесткая архитектура». ↩︎
-
Иэн также разделяет понятия comprehension (охмещение мира как целостности) и apprehension (удержание, овладение миром через тревожное предчувствие). Разница между ними кроется в природе внимания. Настоятельно советую посмотреть лекцию Иэна AI and the Battle for the Soul: Information is Not Understanding в Ральстоновском колледже. ↩︎
Похожие статьи
 Игры с ценами на ИИ: три валюты, в которых нам выставляют счета
 Японский робот-официант из 1980-х, поразивший воображение
 Как фантасты подходили к проблеме обучения
 Математический мультивёрс: тривиализм Вавилонской библиотеки или гиперхаос Книги песка?
 Вычисления на логарифмической линейке: умножение и деление
 Как ИИ-агенты за три недели оцифровали мой семейный архив и к чему это привело
 Как искусственный интеллект покоряет большую математику: от Навье — Стокса до упаковки сфер и Lean
 Магия кино до CGI: как снимали без компьютерной графики, секреты Лукаса и первые ЭВМ на съемочной площадке