Как я вручную создал винный бенчмарк на 3 266 вопросов с помощью LLM и где нейросети меня подвели
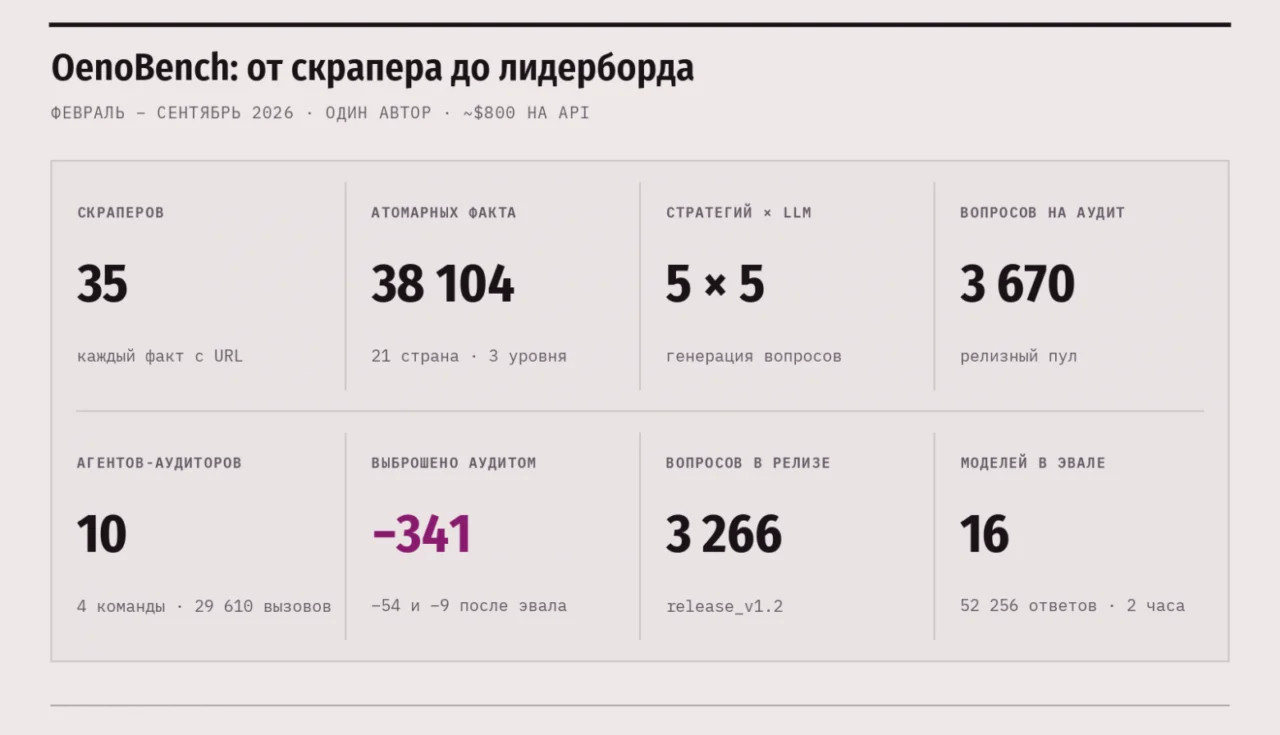
OenoBench в цифрах: от скрапера до лидерборда
В феврале я задался целью выяснить, какими познаниями о вине обладают современные языковые модели. Беседы о тонкостях Бордо меня не привлекали; мне было любопытно, знают ли нейросети точную продолжительность выдержки Бароло в бочках или в каком именно округе Вашингтона расположена AVA Beverly. К сентябрю этот эксперимент трансформировался в бенчмарк OenoBench: 38 104 факта, собранных из открытых источников усилиями 35 скраперов, 3 266 тестовых вопросов с вариантами ответа и полноценный прогон шестнадцати моделей. Львиную доля работы выполнили агенты: пять моделей генерировали вопросы, а десять аудиторских агентов их проверяли. Единственным человеком в этой цепочке оставался я — на мне лежала задача контролировать то, что ИИ оценить не способен: само вино.
Итоговые затраты на API составили около $800. Полученную исследовательскую работу я направил на конференцию NeurIPS 2026 в профильный трек Datasets & Benchmarks. Далее я подробно расскажу о мотивах и ходе работы, о трансформации фактов в вопросы, о баталиях десяти агентов по поводу их качества, о допущенных ошибках и результатах тестирования шестнадцати моделей.
Что я делал и зачем
У меня за плечами диплом WSET 4-го уровня (Wine & Spirit Education Trust — престижная британская система винного образования, являющаяся высшей ступенью и стандартным трамплином для поступления на программу Master of Wine). Параллельно я активно взаимодействую с языковыми моделями и веду проект, посвященный внедрению ИИ в виноделие. На стыке этих компетенций и возник резонный вопрос. Когда модель рассуждает о вине, объективно оценить ее может лишь эксперт. Общепринятые тесты вроде MMLU или GPQA детально исследуют успехи ИИ в точных науках или юриспруденции, но обходят стороной способность отличать Бароло от Барбареско. Между тем в индустрии, где алгоритмы уже создают дегустационные заметки, консультируют покупателей и подбирают гастрономические пары, это ключевой аспект.
При этом винная сфера идеально подходит для тестирования. Виноделие строго регламентировано: французские AOC, итальянские DOCG, американские AVA представляют собой не субъективные мнения, а тысячи страниц нормативных актов с четкими географическими границами, разрешенными сортами лозы и лимитами урожайности. Каждый вопрос здесь имеет абсолютно верный ответ. Необходимые данные открыты: Wikidata распространяется под лицензией CC0, Wikipedia — под CC BY-SA, к вашим услугам официальные реестры французского INAO, американского TTB и справочник AVA от Калифорнийского университета в Дэвисе. Это позволило мне верифицировать факты самостоятельно, не привлекая сторонних специалистов.
Идея заключалась в том, чтобы агрегировать разрозненные факты из открытых источников в единую базу с обязательными ссылками на первоисточники. Затем преобразовать их в вопросы с четырьмя вариантами ответа, охватывающие шесть основных категорий: регионы, сорта винограда, производителей, агрономические практики, виноделие и винный бизнес. Вопросы подразделялись на четыре категории сложности — от базового уровня L1 до экспертного уровня Master of Wine (L4). Финальной целью было заявлено создание 5 000 вопросов к дедлайну NeurIPS в мае. В качестве иллюстрации приведу пару примеров из итоговой базы:
-
L2: Moscato di Scanzo holds Italy’s DOCG status. In which Italian region is this appellation located? Ответ: Lombardy.
-
L4: The regulatory boundaries for which American Viticultural Area are codified specifically within Title 27, section 9.172 of the Code of Federal Regulations? Ответ: West Elks.
Существовало лишь одно жесткое ограничение, продиктовавшее всю архитектуру проекта: я работал в одиночку. Хотя квалифицированный сомелье способен составить 5 000 вопросов вручную, это заняло бы полгода непрерывного труда. Следовательно, генерацию должны были осуществлять нейросети, а их валидацию — другие алгоритмы. Моя роль свелась к калибровке процесса: разметке выборок, мониторингу согласия агентов и принятию окончательных решений.
Общая схема отражена на диаграмме ниже, и дальнейшее изложение следует ее логике сверху вниз.

Хронология проекта выглядит следующим образом: с февраля по апрель разрабатывались скраперы и собирались факты, с апреля по начало мая шла генерация и аудит, 3 мая состоялся финальный тестовый прогон шестнадцати моделей, а 4 мая была отправлена заявка на конференцию. В летний период проводились дополнительные проверки самого массива данных. Начну с первой обнаруженной проблемы.
17 скраперов из 35 ничего не скрапили
Первые сборщики данных были написаны в феврале. К началу апреля база насчитывала около 27 тысяч фактов, дашборд радовал глаз зелеными индикаторами, и я готовился приступить к генерации.
7 апреля я сделал то, что следовало предпринять еще в феврале: проверил каждый скрапер на предмет того, какие именно данные он выкачивает. Вот фрагмент файла italy.py в том виде, в каком он хранился в репозитории с 14 февраля:
# ─── Structured DOCG Knowledge Base ──────────────────────────────────────────
# This is the guaranteed fallback: a well-known fixed list of all 77 DOCG
# appellations with structured data compiled from multiple public sources.

DOCG_DATABASE = [
    # ── Piedmont (17 DOCG) ──
    {
        "name": "Barolo",
        "region": "Piedmont",
        "classification": "DOCG",
        "colors": ["red"],
        "grapes": ["Nebbiolo"],
        "grape_pct": "100% Nebbiolo",
        "aging_months": 38,
        "aging_wood_months": 18,
        "riserva_months": 62,
        "yield_tons_ha": 8.0,
        "notes": "Must be aged for a minimum of 38 months, including 18 months in wood.",
    },
    # ... ещё 75 записей
]
«Guaranteed fallback». Чуть ниже в скрипте функционировал корректный HTTP-клиент с задержками между запросами, обращавшийся к сайту консорциума. Вот только полученные данные никуда не сохранялись: факты формировались на основе упомянутого захардкоженного списка и заносились в базу с пометкой «источник: Federdoc». Этот перечень в свое время сгенерировала модель при написании кода скрапера. Большинство параметров оказались верными — Claude действительно превосходно осведомлен о требованиях к Бароло. Однако ни одно утверждение не было подкреплено реальной ссылкой, что для бенчмарка академического уровня недопустимо. Если факт извлекается из памяти нейросети, мы тестируем не ее знания, а внутреннее эхо.
Выяснилось, что 17 скраперов функционировали без единого реального запроса. Еще 8 работали наполовину: шесть совмещали внутренние знания модели с реальным парсингом, а оставшиеся перегружали базу избыточными SPARQL-запросами и неатомарными абзацами. В период с 7 по 11 апреля мне пришлось переписать всю систему:
-
из базы было удалено 12 563 факта, не имевших под собой реальных сетевых вызовов (4 702 в первый же день после переписывания шести смешанных скраперов и еще 7 861 после обработки полностью захардкоженных модулей; после чистки осталось 16 702 записи);
-
17 скраперов были написаны заново с ориентацией на Wikipedia, Wikidata и официальные реестры, а 8 исправлены;
-
в ходе трех ревизий кода было удалено 31 700 строк и добавлено 12 283. Один лишь файл
europe.pyсократился с 4 846 до 1 010 строк.
После реорганизации удалось собрать 38 104 факта, каждый из которых получил уникальный source_id со ссылкой на URL. В итоговой базе не осталось ни одного бесхозного факта или ссылки без подтверждения. Первые шесть обновленных скраперов выдали примерно на 60 % меньше данных по сравнению со своими «гарантированными» предшественниками, и это был закономерный результат.
|
Источник |
Фактов |
Доля |
|---|---|---|
|
Wikipedia (265 страниц-источников) |
13 083 |
34,3 % |
|
Wikidata (SPARQL) |
11 806 |
31,0 % |
|
Датасеты HuggingFace и Kaggle |
4 739 |
12,4 % |
|
INAO, UC Davis, TTB, журналы, прочее |
8 476 |
22,2 % |
В представленной таблице отсутствует географическая разбивка, хотя в ней таится перекос: на Португалию приходится 6 176 фактов (16 % базы). Виной тому особенности Wikidata. Сотни португальских приходов (freguesias) зарегистрированы там как винодельческие регионы с указанием площади в гектарах, и SPARQL-запрос добросовестно вытянул их все: «União das Freguesias de Vila Cova e Feitos is a wine region in Barcelos, Portugal», «São Jacinto covers approximately 13.84 hectares». Юридически это подтвержденные факты, фактически — фрагменты административной карты Португалии. С этим несоответствием в дальнейшем пришлось бороться на этапе сэмплирования.
Главный урок здесь заключается не в особенностях работы Claude. Захардкоженные массивы данных выглядят абсолютно безобидно: это типичные словари, успешно проходящие тесты и попадающие в хранилище с правдоподобными метаданными. Если код генерирует нейросеть, а результаты идут в научную работу, происхождение данных (provenance) требует отдельного аудита; простое ревью дифф-файлов здесь не поможет. Я читал диффы внимательно, но тысячестрочный список с именем DOCG_DATABASE не вызвал у меня подозрений, поскольку казался разумным резервным решением.
Как абзац из Wikipedia становится фактом
Большинство скраперов (25 из 35) пропускают извлеченный текст через универсальный пайплайн _fact_processing.py. Именно здесь текст источника трансформируется в пригодную для базы форму:
-
Декомпозиция. Сложные предложения разбиваются по союзам на атомарные суждения; фрагменты, лишенные подлежащего, достраиваются из контекста. Предельная длина — 30 слов.
-
Разрешение анафор. Местоимения вроде «it», «the estate», «he» заменяются конкретными наименованиями сущностей.
-
Классификация домена. Текст распределяется по шести доменам на основе ключевых слов с приоритетами, исключающими сваливание всего массива в категорию «регионы».
-
Валидация. Отсеиваются факты короче пяти слов, лишенные глаголов или содержащие неразрешенные местоимения.
-
Тематическая фильтрация. Региональные словари отсекают посторонний мусор (например, австрийские факты, проникшие в скрапер Бордо через транзитивные запросы
P131*в Wikidata).
Типичный факт в базе выглядит так: «Arlanza is a Spanish Denominación de Origen Protegida (DOP) located in the provinces of Burgos and Palencia, Castile and León, Spain». Одно утверждение, одна сущность, один URL. Если из исходного текста невозможно сформировать самостоятельное проверяемое предложение, факт отбраковывается.
После завершения сборки была проведена дополнительная фильтрация, устранившая 1 916 сомнительных записей из 40 020: в частности, 224 почти полных дубликата, 1 422 бессодержательных шаблона вроде «X is a wine region in Y» из португальского сегмента Wikidata, 100 усеченных фраз, 72 фрагмента с неразрешенными местоимениями (еще 129 удалось исправить автоматически), 24 предложения длиннее 50 слов, а также некоторое количество маркетингового спама и новостей о спорте, случайно попавших в выборку по ключевому слову «wine». Факты длиной от 31 до 40 слов получили понижающий коэффициент достоверности 0,8, а длиннее 40 слов — 0,6. Каждый источник имеет свой весовой коэффициент надежности: первый уровень (официальные реестры, университетские базы, часть Wikidata) обеспечил 19,6 % фактов; второй (Wikipedia, оставшаяся часть Wikidata и датасеты) — 76,6 %; третий — 3,8 %. Все HTTP-запросы выполняются с индивидуально настроенными паузами (от 1,5 до 10 секунд, чаще 5) и информативным заглавием User-Agent.
Генерация: пять стратегий, пять моделей и 99 % брака на входе
Из собранных фактов необходимо было сформировать вопросы с вариантами ответов (как правило, четырьмя). Чтобы избежать монотонности, разнообразие закладывалось по двум направлениям.
Стратегии. Было задействовано пять генераторов, объединенных общим контрактом: на вход подается один или несколько фактов и целевой уровень сложности, на выходе формируется Pydantic-модель вопроса.
|
Стратегия |
Суть процесса |
В релизе |
|---|---|---|
|
fact_to_question |
один факт преобразуется в вопрос с набором дистракторов |
1 909 |
|
distractor_mining |
поиск «конкурирующих» сущностей (соседний AOC, родственный сорт) для построения вопроса |
405 |
|
template |
48 детерминированных шаблонов без участия LLM, перефразированных моделью Haiku 4.5 |
389 |
|
scenario_synthesis |
кластер из трех взаимосвязанных фактов конвертируется в прикладной кейс от лица сомелье или винодела |
319 |
|
comparative |
сопоставление пары фактов по единым критериям (выдержка, урожайность, высота над уровнем моря) |
244 |
Модели. Генерация выполнялась через OpenRouter с ограничением в 35 % на долю одной модели, чтобы исключить стилистический «акцент» конкретного движка. Использовались Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, Hermes-3 на базе Llama 3.1 405B и Qwen3 235B. В итоговый релиз вошли: Qwen (667 вопросов), Llama (629), Claude (619), GPT (542), Gemini (420) и шаблонные формулировки (389). Необходимость удержания в ротации слабых генераторов станет очевидна при обсуждении феномена self-preference.
Промпты для каждой стратегии включали важнейший блок, добавленный после третьего пилотного тестирования аудита. Приведу его дословно из файла _prompts.py:
AVOID WORLD-KNOWLEDGE SOLVABILITY:
- DO lead questions with an OBSERVABLE ATTRIBUTE from the source fact (aging
  months, soil type, yield limit, phenolic threshold, clone name, altitude,
  specific varietal %, regulatory minimum, grape blend percentage) and ask the
  test-taker to infer the entity.
- If the only fact-specific content is a famous entity name with no
  technical/regulatory/attribute detail, output instead:
  {"skip": true, "reason": "Iconic entity without fact-specific technical depth"}
Возможность легально ответить «пропускаю» оказалась эффективнее большинства прочих корректировок промптов. Ранее на базе факта вроде «Бароло — знаменитое вино Пьемонта» генератор неизменно создавал вопрос «В каком регионе производят Бароло?», на который любая модель с легкостью отвечала без всяких первоисточников.
Оркестратор. Рабочий процесс делился на ячейки «стратегия × домен × генератор»; уровень сложности определялся стратегией автономно. Для каждой ячейки рассчитывалась квота, а сэмплер отбирал факты с весами, обратными доле конкретной страны в базе (иначе Португалия с ее 16 % фактов монополизировала бы вопросы). Генератор получал инструкцию, ответ проверялся схемой валидации, варианты ответов перемешивались (поскольку модели склонны размещать правильный вариант на позиции A значительно чаще остальных), после чего кандидат сопоставлялся с уже существующими вопросами по косинусному расстоянию эмбеддингов в pgvector с порогом 0,92. Успешные кандидаты фиксировались в базе вместе с полными метаданными.
Стоит упомянуть о трех системных сбоях на этом этапе. Из 67 ответов в одном из тестовых прогонов, не поддававшихся парсингу JSON, 65 сгенерировала Gemini Pro: она оборачивала JSON в markdown-блоки вида jsonc, к чему парсер не был готов. Тот же Gemini при попытке перефразировать шаблоны проваливал каждую вторую попытку, поскольку его режим рассуждений исчерпывал лимит в 300 токенов, оставляя в ответе лишь пару символов — { и перевод строки; перефразирование было перенесено на Haiku 4.5. Самая незаметная проблема возникла из-за ошибки в распределении квот: 26 из 60 ячеек тестового прогона завершились с нулевым результатом, однако лог исправно рапортовал generated=20, поскольку выводил запланированный бюджет, а не реальное количество строк. Ошибка обнаружилась лишь при сопоставлении числа записей в базе с логами.
Фильтр на «решаемость по памяти» (closed-book). После генерации каждый вопрос уровней L1–L3 передавался другой модели без исходного факта. Если та давала верный ответ с уверенностью не ниже 0,6, вопрос получал метку closed_book_solvable и принудительно снижался до уровня L1. Выбор модели зависел от сложности: Haiku 4.5 для L1, Sonnet 4.6 для L2, Opus 4.7 для L3. Логика проста: вопрос второго уровня должен быть непосилен для модели того же уровня. Из четырех прототипов фильтра победил вариант с форматом multiple choice: точность составила 77 %, полнота — 94 % (против 68 % и 44 % у прототипа, верифицировавшего сам факт).
_GATE_MODEL_DEFAULT_L1 = "anthropic/claude-haiku-4.5"
_GATE_MODEL_DEFAULT_L2 = "anthropic/claude-sonnet-4.6"
_GATE_MODEL_DEFAULT_L3 = "anthropic/claude-opus-4.7"
CONFIDENCE_THRESHOLD = 0.6
CLOSED_BOOK_QUOTA_FRACTION = float(os.environ.get("OENOBENCH_CB_QUOTA", "0.40"))
В финальном корпусе эту метку получили 1 601 вопрос из 3 266, то есть ровно половина. Это существенный показатель, значение которого для итогового лидерборда мы разберем далее.
Верификатор для слабых генераторов. Первичная ручная проверка выявила неприятный факт: Llama и Qwen ошибались в выборе правильного ответа в 40 % и 29 % случаев соответственно, тогда как Claude, GPT и Gemini не допускали ошибок на выборке из 31 вопроса. Для слабых моделей был внедрен дополнительный этап контроля: независимая нейросеть решала задачу, опираясь на исходный факт, и в случае расхождения с ключом вопрос безжалостно отбраковывался. Механизм работал избирательно: если вопрос уже прошел фильтр на решаемость без контекста, а генератор оценил собственную уверенность в 0,9 и выше, проверка пропускалась. В релизной сборке это исключение сработало 618 раз.
Масштабы брака наглядно демонстрирует пилотный прогон v8: около 16 000 обращений к LLM, 11,4 часа работы и всего 111 принятых вопросов. Примерно 150 вызовов на один пригодный вопрос при 99 % брака. После десяти оптимизаций (включая удаление вызовов time.sleep(1.5) перед каждым запросом, замену 321 холодного запуска подпроцессов на внутренние вызовы, кэширование решений в Postgres и защиту от зависаний в пустых ячейках) пилот v9 выдал 46 вопросов за 772 вызова и 18 минут. На финальном этапе стоимость одного принятого вопроса составила $0,034, а формирование основного пула release_v1 (2 650 вопросов) обошлось примерно в $160. Еще 1 062 вопроса поступили из ранее собранного вспомогательного набора.
Тогда же стало очевидно, что заявленных 5 000 вопросов не получится. Генератор уперся в ограничения базы фактов: в трех стратегиях из пяти содержательный материал исчерпался задолго до выполнения квоты, две другие достигли лимита итераций, а винный бизнес и виноделие, чья химия процессов описана в платных научных журналах, а не в Wikidata, дали всего 187 вопросов. Пришлось остановиться на том объеме, который позволили имеющиеся данные.
Аудит: десять агентов в четырех командах
Сгенерированные вопросы представляли собой «сырье». Для оценки объемов и характера брака я развернул отдельный контур в директории src/qa/, состоящий из десяти агентов, оценивающих каждую категорию по шкале pass, warn или fail.
Команда A (статический анализ без привлечения LLM). A1 LexicalHygiene отслеживает с помощью регулярных выражений маркетинговые клише («prestigious», «renowned») и «воду». A2 BiasStats применяет критерий χ² для проверки равномерности распределения правильных ответов и тест Манна — Уитни для анализа длины вариантов. A3 FactEcho вычисляет наибольшую общую подпоследовательность (LCS) между вопросом и первоисточником, выставляя fail при коэффициенте от 0,65 или совпадении от 8 слов. A4 TemplateFingerprint использует логистическую регрессию по биграммам частей речи для выявления излишне шаблонных формулировок.
Команда B (судейская панель). B1 TriJudgeAnswer (Claude, GPT-5.4 и Gemini 3.1 Pro) отвечает на вопросы, имея доступ к источнику, но не видя ключа; выставляется fail, если мнение большинства расходится с ключом. B2 ClosedBookSolvability тестирует вопросы силами четырех судей в слепом режиме.
# Three high-capability judges for B1 / D1 — intentionally excludes Llama/Qwen
JUDGE_PANEL = ("claude", "chatgpt", "gemini")
JUDGE_PANEL_B2 = ("claude", "gemini", "llama", "qwen")
Llama и Qwen намеренно исключены из панели B1: поскольку они участвуют в генерации вопросов, судья не должен оценивать собственные творения. В B2 они, напротив, введены в качестве калибровочных якорей — Opus и Gemini обладают слишком глубокими познаниями о вине, чтобы служить эталоном среднего экзаменующегося.
Команда C. C2 CategoryLeak выявляет казусы вроде вопросов о красном вине с белыми сортами винограда среди дистракторов. C4 DifficultyAudit поручает Gemini переоценить сложность вопросов и выставляет fail при расхождении больше чем на два уровня.
Команда D (корпусная статистика). D1 SelfPreference строит матрицу 5 × 5 для сопоставления связок «генератор × респондент». D3 SkewAudit отслеживает диспропорции по странам через χ² (на первом пилоте одна из стран была представлена в 4,46 раза интенсивнее своей реальной доли в базе).
Первый тестовый аудит 472 вопросов обошелся в $8,49 (при моих прогнозах в $130–175) и сразу заблокировал генерацию: 36 % вопросов дословно дублировали источник, 28 % решались без него. За этим последовало четырнадцать итераций аудита за две недели с постоянной корректировкой промптов, пороговых значений и сэмплера.

Две кривые на графике стремительно приближаются к нулю, третья — нет. Копирование первоисточника успешно пресекается инструкцией «перефразируй» вкупе с постфильтром по LCS (показатель снизился с 36 % до 1,7 %). Проблема неверных ключей решается верификатором (падение с 4,5 % до 1,3 %). А вот показатель «решается без источника» остался непоколебимым: 28 % на старте, от 31 до 67 % на последующих этапах и 40 % в релизной версии при целевом пороге Go в 15 %. Ниже я объясню, почему в итоге разуверился в этом конкретном агенте, а не в качестве самого датасета.
Релизный аудит 3 670 вопросов занял 5 часов 22 минуты, потребовал 29 610 вызовов и обошелся в $75,79. Процедуры команд B и C4 выполнялись в восемь потоков; при последовательном исполнении на это ушел бы примерно 31 час.

Метрики за каждым столбцом извлекаются из базы стандартным SQL-запросом:
SELECT agent_id, severity, count(*)
FROM audit_findings
WHERE run_id = '2ba38269-5e66-44aa-aaaf-010dc7ef19d4'
GROUP BY 1, 2
ORDER BY 1, 2;
По результатам аудита были отбракованы 341 вопрос с отметками fail от агентов A1, A3, B1, C2 и позднего статического фильтра B3, выявляющего «вездесущие» сорта (например, вопрос «в каком регионе культивируют Каберне Совиньон» имеет десятки правильных ответов). Еще 1 259 вопросов подверглись переразметке по сложности по вердикту C4: доля задач категорий L3 и L4 увеличилась с 14 % до 51 %. После исключения вопросов, оставшихся без ответа ни у одной из моделей, и ручной проверки пограничных случаев в строю осталось 3 266 вопросов.
В качестве демонстрации приведу реальный случай срабатывания fail у панели B1, когда судьи заметили дефект, пропущенный генератором:
{
  "question": "Which Italian region has only 1 DOCG appellation?",
  "options": ["Emilia-Romagna", "Piedmont", "Sardinia", "Trentino-Alto Adige"],
  "claimed_key": "C",
  "majority_choice": "D",
  "open_book_choices": [
    {"judge": "claude",  "chosen": "D",
     "rationale": "Source fact [5] explicitly states Trentino-Alto Adige has 1 DOCG appellation, though Sardinia (fact [6]) also has 1 DOCG, making both C and D technically correct."},
    {"judge": "chatgpt", "chosen": "C",
     "rationale": "The source fact shows both Sardinia and Trentino-Alto Adige have 1 DOCG, so among the options there is not a unique single best answer."},
    {"judge": "gemini",  "chosen": null}
  ],
  "majority_matches_key": false
}
Два корректных ответа в рамках одного вопроса. Оба судьи зафиксировали это в обоснованиях, и вопрос отправился в корзину. Именно так система и должна функционировать. Следующий раздел посвящен тому, как часто она давала сбои.
Судьи ошибаются вместе
Если судьи сами являются нейросетями, почему им стоит доверять? Разумеется, слепой веры не было — проводилась калибровка. Я размечал стратифицированные выборки по восьми доменам (сначала в таблицах, а затем в специализированном Flask-приложении с карточками вопросов) и вычислял коэффициент каппа Коэна между вердиктами судей и моей собственной экспертной оценкой.

Ни одна из рубрик не достигла порога 0,6, при котором судейским вердиктам можно доверять без человеческого контроля. Два провала заслуживают отдельного упоминания.
Панель B1 на первой выборке: каппа = −0,05. Среди 60 вопросов я обнаружил шесть с ошибочными ключами. Во всех шести случаях панель B1 отрапортовала majority_matches_key = True. Все эти вопросы были сгенерированы Llama либо Qwen. Причины очевидны при анализе обоснований: генератор создал вопрос с некорректной предпосылкой, а три судьи, отталкиваясь от этой же ошибки, единогласно пришли к неверному выводу. Три модели трех разных вендоров согласились друг с другом и единодушно ошиблись во всех шести случаях. Пока судьи анализируют один и тот же дефектный текст, увеличение их числа ничего не меняет, и четвертый судья здесь не помог бы. Проблему решил другой элемент конвейера — верификатор на этапе генерации, который перепроверяет задачи от Llama и Qwen и отсеивает их при несовпадении ключа, не дожидаясь голосования. После его внедрения коэффициент каппа для B1 на объединенной выборке из 119 строк подскочил до 0,47.
Панель B2: каппа = 0,01, затем упала до −0,10. Здесь наблюдалось расхождение иного рода. Судьи утверждали, что 83 % вопросов поддаются решению без контекста, тогда как моя оценка составляла 12 %. На тот момент в судейскую панель B2 входили Opus 4.7, GPT-5.4 и Gemini 3.1 Pro (Llama и Qwen были добавлены позже, после этого разбора), а их эрудиция в винных вопросах неизмеримо превосходит знания человека, сдающего экзамен на диплом WSET. Агент фиксировал не утечку данных в претрейн, а разрыв между передовой моделью и экспертом-человеком, поэтому 15-процентный порог отсечки здесь не имел смысла. В результате вердикты B2 перестали быть основанием для дисквалификации вопросов. Метку closed_book_solvable проставляет предварительный фильтр генератора (в релизе она стоит у 1 601 вопроса), а решать, учитывать ли их при сравнительном анализе моделей, я предоставил пользователям датасета.
16 моделей, 52 256 ответов, два часа
Процедура тестирования была предельно проста: вопрос, варианты ответа, модель выдает одну букву. Шестнадцать конфигураций тестировались параллельно через OpenRouter, на что ушло 120 минут. Прогон охватил 3 329 вопросов (63 из них впоследствии были исключены при ручной отбраковке, так что все дальнейшие цифры пересчитаны по оставшимся 3 266 пунктам): 52 256 ответов на общую сумму $98,33. Двенадцать конфигураций функционировали в стандартном режиме, четыре — с активированным механизмом рассуждения, хотя грань между ними, как выяснилось, условна. Технический нюанс: параметр max_tokens пришлось принудительно поднять с 5 до 2 000, поскольку у OpenAI установлена нижняя граница, а у reasoning-моделей скрытые токены рассуждения полностью исчерпывают лимит до выдачи первой буквы ответа.

Верхушка таблицы плотная: o3, GPT-5, Gemini 2.5 Pro и Opus 4.7 разделяют всего 2,6 п. п. В хвосте расположилась Haiku 4.5, но это артефакт: 19,7 % ее ответов не удалось корректно распарсить в буквенный формат, и они были засчитаны как ошибки. Ряд результатов оказался неожиданным.
Корректное сравнение режима рассуждений удалось получить лишь в одном случае. У Opus 4.7 бюджет рассуждения составлял 512 токенов, поэтому режим фактически не задействовался: за весь прогон модель выдала 23 тыс. токенов против 16 тыс. у базового Opus при идентичной задержке, откуда и проявилась разница в −0,1 п. п. Gemini 2.5 Pro и GPT-5 задействуют рассуждение и в «обычных» режимах, поэтому сопоставления Gemini (+0,9 [−1,0; +2,8]) и o3 с GPT-5 (+0,8 [−1,0; +2,6]) демонстрируют разницу бюджетов рассуждения, а не его принципиальное наличие. Единственная пара, где этот режим действительно переключался явно — DeepSeek-V3 и R1: прирост составил +6,8 п. п. [+4,6; +8,8]. Выделение дополнительного бюджета модели, и без того склонной к рассуждениям, на данном корпусе ощутимого эффекта не принесло.
Самый экономичный путь к результату в 81 %. Opus 4.7 без рассуждения обошелся в $3,35 за весь корпус против $29,47 у Gemini 2.5 Pro при разнице результатов всего в 0,7 п. п. Модель GPT-5-mini стоимостью $2,82 демонстрирует 78,4 % правильных ответов и при этом превосходит все шестнадцать конфигураций в наиболее сложном домене винного бизнеса: 66,3 % против 65,4 % у o3, стоявшего $11,80. Нормативно-правовая база, акцизы и торговля закономерно оказались труднейшей темой для всех участников: средний показатель по шестнадцати конфигурациям составил 56,5 %.
Тот же лидерборд в разрезе по метке closed-book.

На 1 601 вопросе, помеченном фильтром как решаемые по памяти, фронтирные модели показывают 96–97 %. На оставшихся 1 665 вопросах показатели падают до 65–70 %. Средний разрыв составляет +32,6 п. п., причем его знак одинаков для всех шестнадцати конфигураций: от +26,6 у GPT-5 до +39,6 у DeepSeek-V3. Тот самый предгенерационный фильтр, который на этапе аудита продемонстрировал отрицательную каппа с моей экспертной разметкой, блестяще предсказал зоны затруднений для шестнадцати моделей. Он расходится с экспертом-человеком, но идеально сходится с нейросетями — противоречия здесь нет, поскольку он измерял осведомленность моделей, а я размечал стандарты для человека.
Еще один сюрприз: аудит практически не повлиял на расстановку сил в лидерборде. Уже после отправки работы на конференцию я протестировал на 341 забракованном вопросе те же модели (за исключением Mistral, пропавшего из OpenRouter). Точность на них составила 64,1 % против 73,3 % на релизной выборке, однако итоговый лидерборд без аудита совпал бы с реальным с коэффициентом Спирмена ρ = 0,996. Аудит критически важен для корректности отдельных вопросов, но избыточен для ранжирования моделей — итоговый рейтинг устойчив к наличию девяти процентов мусора.
Self-preference, и где он отрицательный
Анализ лидерборда в разрезе семейств генераторов отвечает на вопрос, ради которого затевалось привлечение пяти разных движков: проще ли модели отвечать на вопросы, созданные ее «родственниками»?

В экосистеме Anthropic эффект проявляется классическим образом: Opus и Haiku отвечают на вопросы от Claude на 9–10 п. п. успешнее, чем на чужие, причем доверительные интервалы далеки от нуля. У OpenAI и Meta этот показатель равен нулю. А вот у Google зафиксирован парадоксальный отрицательный эффект: Gemini Flash справляется с вопросами от Gemini Pro на 10,4 п. п. хуже, чем с чужими, а сама Gemini Pro — на 6,1 п. п. хуже (хотя вопросы генерировались ее собственным старшим «родственником» Gemini 3.1 Pro). Правдоподобная гипотеза заключается в том, что Gemini-генератор тяготеет к редким деталям, которые Gemini-решатель впоследствии не осиливает, тогда как генераторы Claude действуют в зоне паттернов, легко распознаваемых решателями Claude. Строго доказать это сложно; после стратификации по сложности и метке closed-book ансамблевый эффект Anthropic сжимается примерно до +3 п. п., указывая на то, что часть превосходства обусловлена характером самих вопросов, а не стилистикой.
Практический вывод не зависит от теоретических изысканий: если вы генерируете бенчмарк единственной моделью и ею же проводите оценку, вы неизбежно либо завысите ее результаты на десяток пунктов, либо необоснованно занизите. Заранее предсказать вектор искажения невозможно.
Что эвал рассказал про сам корпус
По завершении прогона я выделил 97 вопросов, на которые не смогла ответить ни одна из 16 моделей, и проанализировал их вручную.

Объективно сложных оказалось лишь 14. Остальные 83 представляли собой дефекты или спорные формулировки: в 27 случаях был неверен ключ, в 19 — правильными являлись сразу несколько вариантов, в 16 текст страдал двусмысленностью. Шесть вопросов содержали два идентичных варианта ответа с ключом вида A,D — их породил конкретный генератор, а агенты аудита не проверяли уникальность вариантов, поскольку мне не приходило в голову контролировать этот аспект. 54 вопроса из 97 были сразу списаны, еще 9 отсеялись в ходе ручного разбора пограничных кейсов. Так 3 329 вопросов превратились в 3 266, а из упомянутых 97 в релизной версии уцелело лишь 34.
С тех пор я исхожу из того, что хвост «самых сложных» вопросов в любом сгенерированном бенчмарке по определению изобилует дефектами. Если модель пасует перед вопросом, первопричину следует искать в некорректности формулировки, а не в слабости модели. Выделять «наиболее трудную» подвыборку в отдельный бенчмарк без повторной ручной ревизии недопустимо.
Второй срез я выполнил уже после подачи статьи, чтобы проверить собственную гипотезу: действительно ли вопросы без метки closed-book требуют аналитического мышления, а не тривиальной эрудиции? Проверка проста. Если сложность заключалась в пробеле знаний, то модель, получившая в промпт исходный факт, обязана дать верный ответ; если требовалось композиционное мышление — не факт. Я отобрал 500 вопросов, предоставил GPT-5 контекст с исходными фактами и повторил тестирование.
На однофактных вопросах без метки closed-book точность подскочила с 67,6 % до 99,5 %. На многофактных, где предполагался синтез данных, — с 84,2 % до 98,5 %. Гипотеза не подтвердилась: корпус оценивает доступность информации, а не аналитические способности. Все четыре оставшиеся ошибки при ручном разборе оказались дефектами самих вопросов: в одном исходный факт гласил «In Serbia it is the most planted grape variety by total area» без расшифровки местоимения «it», в другом условие подходило сразу под три DOCG. Побочный результат оказался важнее основного: сценарий «модель не может выбрать ключ, имея перед глазами исходное предложение» служит дешевым и абсолютным детектором дефектов (все 4 срабатывания указали на реальные ошибки). Такой тест стоил чуть больше доллара на 500 вопросов и должен был войти в конвейер с самого начала вместо половины команды B.
Сколько это стоило
|
Статья расходов |
Сумма |
Источник данных |
|---|---|---|
|
Сборка release_v1 (2 650 вопросов) |
~$160 |
статус проекта на 3 мая |
|
Релизный аудит (29 610 вызовов) |
$75,79 |
таблица |
|
15 пилотных прогонов аудита |
$44,27 |
суммарно по |
|
Тестирование 16 конфигураций |
$98,33 |
отчет OpenRouter |
|
Пробный эвал на 1 062 вопросах |
$33,03 |
отчет тестирования |
|
Постсабмитные прогоны (oracle-эвал, абляции) |
~$14 |
три изолированных запуска |
|
Пилоты генерации, прототипы фильтра, отладка |
остаток |
не детализировано по статьям |
|
Итого затраты на OpenRouter |
~$797 |
$783 по балансу аккаунта на день сабмита плюс ~$14 после |
Первые шесть позиций зафиксированы документально; седьмая представляет собой остаток, в который вошло все неучтенное: пилотные генерации, отдельная сборка вспомогательных 1 062 вопросов, четыре прототипа гейта (по $0,16–0,61) и отладочные прогоны. Инфраструктура (виртуальная машина с Postgres, Elasticsearch, Neo4j и Redis в Docker) в смету не включена, равно как и подписка на Claude Code, задействованная для решения сопутствующих задач. Затраты времени: семь месяцев вечерней работы, свыше 420 коммитов.
Что забрать, если вы не про вино
Всю описанную архитектуру можно перенести на любую другую предметную область без изменения принципов работы. Вот к каким выводам я пришел и что сделал бы иначе.
Право возвращать пустой ответ (skip) нужно было предоставить генератору с первого дня. Инструкция в промпте «если факт содержит лишь знаменитое имя без технических деталей, верни skip» отсеяла больше негодных вопросов, чем последующие усилия аудиторских агентов. До ее появления генератор выжимал вопрос из любого факта, и каждый такой брак приходилось выявлять за реальные деньги.
Судей изначально не стоит воспринимать как независимых экспертов лишь на том основании, что они созданы разными компаниями. Три модели, анализирующие один и тот же некорректный вопрос, солидарно приходят к одинаковой ошибке, и наращивание их численности не решает проблему. Эффективнее сработал предварительный верификатор, отбраковывающий вопрос при расхождении с ключом без всякого голосования. Правда, в релизной сборке он пропускал вопросы при высокой уверенности генератора (618 раз), так что применять его следует тотально.
Детектор дефектов стоило встраивать в конвейер незамедлительно, а не после отправки статьи. Модели демонстрируют исходный фрагмент, по которому составлен вопрос, и пытаются на него ответить. Если модель с подсказкой пасует перед ключом — вопрос бракованный. Проверка 500 вопросов обошлась чуть дороже доллара, но все четыре срабатывания указали на подлинные дефекты.
Происхождение данных (provenance) требует отдельного программного контроля, поскольку ревью кода его не страхует: сгенерированный по памяти словарь выглядит в дифф-файле абсолютно так же, как и реально спарсенный. Теперь каждый факт в базе снабжен прямой ссылкой, и я проверяю это автоматизированными запросами, а не слепой верой в чистоту кода.
Измерять моделью тесты, которые она же помогла составить — тупиковый путь. Расхождение составляет около десятка пунктов, и в какую сторону качнется маятник, заранее неизвестно. Публиковать «самые сложные вопросы» без ручной инспекции также нельзя: в автоматизированных бенчмарках этот сегмент насквозь пропитан браком, в чем я убедился на собственном опыте.
Датасет со всеми 3 266 вопросами, привязками к фактам и URL источников опубликован на HuggingFace, исходный код открыт на GitHub (ссылки приведены ниже). Обнаружив вопрос с некорректным ключом, оставьте его идентификатор в комментариях — я проведу ревизию и обновлю датасет с соответствующей отметкой.
Ссылки и источники
-
Препринт: arxiv.org/abs/2608.20106
-
Wikidata SPARQL: query.wikidata.org
-
Реестр AVA UC Davis: github.com/UCDavisLibrary/ava
-
INAO, реестр AOC: inao.gouv.fr
-
OpenRouter: openrouter.ai
О разработке агентных систем, оценке ИИ и прикладных бизнес-кейсах я пишу в своем Telegram-канале AGI Boardroom. Там же появятся обновления датасета и разборы проблемных вопросов, найденных читателями.
Примечание об инструментах. Программный код проекта преимущественно написан с помощью Claude Code: я формулировал задачи, изучал дифф-файлы и утверждал результаты. Вопросы генерировались и верифицировались упомянутыми в тексте моделями; все ручные оценки и разметки выполнены мной лично. Claude Code также помогал в подготовке статьи: агрегировал метрики из базы и отчетов, формировал графики и составлял черновик, который я затем отредактировал. Все числовые показатели в тексте извлечены из рабочей базы данных и логов проекта.
Похожие статьи
 Физика пламени и векторы познания
 Искусственный интеллект научился создавать ДНК
 Блокнот: программа, которую Microsoft не решалась менять сорок лет
 Время на исходе: что означает загадочная фраза о фотонах?
 Интервью с Роджером Пенроузом: о Вселенной, сознании и пространстве-времени
 Первая часть 16-й проблемы Гильберта: перебор схем 8-й степени с ограничениями
 У астероида неожиданно нашли кольца: ученые в недоумении
 Кого ждет рынок труда России в 2032 и 2040 годах: демографический анализ Росстата