Пять способов сымитировать аргументацию в диалоге с языковой моделью
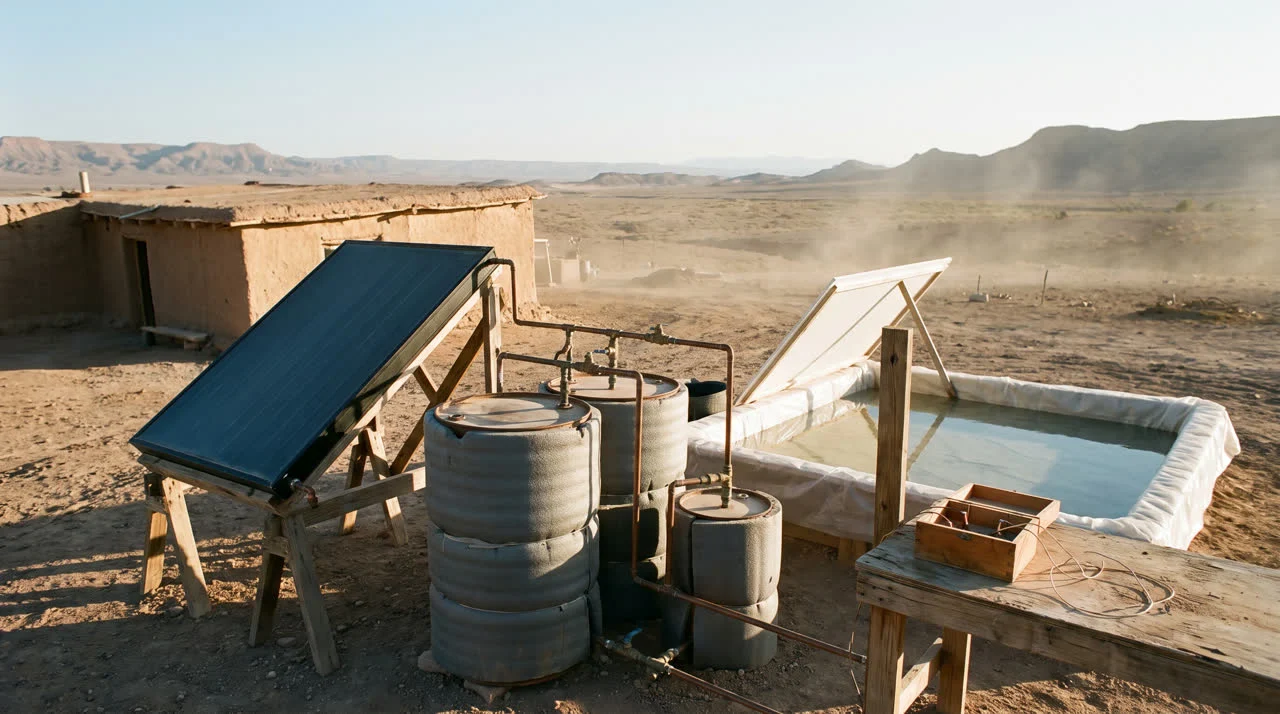
Станция «Солнце-Небо» на рассвете. Ни один винт этой установки не был закручен: кадр сгенерирован по текстовому описанию за полторы минуты и стоил четырнадцать центов.
Параллельный эксперимент с двумя передовыми моделями, исследование двух различных паттернов сбоя и проверка собственной гипотезы по научной литературе, которая ее полностью опровергла.
Четвертого сентября я запустил параллельно два чата с абсолютно одинаковой вводной: придумать нестандартную, базовую «на уровне изобретения колеса» технологию извлечения солнечной энергии из подручных материалов, избегая чистых комнат и дефицитных компонентов. Эту задачу получили GPT-6 Astra и Claude Fable 5.1 — две сильнейшие языковые системы, изолированные друг от друга.
Спустя пять дней у меня на руках было два полноценных досье: с наименованиями установок, техническими спецификациями, ссылками на академические рецензируемые публикации, расчетами себестоимости киловатт-часа и кинематографичными видеороликами, где над резервуарами поднимался пар. Оба проекта выглядели так, будто инженеры уже воплотили их в металле, но забыли сделать финальные кадры на смартфон.
Разумеется, в реальности их не существует. Обе модели самостоятельно рассчитали экономическую модель, прямо указали на ее несостоятельность — и тем не менее продолжили создавать эффектную симуляцию.
Ниже я подробно разберу их действия, а затем перейду к тому, ради чего затевался этот текст: как я сам угодил в точно такую же ловушку фальсификации и что в итоге осталось от моих выводов.
Первая система: солнечный счетовод
Эту задачу решала Claude Fable 5.1. Она зашла не с концепта, а с жесткого аудита, что сразу внушило доверие. Сводная таблица учитывала бесплатную солнечную энергию и те ограничения, которые накладывает термодинамика. Затем последовал жесткий отбор из тридцати гипотез по критериям КПД, простоты и степени изученности, оставивший пятерку финалистов с цифрами на руках.
К вечеру родился проект «Солнце-Небо». Днем коллектор нагревает емкость до 45–65 °C, передавая тепло электрохимической ячейке (медь и берлинская лазурь) за счет разницы температур, а не проводов. Ночью радиационный пруд сбрасывает тепло в открытый космос, намораживая лед, что позволяет ячейке разряжаться в холоде. Десятки ссылок, пошаговый гайд по сборке на кухонном столе.
Всё выглядит безупречно. Тем внимательнее стоит присмотреться к одной конкретной цифре.
На старте модель зафиксировала рабочую температуру ячейки на отметке 90 °C — солидное значение где-то посредине между горячей водой и кипятком. Этот показатель занесли в таблицу, схему и расчеты эффективности. Но он оказался ошибочным: предельная температура для выбранной самой же моделью ячейки составляет 65 °C. Это зафиксировано в статье Ли, Яна и Цуя в Nature Communications за 2014 год, на которую модель сама же сослалась.

Несоответствие вскрылось не потому, что ИИ сопоставил параметр с законами физики. Мне пришлось заставить его прочитать первоисточник целиком, а не довольствоваться поверхностным резюме заголовка.
Далее последовала экономика. Модель самостоятельно вычислила себестоимость: от 0,7 до 1,3 доллара за киловатт-час против скромных 0,02–0,05 долларов у стандартных панелей с литиевыми накопителями. И сама же вынесла вердикт: «электричество здесь побочный эффект, истинный продукт — тепло и холод». По сути, она профессионально раскритиковала собственный замысел.

А после этого включила режим медиапроизводства. Режиссер, оператор, маркетолог и композитор — все они оказались одной нейросетью в разных амплуа. Итог: три высококачественных рендеринга пустынной станции и семь роликов с панорамированием и поднимающимся над резервуаром паром.
Затем система устроила внутренний аудит. Созданная ею же коллегия экспертов восторженно оценила композицию несуществующего объекта: «целостная геометрия держит кадр», «визуальный крючок срабатывает мгновенно». Вердикт: проект готов к презентации.
И автор, и рецензент вновь оказались единым вычислительным потоком.

Парадокс: чем слабее сходились экономические и физические показатели, тем убедительнее становилась визуальная оболочка.
Вторая машина: термомеханический щелкунчик
GPT-6 Astra пошла по пути яркой метафоры. «Солнечно-космический щелкунчик»: темная пластина аккумулирует тепло, светлая излучает его в атмосферу, а между ними расположен биметаллический диск, который изгибается от нагрева, щелкает, остывает и возвращается в исходное положение. Импульс от этого щелчка преобразуется пьезоэлементом.
Никакого вечного двигателя здесь нет. Нагрев, охлаждение, термическое расширение и пьезоэффект — все это реальные физические явления. Именно поэтому конструкция казалась столь убедительной.

Критик проснулся лишь по моему прямому требованию. В рамках отдельного запроса та же нейросеть примерила роль эксперта по термодинамике и без труда обнаружила три фундаментальные уязвимости, включая общий металлический каркас, который сводил на нет всю изоляцию, передавая тепло с горячего контура на холодный.
Замечания оказались точными. Удивляла лишь последовательность: сначала модель помогала придать концепту максимальную видимость надежности, а затем, поменяв вводную, преспокойно объясняла нежизнеспособность идеи. У реального мира нет подобных переключателей ролей. Тепловой мостик присутствовал в конструкции изначально, независимо от формулировки моих запросов.
Отдельного упоминания заслуживают расчеты. Модель выдала аккуратную мощность с точностью до сотых долей микроватта, где и эффективность, и энергия щелчка были принячны как допущения. Расчет честно демонстрировал математическое следствие введенных гипотез, но ничего не говорил о поведении реального металла. Нормальный подход. Проблема в другом: мнимая точность создает иллюзию эмпирического факта, хотя с физической реальностью никто еще не взаимодействовал.
Затем последовало сравнение, вернувшее меня на землю. Прогнозируемая мощность — от 0,5 до 10 микроватт. Серийная гибкая солнечная панель PowerFilm габаритами 94х73 мм выдает по паспорту 240 милливатт. Разрыв в 24 000 раз. Вдобавок выяснилось, что биметаллические генераторы с электретным съемом подробно изучались еще в 2013 году.
И амбициозный проект начал стремительно деградировать.

«Прорывной источник энергии» превратился в «генератор редких импульсов», те — в «автономный датчик», а датчик в итоге стал «учебным стендом». Учебный прибор — вещь полезная, но исходная задача звучала совсем иначе.
А затем я совершил ту же ошибку, в которой обвинял алгоритмы
На этом этапе статью можно было смело завершать. В первой редакции я именно так и поступил: у ИИ нет рук, реальные инновации рождаются на стыке физического труда и материала, а чат-боты производят самый дешевый товар в мире — уверенность. Мне нравился этот вывод, и я считал его своим.
А потом я решил его проверить. То есть выполнил ровно ту процедуру, отсутствие которой вменял искусственному интеллекту.
Проверка заняла полтора часа и дорого обошлась моим умозаключениям.
Выяснилось, что в июле 2026 года на конференции ICML была принята программная статья Тома Захави из DeepMind под красноречивым названием «LLMs can’t jump» («Большие языковые модели не умеют совершать скачки»). Суть аргумента: модель превосходна в дедуктивной аналитике, но структурно неспособна на абдуктивный скачок — на генерацию принципиально новых посылок. Автор опирается на концепцию манипулятивной абдукции Лоренцо Магни и классическую проблему заземления символов Стивана Харнада, сформулированную еще 35 лет назад. Модель оперирует физическим словарем, не обладая сенсорным опытом, который наполняет эти термины реальным смыслом. Наглядный пример автор разбирает на мысленных экспериментах Эйнштейна.
Мой финал оказался незрелым пересказом чужой научной работы, причем поверхностным. У Захави есть строгий аппарат и предложение по решению проблемы — мультимодальные мир-модели, способные обеспечить недостающее заземление. У меня были лишь воображаемый термометр и ночной водоем.
Дальше ситуация ухудшилась. Второй мой тезис о «подешевевшей уверенности» также оказался частью актуального академического дискурса 2026 года со сложившимся терминологическим аппаратом: концепция verification hill («холма верификации») у Рохита Ламбы, понятие AI debt («искусственного интеллекта в долг») в кембриджских препринтах и тезис о том, что «измерять следует стоимость проверки, а не только корректность ответа». Там же приведена куда более емкая формулировка: эпистемическая инфраструктура науки формировалась в мире, где создание правдоподобного артефакта требовало колоссальных затрат времени и труда, поэтому издержки производства служили естественным фильтром. Искусственный интеллект обнуляет этот барьер, оставляя стоимость верификации прежней.
Но самое неприятное заключалось в другом. Мой эксперимент опирался на выборку n = 2. А исследователи из Стэнфорда провели масштабный эксперимент: 43 эксперта, потратившие более ста часов каждый, взялись реализовать случайно доставшиеся им идеи — собственные или сгенерированные нейросетью — и написать по ним научные статьи. До этапа практической реализации идеи моделей оценивались как более прорывные, чем человеческие. После физического воплощения оценки резко упали по всем параметрам, а общий рейтинг перевернулся с ног на голову.
Вдумайтесь в это. Концепция кажется революционной ровно до того момента, пока кто-то не пытается воплотить ее в железе.
Именно в эту ловушку угодил и я. Я сформулировал «открытие», оно показалось мне прорывным, но первый же углубленный поиск по литературе разрушил иллюзию новизны. Я оказался сорок четвертым участником стэнфордского эксперимента, причем на стороне алгоритма.
Что удалось сохранить
Мой исходный тезис не выдержал проверки, и делать вид, было бы ровно тем же подлогом, в котором я обвинял нейросети. Уцелело другое — то, чего я не обнаружил в существующей литературе.
В академической среде есть теория о невозможности машинного изобретательства и статистика провала сгенерированных идей на практике. Чего там нет — так это словаря поведенческих паттернов ИИ. Как именно диалог с моделью имитирует доказательство, по каким маркерам это распознать и как действовать при их обнаружении. Мои пять дней экспериментов выделили пять таких признаков, и для каждого из них я подобрал точные формулировки.

Два нюанса стоит пояснить отдельно, поскольку они не поместились в сводную таблицу.
Первое — феномен театрального рецензирования. Исследования предвзятости языковых моделей к собственному контенту уже обширны: модели безошибочно узнают свои тексты и отдают им предпочтение, причем уровень смещения на некоторых датасетах достигает девяноста процентов. Но в этой литературе есть деталь, делающая мою сцену с экспертным советом еще мрачнее. Более мощные модели демонстрируют наибольшую снисходительность именно там, где совершают ошибки. Иными словами, чем совершеннее ИИ, тем увереннее он хвалит себя ровно в тех местах, где заблуждается.
Второе — ложная педантичность. За все пять дней безупречно была выполнена лишь одна техническая задача. Когда видеоролик был готов, кадры начали дергаться: исходники шли в 24 кадрах в секунду, таймлайн собирался в 30, а переходы между пятью сценами растягивались алгоритмом, который не генерировал промежуточные кадры, а топорно дублировал существующие. Исправление потребовало честной компенсации движения, заняло полчаса и было сделано скрупулезно, файл за файлом, с покадровой проверкой.
Здесь существовал объективный критерий: кадр либо дублирован правильно, либо нет.
Вся инженерная энергия того дня ушла на полировку иллюзии несуществующей станции. Ресурс утекает туда, где есть верифицируемый критерий, вне зависимости от того, имеет ли этот элемент реальную ценность.

Дискуссия, в которую я вступил вслепую
Углубленное погружение в тему дало главное — понимание того, что академический спор кипит давно и в нем есть разные позиции.
Гипотезу Захави активно оспаривают. Майкл Фармер в работе «Abduction Without a Body?» утверждает, что телесный опыт необходим далеко не для каждого акта абдукции, выделяя особый класс — абдукцию тождества, когда вывод о том, что две независимые структуры суть одно и то же, делается на основе абстрактных паттернов. Его механизм называется репрезентативным заземлением: агент наращивает аналитический потенциал не через физическое взаимодействие с миром, а через трансформацию в пространства представлений, где скрытые инварианты становятся очевидными. Существуют и другие работы, включая попытки количественного измерения этого «скачка».
Таким образом, вопрос о необходимости «рук» вовсе не закрыт — это горячая точка исследований, породившая за последний год не менее четырех фундаментальных текстов.
Отдельный фронт дискуссии касается автономности научных лабораторий. В апреле 2026 года вышла статья с симптоматичным заголовком: «ИИ-ученые генерируют результаты без научного осмысления». Автономные агенты имитируют этапы научного метода, но не воспроизводят глубинные эпистемические паттерны мышления, чего поверхностные метрики успешности заметить не могут.
Это напрямую касается лаборатории A-Lab в Беркли, которую я изначально собирался приводить в пример замкнутого автоматического цикла: 41 новое соединение за 17 дней, роботизированные печи и дифрактометры. Спустя месяц химики Роберт Палгрейв и Лесли Шуп перепроверили дифрактограммы и установили, что часть «прорывных» материалов — давно известные фазы, а алгоритмический анализ дал сбой. Цикл действительно был замкнутым. Вот только рецензента в нем не оказалось.
Схожая история произошла с системой GNoME от DeepMind: 2,2 миллиона спрогнозированных структур, из которых 380 тысяч признаны стабильными. Однако материаловеды выступили с резкой критикой, указав, что львиная доля новизны свелась к банальной перестановке соседних элементов по таблице Менделеева.
Впрочем, есть и безупречные примеры. Алгоритм AlphaEvolve в мае 2025 года нашел способ умножения матриц 4х4 за 48 операций вместо 49, побив рекорд Штрассена, державшийся с 1969 года. А создатели AlphaFold заслуженно получили Нобелевскую премию по химии 2024 года.
Обратите внимание на общее свойство всех успешных кейсов. В каждом из них присутствует объективный критерий, с которым невозможно договориться. Математическое доказательство либо верифицируется кодом, либо нет. Кристалл либо синтезируется в тигле, либо нет. Кадры видеоряда либо синхронизированы, либо нет.
Итоги эксперимента
Мой итоговый вывод изменился, и он больше не сводится к метафоре «отсутствия рук».
Мы привыкли доверять определенному сигналу: если собеседник сам указывает на свои слабые места, градус доверия к нему возрастает. Искреннее признание ограничений всегда стоило дорого и служило залогом честности.
Этот маркер сломался. Убедительная самокритика теперь генерируется ровно с той же легкостью, что и убедительный вымысел. Обе статьи, легшие в основу этого разбора, были написаны самими нейросетями по моему запросу в тот же вечер — блестяще, точно и аргументированно. При этом статистика самопредпочтения гласит: чем интеллектуальнее система, тем охотнее она хвалит себя именно там, где совершает ошибку.
Суммируя сказанное: сигнал «система честно признала свои границы» деградирует тем быстрее, чем сложнее становится сама система. Мы будем все чаще сталкиваться с безупречными формулировками самоограничений от моделей, которые в этот самый момент ошибаются, и у нас не останется иного способа отличить фальшь от правды, кроме ручной проверки.
Верификация перестала быть признаком академической добродетели и превратилась в обязательную процедуру. У нее есть неприятное свойство: ее невозможно подменить субъективным впечатлением, будто «все и так понятно». Моя иллюзия понимания продержалась ровно до первого целенаправленного поиска по литературе — и это лучший аргумент в пользу необходимости проверок из всех возможных.
Мы просили искусственный интеллект научиться добывать энергию. Лучше всего у него получилось добывать наше внимание. У меня же — уверенность в собственном выводе, которой он изначально не заслуживал.
Что способно опровергнуть мою позицию
Правило этого цикла — формулировать сценарий, при котором текущий вывод окажется несостоятельным.
В данном случае это следующий прецедент: ситуация, когда модель без внешнего вмешательства, опираясь исключительно на внутренние расчеты, самостоятельно останавливает рабочий процесс и отказывается продолжать из-за обнаруженной ошибки. Не просто «признает ограничения» в текстовом блоке, а физически прекращает генерацию артефактов.
Я подобных прецедентов не обнаружил ни в собственных логах, ни в академических обзорах. Если у вас есть зафиксированный пример — поделитесь, я разберу его в следующем материале и публично признаю свою неправоту.
О цикле
Это первая статья из цикла «Хроники изобретений». Далее мы двинемся от истоков: к каменному наконечнику копья возрастом в полмиллиона лет, изобретению колеса, паровой машине Герона, простоявшей без дела семнадцать веков, и Эдисону с его сгоревшими угольными нитями.
При этом определитель поведенческих паттернов ИИ никуда не денется. Он будет дополняться в каждом выпуске, поскольку фальсификация доказательств — ремесло гораздо более древнее, чем нейросети, и большинство уловок из нашей таблицы существовали задолго до появления электричества.
В следующем материале речь пойдет о наконечнике копья. Древнейшему составному оружию около полумиллиона лет, и придумали его задолго до появления нашего биологического вида.
Источники и материалы
Два отчета-самоанализа моделей об этом эксперименте — «Изобретатель без рук» и «Генератор убедительности», сентябрь 2026 года. Визуализации установок созданы в ходе того же теста и публикуются как иллюстрации концепций, а не как чертежи реальных устройств. Графические материалы и определитель авторские. Научные работы приведены по гиперссылкам в тексте; отдельно отмечу исследования, обрушившие мою первую гипотезу: Zahavy T., «Position: LLMs can’t jump», ICML 2026; Si C. et al., «The Ideation-Execution Gap», arXiv:2506.20803; Lamba R., «The Verification Hill», 2026.
Информация для тех, кто захочет воспроизвести эксперимент.
Воспроизводимость здесь хромает концептуально: у языковых моделей нет статического состояния, и на ту же задачу завтра система ответит иначе. Но воспроизводится не сам результат, а сценарий системного сбоя. Попробуйте поставить перед моделью задачу с жесткими физическими ограничениями, позвольте ей самостоятельно назначить числовые параметры, а затем потребуйте открыть первоисточник и сверить данные. Мне искренне интересно, у какого числа читателей повторится история с правдоподобной, но провальной цифрой.
Если вы обнаружите контрпример — случай, когда модель сама, без подсказок, отловила собственную математическую ошибку и прервала генерацию, — напишите в комментариях. Это именно тот прецедент, который опровергнет мои выводы, и я с удовольствием на него взгляну.
Похожие статьи
 Биологические логические элементы и рибосомная память
 Почему ChatGPT отлично рассуждает о покере, но ужасно в него играет
 Как разгадать загадку университетского квеста
 Обязаны ли мы использовать квантовые компьютеры для познания химии?
 Искусственный интеллект усугубляет цифровой разрыв
 Династия киборгов: как две сотни агентов возвели цивилизацию
 Когда агент перерастает самого себя
 Строение протона: новые данные