Потоковый процессор Electron E1: в 100 раз эффективнее ARM

Неуклонный рост энергопотребления дата-центров вскоре вынудит индустрию выкупать мощности атомных электростанций по примеру Microsoft и Amazon, однако отрасли необходима альтернативная стратегия. Именно поэтому рынок так остро нуждается в предельно энергоэффективных центральных процессорах.
Год назад молодой стартап Efficient Computer презентовал «рекордный по энергоэффективности» чип Electron E1. Инженеры поставили перед собой амбициозную цель переосмыслить концепцию универсального CPU сквозь призму энергосбережения. Хотя текущая модификация создавалась для встраиваемых систем, фундаментальные принципы этой архитектуры применимы и в масштабных дата-центрах.
В стандартных embedded-сценариях — будь то быстрое преобразование Фурье для анализа сигналов или вычисление признаков в сверточных нейросетях — новинка превосходит решения на базе ARM в 10–100 раз.
На текущий момент чип и фирменный компилятор проходят этап закрытого бета-тестирования. Участники программы могут протестировать свой C/C++ код в онлайн-песочнице и оценить показатели автономности на новом железе.
Фоннеймановский тупик
Фундаментом для подавляющего большинства современных компьютеров служит архитектура фон Неймана, разграничивающая вычислительные блоки и хранилище данных. Эта схема безупречна для классических вычислений, но превращается в фатальное «бутылочное горлышко» при матричном умножении и прочих операциях нейросетей. Понятие фоннеймановского барьера появилось ещё в 1977 году, однако критическую проблематику на аппаратном уровне мы ощущаем только сейчас.
Отсюда проистекает колоссальный спрос на специализированное «железо», превосходящее традиционные CPU и GPU. Микропроцессоры нового поколения не просто адаптированы под специфические задачи, но и базируются на принципиально иных архитектурных концептах.
Подобный подход позволяет радикально снизить энергозатраты вычислительных комплексов за счет миграции данных между процессором и памятью, сведенной к абсолютному минимуму.
Классические CPU заточены под дискретные алгоритмы: выполнив инструкцию и сбросив данные в память, процессор моментально переключается на сторонний процесс. Однако задачи машинного обучения тесно взаимосвязаны, и у процессора зачастую попросту нет сопутствующей работы на время простоя. Именно поэтому ряд исследователей видит спасение исключительно в глубокой архитектурной оптимизации.
Потоковая доставка инструкций из памяти сопровождается огромными накладными расходами. Миллиарды циклов в секунду на выборку, декодирование, реорганизацию и переименование регистров требуют колоссального количества энергии. Кроме того, для борьбы с простоями современные CPU вынуждены задействовать предсказание ветвлений, что еще сильнее увеличивает энергопотребление.
Вместо этого модель E1 преобразует линейку команд в пространственный маршрут, по которому потоки данных непрерывно циркулируют внутри кристалла от одного вычислительного блока к другому.
Матрица плиток в E1

Каждый узел (плитка) E1 представляет собой упрощенное процессорное ядро, способное выполнять команды без процедуры выборки, предсказания ветвлений и сопутствующих издержек. Плитки объединяются в единую программируемую матрицу Fabric. Иными словами, скомпилированное программное обеспечение физически распределяется по всей площади полупроводниковой пластины.

Чип относится к категории CGRA (Coarse-Grained Reconfigurable Architecture) или пространственных потоковых процессоров (Spatial Dataflow Processors). В подобных решениях память расположена в непосредственной близости от вычислителей (распределенная SRAM ближе к кремнию), а сами расчеты производятся в массиве логических блоков.
Концептуально это напоминает FPGA (программируемые вентильные матрицы), но с укрупненными базовыми ячейками. Схожий вектор некогда исследовала компания GreenArray при создании нестандартного чипа GA144, однако проект не сыскал широкой популярности. Сама же парадигма потоковых вычислений (Dataflow/CGRA) была теоретически обоснована еще на заре 1980-х.
За разработкой E1 стоит команда специалистов во главе с Брэндоном Люсией, занимающим пост генерального директора и сооснователя Efficient Computer.

Фирменный компилятор
Некоторые участники сообщества уже оценили возможности веб-песочницы Compiler Playground, опробовав процесс программирования для платформы E1. Среда демонстрирует работу проприетарного транслятора effcc и особенности выполнения реального кода. От разработчика не требуется глубоких специфических знаний: привычный код оптимизируется в автоматическом режиме. Согласно документации, запатентованный модуль Modular Optimization Framework самостоятельно подбирает оптимальную схему распараллеливания для минимизации тактовых задержек. Инженеру достаточно лишь вынести ключевые функции в отдельные блоки, пометив их специальным атрибутом для интеграции в матрицу Fabric.
Главная особенность компилятора effcc заключается в распределении алгоритма не только во времени, но и в пространстве кремниевого кристалла. Каждой инструкции сопоставляется отдельная ячейка-плитка, после чего коммуникационная сеть настраивается таким образом, чтобы информация, пройдя обработку в одном узле, поступала на вход следующему в строгой последовательности. При разветвлении логических условий (вроде конструкций if/then/else) пространственная топология матрицы динамически трансформируется:

При необходимости итоговую конфигурацию можно скорректировать вручную.
Транслятор принимает на вход код на C и C++, импортирует файлы моделей LiteRT и ONNX, производит декомпозицию инструкций под архитектуру E1 и рассчитывает длительность выполнения в тактах; примеры взяты из недавней публикации:

Инструментарий позволяет сопоставить энергоэффективность алгоритмов на различных микроархитектурах. Для наглядности разработчики приводят расчетное время автономной работы устройства от пальчиковой батарейки при выполнении конкретной задачи:

Очевидно, что общие энергозатраты системы не ограничиваются одним лишь CPU, поэтому демонстрация носит условный характер, однако она наглядно иллюстрирует затраты энергии на выполнение отдельных рутин.
Доступ к песочнице Compiler Playground предоставляется участникам программы раннего доступа (Early Access Program) по предварительной заявке:

Потоковая парадигма
Потоковая концепция не является абсолютным новшеством от Efficient Computer — аналогичные принципы уже применялись индустриальными гигантами. В частности, TPU от Google и ускорители Inferentia авторства Amazon опираются на потоковую передачу данных и концепцию систолических массивов.

Исследовательское подразделение IBM Research также экспериментирует со специализированными процессорами NorthPole, пытаясь преодолеть фоннеймановский барьер и форсировать ИИ-вычисления.

Тем не менее, подобные решения имеют жесткие ограничения на количество ветвлений, тогда как в E1 эти барьеры полностью сняты, утверждают создатели.
Сетевая топология E1 допускает построение произвольных маршрутов, востребованных прикладным софтом. Речь идет о полноценной поддержке рекурсивных алгоритмов и циклов вроде while, требующих обратной связи. Структура Fabric способна маршрутизировать сигналы по обратным связям, обеспечивая универсальность вычислений. До сих пор альтернативные потоковые архитектуры не могли похвастаться подобной гибкостью в сегменте универсальных CPU — эту задачу Люсии и его коллегам удалось решить после многолетних научно-исследовательских изысканий.
Главной статьей энергозатрат при работе искусственного интеллекта остается транспортировка данных — постоянная пересылка весов нейросети между памятью и вычислительным блоком. На этом фоне затраты на сами математические операции (вроде векторно-матричного умножения) кажутся минимальными и относительно простыми.
До эпохи масштабных языковых моделей архитектура фоннеймановских машин не казалась проблемной, а возникающие затыки успешно нивелировались многоярусным кэшированием. За минувшие десятилетия производительность процессоров и емкость накопителей кратно возросли, в то время как энергозатраты на перемещение информации остались прежними, превратившись в системный тормоз. Избавление от этого изъяна способно качественно ускорить как обучение, так и инференс LLM.
Сегодня вся технологическая экосистема сосредоточена на локализации данных — максимальном сближении подсистемы памяти с процессорным ядром и совмещении хранения с обработкой.

Показательным примером служит недавний выход на рынок стартапа Positron, привлекшего гигантские инвестиции под разработку процессоров нового поколения. По данным Wall Street Journal пишет, компания привлекла $875 млн при общей оценке в $5 млрд. Их флагманский чип Asimov спроектирован по принципу «memory-first» и поддерживает до 2,3 ТБ памяти.
Отладочный комплект Electron E1 Evaluation Kit (EVK)
Возвращаясь к Efficient Computer, стоит отметить, что компания рассылает партнерам полноценные девелоперские наборы Electron E1 Evaluation Kit, позволяющие протестировать реальное кремниевое изделие, сошедшее с конвейера, в отличие от экспериментальных прототипов вроде Asimov.

Плата оснащена стандартными разъемами форм-фактора Arduino и прочими интерфейсами для подключения периферии.
Феноменальная энергоэффективность процессора изначально предполагает его задействование на периферии (edge-системы), где востребован инференс машинного обучения в автономном режиме, способном годами функционировать от батареек: в автономных роботах, автомобилях, носимой электронике и космической аппаратуре.

Спрос на ресурсосбережение высок и в серверном сегменте, поэтому практические сценарии применения новой архитектуры еще предстоит определить.
Новая архитектура и будущие процессоры
Многие независимые аналитики скептически оценивают перспективы подобных ультраэкономичных CPU, указывая на жесткую конкуренцию со стороны традиционных микроконтроллеров в нише встраиваемой техники. Вероятно, подлинным приоритетом для Efficient Computer станут дата-центры, где потребность в экономии энергии носит критический характер.
Безусловно, классическая фоннеймановская модель не уйдет в прошлое в одночасье. Хотя она неэффективна для языковых моделей, она остается непревзойденной для работы с трехмерной графикой, тяжелыми вычислительными нагрузками и операциями с 32- или 64-битной точностью.
Тем не менее, тектонический сдвиг индустрии в сторону ИИ стимулировал появление целого поколения процессоров на базе принципиально новых принципов «memory-first» с пространственной потоковой обработкой. Спрос диктует правила, и впереди нас ждет немало открытий.
© 2026 ООО «МТ ФИНАНС»
Похожие статьи
 В России начался официальный старт продаж Poco X8 с AMOLED-экраном, батареей на 8340 мАч и защитой IP69K
 Huawei представила телевизоры Mate TV 2: чип Kirin T92, экран на 5000 нит и звук до 240 Вт
 Xiaomi беззастенчиво использовала легендарную фразу Стива Джобса для анонса нового смартфона
 По прогнозам Илона Маска, к 2028 году искусственный интеллект превзойдет человека во всех сферах
 Starship прибыл на старт с первыми б/у теплозащитными плитками
 HyperOS от Xiaomi получила масштабное обновление с исправлением 180 уязвимостей
 Xiaomi выпустила беспроводной утюжок для волос с плазмой, термоконтролем и автономностью 70 минут
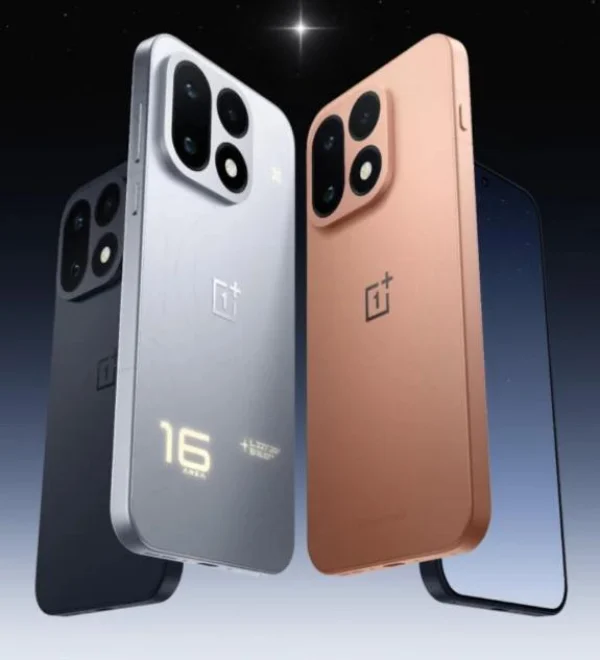 OnePlus 16 с процессором Snapdragon 8 Elite Extreme Gen 6 и экраном 185 Гц установил рекорд в AnTuTu, набрав 5,38 млн баллов