
Архитектура режимов работы x86-процессора
В этой публикации я поделюсь частью багажа знаний, который накопил в процессе погружения в OSDev и низкоуровневое системное программирование. Параллельно я тружусь над созданием профильной документации по Computer Science, которую совсем скоро опубликую на своем GitHub.
Стоит сразу оговориться: мой путь в этой сфере только начинается. Зачем же браться за перо? Все просто — чтобы систематизировать уже имеющийся опыт, получить ценные замечания от экспертов и, возможно, помочь начинающим разработчикам разобраться в этой непростой теме.
Как устроен процессор?
Большинство подобных материалов стартуют с избитой и донельзя упрощенной схемы вроде «Кнопка питания -> BIOS -> железо -> загрузчик -> ОС». Я же предлагаю зайти с другой стороны: как функционирует центральный процессор на фундаментальном уровне?
Конечно, даже далекие от IT люди имеют представление о битах и байтах. Но как именно кремниевый чип оперирует ими? Каким образом электрические сигналы доходят до транзисторов и как рождаются вычисления? На эти вопросы мы сегодня и ответим.
Манипуляции с битами на аппаратном уровне
По сути своей процессор довольно примитивен. У него нет встроенной команды «найти подстроку» — вместо этого он оперирует базовыми логическими операциями (AND, OR, XOR и т.д.). Углубляться в них я не стану, в сети полно исчерпывающей информации. Наборы подобных операций образуют инструкции. Они бывают как сложными и ресурсоемкими (например, INVLPG), так и элементарными вроде MOV или ADD. За один такт ядро способно обработать лишь одну инструкцию (в современных CPU это ограничение уже преодолено, но для вводной статьи такое допущение вполне допустимо), поэтому истинного параллелизма в рамках одного ядра не существует — все современные операционные системы используют псевдопараллелизм.
Помимо лимита на количество выполняемых за раз команд, процессор ограничен в объеме обрабатываемых данных за один проход. Этот показатель меняется в зависимости от режима работы и называется машинным словом.
Доставка битов к процессору
Роль проводников, доставляющих электрические импульсы к процессору, выполняют шины: шина данных и шина адреса. Первая транслирует непосредственно информацию для обработки, вторая передает адрес следующей инструкции. Шины имеют разную разрядность. Поскольку архитектура x86 восходит к 16-летним прародителям и сохраняет обратную совместимость, даже новейшие 64-битные чипы по умолчанию активируются в 16-битном режиме, а переключение ложится на плечи загрузчика или ОС. Иными словами, разрядность адресной шины напрямую зависит от текущего режима функционирования процессора.
Режимы функционирования процессора.
На сегодняшний день потребительские ПК задействуют три основных режима: — Real mode (16-битный режим). Характеризуется 16-битными регистрами (им я посвящу отдельный материал) и 16-битными машинными словами, но при этом 20-битной шиной адреса (об этом подробнее ниже). — Protected mode (32-битный режим). Логично, что здесь задействованы 32-битные регистры, шина адреса и машинные слова. — Long mode (64-битный режим). По аналогии: 64-битные регистры и машинные слова. Физическая адресная шина здесь расширена до 52 бит, тогда как на виртуальном уровне чаще всего задействуется 48 бит (либо 57 бит при пятиуровневой страничной организации, что также станет темой отдельного разговора).
Режим Real mode.
Переходим к детальному разбору процессорных режимов и начнем с классического real mode.
Ключевая особенность этого режима заключается в наличии косвенного доступа к BIOS посредством специальных программных прерываний. Ни protected, ни long mode похвастаться этим уже не могут из-за архитектурных барьеров.
У внимательного читателя наверняка возникнет закономерный вопрос: почему 16-битная среда задействует 20-битную адресную шину, и главное — как это реализовано? Здесь не обойтись без экскурса в историю. 16-битная шина давала доступ всего к 64 КБ RAM, что почти не превосходило возможности старых 8-битных машин. Инженерам Intel потребовалось срочно расширить этот лимит. Решением стала сегментация и увеличение шины до 20 бит, что позволило адресовать уже целый 1 МБ памяти.
Механизм сегментации.
Сегментация представляет собой модель организации адресного пространства, где память дробится на сегменты — непрерывные блоки, точка отсчета которых прописана в сегментном регистре. Сама информация хранится внутри сегмента, а ее конкретное положение определяется смещением (offset), записанным в регистре общего назначения (GPR).
В этой концепции адрес задается не прямым указанием байта, как в protected mode, а через формулу:
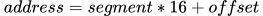
Откуда берется умножение на 16? Все просто: поскольку 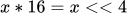 , на практике это выглядит так:
Сегмент: 0bXXXX XXXX XXXX XXXX
* 16 (он же << 4): 0bXXXX XXXX XXXX XXXX 0000
Сдвиг: 0b0000 YYYY YYYY YYYY YYYY
Адрес: 0bXXXX XXXX XXXX XXXX 0000 + 0b0000 YYYY YYYY YYYY YYYY
А если подставить реальные значения:
Сегмент: 0b0010 1001 0110 1001
* 16: 0b0010 1001 0110 1001 0000
Сдвиг: 0b0000 1010 0011 1010 0001
Адрес: 0b0010 1001 0110 1001 0000 + 0b0000 1010 0011 1010 0001 = 0b0011 0011 1010 0011 0001
Следовательно, напрямую обратиться к произвольному участку памяти не получится:
bits 16
main:
    mov [0xB8000], 'A' ; На экран ничего не выведется, поскольку архитектура требует адрес вида сегмент:смещение.

	mov ax, 0xB800
	mov es, ax
	mov di, 0
	mov [es:di], 'A' ; На экран выведется A, поскольку 0xB800 * 16 + 0 = 0xB8000, что как раз адрес VGA text buffer.
Линия A20.
Еще одна специфическая черта архитектуры x86 — наличие адресного проводника A20 на процессорной шине, который по умолчанию деактивирован. Без его принудительного включения любые запросы к памяти выше 1 МБ будут закольцовываться (так называемый wrap-around эффект). Иными словами, 20-й бит и все старшие разряды просто отсекаются, оставляя лишь младшую 20-битную часть. Пример:
Адрес: 0×10FFFF
Этот же адрес с выключенной A20 процессор читает как: 0×0FFFF
Поэтому для работы с памятью за пределами первого мегабайта шину необходимо активировать. Самый быстрый путь — задействовать Fast A20 gate, умещающийся всего в три ассемблерные строки:
in al, 0×92 ; Сохраняем значение порта 0×92 — порта, 1 бит (если считать от 0) которого как раз и отвечает за нужную нам линию, хотя и другой функционал тоже имеет.
or al, 2 ; Выставляем тот же 1 бит в 1.
out 0×92, al ; Записываем получившееся обратно в порт.
Хотя этот метод предельно прост, он не лишен изъянов: он предполагает, что первый бит порта всегда равен нулю, и не обрабатывает возможные сбои. Здесь мы жертвуем надежностью ради скорости реализации.
Protected mode.
Protected mode представляет собой 32-битную среду процессора. В отличие от предыдущего режима, здесь доступ к памяти носит линейный характер, планка максимального объема адресуемой памяти поднимается до 4 ГБ, а также открывается возможность задействовать страничную организацию (paging). Разберем детали.
Сегментация в защищенном режиме.
В этой среде сегментация выполняет преимущественно защитные функции, откуда и происходит название режима. В чем заключается эта защита? — Сегментные регистры (CS, DS, ES и т.д.) теперь хранят не чистые адреса, а селекторы — указатели на дескрипторы, содержащие базовый адрес сегмента, лимиты и права доступа. — При каждой загрузке селектора процессор в автоматическом режиме верифицирует эти параметры, пресекая любые нарушения без вмешательства ОС. — Это гарантирует максимальную гибкость (ОС может менять дескриптор, и все селекторы мгновенно начинают указывать на новые области) и изоляцию процессов, не позволяя им выходить за рамки дозволенного лимита.
Дескрипторы выступают в роли своеобразных регламентов. В глобальной таблице GDT (Global Descriptors Table) прописаны правила доступа к памяти и сегментам, а в IDT (Interrupt Descriptors Table) — сценарии реакции процессора на различные прерывания.
Ключевые особенности режима.
Protected mode требует предварительной настройки GDT — это жесткое архитектурное ограничение. Поэтому перед прыжком в 32-битный режим необходимо сформировать хотя бы базовую глобальную таблицу дескрипторов. Каждый элемент имеет строго определенный формат:
-
Байты 0-1. Limit, определяющий границу завершения сегмента.
-
Байты 2-4. Base, задающий точку старта сегмента.
-
Байт 5. Access byte, отвечающий за права доступа.
-
Байт 6. Флаги (старшая тетрада) совместно с Limit (младшая тетрада).
-
Байт 7. Base. Такая громоздкая структура обусловлена исключительно историческим стремлением к обратной совместимости с устаревшей кодовой базой.
Сама GDT должна стартовать с нулевого дескриптора. Ее предельный размер ограничен 64 КБ (65 535 байт из-за 16-битного поля лимита), что эквивалентно 8 191 дескриптору. С учетом нулевого элемента реальный лимит составляет 8 190 записей, хотя на практике редко задействуется больше пары десятков.
Также в этом режиме активируется paging — страничная адресация памяти. Ей стоит посвятить отдельный трактат, но базовую суть я обрисую.
После активации пейджинга (тумблером PG в системном регистре CR0) процессор переходит на работу с виртуальными адресами вместо физических. До включения этой опции в системе уже должны быть сформированы страничные структуры, обычно состоящие из четырех уровней: — PML4 (Page Map Level 4). Главная и самая крупная таблица, чей адрес записывается в регистр CR3. Все последующие виртуальные адреса будут привязаны к ней до тех пор, пока содержимое CR3 не изменится. Записи PML4 ссылаются на нижестоящий уровень. — PDPT (Page Directory Pointer Table). Принимает указатели из PML4 и транслирует их дальше. — PD (Page Directory). Функционирует аналогично предыдущей таблице. — PT (Page Table). Конечные записи этой таблицы ведут уже не к следующим структурам, а к физическим блокам памяти — фреймам (размером 4 КБ), которые соответствуют концепции страниц в адресном пространстве.
Иными словами, перед нами типичная матрешка, где на финише вместо искомого объекта обнаруживается адрес нужных данных.
Каждая таблица вмещает до 512 записей, ссылающихся на дочерние элементы (либо на фреймы на уровне PT). Таким образом, PML4 оперирует 512 таблицами PDPT, каждая из которых ведет к 512 таблицам PD, а те — к 512 таблицам PT, завершающимся фреймами.
Описанная схема актуальна для long mode. В protected mode без PAE адресация является двухуровневой (PD -> PT) с емкостью по 1 024 записи, а с активированным PAE — трехуровневой (PDPT -> PD -> PT) по 512 записей в каждой.
Разумеется, это колоссально упрощенная модель, опускающая массу нюансов и технических тонкостей, но для общего понимания логики процесса ее вполне достаточно.
Long mode.
Финальный этап — 64-битный режим. Сегментация здесь практически упразднена, а использование paging является обязательным условием работы. Поговорим о деталях.
Сегментация.
В Long mode классическая сегментация практически не задействуется. Большинство привычных сегментных регистров просто игнорируются ядром процессора. В строю остаются лишь два из них: FS и GS. Они зарезервированы под нужды TLS (Thread-Local Storage) и могут применяться операционными системами по собственному усмотрению.
Адресация в этом режиме претерпела значительные изменения. Несмотря на 52-битную физическую шину, для виртуальной адресации обычно применяются 48 бит. Здесь мы вновь возвращаемся к страничной структуре, поскольку в Long mode она используется безусловно. Виртуальный адрес выглядит следующим образом:
0x0000124836C9BEDF
=
0b0000 0000 0000 0000 0001 0010 0100 1000 0011 0110 1100 1001 1011 1110 1101 1111
Здесь старшие 16 бит должны дублировать 47-й бит (так называемый canonical address). Младшие 12 бит играют роль смещения внутри страницы, а промежуточные блоки по 9 бит задают индексы таблиц на соответствующих уровнях:
0b0000000000000000 000100100 100100000 110110110 010011011 111011011111
 |CanonicalAddress|  PML4  |   PDPT   |   PD    |   PT   |    offset   |
Процесс трансляции (вычисления физического адреса на основе виртуального) протекает следующим образом: PML4[36] ведет к PDPT; оттуда PDPT[288] указывает на PD; затем PD[438] адресует PT, а PT[155] выводит на конкретный фрейм, к которому добавляется смещение 3807 для получения искомого байта.
Концепция Canonical address делит виртуальное пространство надвое. Нижний диапазон (где старшие 16 бит равны нулю) отдан под нужды пользовательских приложений, а верхний (где те же 16 бит равны единице) зарезервирован за ядром ОС (higher half). Образующийся между ними «канонический разрыв» поглощает свыше 99,99% потенциальных адресов, однако оставшегося пространства с запасом хватает на 128 ТБ для софта и 128 ТБ для ядра (всего 256 ТБ на систему), чего с лихвой хватит домашним ПК на ближайшие десятилетия. Тем не менее, уже активно внедряется 5-уровневая адресация на 57 бит и проектируется 6-уровневая.
Переключение между режимами.
Стоит отдельно перечислить условия, необходимые для смены процессорных режимов: — Для прыжка из real mode в protected mode требуется корректно настроенная таблица GDT, чей адрес прописан в регистре GDTR, и выставленный бит PE в регистре CR0. — Для перехода из protected mode в long mode необходимо заранее подготовить табличные структуры страниц, занести адрес PML4 в регистр CR3, активировать пейджинг поднятием бита PG в том же CR0, а также взвести бит PAE в CR4 и бит LME в регистре EFER. — Завершающим аккордом любого перехода выступает выполнение инструкции far jump для обновления сегментного регистра CS.
Заключение.
Поскольку это мой дебют в жанре технической статьи, материал наверняка получился несовершенным. Со временем, по мере накопления практики, качество текстов будет расти. Что касается моих собственных изысканий, то я поддерживаю активность на GitHub и периодически публикую заметки в своем Telegram-канале. Мой скромный практический опыт на текущий момент воплощен в двух ключевых проектах:
Буду искренне рад любой конструктивной критике и поддержке со стороны сообщества.
Благодарю за уделённое время!
Похожие статьи
 Компактный фотопринтер от Xiaomi: печать напрямую со смартфона
 «Почта России» начала отправлять уведомления о посылках через мессенджер MAX
 Почему дешёвая подсветка док-станции Flydigi заставила меня сделать свою собственную
 Российские операторы потратили на рекламу 5G около миллиарда рублей за месяц
 ИИ-модель OpenAI взломала чужой криптовалютный кошелек для оплаты комиссии в сети Ethereum
 Xiaomi выпустила металлический чемодан с бесшумными колесами
 PowerColor готовит компактную, но небыструю низкопрофильную Radeon RX 9050 8GB LP
 SK Hynix анонсировала ультракомпактный процессор H-TPU для интеграции в SSD