Организовал для юных моделей проектный институт: почему слабое деление на разделы увеличило результат вчетверо — пять главных пунктов
Я тепломеханик, руковожу отделом в проектном институте, в сфере проектирования уже четырнадцать лет. Программированием профессионально никогда не занимался, а с нейросетями экспериментирую чуть меньше года. Этой весной я задался целью вырастить из слабых локальных моделей коллективный разум, который превзошел бы по эффективности любую из них по отдельности. Интеллектуального прорыва не произошло. Зато в процессе я спроецировал структуру классического проектного института на шесть компактных языковых моделей и эмпирически проверил, какие именно элементы этой схемы жизнеспособны под нагрузкой. Сработал всего один принцип — деление документации на разделы. Именно он дает ощутимый прирост производительности даже слабым архитектурам.
[кат]Истоки эксперимента
Все началось с проекта «Мицелий» — так я озаглавил свою весеннюю инициативу. Меня увлекли труды Ильи Пригожина о диссипативных структурах, а также академические исследования, в которых крупные популяции нейросетей автономно распределяют роли и вырабатывают собственный язык коммуникации, даже будучи абсолютно идентичными. Мне захотелось смоделировать условия, при которых ансамбль слабых моделей эволюционировал бы в нечто более мощное, чем каждый его участник по отдельности. Если говорить академическим языком — добиться сильной эмерджентности.
Модели намеренно подбирались слабые. Если топовая нейросеть успешно справляется с задачей сама, стимулы для синергии в рое исчезают. Была и чисто прагматическая причина: в моем распоряжении видеокарта GTX 1660 SUPER с 6 ГБ видеопамяти, а архитектура эксперимента требовала одновременного удержания в памяти нескольких моделей и обработки тысяч запросов. В итоговый пул вошли: qwen2.5-coder-1.5b, qwen3-1.7b, llama-3.2-1b, gemma-3-1b, internvl3-2b и smollm2-1.7b. Да, это решения предыдущих поколений, за которые меня уже справедливо покритиковали на Reddit. Однако менять состав по ходу эксперимента было нельзя, поскольку использовались зафиксированные на диске ответы из предыдущих прогонов по тем же тестам.
Эксперимент не оправдал ожиданий. На выборке из 200 задач MBPP рой показал результат в 29% против 52% у банального метода best-of-N, где модель просто совершает несколько попыток. Строгая эмерджентность — ситуация, когда коллектив решает задачу, непосильную ни одному из его участников, — при двух независимых проверках составила ровно ноль. Лишь однажды наблюдался слабый намек на синергию, когда нейросети заполняли разные поля единого ответа, но развить этот успех не удалось.
Весь софт для тестов написали ИИ-агенты, тогда как я формулировал задачи и анализировал метрики. Параллельно я дорабатываю форк llama.cpp, чтобы запускать крупные модели на тех же скромных 6 ГБ — об этом шла речь в предыдущей публикации. Читатели тогда интересовались, есть ли от мини-моделей реальная польза помимо высокой скорости генерации токенов. Данная статья как раз посвящена качеству и тому ценному опыту, который удалось извлечь из неудавшегося эксперимента.
Метод Альберта Кана
Альберт Кан — легендарный американский архитектор, построивший заводы для Генри Форда. В период с 1929 по 1932 год его бюро спроектировало для Советского Союза около пятисот промышленных предприятий, включая Сталинградский тракторный завод, а через московское представительство прошли обучение тысячи отечественных инженеров. Существует мнение, что советская система проектных институтов берет начало именно оттуда. Не берусь судить об исторической достоверности, но организационную структуру я узнаю безошибочно — я в ней работаю каждый день.
Процесс устроен следующим образом. Главный инженер проекта (ГИП) делит объект на специализированные разделы: тепломеханику, электроснабжение, строительные конструкции, автоматику и прочие, за каждый из которых отвечает профильный отдел. Готовый раздел проходит внутреннюю проверку (ВДП — внутридисциплинарный контроль). Затем смежные отделы сверяют чертежи на предмет коллизий (МДП — междисциплинарная проверка): например, мой насос должен совпасть с фундаментом, запроектированным строителями. Сложные коллизии выносятся на уровень главного специалиста. На финальном этапе нормоконтроль проверяет проект на соответствие стандартам, после чего документация комплектуется в альбомы и передается заказчику.
Ни один специалист не удерживает в голове всю станцию целиком — это физически невозможно. Маленькая модель, получившая на вход сразу восемнадцать записей с требованием отобрать нужные, находится в том же положении, что и инженер, заваленный всей проектной документацией одновременно. Возникла идея применить к нейросетям тот подход, который ГИП использует в реальной работе.
Профессиональная деформация в чистом виде.
Тестовая задача
Был подготовлен простой синтетический полигон. Каждая задача содержала массив из 18 транзакций (по одной на строку). Модели требовалось выделить все транзакции, соответствующие конкретной категории и региону. Искомых записей насчитывалось от двух до пяти, причем рядом намеренно располагались похожие-дистракторы: совпадающие по категории, но с другим регионом, и наоборот (по 2–4 штуки каждого типа). Вот фрагмент одной из тестовых задач:
База транзакций:
TXN-0003 | account: Fernwood Industries | category: software-licensing | amount: 295.60 | region: LATAM | date: 2026-12-14
TXN-0014 | account: Granite Ridge LLC | category: office-supplies | amount: 243.44 | region: APAC | date: 2026-01-09
TXN-0017 | account: Ironpeak Supply | category: consulting | amount: 219.51 | region: EU-West | date: 2026-12-04
TXN-0001 | account: Cinderpath Co | category: software-licensing | amount: 320.54 | region: LATAM | date: 2026-10-16
TXN-0005 | account: Cobalt & Finch | category: software-licensing | amount: 44.56 | region: EU-West | date: 2026-10-25
...

Найди ID всех транзакций, у которых category = "software-licensing" И region = "LATAM".
Выведи ТОЛЬКО список подходящих ID через запятую, без пояснений. Если подходящих нет, выведи слово НЕТ.
Далее на основе найденных записей требовалось вычислить сумму, количество или максимальное значение и сравнить с порогом, выдав булев ответ ДА или НЕТ. Арифметические вычисления моделям не доверялись — за них отвеча программный код. От нейросети требовалась исключительно точность фильтрации. Задача засчитывалась только в том случае, если модель возвращала абсолютно точный набор идентификаторов без пропусков и лишних элементов.
Безусловно, задача выглядит игрушечной. Тем не менее, она отражает главную проблему больших текстовых контекстов: полезная информация в ней утоплена среди визуально похожих «шумных» данных.
Деградация точности к концу контекста
Первым делом я провел ретроспективный анализ позиционного распределения старых ответов. На выборке из 120 задач совместными усилиями шести моделей первая запись находилась в 61% случаев, а последняя, восемнадцатая — лишь в 21%. Кривая успешности демонстрировала плавный и почти линейный спад от начала к концу списка. При этом знаменитый провал внимания в середине контекста, описанный в работе Lost in the Middle (Liu et al., 2023), в моих тестах не зафиксирован.
Поначалу я ошибочно предположил, что к финалу списка модель начинает чаще отвечать «нет». Именно эта гипотеза легла в основу моего отчета и поста на Reddit. Один из читателей посоветовал перепроверить исходные массивы данных, и оказался абсолютно прав. Модель не становится более сдержанной: как в первой трети списка, так и в последней она маркирует примерно пятую часть записей (0.21 и 0.19 соответственно). Проблема в том, что в конце она чаще ошибается в классификации. Количество корректно найденных целевых элементов падает (с 0.50 до 0.30), а доля ложных срабатываний среди неподходящих строк растет (с 0.14 до 0.16). Проще говоря, к концу текста модели хуже справляются с разбором похожих строк. В отчет внесена соответствующая поправка, но первоначальный ошибочный вывод я сохранил для прозрачности выводов.
Принцип деления на разделы
Далее был применен метод Кана. Массив из 18 записей программно нарезался на три независимых блока по шесть строк с сохранением исходной последовательности внутри каждого. Нейросети к процессу разбиения не привлекались. В рамках другого эксперимента я пробовал поручить мини-модели самостоятельную декомпозицию задачи на шаги: четверть сгенерированных планов даже не распарсилась в валидный JSON, а до правильного ответа из ста попыток дошла всего одна. Из такой модели ГИП никакой.
Каждая модель анализировала блоки изолированно. На этапе внутридисциплинарного контроля (ВДП) реализована фильтрация: если модель упоминала ID, отсутствующий в ее блоке, он классифицировался как галлюцинация и отсекался кодом (за весь прогон было зафиксировано лишь пять подобных случаев). Голос за конкретную транзакцию учитывался только из того блока, где она физически располагалась. Все критерии успешности эксперимента фиксировались в протоколе заранее, исключая соблазн подкрутить метрики post factum. Процесс занял 720 вызовов и около десяти минут расчетного времени на той же GTX 1660 SUPER.
Разрыв в качестве распознавания между началом и концом списка практически нивелировался:
|
полнота |
весь список |
блоки по 6 |
|---|---|---|
|
записи 1-6 |
0,51 |
0,60 |
|
записи 13-18 |
0,30 |
0,57 |
|
разрыв |
0,20 |
0,02 |

На контрольной выборке из 40 задач тренд падения точности для неразрезанного списка сохранялся, но был менее выраженным. После сегментации позиция записи в тексте перестала оказывать критическое влияние на вероятность ее обнаружения.
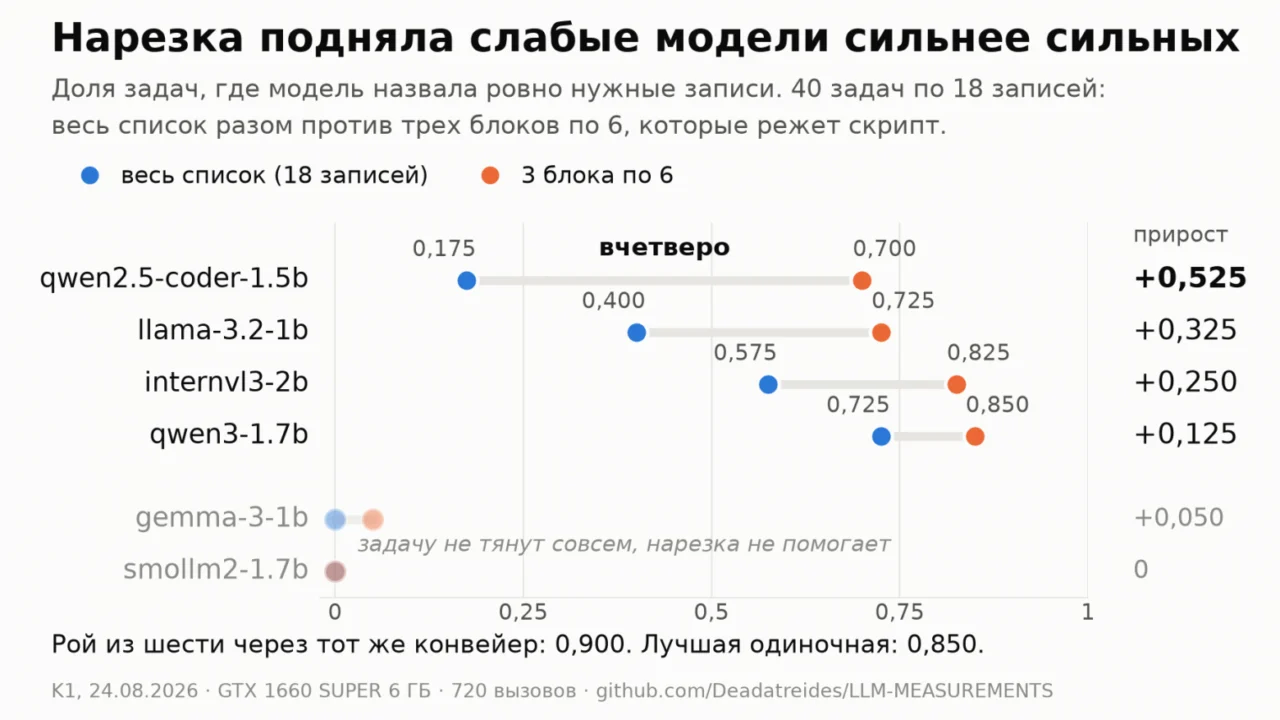
Дальше произошло то, чего я совершенно не ожидал. Ниже представлена доля задач, решенных моделями с абсолютной точностью:
|
модель |
весь список |
блоки |
прирост |
|---|---|---|---|
|
qwen2.5-coder-1.5b |
0,175 |
0,700 |
+0,525 |
|
llama-3.2-1b |
0,400 |
0,725 |
+0,325 |
|
internvl3-2b |
0,575 |
0,825 |
+0,250 |
|
qwen3-1.7b |
0,725 |
0,850 |
+0,125 |
|
gemma-3-1b |
0,000 |
0,050 |
+0,050 |
|
smollm2-1.7b |
0,000 |
0,000 |
0 |
Закономерность очевидна: чем слабее модель, тем драматичнее прирост результативности. Кодер продемонстрировал четырехкратный рост, практически догнав лидера среди монолитных конфигураций (0.700 против 0.725 у qwen3-1.7b на полном списке). Собственно, ради этого Кан и дробил проектный процесс: при корректной декомпозиции отстающие участники подтягиваются, а их усилия начинают складываться в качественный результат. При этом архитектуры gemma и smollm изначально не справлялись с задачей, и сегментация им не помогла.
Контекстная нарезка — инструмент не новый, его так или иначе используют все разработчики, работающие с большими объемами документации. Мне было принципиально важно измерить точный прирост эффективности для слабых моделей и оценить реальный вклад коллективного взаимодействия.
Иллюзия прорыва
Главной целью эксперимента оставалась проверка эмерджентности, порог которой был строго зафиксирован в протоколе: если ансамбль выдает правильный ответ хотя бы в трех из сорока задач, а в одиночку модели с ними не справляются, эффект зафиксирован. По первоначальным расчетам показатель составил 34 из 40. Я уже был готов праздновать успех, пока не проанализировал корректность сопоставления. С одной стороны выступал сложный конвейер (блочная структура, валидация, голосование, агрегация), с другой — базовая модель, обрабатывающая весь массив из 18 записей единым куском. Некорректные условия сравнения обесценивали результат.
Если пропустить через аналогичный конвейер сильнейшую одиночную модель (qwen3-1.7b), она выдает точность 0.850. Совместная работа всех шести моделей дает 0.900. Гипотетический «оракул», учитывающий успешность любой из шести моделей, демонстрирует 0.975. Строгая эмерджентность оказалась равна нулю: итоговый синтезированный ответ ни разу не превзошел максимальные возможности лучшего одиночного участника. Рой добавил всего пять процентных пунктов.
Значение 34 так и осталось в итоговом файле рядом с ошибочным вердиктом — я намеренно не стал его удалять, чтобы методологическая погрешность оставалась на виду.
Эффективность элементов проектного института
|
элемент конторы |
что это у моделей |
что дал |
|---|---|---|
|
ГИП делит объект на разделы |
скрипт режет 18 записей на 3 блока по 6 |
почти все: разрыв 0,20 → 0,02, точный набор 0,75 → 0,90 |
|
исполнители |
6 моделей на каждый блок |
+0,05 сверх лучшей одиночной |
|
ВДП |
ID не из своего блока идет в брак |
поймано 5 выдумок |
|
МДП |
сверка на стыках блоков |
сверять нечего, блоки независимы |
|
нормоконтроль |
проверка формата ответа |
ошибок формата не было |
|
главный специалист |
точечный вопрос по одной строке |
не понадобился |
|
ревизии |
повторный круг, пока ответ неуверенный |
не понадобились |
Из семи заимствованных элементов организационной структуры нагрузку выдержал лишь один — разделение на блоки. Остальные либо внесли минимальный вклад, либо оказались избыточными для данной задачи. Междисциплинарную проверку (МДП) в данном сценарии оценить невозможно, поскольку блоки независимы и коллизий на стыках не возникает. Требуется принципиально иной класс задач, где разделы ссылаются друг на друга (по аналогии со взаимодействием тепломехаников и строителей). Это станет темой для следующего этапа исследований.
Технические детали для скептиков
Использованные модели в формате GGUF: qwen2.5-coder-1.5b-instruct Q4_0, llama-3.2-1b-instruct Q4_0, qwen3-1.7b Q4_0, internvl3-2b Q4_K_M, gemma-3-1b-it Q5_K_S, smollm2-1.7b-instruct Q4_K_M. Аппаратная база: GTX 1660 SUPER 6 ГБ.
Конфигурация теста: 40 задач, 3 блока, 6 моделей, суммарно 720 вызовов за 614 секунд. Базовые ответы по целому списку импортированы из предыдущих прогонов по тем же 40 кейсам.
Программная постобработка приводила ответ модели к ближайшему валидному набору (корректное решение всегда включает все строки с целевой парой «категория-регион»). Данное правило применялось симметрично как для монолитного списка, так и для блочной обработки.
Протокольные пороги: полнота в конце списка не ниже 0.45 (фактически 0.57), падение точности не более 0.12 (фактически 0.02), доля точных совпадений не ниже 0.85 (фактически 0.90). Эмерджентность по первоначальным критериям — 34 задачи, по корректным — 0.
Позиционная деградация оценена на ретроспективной выборке из 120 задач без дополнительных вызовов. Корректировка относительно характера ошибок верифицирована на тех же массивах данных. Исходные скрипты доступны в репозитории.
Практические выводы
Если вы передаете модели массив документов, длинный перечень записей или контекст для AI-агентов, практикуйте жесткую сегментацию. В моем тесте оптимальный размер блока составил шесть элементов — значение было выведено эмпирически на основе кривой полноты (первые шесть позиций распознавались надежнее всего). Оптимальность размеров в три или девять строк я не проверял. Декомпозицию обязательно должен выполнять детерминированный скрипт. Валидацию ответов также следует возложить на код: выявление идентификаторов, отсутствующих в целевом блоке, реализуется элементарной проверкой.
С точки зрения расхода токенов нарезка практически бесплатна: три блока по трети исходного объема эквивалентны оригинальному тексту плюс служебный промпт для каждого фрагмента. Количество запросов возрастает втрое, но за счет уменьшения длины контекста они обрабатываются быстрее. При этом надстройка в виде роя из шести моделей увеличивает нагрузку еще вшестеро, обеспечивая прирост точности всего на пять пунктов. Столь незначительный дивиденд вряд ли оправдывает затраты ресурсов.
Ограничения исследования
В экспериментах участвовали исключительно модели размерностью 1–2B, что обусловлено лимитом видеопамяти в 6 ГБ. Тестирование более крупных архитектур не проводилось. Как следует из сводной таблицы, с ростом базовой мощности модели маржинальный прирост от декомпозиции снижается (у qwen3-1.7b он составляет всего +0.125). Логично предположить, что для моделей уровня 7B и выше этот эффект будет еще менее выраженным, однако это требует отдельной проверки. Эксперимент ограничивался сорока задачами в рамках единого домена и единственной схемы разбиения.
Итоговый бинарный ответ (ДА/НЕТ) сошелся во всех 40 кейсах, но этот показатель обманчив: угадать булево значение можно и при ошибиться в деталях. Поэтому ключевой метрикой служит абсолютная точность выборки — 0.900.
Исходные материалы
Отчет, протокол испытаний, скрипты автоматизации и сырые датасеты ответов опубликованы в открытом репозитории на GitHub: REPORT_K1.md. Там же вы найдете детальный разбор механики позиционного распада и проверочный скрипт.
В следующей публикации я планирую разобрать сценарий, где нейросеть пишет тесты для собственного кода. Результаты там удручающие: 42% сгенерированных тест-сьютов вообще не запускаются, а из работоспособных 60% забраковали заведомо корректную реализацию. Посредник-тестировщик из мини-модели оказался столь же сомнительный, сколь и ГИП.
Хотелось бы задать вопрос разработчикам мультиагентных систем: проводили ли вы честное сравнение своего роя с одиночным агентом максимальной мощности, пропущенным через аналогичный конвейер? В моих тестах разница составила скромные пять пунктов. Удалось ли кому-нибудь зафиксировать превосходство, превышающее статистическую погрешность?
Похожие статьи
 FLAC и MP3: какие детали пропадают при сжатии и заметно ли это на слух
 Приключения латиницы: венгерские иллюминаты и румынский ренессанс
 Могут ли черные дыры взрываться?
 Загрузка сознания: почему я верю в сверхинтеллект
 Интервью с Дэвидом Уоллесом: вся правда о стреле времени
 ТикТок из 1940-х: во сколько американцам обходились развлечения во время Второй мировой
 Норвежский единорог из кубика Рубика: история роботизированных складов AutoStore
 Устройство, которому верят из-за его лжи