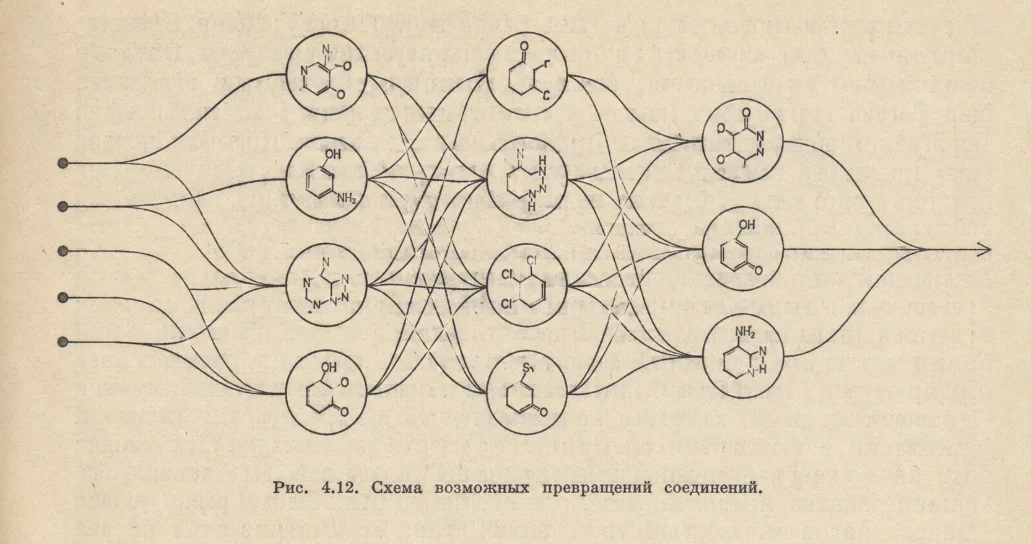
Объяснение архитектуры современных нейросетей через призму методички 1990-х годов
Перебирая старые учебные пособия по линейной алгебре (да, у меня есть такая специфическая привычка, можете не удивляться), я наткнулся на неожиданный фрагмент о химии. Автор с абсолютно невозмутимым видом заявлял: «Молекула воды — это вектор (2, 0, 1). Молекула метана — вектор (4, 1, 0)». И тут же, без каких-либо вводных, переходил к линейной зависимости векторов, преподнося это как нечто само собой разумеющееся.
Сначала мне показалось, что это просто вольная методическая аналогия для наглядности. Но поразмыслив над этим с полчаса, я осознал правоту автора и попутно понял, почему любую предметную область можно успешно упаковать в нейросеть. Просто в девяностых это гордо именовалось линейной алгебре, а не модным representation learning.
Химия для тех, кто не любит химию
Суть подхода предельно прозрачна. Берем набор из $n$ базовых элементов (водород, углерод, кислород и т. д.). Каждому элементу ставим в соответствие уникальный вектор, где на его персональной позиции стоит единица, а во всех остальных — нули:
-
b1 = (1, 0, …, 0) — водород,
-
b2 = (0, 1, …, 0) — углерод,
-
b3 = (0, 0, 1, …, 0) — кислород.
Если этот принцип кажется вам смутно знакомым, поздравляю: вы только что мысленно воспроизвели one-hot encoding. Именно так сегодня кодируют категориальные переменные перед загрузкой в модель. Разумеется, автор методички из девяностых оперировал другими терминами, но по сути описал именно этот механизм, заменив привычные токены химическими атомами.
Двигаемся дальше. Любая молекула представляет собой линейную комбинацию этих базисных векторов, умноженных на целые неотрицательные коэффициенты. Сколько атомов конкретного типа входит в состав вещества, столько единиц мы и берем в качестве множителей.
Взглянем на воду в базисе (H, C, O): H2O = 2·b1 + 0·b2 + 1·b3 = (2, 0, 1). А вот формула углекислого газа: CO2 = 0·b1 + 1·b2 + 2·b3 = (0, 1, 2).

В академической среде это называется «bag of atoms» (по аналогии с известным «bag of words»). Порядок расположения элементов стирается, фиксируется исключительно их количество. По сути, классическая брутто-формула изначально и является таким «мешком», хотя спутать ее со структурной формулой невозможно — об этом мы еще поговорим.
Молекула воды предсказывает саму себя
Естественно, мне захотелось проверить эту теорию на практике. Если молекула — это вектор, а масса отдельного атома — просто скалярная величина, то молярная масса всего соединения должна вычисляться как простейшая линейная функция от вектора молекулы, то есть через обычное скалярное произведение.
Берем стандартные веса: водород весит 1.008, углерод — 12.011, а кислород — 15.999 а.е.м. Теперь рассчитаем молярные массы как взвешенные суммы:
-
m(H2O) = 2·1.008 + 0·12.011 + 1·15.999 = 18.015,
-
m(CO2) = 0·1.008 + 1·12.011 + 2·15.999 = 44.009,
-
m(C2H2) = 2·1.008 + 2·12.011 + 0·15.999 = 26.038,
-
m(CH4) = 4·1.008 + 1·12.011 + 0·15.999 = 16.043.
Сопоставляем с эталонными данными: вода — 18.015, углекислый газ — 44.01, ацетилен — 26.04, метан — 16.04. Погрешность минимальна и упирается исключительно в округление справочных констант.
К какому выводу мы пришли? Перед нами элементарная нейросеть без скрытых слоев, лишенная функций активации, с единственным нейроном на выходе. В качестве входных данных выступает молекулярный вектор, а весовыми коэффициентами служат атомные массы. Обучать такую систему нет нужды, поскольку идеальные веса давно выведены химиками и записаны в таблицу Менделеева. Тем не менее, если бы эти константы были нам неизвестны, а в распоряжении имелась лишь пара сотен связок «вектор молекулы — молярная масса», стандартная линейная регрессия с легкостью подогнала бы нужные коэффициенты без единой химической формулы. Именно так функционируют актуальные модели для прогнозирования свойств материалов: они абстрагируются от физических законов, филигранно выявляя статистические паттерны в векторизованных составах.

ИИ‑роутер — доступ к 300+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Почему это универсально для любых задач
Подытожим описанный механизм в виде фундаментального правила.
Базовая архитектура любой нейросети сводится к последовательности математических шагов: умножение вектора на матрицу, добавление смещения, прогон через нелинейность и циклический повтор. Единственное безальтернативное условие для входных данных — они должны быть представлены в виде вектора, то есть элемента пространства, где корректно определены операции сложения и умножения на скаляр.
Как только вам удается переложить реальные объекты вашей предметной сферы на язык векторов, сохранив смысл арифметических операций, вся мощь линейной алгебры начинает работать на вас. Не имеет ни малейшего значения, что именно вы векторизуете: слова (word2vec, токенные эмбеддинги), пиксели изображений, пользовательские корзины интернет-магазина или химические элементы. Нейросети абсолютно безразлично происхождение данных — она оперирует исключительно числами и матрицами.
В этом и кроется главный секрет современного ИИ: девяноста процентам успеха в машинном обучении предшествует качественное проецирование реального мира в векторное пространство, тогда как дальнейший тренировочный процесс библиотеки берут на себя.
Где концепция «мешка атомов» дает сбой
Автор учебника справедливо отмечал, что реальным химическим соединениям соответствуют далеко не любые векторы, а лишь те, чьи координаты выражаются целыми неотрицательными числами. Однако в химии существует куда более тонкая проблема, которую методичка деликатно обошла стороной.
Рассмотрим два соединения: этанол (C2H6O) и диметиловый эфир (C2H6O). Это совершенно разные субстанции, отличающиеся температурой кипения, токсичностью и химическим поведением. Тем не менее, в стандартном атомном базисе их состав описывается абсолютно идентичным вектором (2, 6, 1). Подход «bag of atoms» не способен разделить изомеры, поскольку он напрочь игнорирует ключевой фактор — топологию связей между атомами.

С точно с таким же тупиком сталкивался классический NLP-метод «bag of words» до появления трансформеров: фразы «собака укусила почтальона» и «почтальон укусил собаку» казались ему близнецами, поскольку порядок слов стирался.
Проблема решается схожими методами. Если в обработке текста на помощь пришли позиционные эмбеддинги и механизм attention, то в химии задействуют графовые нейросети (GNN). Здесь молекула моделируется не плоским вектором количеств, а полноценным графом связей, позволяющим сети анализировать пространственную топологию.
Алгоритм работает следующим образом: каждый атом по-прежнему задается вектором (как в том самом учебнике), но теперь это лишь локальная характеристика узла графа, дополненная типом элемента. Далее узлы обмениваются сигналами с соседними элементами по химическим связям, агрегируют полученные векторы и корректируют собственные представления. Всего за несколько итераций информация о пространственной структуре диффундирует по всему графу.
На датасете QM9, содержащем более 100 000 компактных органических молекул с просчитанными квантовыми параметрами, подобные графовые сети прогнозируют 11 из 13 целевых характеристик с точностью, сопоставимой с ресурсоемкими квантовохимическими расчетами. Главное отличие от простой брутто-формулы заключается в учете связей, благодаря чему этанол и диметиловый эфир для сети превращаются в уникальные объекты.
От трех атомов к двадцати аминокислотам
Тот же основополагающий принцип, но в гораздо больших масштабах, применяется в архитектурах для предсказания белковых структур. Разница с учебником очевидна: вместо трех базовых атомов здесь задействовано 20 аминокислот, а вместо компактных молекул — полимерные цепи из сотен элементов.
Белок — это строго упорядоченная последовательность аминокислот. К двадцати основным добавляется редкий селеноцистеин, формируя алфавит примерно из 21 знака. Самый примитивный способ кодирования почти дословно копирует подход b_k из методички: формируется вектор длиной 21, где единицей отмечена нужная аминокислота, а остальные позиции занулены. Такой one-hot encoding до сих пор используют в качестве отправной точки в исследованиях белковых эмбеддингов — эталона, с которым сравнивают современные модели, и который те неизменно превосходят.
Проигрывает он по той же причине, что и простая брутто-формула перед графами. One-hot не понимает, что физико-химические свойства лейцина и изолейцина практически идентичны. Для вектора это два независимых индекса, равноудаленных друг от друга и от остальных восемнадцати элементов. Поэтому разработчики поступают точно так же, как создатели word2vec: жесткий one-hot заменяют на обучаемый эмбеддинг. Он динамически подстраивается в процессе тренировки так, чтобы близкие по природе аминокислоты занимали соседние позиции в векторном пространстве.

Модели семейства ESM сконструированы ровно по этой схеме. Белок рассматривается как текстовое предложение, аминокислота выступает в роли токена, а сама нейросеть представляет собой трансформер, решающий задачу, аналогичную BERT в NLP — предсказание замаскированного токена по контексту. Только вместо угадывания слова в конструкции «он пошел в [MASK]», сеть восстанавливает пропущенную аминокислоту, опираясь на эволюционный контекст миллионов реальных белковых последовательностей. На выходе каждая аминокислота внутри конкретного белка обретает контекстный вектор, на порядки превосходящий жесткий one-hot за счет скрытой эволюционной и структурной логики, усвоенной моделью самостоятельно.
AlphaFold2 делает следующий шаг вперед. Внутри модели поддерживаются два параллельных слоя представлений: множественное выравнивание последовательностей (MSA), где строки отражают гомологичные участки одного белка у разных организмов, и парное представление (pair), оценивающее вероятность физического контакта между любыми двумя аминокислотами цепи.
Ядро системы (Evoformer, состоящий из множества блоков) перераспределяет внимание по элементам MSA-матрицы, итеративно уточняя парные связи до тех пор, пока из эволюционной статистики не проступит пространственная геометрия белка. Финальный модуль транслирует эти векторы в точные трехмерные координаты атомов.
Любопытно, что в фундаменте этого грандиозного механизма лежит та же самая идея из университетской методички: аминокислота задается координатами в векторном пространстве. Разница лишь в том, что размерность пространства теперь измеряется не тремя осями (H, C, O), а тысячами обучаемых параметров, а правила комбинаторики выводятся автоматически на массивах данных с помощью маскированного языкового моделирования.
Более свежая модель ESMFold вообще отказалась от использования MSA. Выяснилось, что при достаточной емкости языковая модель способна самостоятельно экстраполировать эволюционную статистику из «сырых» последовательностей, предсказывая пространственную форму напрямую по эмбеддингам без поиска гомологов. Это работает в разы быстрее AlphaFold 2, пусть и ценой микроскопической потери в точности.
Возвращаясь к методичке
Конечно, автор того старого учебника не совершал глобальных научных прорывов — линейная алгебра к моменту публикации существовала уже много десятилетий. Тем не менее, он блестяще проиллюстрировал ключевой тезис: как только сложный объект переведен на язык векторов, к нему начинает применяться мощнейший аппарат абстрактной математики. При этом совершенно неважно, что именно кодируют координаты — атом водорода, остаток аминокислоты или токен в языковой модели.
Дистанция между тремя простыми атомами из потрепанной методички и сложнейшими структурами ESMFold или AlphaFold 2 на практике оказалась куда короче, чем кажется. Разница сводится лишь к размерности векторных пространств и к тому, кто именно рассчитывает коэффициенты — студент с калькулятором за письменным столом или кластер мощных GPU, молотящий вычисления неделями.
Современные нейросети выполняют ровно те же скалярные произведения, но в гиперразмерных пространствах, с огромными вычислительными мощностями и нелинейными активациями между слоями. Фундаментальные принципы, объясняющие сегодня способность AlphaFold 2 моделировать белки, а GPT — осмыслять человеческий язык, были фактически описаны на пожелтевших страницах старых учебников десятилетия назад. Всё упирается в векторы, остальное — технические детали.
P.S.: Сама методичка принадлежит перу Р. А. Симоненко и называется «Методическая разработка для студентов химического факультета. Часть 1. Векторы, матрицы и определители». Она досталась мне в виде обычных ксерокопий, в свободном доступе в сети я ее, увы, не встречал.
Похожие статьи
 Как шведские энтузиасты в гараже обошли стартап Бэббиджа с бюджетом в 30 паровозов
 Эволюция кода: история ИТ. Часть 5. Гэри Килдалл
 Очередная, 100501-я версия латиницы для русского языка
 Получение энергии из атмосферы
 В России испытали новый СВЧ-радиометр МРИТ-76 для измерения температуры жидкого чугуна
 Вселенная поразительно эксцентрична
 Истоки цивилизации: от городов к канализации
 Дело Бранденбурга против Огайо: как суд отстоял свободу слова (и оправдал негодяя)