
Нейропротез восстановил естественную речь пациентки через 18 лет молчания с помощью декодирования сигналов мозга в реальном времени
Фото: Noah Berger
Группа нейроинженеров из Калифорнийских университетов в Беркли и Сан-Франциско представила инновационную систему, способную трансформировать нейронные сигналы в синтезированную речь с задержкой менее секунды. Впервые такая технология предоставила возможность 47-летней Энн, потерявшей дар речи после перенесённого инсульта в 2005 году, общаться с помощью голоса, практически моментально выражающего её мысли. Это достижение открывает новые горизонты в восстановлении коммуникативных способностей у пациентов с тяжёлыми формами паралича.
В основе технологии лежит алгоритм, аналогичный используемым в голосовых помощниках, таких как Siri. Однако вместо обработки звуков он занимается расшифровкой активности моторной коры — зоны мозга, ответственной за артикуляцию. «Мы перехватываем сигналы на этапе подготовки мозга к движению речевых мышц, ещё до того, как человек попытается произнести звук», — пояснил Чхоль Джун Чо, один из авторов исследования и аспирант UC Berkeley.
Во время клинических испытаний у Энн были установлены электроды, регистрировавшие активность её мозга, пока она мысленно проговаривала фразы с экрана. Нейросеть, натренированная на записях её голоса до травмы, преобразовывала эти сигналы в аудиозвук. Система не только успешно воссоздавала 80% обучающих предложений, но и правильно синтезировала редко встречающиеся слова из фонетического алфавита NATO, такие как «Альфа» и «Браво». «Модель научилась распознавать базовые элементы речи, не ограничиваясь простым запоминанием шаблонов», — отметил Гопала Ануманчипалли, один из соавторов разработки.
Ключевым достижением стала минимизация задержки: предыдущие системы требовали до восьми секунд для генерации фразы, что делало разговор неестественным. Новая технология сократила этот интервал до одной секунды. «Первый звук появляется почти одновременно с посылаемым нейронным сигналом», — отметил Ануманчипалли. Пациентка Энн описала этот опыт как «возвращение к осознанию себя», подчеркнув, что немедленная обратная связь разительно отличается от предыдущих методов, где нужно было поэтапно превращать мысли в текст и голос.
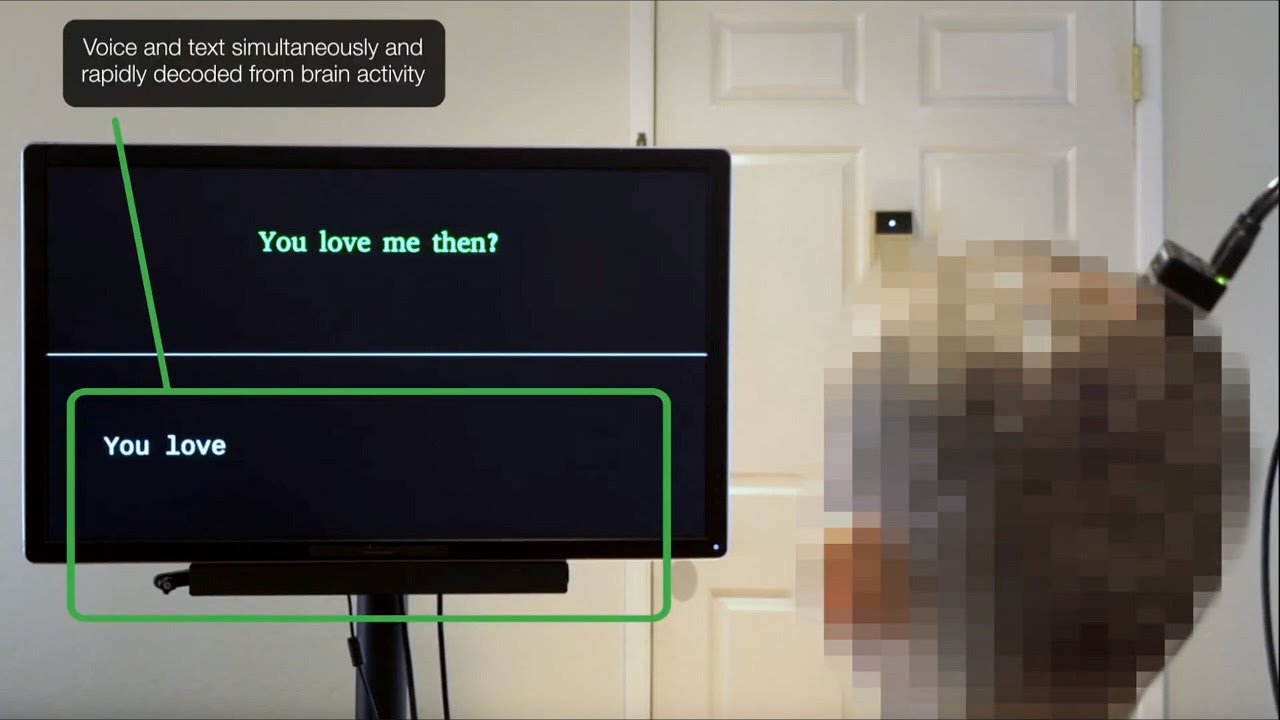
Эта система совместима с различными типами сенсоров: как с инвазивными микроэлектродными массивами (MEA), вводимыми в мозговую ткань, так и с неинвазивными поверхностными датчиками (sEMG), отслеживающими активность лицевых мышц. Это расширяет её применение для пациентов с различными формами паралича.
В настоящее время учёные работают над добавлением эмоциональной окраски к синтезированной речи — интонаций, громкости и тембра. «Даже малые изменения тона кардинально изменяют смысл. Например, слово “хорошо” может звучать как одобрение или как сарказм», — объяснил Кейло Литтлджон, аспирант UC Berkeley. Для решения этой задачи команда изучает нейронные паттерны, лежащие в основе паралингвистических особенностей.
Технология всё ещё на стадии эксперимента, однако исследователи уверены, что при поддержке фондов она найдет своё место в клинической практике в течение ближайшего десятилетия. Проект уже получил финансирование от Национального института глухоты и коммуникативных расстройств (NIDCD), японской программы Moonshot и частных организаций.
Источник: iXBT
Похожие статьи
 В iFixit разобрали 14-дюймовый MacBook Pro с сенсорным дисплеем PROLED XDR
 Anthropic официально объявила о выходе на Nasdaq с тикером ANT
 Совет директоров Nvidia готовится отправить Дженсена Хуанга в отставку после двух внебрачных связей
 1 млрд рублей на безопасность: «Яндекс Go» закрыл доступ к аренде самокатов для 751 тысячи пользователей
 Microsoft запатентовала обучение ИИ с использованием видеокарт пользователей
 В России приступили к компоновке элементов АЭС для Луны
 АЛРОСА начала внедрять платформу контейнеризации «Боцман»
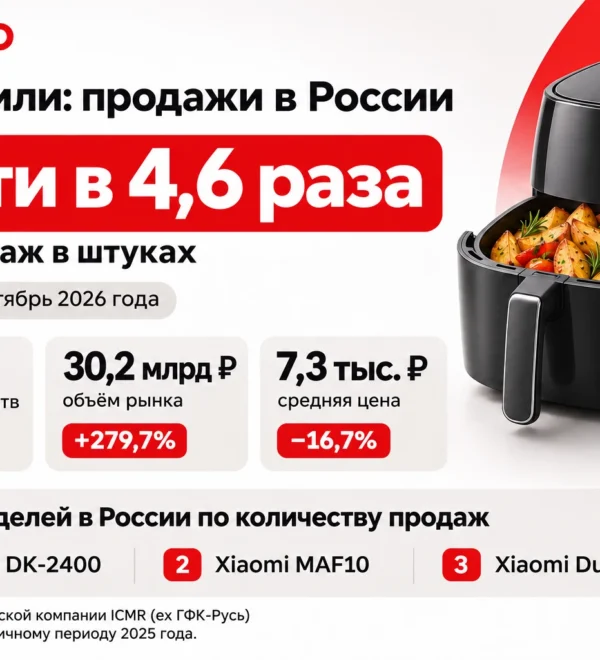 Продажи аэрогрилей в России выросли почти в 4,6 раза за девять месяцев