Кризис научного рецензирования: как искусственный интеллект усугубляет проблемы пир-ревью
Искусственный интеллект прочно закрепился в академической среде и научном программировании, помогая обрабатывать массивы информации и строить наглядные графики. Однако, как и в других отраслях, генеративные модели лишь усиливают как сильные, так и слабые стороны сложившихся процессов. Нейросети стремительно генерируют код и производят расчеты, приближая момент получения первых итогов. Но дальше вступает в силу громоздкий механизм верификации и публикации, который невозможно масштабировать с той же скоростью.
Картина вырисовывается тревожная: темпы генерации гипотез и расчетов значительно опережают нашу способность критически их оценивать. Одинокая логическая ошибка в скрипте способна запустить цепную реакцию — сформировать неверный график, исказить статистику, лечь в основу статьи, а затем обрасти десятками перекрестных ссылок в последующих работах. На каждом витке этот некорректный тезис будет обрастать всё более авторитетным академическим весом (достаточно вспомнить метрики цитируемости).
В конечном счете, если устоявшиеся механизмы валидации знаний останутся прежними, мы рискуем регулярно пропускать фатальные заблуждения и незаметно скатиться в псевдонауку. Вместо ускорения прогресса это приведет к его системному торможению.
В чем проблема
Тезисы «программа функционирует» и «программа решает поставленную задачу корректно» далеко не всегда тождественны.
В типовой коммерческой разработке эти понятия зачастую совпадают: скрипт запустился и выдал валидный ответ — значит, цель достигнута. Но стоит столкнуться с нетривиальными вызовами вроде экстремальных нагрузок, как работоспособность кода испаряется.
В научных же изысканиях запросто можно написать код, который отработает без единого сбоя, выдав идеальные кривые или прецизионные цифры. Вот только алгоритм может опираться на неверную методологию, игнорировать граничные условия модели или вовсе решать другую задачу. Интегрированные среды разработки распознавать подобные концептуальные промахи не умеют.
Разумеется, эта уязвимость существовала задолго до эпохи больших языковых моделей. Ученые подвержены когнитивным искажениям, ошибкам интерпретации, выбору неадекватных инструментов или даже осознанным фальсификациям. Задача осложняется тем, что эталонный результат изначально никому не известен.
В качестве защитного барьера научное сообщество выстроило институт рецензирования (peer review). Упрощенно говоря, рукопись проходит через несколько сит на пути к признанию. Сначала материал отсеивают редакторы профильных изданий, затем его препарируют независимые эксперты. Уже после релиза научное сообщество тестирует выводы, пытаясь воспроизвести эксперименты или выявить внутренние противоречия.
Эта система никогда не была безупречной. Рецензенты тоже люди и способны упускать из виду грубые просчеты. Хрестоматийным примером служит история с Пилтдаунским человеком.
В 1912 году палеонтолог Артур Смит Вудворд и энтузиаст Чарльз Доусон триумфально презентовали останки «недостающего звена» эволюции. Артефакт изучали на протяжении десятилетий, закрепив его в учебниках. Несмотря на скепсис некоторых исследователей, указывавших на несоответствие находки другим антропологическим открытиям, лишь в 1950-х годах экспертиза доказала масштабный подлог: череп человека был искусно совмещен с челюстью орангутана с подпиленными зубами и искусственно состаренными костями. Разоблачить мистификацию позволили лишь передовые методы датирования.
Более современный прецедент из мира физики связан с именем Яна Хендрика Шена. На рубеже тысячелетий он опубликовал серию прорывных статей по физике полупроводников, претендуя на Нобелевскую премию. Коллеги отмечали феноменальную продуктивность: в 2001 году его статьи выходили в среднем раз в восемь дней. Позже выяснилось, что автор систематически фальсифицировал экспериментальные ряды ради красивых графиков, дублируя иллюстрации из разных опытов. Статьи были отозваны, а репутация исследователя разрушена.
Подобных кейсов немало. Каждый кризис провоцирует новую волну дискуссий о жизнеспособности peer review. И хотя критика звучит обоснованно, лучшей альтернативы пока не изобрели, поскольку фундаментальный принцип остается неизменным: автор работы не должен единолично определять истинность своих результатов.
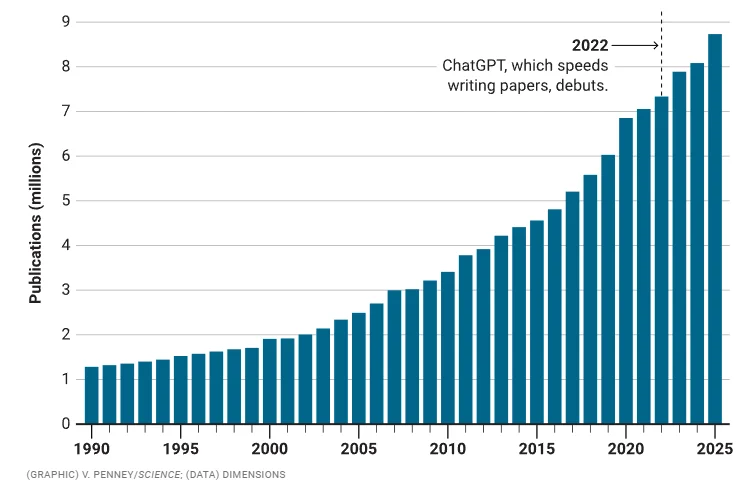
Генеративный ИИ полностью трансформирует ландшафт. Нейросети ускоряют написание кода и обработку массивов, мгновенно выводя исследователей на стадию публикации. Но если раньше профильные редакторы и рецензенты едва справлялись с потоком рукописей, то кто возьмет на себя контроль качества, когда объем публикаций вырастет на порядок?
А вал публикаций уже стал реальностью. В период с 2020 по 2025 год их мировой объем удвоился, причем резкий скачок зафиксирован сразу после публичного запуска ChatGPT. Дефицит экспертов привел к тому, что ожидание рецензии растянулось с нескольких месяцев до года, и это далеко не предел.
Иллюзия самоконтроля: надежда на авось
Команда ученых из Мичиганского университета, Университета Теннесси и Национальных лабораторий Сандия исследовала сценарии применения ИИ в академической среде. В 2025 году они опросили 527 профильных специалистов (преимущественно из американских вузов). Респонденты описывали конкретный недавний кейс использования нейросетей: характер задачи, задействованные инструменты и предпринятые меры верификации. Дополнительно фиксировалась самооценка уверенности авторов в собственных силах, возможностях ИИ и итоговом продукте.
Полученные данные классифицировали по двум критериям: тип делегированной задачи и методы валидации. Затем эти параметры соотнесли с бэкграундом программистов, научной дисциплиной и градусом уверенности.
Какие процессы доверяют алгоритмам
Выборка оказалась высококвалифицированной: медианный стаж научного программирования составил шесть лет, а 84% респондентов пишут код еженедельно (преимущественно на Python и R).
Список наиболее популярных задач выглядит следующим образом:
-
Обработка данных — 23,9% (очистка, конвертация форматов, слияние датасетов).
-
Визуализация — 19,8% (построение и кастомизация графиков).
-
Отладка — 17,4% (диагностика сбоев, рефакторинг кода).
-
Вычислительные науки — 11,7% (численные методы, дифференциальные уравнения, симуляции).
-
Статистический анализ — 10,9% (регрессионные модели, ML-пайплайны, тесты).
В сумме эти категории охватывают 76% всех описанных кейсов.
Как проверяют результаты
Самое любопытное кроется в методах контроля: полноценной проверкой кода почти никто не занимается. Самым массовым методом оказалось банальное выполнение скрипта — его упомянули 52,8% участников. Еще 22,5% ограничились визуальным осмотром итогов. Лишь 19,4% читали сгенерированный программный текст, а 16,2% проверяли корректность графиков. При этом независимый аудит коллегами или интеграционное тестирование практически отсутствуют. Автоматические тест-сьюты упомянули лишь 2,8% опрошенных, перекрестную проверку коллегой — около 2%, ручные математические выкладки — 1,2%, а бенчмаркинг с альтернативными языковыми моделями — всего 0,4%.
Конечно, паниковать рано: специфика задач бывает разной, и классические тесты уместны не везде. Часть респондентов сверяла результаты с известными аналитическими решениями, прогоняла код на уменьшенных выборках или дублировала старую логику. Это вполне здравые методики независимой валидации, но встречаются они удручающе редко. В подавляющем большинстве случаев проверка замыкается в изолированном контуре «человек — нейросеть».
Зависит ли качество проверки от опыта
Анализ выявил парадоксальную закономерность: чем выше квалификация разработчика, тем скептичнее он оценивает надежность ИИ, однако количество задействованных им методов верификации от этого не растет.
С другой стороны, новички демонстрируют избыточный уровень доверия к алгоритмам. Ирония в том, что чем слабее человек разбирается в программировании, тем сложнее ему заметить завуалированную логическую ошибку, допущенную ассистентом.
Следовательно, основная масса скрытых багов перекладывается на плечи внешних фильтров, включая редакционное сито. Рецензентам придется вручную валидировать сложные математические методы, обоснованность гипотез и чистоту экспериментов.
Распознать откровенный бред нетрудно, но как быть со статьями, где фейковые результаты замаскированы под безупречную аналитику — ведь правдоподобность является главным козырем современных языковых моделей?
Взгляд в будущее
При текущих темпах прироста публикаций мы неизбежно упремся в физические ограничения научного сообщества — сутки экспертов не резиновы. Это неизбежно приведет к увеличению доли ложных открытий, проходящих в печать.
Теоретически брак можно отсеивать через репликацию экспериментов, но и эти ресурсы исчерпычны. Объем опубликованных, но не опровергнутых заблуждений продолжит стремительно расти.
Сегодня активно обсуждается автоматизация рецензирования с помощью специализированных ИИ-агентов. Однако подходить к этой задаче нужно с максимальной осмотрительностью, избегая ошибок предыдущих исследований. Обучать «нейросеть-рецензента» следует исключительно на верифицированных массивах данных. Ему необходимы инструменты независимого контроля: эталонные датасеты, воспроизводимые симуляции, проверяемые математические инварианты и прямой доступ к исходным кодам. В противном случае мы получим высокопроизводительного эксперта, который с железобетонной уверенностью подтвердит корректность кода, написанного другой нейросетью, окончательно уводя науку по ложному пути.
Похожие статьи
 Как учились программировать гики из соцлагеря?
 Борьба за качество в Factorio с помощью матриц
 Физика пламени и векторы познания
 Искусственный интеллект научился создавать ДНК
 Блокнот: программа, которую Microsoft не решалась менять сорок лет
 Время на исходе: что означает загадочная фраза о фотонах?
 Интервью с Роджером Пенроузом: о Вселенной, сознании и пространстве-времени
 Первая часть 16-й проблемы Гильберта: перебор схем 8-й степени с ограничениями