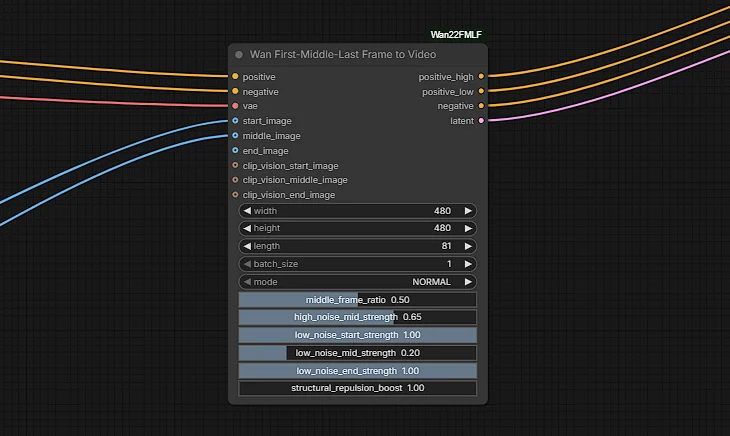
Как запускать бесконечную генерацию видео на RX 6700 XT с 12 ГБ VRAM через WAN 2.2 I2V-A14B
Вместо предисловия
Относительно недавно я открыл для себя ComfyUI. После непродолжительных манипуляций с настройкой и инсталляцией кастомных ROCm-драйверов под свою видеокарту (официальная поддержка в данном случае стартует лишь с AMD RX7600) я столкнулся с трудностями при создании видео.
Если быть точным, единственным приемлемым вариантом для полноценных вычислений на GPU оказалась модель wan2.2_ti2v_5B. Тем не менее, функционировала она крайне нестабильно: игнорировала текстовые промпты и генерировала визуальные артефакты.
Квантование и подбор подходящей архитектуры
Погрузившись в тему глубже, я узнал о квантовании — методе, позволяющем существенно уменьшить объем модели. Это, безусловно, влечет за собой определенное снижение ее возможностей, однако, как неоднократно отмечалось в сообществе, деградация не носит линейный характер.
Этим подходом я и воспользовался. Мой выбор пал на GGUF-вариацию Wan2.2-I2V‑A14B с квантованием Q4_K_M. Она устроила меня по габаритам и, судя по отзывам на профильных форумах, демонстрирует на порядок более качественные результаты по сравнению с wan2.2_ti2v_5B. Подобный скачок в производительности отчасти объясняется не только усложненной архитектурой, но и двухэтапным процессом генерации (high и low noise): первый формирует базовую композицию, а второй прорабатывает мелкие детали.
Дополнительно я задействовал LoRA-ускоритель lightx2v_4steps, что позволило достигать приемлемого качества всего за 4 шага и радикально сократить время рендеринга. Впрочем, это решение еще сыграет свою роль, о чем я расскажу чуть позже.
Аппаратная оптимизация
Следующим шагом стал апгрейд аппаратной части: я установил новый твердотельный накопитель (SSD), куда перенес все веса моделей и файл подкачки. К слову, последний обеспечил совершенно неожиданный прирост к производительности. Объем моей оперативной памяти составляет 32 ГБ, и ее всегда хватало с запасом, однако стоило перенести файл подкачки на SSD, как максимальное количество кадров для генерации в разрешении 480×480 возросло с 39 до 53.
Тем не менее, достигнутый лимит меня по-прежнему не устраивал, а при переходе на разрешение 720×720 доступная длина последовательности резко сокращалась. Стоит отметить, что даже при задействовании всего потенциала архитектуры сформировать более 81 кадра за единичный проход не представляется возможным.
Поиск обходных путей: почему банальная склейка не работает
Осознав ограничения, я задумался о последовательной генерации видеоряда.
Первоначальная идея заключалась в том, чтобы скармливать финальный кадр предыдущего фрагмента в качестве отправной точки для следующего. Однако эта концепция провалилась: из-за отсутствия исторического контекста о предыдущих кадрах движение получалось рваным и абсолютно несогласованным.
Попытки найти готовые программные решения тоже не увенчались успехом: все они сводились к единому тяжеловесному узлу (ноде), куда одновременно подгружались все модели, неминуемо приводя к исчерпанию видеопамяти. Подобные схемы оказались тупиковыми. Мне требовался гораздо более гибкий инструмент для тонкой настройки.
Узел Wan First‑Middle‑Last Frame to Video
В конечном счете, после долгих поисков, я обнаружил ноду Wan First‑Middle‑Last Frame to Video, входящую в пакет Wan22FMLF. Ее функционал заточен под подготовку данных для генерации роликов на основе трех ключевых кадров с возможностью гибко регулировать позицию промежуточного кадра.
Тогда-то у меня и созрела концепция создания нового видеосигнала по двум опорным кадрам, извлеченным из предыдущего сегмента: первый берется где-то посредине предыдущего отрезка, а средний — в его конце. После завершения рендеринга останется лишь отсечь дублирующиеся кадры для устранения дерганости и совместить заключительный кадр предыдущего блока с ключевой точкой из середины нового видеоряда, которые должны идеально совпадать.
Ключевое условие: индекс промежуточного кадра обязан быть кратен четырем, поскольку именно таковой является базовая длина генерируемого моделью сегмента. Речь идет именно об индексе (начинающемся с нуля), а не об обыкновенном порядковом номере.
Схема работы механизма

В результате подобных манипуляций на выходе формируется единое продолжительное видео с отличной преемственностью кадров. Наилучшего визуального качества мне удалось добиться при величине нахлеста (оверлея) в 12 кадров, хотя для сцен с интенсивным движением лучше снизить это значение до 8.
Предложенная схема масштабируется практически до бесконечности, причем время расчетов при увеличении числа сегментов возрастает строго линейно.
Побочные эффекты, с которыми пришлось смириться
Локальный пересвет промежуточного кадра
Первым и наиболее заметным недостатком оказалось высветление центрального опорного кадра, этот эффект неизбежно затрагивал и соседние изображения. Частично нивелировать проблему помогла тонкая настройка параметров шума для среднего кадра и расширение зоны перекрытия. Тем не менее, победить дефект до конца не вышло: в ряде сцен пересвет все же бросается в глаза.
Впрочем, в условиях постпродакшна не составляет труда вручную скорректировать экспозицию — ничего фатального здесь я не вижу. Позже выяснилось, что виновником этого артефакта выступает упомянутый ускоритель lightx2v_4steps, однако отказываться от него я не стал, поскольку без него время рендеринга увеличилось бы пятикратно.
Незначительная потеря детализации
Второй нюанс заключается в постепенном размытии мелких деталей при переходе от одного фрагмента к другому. В частности, если объекты, присутствовавшие в самом начале, исчезли на первом и среднем опорных кадрах, вернуть их в дальнейшем уже не удастся.
Сводная таблица производительности
|
Разрешение |
Кол-во кадров |
Число генераций |
Затраченное время |
Оверлей |
|---|---|---|---|---|
|
480×480 |
52 |
1 |
6 мин |
— |
|
480×480 |
132 |
3 |
18 мин |
12 кадров |
|
480×832 |
132 |
3 |
30 мин |
12 кадров |
Демонстрация готового видео
Yandexdisk.yandex.ru
Заключение
На этом пора закругляться. Надеюсь, данный материал оказался для вас познавательным и практичным. Ниже я оставляю файл воркфлоу с полностью рабочей реализацией описанного метода.
Yandexdisk.yandex.ru
Похожие статьи
 РусГидро завершила пилотное внедрение платформы «Боцман» для управления контейнерами
 Яндекс объединил Мессенджер и Телемост: история чатов переносится автоматически
 Подмена торрент-файлов на iTorrents: в RuBackup назвали меры против повторной атаки
 Официально рассекречены Vivo X500 Pro и X500 Pro Max: топовые камеры Zeiss и Sony, продвинутая стабилизация и сменные объективы
 Релиз видеокарт GeForce RTX 60 перенесен на 2028 год
 Инсайдер подтвердил перенос выхода видеокарт GeForce RTX 60 с 2027 года
 Google и Blackstone создали Crux AI: оператор дата-центров для TPU стоимостью в миллиарды долларов
 Проект модернизации последнего в США ускорителя с уникальными компонентами в Лос-Аламосе одобрен до 2050 года