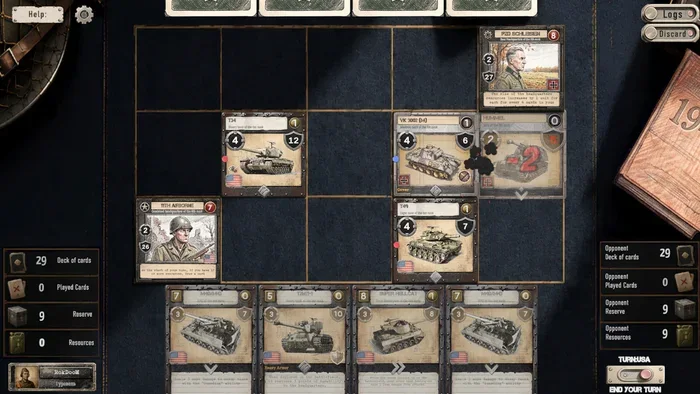
Как я пытался заменить бота в Tank General на самообучающийся ИИ (статья и видео)
(вот о чём я говорю)
Сегодня отовсюду слышно о нейросетях и возможностях, которые они открывают. Многие уже вовсю применяют их в работе, а я по-прежнему действую по старинке и вручную разбираюсь с каждым элементом. Порой чувствую себя динозавром, безнадёжно отставшим от современных тенденций.
Но неожиданно для самого себя я всё же решил немного приблизиться к прогрессу. Только не подумайте лишнего: никакого нейрослопа! ИИ-агента я по-прежнему не пускаю в свой проект и не собираюсь этого делать. А вот использовать нейросети, чтобы сделать игру интереснее — именно интереснее, — я готов обеими руками.
Так я занялся внедрением самообучающегося агента, который должен заменить существующего не слишком сообразительного бота. О том, как проходила эта работа и к чему она привела, я и расскажу в статье.
Видеоверсия статьи доступна на YouTube, RuTube и VK Video.
1. Вступление
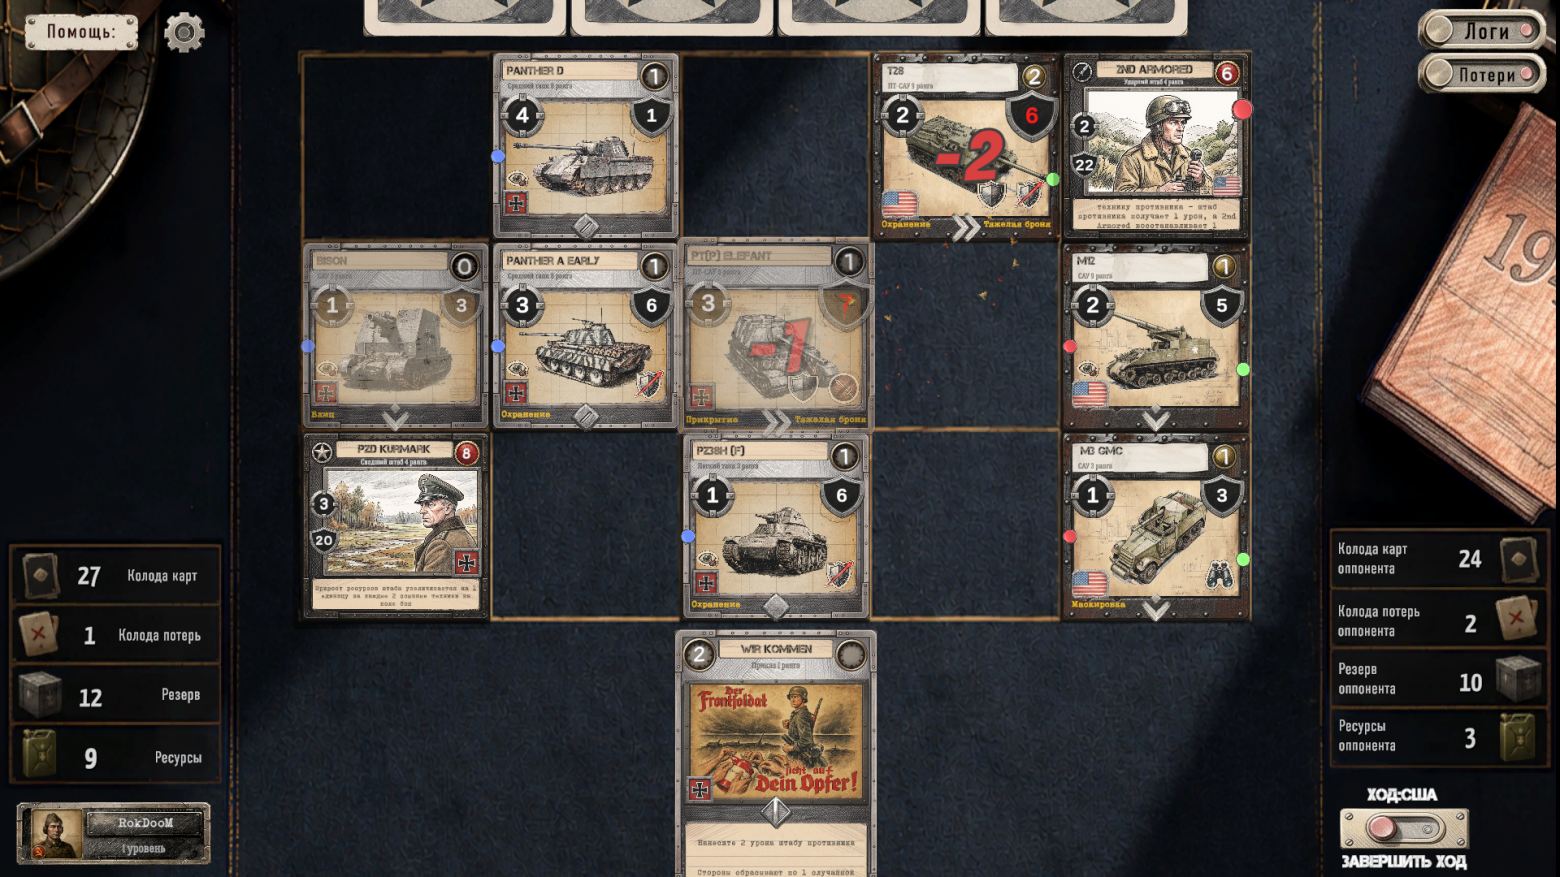
Я разрабатываю Tank General — тактическую коллекционную карточную игру про танки времён Второй мировой войны. В ней есть PvP и несколько PvE-режимов, где игрокам противостоит существующий бот. Работа над проектом продолжается уже больше двух лет, и сейчас я постепенно готовлю игру к релизу.
Для начала стоит задать важный вопрос: а нужна ли вообще такая замена? PvE-режимы работают, бот сражается, перемещается, применяет заклинания и разумно расходует ресурсы. Чего ещё желать? Тем более что создание самообучающейся модели потребует немало времени и сил.
И всё же она нужна. Очень нужна. Прежде всего потому, что PvP-сражения в моей игре гораздо увлекательнее, продолжительнее и напряжённее боёв против бота. Проще говоря, играть с человеком заметно интереснее.
При этом не всем нравится PvP. Насколько я понимаю современные игровые тенденции, всё больше людей предпочитают PvE-режимы. Я и сам отношусь к их числу.
Мне хочется, чтобы в Tank General играли все, кому близки её жанр и сеттинг, а не только любители схваток с другими игроками. И дело не только в потенциальном доходе от расширения аудитории. Я люблю свою игру и хочу, чтобы как можно больше людей разделили это чувство.
Когда больше двух лет назад я создавал бота, то совершенно не представлял, как подступиться к задаче. Поэтому просто описал его поведение так, как считал нужным: задал алгоритмы для конкретных ситуаций, последовательность действий, выбор целей, направление движения и так далее. Позже я добавил систему наград: каждый результат действия оценивается в определённое количество очков, а бот должен выбирать вариант, который принесёт ему больше всего очков. По крайней мере, в теории.
Насколько «умным» он получился? Несмотря на несколько улучшений, не слишком. Что неудивительно с учётом ограничений выбранного подхода. Чтобы сделать PvE-бои достаточно сложными, мне до сих пор приходится усиливать карты бота, из-за чего сражения получаются не совсем честными.
В игре сотни карт с разными способностями, а бои проходят на поле с сеткой. Поэтому в каждом сражении возникают сотни возможных действий, которые сильно различаются от боя к бою. Число их сочетаний получается огромным.
В итоге передо мной встал выбор: продолжать улучшать бота, вручную описывая удачные действия для каждой ситуации, или попробовать другой подход.
Первый вариант означал бы бесконечное расширение скриптов, отвечающих за поведение бота. Пришлось бы учитывать основные игровые ситуации, которых насчитываются тысячи, и вдобавок следить, чтобы алгоритмы не противоречили друг другу.
Можно ли было пойти этим путём? Вполне. Задача непростая и трудоёмкая, но осуществимая.
Однако я уверен, что даже тогда сражения с ботом не сравнились бы по ощущениям с PvP. Ограниченный набор алгоритмов, шаблонное поведение и общая предсказуемость не позволили бы получить то же удовольствие, что и от противостояния живому человеку.
Недавно мне пришла в голову идея: почему бы не внедрить самообучающуюся модель? Пусть она проведёт тысячи боёв сама с собой и научится играть достаточно хорошо, чтобы противостоять ей было действительно интересно. Что мне мешает попробовать?
Таковы были мои грандиозные планы. Но на деле всё оказалось сложнее…
2. Стартовые условия
Как я уже говорил, над проектом я предпочитаю работать по старинке: вручную настраиваю каждый элемент в Unity. Исключение составляет код игры. Профильного образования у меня нет, поэтому самостоятельно я пишу его плохо и медленно.
Наблюдая за современными вайб-кодерами и ИИ-слопперами, я давно ощущаю себя отставшим от жизни дедом, который ничего не понимает в новых технологиях. Да и догонять продвинутую молодёжь мне особенно не хочется: я получаю удовольствие от того, что создаю игру своими руками, и не стремлюсь менять этот процесс на более быстрый, но бездушный.
А вот ускорение работы с кодом, которое обеспечивают современные агенты, мне понравилось. Когда я впервые увидел, насколько быстрее благодаря им движется разработка, был в полном восторге. И до сих пор этому радуюсь.
Что именно я использую? Поскольку мне не нужен сложный агент с огромным расходом токенов, я работаю с бесплатной моделью Big Pickle — понятия не имею, что за ней скрывается, но результат меня устраивает, — либо с Deep Seek V4.1 через открытый ИИ-агент OpenCode. Выглядит всё это как привет из девяностых. У OpenCode есть и более современный интерфейс, но мне, как настоящему деду, лень в нём разбираться: мои задачи по работе с кодом прекрасно решает и эта древность.
Для каждой задачи я открываю новую сессию. Думаю, OpenCode несложно настроить так, чтобы он помнил предыдущие, но мне это не нужно: устройство проекта у меня в голове, и я понимаю, в каком направлении вести агента. Ежедневного бесплатного лимита Big Pickle для работы с кодом обычно хватает. В крайнем случае у меня есть второй ПК, на котором можно продолжить работу. А на совсем крайний случай установлен локальный Qwen 3.8 27B: он работает через тот же OpenCode очень медленно, но тоже неплохо справляется.
Сразу признаюсь: создание самообучающейся модели лежит далеко за пределами моих знаний, и самостоятельно я бы с этим не справился. Чтобы представить масштаб задачи, взгляните на текущую формулу наград для модели:
R_total = R_terminal + R_intermediate
R_terminal = +100 (победа) / −100 (поражение)
R_intermediate = clip( R_combat + R_damage + R_tactical + R_board , −80 , +80 ).
Где: R_combat | clip( λ_c · (Σ_enemy V(u) − β_c · Σ_own V(u)), −C_c, +C_c ) | λ_c = 10, β_c = 1.2, C_c = 70 | ±70 |
| R_damage | clip( λ_d · (Σ_enemy f_d·V(u) − β_d · Σ_own f_d·V(u)), −C_d, +C_d ) | λ_d = 8, β_d = 1.2, C_d = 15 | ±15 |
| R_tactical | сумма бонусов/штрафов (см. §5) | — | ±10 |
| R_board | clip( b_board · Δcells, −C_b, +C_b ) | b_board = 5, C_b = 10 | ±10 |
Замечательно, правда? Сразу всё ясно, стоит только взглянуть на формулу.
С такими вводными я и начинал. К сожалению, даже более двух лет работы над проектом не дали мне понимания, как реализовать самообучающуюся модель. Поэтому пришлось активнее подключить к задаче ИИ-агента и нейросеть.
3. Создание самообучающейся модели
Сначала я поручил агенту подробно изучить, как в проекте реализованы бои с ботом. По результатам анализа он составил план внедрения самообучающейся модели из 20 последовательных этапов. Я передал этот план Chat GPT, с его помощью доработал и утвердил, после чего приступил к реализации.
Рабочий процесс выглядел так: я отправлял Chat GPT общий план, отчёты о выполненных этапах и сведения о текущем состоянии проекта, а затем просил подготовить промпт для агента по очередному этапу. Агент выполнял задачу и отчитывался о результате. После этого цикл повторялся. По такой схеме прошли все этапы.
Не скажу, что всё шло гладко, но работа постепенно продвигалась, а обнаруженные ошибки устранялись.
Первым делом вся боевая механика — атаки, перемещения, обработка урона, розыгрыш карт и прочее — была скопирована и вынесена в отдельные скрипты. По сути, внутри игры появилась ещё одна, упрощённая игра без визуального отображения.
Затем был создан скрипт для запуска симуляций боя с использованием скопированных механик. Он позволяет проводить полноценные сражения на уровне кода, без визуализации. Благодаря этому каждый симуляционный бой занимает всего несколько секунд.
Лишь после этого в проект добавили обучаемую модель. На данном этапе она уже корректно взаимодействовала с игровой логикой, соблюдала правила и выбирала допустимые действия для атаки и перемещения. Но полноценного обучения ещё не было: модель знала конечную цель — победу, — однако не умела эффективно выстраивать стратегию её достижения.
Следующим важным шагом стало внедрение самого механизма обучения. Симуляция боёв уже работала, теперь нужно было добиться того, чтобы модель не просто проводила сражения, а действительно извлекала из них опыт.
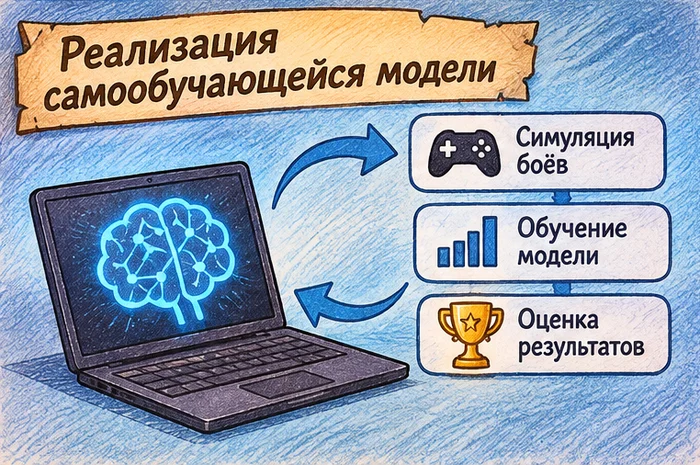
Когда эта задача была завершена и я получил подтверждение, что модель действительно обучается по результатам симуляций, моей радости не было предела. Я решил, что самое сложное уже позади.
Как же я ошибался. Всё только начиналось…
4. Главная загвоздка
Прежде отмечу важную деталь. Самообучающиеся модели в моём проекте — это не большие языковые модели вроде Qwen, Chat GPT или Claude, встроенные в игру локально. У этих гигантов совершенно другие возможности, которые для моей задачи избыточны. Они универсальны, но их функциональность в игре мне попросту не нужна.
В проекте я использую классическое машинное обучение — Machine Learning. Если коротко, в отличие от универсальных нейросетей мои модели предназначены для одной конкретной задачи. Для них не существует мира за пределами игры. В основе лежат математические формулы и алгоритмы, получающие доступ к игровым функциям. В ходе обучения программа выявляет закономерности и формирует собственную базу — готовую модель.
При этом в рамках моей игры такие модели должны показывать лучший результат, чем универсальные, если только последних тоже специально не обучить её правилам. Базовые принципы обучения классического ML и современных больших ИИ во многом похожи, хотя архитектура и объём обучающих данных различаются.
Для обучения были созданы две базовые модели — А и В, которые развиваются параллельно и независимо. Сам процесс устроен следующим образом:
— базовые модели А и В замораживаются и используются как фиксированные соперники;
— кандидат А, то есть копия модели А с настройками самообучения, проводит множество боёв против фиксированных моделей А и В;
— кандидат В, копия модели В с настройками самообучения, также многократно сражается с фиксированными моделями А и В;
— затем два обученных кандидата, А и В, проводят бои друг с другом;
— если зафиксирован прогресс, обученные кандидаты заменяют замороженные модели А и В, после чего цикл повторяется.
Проблема обнаружилась во время первого серьёзного прогона из нескольких тысяч симуляционных боёв. Модели действительно обучались, но, похоже, проигрывать: доля побед обученных кандидатов против базовых моделей упала с 50% в начале обучения до 30% в конце.
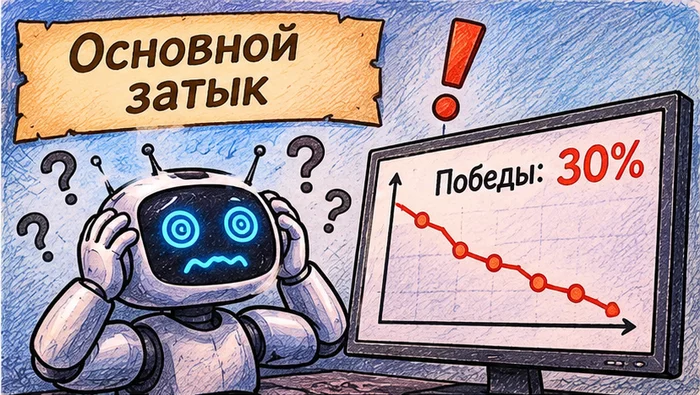
Эксперимент наглядно показал, что результаты боёв влияют на обучение. Только модели осваивали совсем не то, чего я ожидал.
Я начал разбираться и обнаружил неверный знак в конце формулы, который менял цель обучения на противоположную. Модель в буквальном смысле училась не побеждать, а проигрывать. Я исправил ошибку, и процент побед кандидатов против базовых моделей вернулся к 50%.
На этом прогресс остановился. Тысячи новых боёв и многочисленные изменения первоначальной формулы ничего не давали. Анализ показывал, что обучение идёт — контрольные веса моделей менялись, — но видимого результата не было: доля побед оставалась около 50%.
На создание симуляции боёв и подготовку моделей к обучению у меня ушло примерно десять дней. Столько же я потратил на попытки добиться реального результата, выраженного в победах, но безуспешно. Что бы я ни делал, а упорства мне не занимать, прогоны из тысяч боёв не показывали прогресса: процент побед оставался прежним.
Думаю, те, кто уже работал с самообучающимися моделями, поняли, где я ошибся. А я тогда даже не догадывался…
И тут кожаные мешки в очередной раз доказали, что нас ещё рано списывать со счетов. Порох в пороховницах остался, и в наступающем новом мире мы тоже можем пригодиться!
5. Выход из тупика
В этом тупике я оказался из-за собственной ошибки. Но и хвалёные нейросети не смогли подсказать, в чём дело. Я обращался к разным моделям, в том числе к Claude, надеясь, что они найдут причину отсутствия прогресса, — безрезультатно.
Эти «умнейшие» нейросети, знающие о разработке игр и обучаемых моделях на порядки больше меня, так и не указали на ключевую проблему.
А ошибка была простой: я сделал процент побед единственным критерием успешности обучения.
Изначально это казалось мне правильным. Чем ещё оценивать результат, если не самым наглядным показателем — ростом доли побед обученных моделей над базовыми?
Но такой подход оказался в корне неверным. Почему?
Подсказка пришла оттуда, откуда я её не ждал. Я пожаловался на проблему другу, который не связан с геймдевом, но любит смотреть видео о современных научных достижениях, в том числе о нейросетях. В конце разговора он вспомнил ролик об инди-разработчике, который внедрял самообучающуюся модель в гоночную игру. Тот тоже сначала выбрал критерием успеха победу в заезде и столкнулся с похожей проблемой.
Дело сдвинулось с места, когда разработчик разделил обучение на этапы. Модель стала получать вознаграждение не только за завершение заезда, но и за успешное прохождение отдельных поворотов и препятствий. При первоначальном подходе, когда награда выдавалась лишь за весь заезд, машины даже не добирались до финиша.
И тут у меня в голове щёлкнуло: вот она, моя главная ошибка!
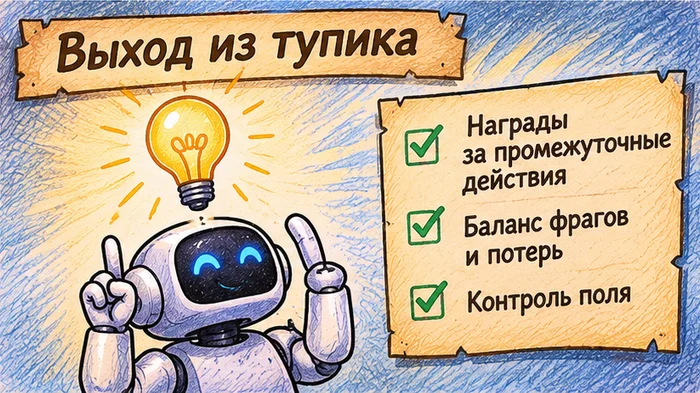
Модель получала основное и единственное вознаграждение за конечный результат — победу или поражение. Победа достигается уничтожением штаба противника, но между началом боя и этим моментом происходит множество промежуточных действий: размещение карт с руки, выбор направления движения и целей атаки, розыгрыш заклинаний, применение способностей, накопление ресурсов и так далее. В моей первоначальной реализации ни одно из этих действий отдельно не оценивалось.
Почему же я решил, что модель станет заниматься всем этим, если перед ней стоит одна итоговая цель — уничтожить штаб? Она выбрала простейший способ: атаковала вражеский штаб напрямую, игнорируя тактику и остальные механики. Её собственный штаб постоянно бил по штабу противника, а все выставленные карты ехали туда же и пытались атаковать.
Обучение проходило на тренировочных штабах с одинаковыми показателями урона и прочности для всех наций. Поэтому побеждал тот, кто ходил первым и первым наносил урон вражескому штабу. А поскольку в симуляции право первого хода чередовалось, модели выигрывали по очереди.
Это и объясняло отсутствие прогресса: независимо от настроек обучения итоговый процент побед держался на уровне 50%.
Сам не понимаю, почему я ожидал, что модель окажется достаточно разумной и самостоятельно найдёт более сложную стратегию, чем прямое уничтожение штаба. Я ведь понимал, что ИИ — не полноценный мозг. Но всё равно потратил уйму времени на бесполезную работу.
Зато кожаный мешок, даже не будучи специалистом в этой области, сразу подсказал возможную причину, просто вспомнив однажды увиденное видео!
6. Что дальше?
В моей игре уничтожить вражеский штаб и победить можно разными способами. Например, собрать колоду, специально предназначенную для атаки штаба. Но самый распространённый способ, который предпочитаю и я, — контроль поля боя за счёт эффективного уничтожения танковых карт противника.
По новой задумке модель должна научиться побеждать именно через контроль поля. Поэтому я изменил формулу наград, добавив поощрение за уничтоженную технику противника и штраф за потерю собственных карт. Формула приобрела следующий вид: R = episode_reward + 0.6 clip(kills - 1.2 losses, -3, +3). Так модель получала награду за положительный баланс уничтоженных и потерянных карт.
При этом я не хотел, чтобы модель забывала о главной цели — победе. Поэтому награда за уничтожение карт была существенной, но уступала награде за уничтожение вражеского штаба. Иначе модель могла бы бесконечно уничтожать выставляемые противником карты ради очков, не стремясь закончить бой.
Это сработало. В ходе обучения модели стали стабильно показывать лучшее соотношение уничтоженных и потерянных карт, чем базовые версии. Наконец я смог заменять базовые модели обученными и таким образом продвигаться вперёд.
Однако мне было ясно, что этих изменений недостаточно. Положительный баланс уничтоженных и потерянных карт в качестве основного критерия ещё не гарантировал, что итоговое поведение моделей меня устроит.
После очередного мозгового штурма я снова скорректировал формулу наград. Теперь она выглядит так, как я показал выше, и учитывает различные игровые ситуации:
— безответное уничтожение цели, когда атакующий юнит не потерял HP;
— уничтожение цели САУ с дистанции;
— уничтожение цели штабом с дистанции;
— уничтожение цели ПТ-САУ первым ударом — награда за использование механики, при которой ПТ-САУ не получает ответный урон, если уничтожает цель атакой;
— уничтожение тяжёлого танка во время кулдауна — ещё одна награда за использование игровой механики;
— неудачная атака, в результате которой погиб собственный юнит, а ни один противник не был уничтожен или повреждён;
— урон по вражескому штабу — постоянный небольшой бонус;
— контроль плацдарма противника, который затрудняет ему розыгрыш карт с руки.
Результаты прогонов с новой системой наград выглядят обнадёживающе. Дополнительные показатели стабильно растут, а обучаемые модели превосходят по ним базовые.
Разумеется, делать окончательные выводы об успехе всей работы и появлении по-настоящему «умных» моделей пока рано. Но уверенности в положительном результате стало значительно больше.
Казалось бы, с основными проблемами обучения я разобрался и теперь можно двигаться дальше. Но что мешает мне снова наступить на те же грабли? Правильно: ничего!
7. Загвоздка № 2
Как же обойтись без ещё одной проблемы? И как думаете, чем она была вызвана? Верно: я опять слишком поздно включил голову. Снова доверился нейросети и снова зря. Не повторяйте моих ошибок — думайте о том, что делаете! Надеюсь, этот случай станет ещё одним наглядным уроком.
Как я уже рассказывал, сначала я выбрал неверный критерий успешности обучения: рост процента побед обученных моделей над базовыми. После изменения системы наград обучение стало более направленным, и прогресс проявился в отдельных показателях.
Но в качестве окончательного подтверждения эффективности я по-прежнему смотрел на процент побед. А он в боях обученных моделей против базовых всё так же колебался в пределах статистической погрешности.
После каждого цикла нейросеть указывала на итоговый отчёт и убеждала меня, что эффективность обучения не доказана, поскольку доля побед почти не меняется. Мы потратили немало времени на обсуждение того, какие настройки можно изменить, чтобы этот показатель вырос.
Коллективно «обсуждали»! Настоящие «коллеги»! С нейросети-то какой спрос, у неё мозгов нет. Но как я сам мог этого не заметить?
Ошибка в анализе заключалась в том, что эффективность обученных моделей каждый раз проверялась в боях против базовых. А базовые модели я обновлял каждый день после очередного успешного обучения!
Получалось, что новую версию сравнивали не с её первоначальным уровнем, а почти с такой же моделью, отстающей всего на один цикл.
Разумеется, разница между моделями, которые отличались лишь одним циклом обучения, была ничтожной. Достаточно было немного подумать: откуда взяться заметному разрыву, если после каждого успешного прогона я заменял базовые модели обученными?
Осознав этот несложный факт, я сразу создал отдельные контрольные модели. Они не будут обновляться и послужат подопытными мышами. Я встроил их в систему обучения, чтобы проверять на них эффективность новых версий моделей.
8. Заключение
Сейчас обучение моделей идёт полным ходом, а дело это небыстрое. Параллельно я встраиваю механизм обучения непосредственно в проект, чтобы запускать его из движка. Время от времени корректирую систему наград: хочу, чтобы модель училась грамотно использовать игровые механики, а не просто совершала действия во время боя. Очень надеюсь, что всё это приближает меня к главной цели — создать достаточно «умного» противника, способного дать настоящий бой человеку.
Наверняка у многих возникнет вопрос: зачем вообще писать статью, если обучение модели ещё не завершено?
В предыдущих статьях я уже говорил, что разработка каждой игры слишком индивидуальна, чтобы безоговорочно переносить реализацию механик из одного проекта в другой, даже в пределах одного жанра. Поэтому подробная инструкция по внедрению самообучающегося агента вряд ли окажется полезной именно для вашей игры.
Зато ошибки, которые я совершил, достаточно универсальны и наглядны. С ними может столкнуться каждый, кто слишком полагается на «мозги» нейросетей в работе.
Буду рад, если статья поможет тем, кто уже создаёт обучаемую модель для своей игры или только раздумывает над этим. А возможно, кто-то после её прочтения захочет попробовать такой подход в собственном проекте.
Пусть это не пошаговая инструкция, но я хотел донести главную мысль:
— даже при использовании нейросетей — и особенно при их использовании — думайте о том, что делаете!
Надеюсь, моя история поможет вам не тратить время на бесполезную работу, как это случилось со мной. Помните: главный рабочий инструмент — ваш собственный мозг, и результат во многом зависит от того, насколько активно вы им пользуетесь.
Спасибо всем, кто дочитал до конца.
Буду благодарен за конструктивные советы и указания на ошибки, которые я допустил в работе.
Всем удачи!
P.S. Демо моей игры доступно в Steam, а обсудить её можно в чате Telegram.
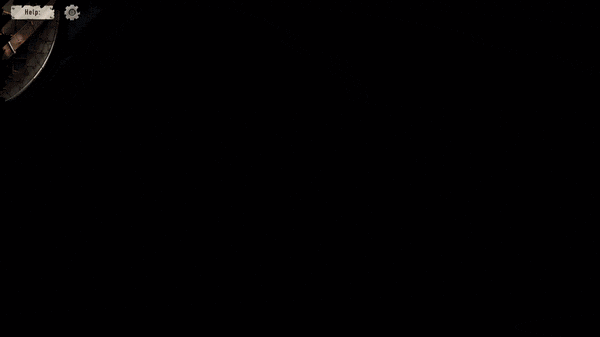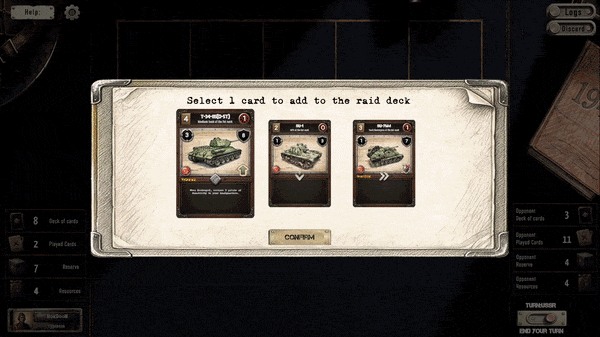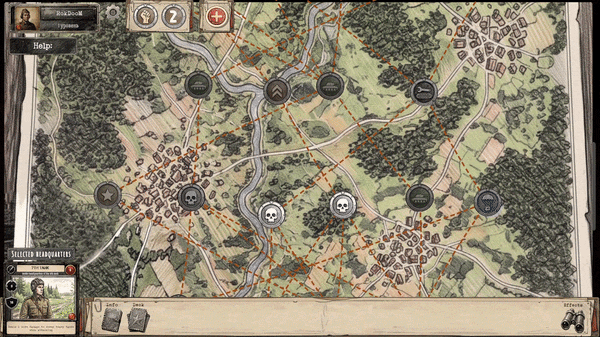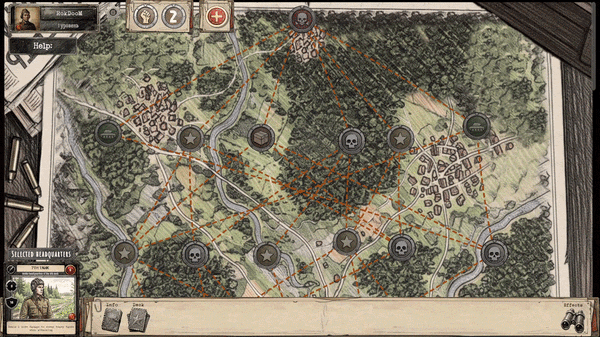
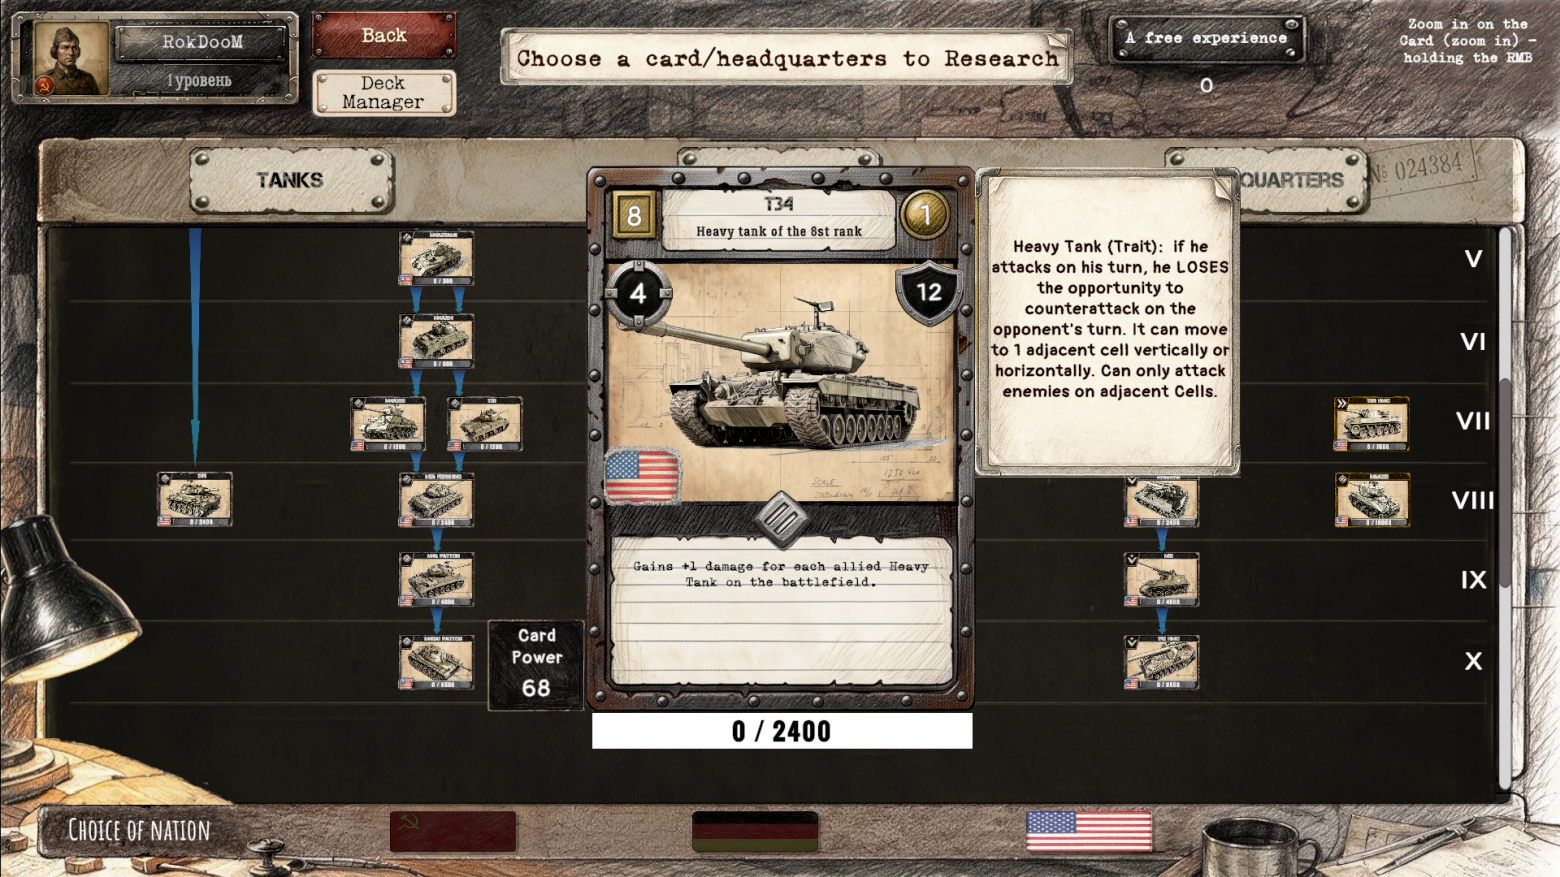
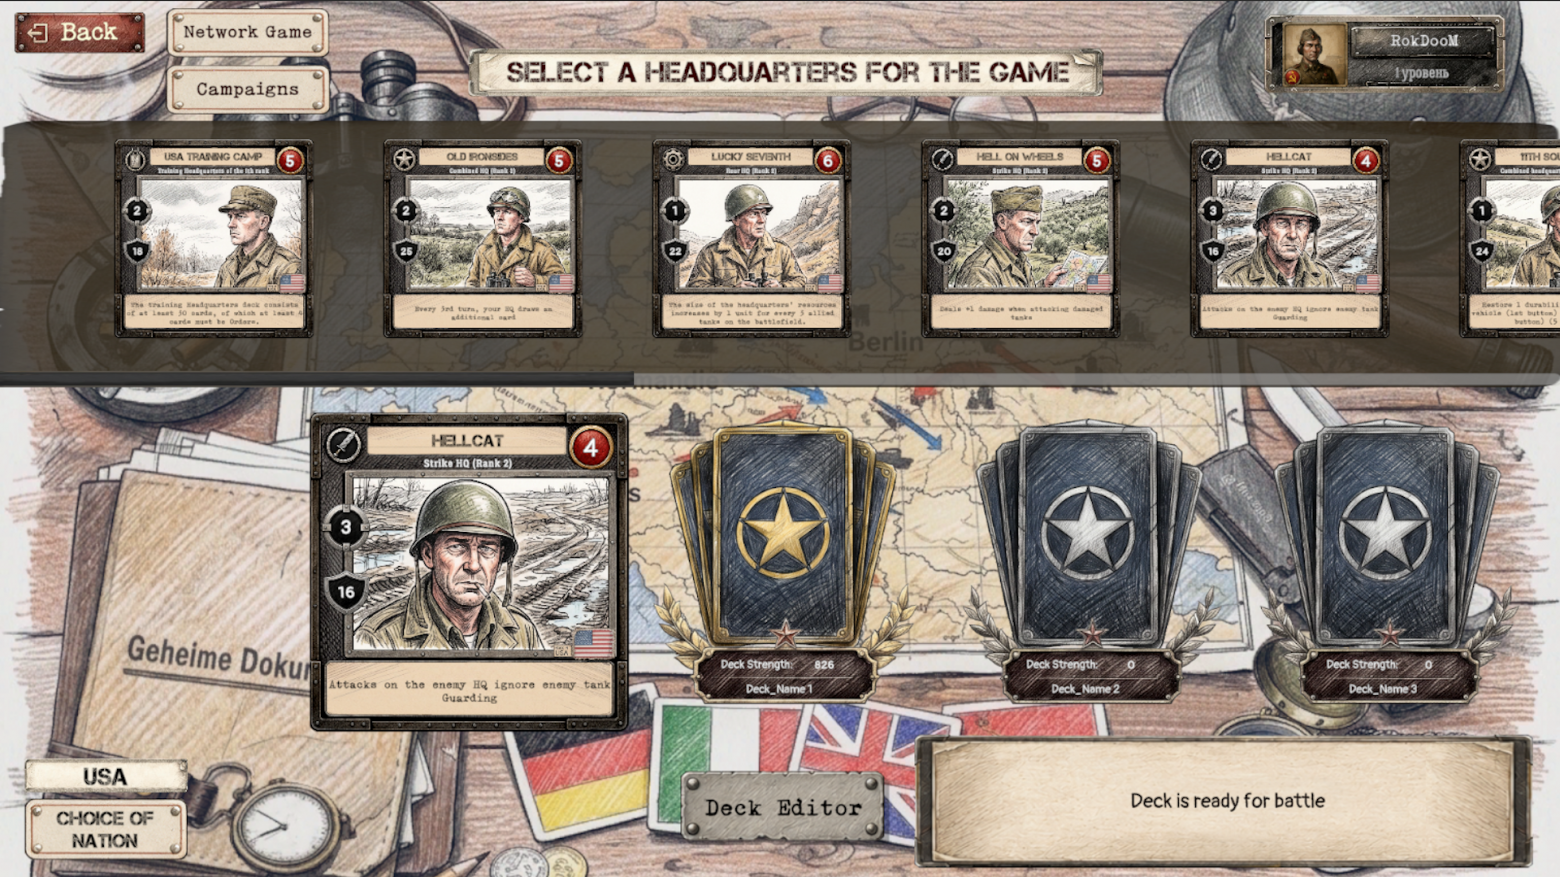
P.P.S. И по традиции — несколько скриншотов из игры.
Похожие статьи
 Разработчики пообещали продолжительную поддержку первой части Path of Exile
 Волки, гоблины и драконы: турнир по защите техподдержки
 Project Zomboid: вышла стабильная версия 42.22.2
 JoyToy выпустила по Warhammer: The Horus Heresy фигурку чемпиона-консула «Имперских Кулаков»
 [Перевод] Самодельная портативная игровая консоль на базе процессора 486
 Предзаказ новой статуи Ребекки из «Киберпанк: Бегущие по краю» от Prime 1 Studio откроется 10 ноября
 BioWare пытаются спасти от «американского диктата», Sony неожиданно призвала владельцев PS5 продавать консоли — самое интересное за неделю
 «Клэйфейс» вплотную приблизился к окупаемости