ИИ превратит интернет в Вавилонскую библиотеку, но в худшем исполнении
Когда возникает необходимость разобраться в каком-либо инструменте или сервисе, инстинктивно хочется сперва изучить чужой опыт и отзывы.
Однако за последний год эта привычка стала давать сбои. Страниц в сети меньше не стало — напротив, их число стремительно растёт. Всё дело в том, что из восьми открытых вкладок семь транслируют абсолютно идентичный контент, используя те же штампы и ту же последовательность изложения.
Очевидно, что эти тексты созданы не человеком, а простейшей языковой моделью без должного уровня промптинга. Для искусственного интеллекта весь массив мировой информации — это исключительно токены. Строки вроде «RFg♴4#-f体$fÆmZ» и любые другие символы для него сводятся к набору чисел. Смысл в них закладываем МЫ — люди, пытаясь передать его нейросети в процессе обучения. В итоге тексты, генерируемые ИИ, представляют собой нечто безликое и усредненное — некую солянку из всех имеющихся обучающих данных.
В результате глобальная сеть постепенно теряет индивидуальность, а суть и первоначальный замысел размываются.
Вавилон
В 1941 году аргентинский классик Хорхе Луис Борхес опубликовал новеллу о гипотетической библиотеке, содержащей абсолютно все возможные книги. Речь идет не о тех томах, которые уже были написаны человечеством, а обо всех мыслимых комбинациях символов, которые в принципе способна вместить книга. Среди этого бескрайнего хаоса хранятся все подлинные труды людей, их черновые наброски, переводы и даже случайные опечатки.
Произведение носит название «La biblioteca de Babel» («Вавилонская библиотека»). Настоятельно рекомендую ознакомиться с ним каждому, кто еще этого не сделал: рассказ лаконичен и легко находится в сети за пару секунд.
Так вот, на мой взгляд, сегодняшний интернет неуклонно движется к состоянию этой жутковатой библиотеки. И даже превосходит её по степени хаоса.
Что случилось в шестигранниках
Новелла вошла в сборник «El jardín de senderos que se bifurcan» 1941 года выпуска.
В основе пространственной структуры этой библиотеки лежат взаимосвязанные шестигранные залы, стены которых сплошь заставлены книжными полками.
Всего двадцать полок, по пять длинных полок на каждой стене; кроме двух: их высота, равная высоте этажа, едва превышает средний рост библиотекаря.
Примерно 99,9% этих фолиантов — чистейший информационный мусор и бред. Тем не менее, в силу бесконечной вариативности и теории вероятностей, среди них можно отыскать абсолютно всё: детальную хронику вашей собственной жизни, перевод Библии на несуществующие наречия, глоссарий к нему, указатель расположения всех существующих словарей, кулинарную книгу по мотивам «Звездных войн», а также ответы на любые вопросы человечества — в том числе на те, о которых мы еще даже не задумывались.
Вся жизнь обитателей этого мира подчинена единственной цели — поиску тех самых заветных фолиантов (называемых ими Откровениями), способных пролить свет на смысл их существования и предначертать судьбу. Это эпопея беспросветной бессмыслицы и десятки тысяч часов тщетных поисков.
Белый шум хуже абракадабры
Вернемся к сфере искусственного интеллекта.
ChatGPT и прочие LLM-модели — это всё же не точная калька с Вавилонской библиотеки. Их ответы не являются случайной генерацией символов; они базируются на вероятностном прогнозировании, опираясь на колоссальные массивы текстов, созданных людьми.
Такие системы не охватывают абсолютно всё на свете и не способны в точности воспроизвести любое когда-либо написанное слово. Рассуждая о них, критически важно осознавать: это продукты со своей предысторией. На них влияют когнитивные искажения исходных данных, субъективные решения создателей, а также цензура и культурные барьеры, призванные ограничивать выдачу определенного контента.
И тем не менее, если оценивать LLM именно как источник информации, они гораздо ближе к концепции Вавилонской библиотеки, чем к любым привычным нам технологическим аналогам.
К примеру, современная языковая модель — это точно не калькулятор.
Калькулятору можно безоговорочно доверять, поскольку он неизменно прав, а если и ошибается при округлении периодической дроби, то вполне предсказуемо. Поведение нейросети гораздо менее прозрачно. Если она выдает неверный результат, предугадать характер этой ошибки практически невозможно.
Классический ручной поиск в интернете тоже может привести к заблуждениям, но обычно он подкреплен ссылками на первоисточники. Опытный пользователь всегда может открыть их, проанализировать качество контента и сопоставить найденное со своими задачами. (Да, алгоритмы ИИ тоже опираются на источники как на контекст, но всё равно ошибаются — причем совершенно спонтанно. Как-то раз мы с приятелем заспорили, являются ли слова «порода» и «род» однокоренными. Нейросеть с абсолютной уверенностью заявила, что да, и их общий корень — род. К ответу была прикреплена ссылка на авторитетный источник, где черным по белому утверждалось обратное: у слова «порода» корень пород, а не род. Что именно спровоцировало модель на столь абсурдный вывод при наличии корректных исходных данных — загадка).
Но главное кроется в другом. Любое доверие к книге, интернет-ресурсу, прибору или эксперту зиждется на презумпции того, что кто-то сопоставил заявленное факты с объективной реальностью. Журналист общался со свидетелями, ученый проводил эксперимент, инженер выполнял калибровку оборудования. Люди, безусловно, склонны заблуждаться и лгать, но даже их ложь обычно апеллирует к каким-то внешним фактам. Ни тома из шестигранных комнат, ни сырые ответы алгоритма никогда не проходили проверку реальным миром.
Компания OpenAI честно предупреждала об этом еще в ноябре 2022 года при запуске research preview. Система «иногда генерирует правдоподобно звучащие, но ложные или бессмысленные ответы». Устранить этот баг крайне сложно, поскольку в процессе обучения с подкреплением «на данный момент просто нет эталонного источника абсолютной правды».
Мертвый язык
Согласно аналитическому отчету за май 2025 года, специалисты Ahrefs исследовали 900 тысяч новых англоязычных веб-страниц, проиндексированных в апреле (по одной на каждый домен). Следы искусственного интеллекта были обнаружены на 74,2% ресурсов. При детальной классификации выяснилось, что полностью машинный контент составляет лишь 2,5%, чисто человеческий — 25,8%, тогда как оставшиеся 71,7% приходятся на гибридные материалы, созданные в соавторстве с нейросети.
Кроме того, опрос 879 контент-маркетологов показал, что 87% из них так или иначе задействуют ИИ в своей работе (хотя детекторы контента далеко не безупречны, о чем сами разработчики делают оговорку).
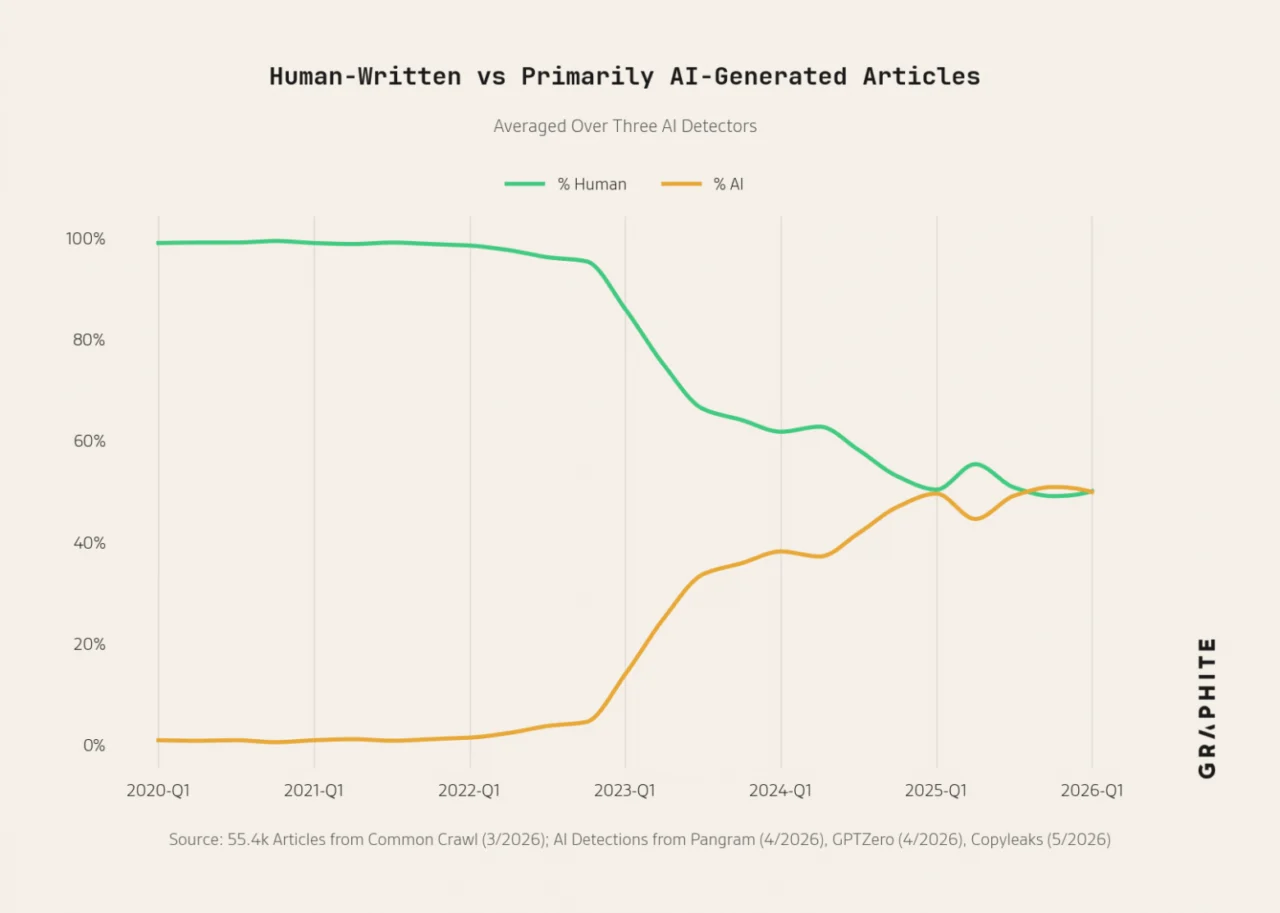
Приведем другие показатели. Платформа Graphite в мае 2026 года отобрала 55,4 тысячи случайных URL-адресов из базы Common Crawl, отфильтровав англоязычные статьи и списки с HTML-разметкой article объемом от ста слов, опубликованные в период с января 2020 по март 2026 года. Пропустив их через три независимых детектора (Pangram, Copyleaks и GPTZero), аналитики вывели средние квартальные показатели.
Методология Graphite отличается от подхода Ahrefs: если там фиксировалось любое минимальное присутствие машинного следа, то здесь отбирались материалы, где доля сгенерированного текста превышает 50%.
Спустя два года после релиза ChatGPT доля преимущественно машинных статей достигла 48%. В финальном квартале 2025 года этот показатель преодолел отметку в 50,9%, впервые обогнав долю человеческого контента. Последние пять кварталов график удерживается примерно на этом уровне, что свидетельствует не о временном всплеске, а о выходе на плато.

Тем не менее, речь идет примерно о половине новых англоязычных публикаций в выборке Common Crawl, а вовсе не о половине всего глобального интернета. Разница колоссальная, и объединять эти понятия не стоит.
Чем это опасно? Помимо очевидного утомления от потребления сгенерированного информационного мусора, такая тенденция деструктивно влияет на будущее обучение ИИ-систем. Питаясь контентом, созданным другими моделями, алгоритмы по сути пережевывают смыслы по второму и третьему кругу. Происходит дальнейшее усреднение уже усредненных данных.
В исследовании, опубликованном в журнале Nature (Shumailov et al.), наглядно продемонстрировано, что неконтролируемое обучение на синтетических текстах ведет к необратимым багам. Если не подпитывать систему свежими человеческими данными, с каждым новым поколением деградация будет только нарастать. (эдакий цифровой инцест нейросетей)
Сделаем важную оговорку: речь идет о последствиях рекурсивного обучения моделей, а не о том, что веб-пространство уже окончательно коллапсировало. Одно из другого автоматически не вытекает.
И тем не менее, включив здравый смысл, несложно сделать вполне определенные прогнозы.
Дефицит не текста, а проверки
Если сопоставить все факторы, вырисовывается тревожная картина. Объемы текстов, внешне неотличимых от экспертных знаний, ежегодно экспоненциально растут. При этом число людей, готовых выйти за пределы «шестигранных комнат» и верифицировать написанное на практике, не увеличивается. Информация принимается на веру без каких-либо сомнений.
Именно поэтому я считаю поверхностным совет «просто научиться лучше читать». Навыки поиска и критической оценки информации были востребованы и раньше, но прежде они опирались на веб-среду, где ссылки вели к реальным первоисточникам. Вскоре же любая ссылка будет перенаправлять на точно такую же статью, лишь переписанную другими словами, растворяя истину в бескрайнем океане рерайте.
Сегодня мы собственными руками создаем цифровую среду, в которой само понятие объективной истины постепенно девальвируется.
У книгохранителей из пророческого рассказа Борхеса было оправдание, которого мы лишены: их библиотека существовала с незапамятных времен, а они были лишь её обитателями, но не авторами. Наша виртуальная библиотека пишется прямо сейчас — и уже фактически без нашего участия.
Так что истинный вопрос заключается вовсе не в том, стоит ли бойкотировать ИИ или запрещать ему писать. Вопрос в том, как отыскать крупицы правды в океане её искусственных симуляций.
Похожие статьи
 Электрогитара «Ласточкин хвост», ред. 2
 Реально ли дата-центрам полностью обойтись без воды?
 Код как борьба. Краткая история IT. Часть 6. Ричард Столлман
 На чём кодили советские гики? Часть 3
 Как создавали модели дорожного движения до появления искусственного интеллекта
 Алгоритмический трейдинг: поиск закономерностей в шуме без переобучения моделей
 Как глобальное потепление изменит наш рацион?
 Каким по счету вы родились в семье