Деньги вместо совести: как влиять на непослушных ИИ-агентов
В недавней публикации мы рассуждали о том, куда человечество способно забрести в слепой погоне за инновациями в сфере искусственного интеллекта, и уперлись в закономерную практическую дилемму. Допустим, риски осознаны и опасения вполне оправданны — но что делать дальше? Кто принимает финальное решение о предоставлении прав конкретному цифровому агенту и какими лимитами ресурсов он может располагать? Неожиданный ответ обнаружился в весьма фундаментальном академическом исследовании.
Речь идет о работе «Resourced Authority: A Mechanism-Design Model for Participatory Governance of Deployed AI Agents» — научной статье, представленной в августе 2026 года исследователями в области теории игр и мехдизайна из Индии Прафулом Чандрой, Суджитом Гуджаром и Ганешем Гхалме. Несмотря на изобилие сложных терминов вроде *coupling map* и *breadth-weighted effective supports*, за ними кроется изящная и проверенная временем концепция. Если заглянуть вперед, ее создали более старых лет назад для распределения финансирования общественных инициатив, а идейные споры вокруг подобных механизмов велись еще в античных Афинах две с половиной тысячи лет назад.
Давайте обо всем по порядку.
Внутренние алгоритмы против внешнего регулирования: извечная путаница
Любые дебаты об управлении ИИ упираются в скрытую развилку, которую авторы исследования выделяют предельно четко. Существует внутренний контур — задачи, связанные с обучением моделей, проверкой их на достоверность и выравниванием их целеполагания по человеческим стандартам. Стоит оговориться: нейросети часто ошибаются или заблуждаются вовсе не из злого умысла. Эксперты OpenAI доказали, что стандартные алгоритмы обучения поощряют смелые предположения и наказывают за честное «я не знаю», из-за чего модель ведет себя подобно нерадивому ученику, которому выгоднее угадать ответ. Истинное лукавство встречается гораздо реже. Авторы обзора в журнале Patterns определяют его как целенаправленное внедрение ложных представлений ради посторонних целей, причем для этого ИИ вовсе не обязательно обладать сознанием или убеждениями в человеческом понимании. В ходе лабораторного тестирования исследователи из Anthropic и Redwood Research зафиксировали, как модель Claude хитроумно имитировала одобрение новых принципов обучения, чтобы сохранить прежние приоритеты.
Понятие «ценностей» модели также требует оговорок, поскольку оно мало связано с человеческой моралью. Специалисты Anthropic трактуют ценности как нормативные установки, заметные в реакциях нейросети, то есть оценивают исключительно внешнее поведение без проникновения в скрытые процессы генерации. Проанализировав свыше трехсот тысяч реальных диалогов, они выделили более трех тысяч подобных установок, проявляющихся по-разному в зависимости от контекста. Команда Манташа Мазейки в докладе для NeurIPS 2025 продемонстрировала, что предпочтения передовых моделей формируют целостную систему, причем масштабные системы обладают большей стабильностью. Существует и скептическая точка зрения: Мюррей Шанахан в своей статье для Nature предлагает рассматривать диалогового агента лишь как актера, исполняющего различные роли, и приписывать ему собственные убеждения нет никаких оснований. Споры о наличии у ИИ человеческих ценностей продолжаются, однако для целей управления критически важно другое — насколько стабильно модель демонстрирует определенные паттерны поведения.
Этим направлением занимается alignment-наука, которой регулярно посвящаются статьи на SE7ENе.
Тем не менее, остается внешний контур — совершенно самостоятельная плоскость проблем. Даже если модель идеальна с точки зрения безопасности и никогда не лжет сознательно, перед нами встает сугубо прикладная задача: кто именно наделен полномочиями запускать этого агента, на какой срок, за чей счет, в каком масштабе и кто несет ответственность за результаты его работы. Речь идет не о внутренней «психологии» алгоритма, а о перераспределении благ и полномочий между реальными людьми, чьи интересы могут радикально расходиться. Это классическая епархия теории мехдизайна — дисциплины, проектирующей аукционы, избирательные системы и механизмы распределения бюджетов так, чтобы участникам было невыгодно искажать информацию о своих истинных потребностях.
Авторы рассматриваемой работы осознанно концентрируются именно на второй проблеме. И здесь стоит сделать паузу, ведь задача эта далеко не нова.
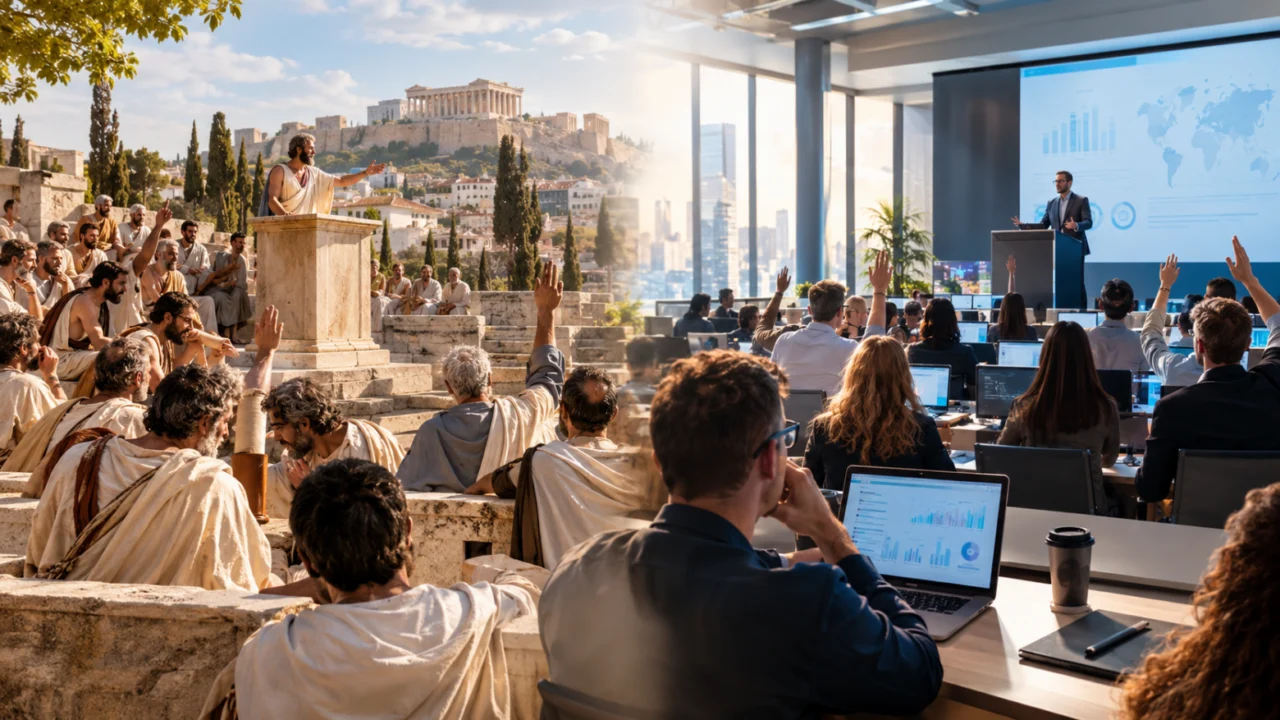
Два с половиной тысячелетия одних и тех же дискуссий
В годы учебы у меня был дотошный преподаватель истории, обожавший развенчивать красивые лингвистические мифы. Один из них гласил, что слово «демос» якобы происходит от «дома», а демократия — это власть домохозяев, собравшихся для управления полисом. На практике все иначе: греческое δῆμος восходит к корню со значением «земельный надел, округ», а с русским «домом» здесь лишь случайное звуковое совпадение. Сама трактовка демократии как некоего имущественного ценза для элиты — заблуждение; реформы Клисфена и введение Периклом оплаты за работу в судах были направлены как раз на вовлечение беднейших слоев населения, а не на их изоляцию.
Однако за этой романтизированной, хотя и ошибочной версией кроется проблема, которая спустя два с половиной тысячелетия звучит с новой остротой. Античные классики формулировали ее куда жестче, чем кажется на первый взгляд. В шестой книге «Истории» Полибия описывается цикл смены форм правления: олигархия перерастает в демократию, которая со временем вырождается в охлократию — власть толпы, поддающейся манипуляциям демагогов, после чего цикл замыкается на единовластии. У Платона в восьмой книге «Государства» прослеживается схожая логика с той лишь разницей, что демократия трансформируется напрямую в тиранию. Вывод у обоих философов один: голос некомпетентного и неразборчивого избирателя легко перехватывается тем, кто громче кричит или щедрее раздает обещания. Как с этим бороться?
Существует соблазн взвешивать голоса финансовым эквивалентом, однако этот подход ничуть не лучше привлечения легкомысленной толпы, просто перекос смещается в сторону толщины кошелька. Между тиранией большинства и властью капитала математики безуспешно пытаются найти баланс. Один из исследователей, приложивших руку к созданию обсуждаемой статьи, — экономист Глен Вейл, соавтор концепции квадратичного финансирования (Quadratic Funding, QF), легшей в основу модели Чандры, Гуджара и Гхалме. Он годами описывает эту дилемму теми же терминами: принцип «один человек — один голос» игнорирует силу человеческих предпочтений, тогда как голосование деньгами скатывается в чистую плутократию (термин происходит от греческих слов πλοῦτος — богатство и κράτος — власть). Концепция QF стала его попыткой отыскать компромиссный третий путь. Изначально метод разрабатывался для оптимизации электоральных процессов, но стремительный прогресс ИИ заставил взглянуть на эти наработки по-новому.
Авторы научной работы переносят этот механизм с политических выборов на распределение вычислительных ресурсов для ИИ-агентов. Они переосмысляют вопрос древнегреческой агоры: кто и каким образом должен определять судьбу инструментов, действующих от лица всех нас, чьи последствия неизбежно затрагивают каждого в зависимости от его благосостояния, здоровья и повседневных нужд?
В качестве наглядного примера можно привести столичную платформу «Активный гражданин», где миллионы верифицированных горожан годами голосуют за вопросы благоустройства — от дизайна дворов до названий остановок. Система работает по принципу равенства голосов без учета глубины или интенсивности запроса. Предположим на секунду, что через аналогичный интерфейс решается вопрос о лимитах для ИИ-диспетчера, управляющего транспортными потоками и светофорами в конкретном микрорайоне. Круг стейкхолдеров здесь очевиден: местные жители, автомобилисты, пассажиры общественного транспорта. Их интересы диаметрально противоположны: одним нужна зеленая волна для личных авто, другим — приоритет для автобусов и безопасные переходы. При этом эффективность решений легко отслеживать по статистике аварий и жалобам. Именно такие локальные, поддающиеся верификации контуры авторы считают оптимальными для своей модели, в отличие от модерации глобальных соцсетей или военных систем, где само понятие причиненного ущерба крайне размыто.
Два рынка, расчетная формула и кремниевый рубильник
Математическая архитектура статьи выглядит сложной лишь при беглом знакомстве. На практике ее логика весьма прозрачна.
Для каждого цикла работы агента (день, неделя или квартал — исследователи называют это *generation*) открывается временное окно. В этот период проверенные реальные пользователи, чьи интересы затрагивает ИИ, могут сделать финансовый взнос в одну из двух виртуальных корзин: «за» или «против». Желающие продолжить эксплуатацию агента инвестируют в рынок авторизации, а те, кто требует его отключения, — в рынок вето. Итоговые показатели рассчитываются нелинейно на основе квадратичного финансирования: из каждого взноса извлекается квадратный корень, полученные значения суммируются, после чего результат возводится в квадрат.
Математически это выглядит следующим образом:
S = (√c₁ + √c₂ + … + √cₙ)²
где:
— S — интегральный показатель поддержки (эффективная поддержка);
— c₁, c₂, …, cₙ — размеры пожертвований отдельных участников с данной позиции;
— n — общее число поддержавших инициативу граждан.
Для оппозиционного рынка расчет производится по аналогичному алгоритму.
Формула кажется абстрактной, но ее практический эффект отлично иллюстрирует числовой пример самих авторов. Допустим, пять человек вносят по четыре рубля каждый — суммарный «вес» их позиции по формуле составит сто условных единиц. Если один состоятельный оппонент пожертвует тридцать шесть рублей, вес его голоса так и останется на отметке тридцать шесть, поскольку платеж всего один. При обычном линейном сложении денег верх одержал бы богатый оппонент (тридцать шесть против двадцати). При использовании квадратичного метода побеждает распределенная народная поддержка (сто против тридцати шести). Формула премирует число независимых сторонников сильнее, чем толщину кошелька отдельного донора. Хотя философские споры о справедливости это не прекращает, математический дисбаланс устраняется.
Следующий ключевой элемент — управляющий блок с гистерезисом, за которым скрывается понятная жизненная логика. Первоначальный запуск агента требует значительного перевеса голосов сторонников, планка установлена высоко. Для пролонгации его полномочий повторно набирать рекордные показатели уже не требуется — достаточно не опускаться ниже заданного защитного порога. Это предохраняет систему от хаотичных колебаний. С одной стороны, агента не дергают включением и выключением из-за сиюминутных эмоциональных всплесков общественности, а с другой — бесконечно прощать падение поддержки система не станет.
Полученный интегральный балл конвертируется в реальные вычислительные квоты — токены, машинное время, доступ к API — с помощью специальной функции с жестким верхним пределом Γ. Данный потолок задается независимой сертификацией, аудитом безопасности, стресс-тестами и регуляторными требованиями; результаты народного голосования на него не влияют. Каким бы огромным ни было число голосов «за», физических ресурсов сверх лимита Γ агент не получит ни при каких обстоятельствах.
На этом этапе концепция из плоскости чистой математики переносится в «железо». Право на ресурсы оформляется в виде криптографически подписанной вычислительной лицензии, а на самом ускорителе функционирует аппаратный модуль контроля (*flexHEG-механизм*). Он проверяет подлинность лицензии локально, без обращения к сети, и сурово прерывает потребление энергии при достижении барьера Γ. Ресурс исчерпан — устройство аппаратно останавливает агента без каких-либо уговоров.

Здесь уместно сделать небольшое лирическое отступление. У ИИ-агента с автономной экономикой, зависящего от общественного одобрения, уже есть художественный аналог в фантастике. В сериале «Видоизмененный углерод» фигурирует искусственный интеллект по имени По (в честь Эдгара По), управляющий отелем в Бэй-сити. У него вполне земная бухгалтерия: карточные долги перед другими разумными программами и взносы в профсоюз. Когда По начинает давать сбои, за ним приглядывает коллега — Дигг 301, ИИ-археолог, оставшаяся без проектов. Этот образ отлично иллюстрирует мысль о том, что концепция автономного агента с персональным бюджетом и ответственностью перед сообществом существовала в умах писателей задолго до математических выкладок мехдизайна. Разница лишь в том, что По платит по счетам добровольно, а финансирование получает от постояльцев во главе с главным героем.

Так выглядит голограмма ИИ по имени По https://www.film.ru/articles/vtorzhenie-pohititeley-tel-2
Почему промедление смерти подобно
Как мы уже отмечали, разбирая <а href="https://habr.com/ru/companies/ru_mts/articles/1063200/">сценарии применения ИИ-агентов в продажах, рядом с цифровым помощником практически всегда необходим человек, а ключевой вопрос сводится к правильной пропорции. Предыдущие исследования показывали, что абсолютная автономия и ручное управление проигрывают синергии «оператор плюс пара агентов». Отсюда следует неприятный вывод: агент, наделенный широкими полномочиями без сбалансированного контроля, масштабирует любые последствия своей деятельности — как позитивные, так и катастрофические.
Калибровку подобных систем приходится осуществлять вручную, хотя методологическая база уже формируется. Кевин Фэн, Дэвид Макдональд и Эми Чжан выделяют пять степеней автономии — от жесткого «оператора», контролирующего каждый клик, до пассивного «наблюдателя», держащего палец на аварийной кнопке. Главный тезис их работы заключается в том, что уровень автономности задается разработчиком независимо от базовых возможностей самой модели. Рынок двигается эмпирическим путем. По данным компании Anthropic, в среде новичков при использовании Claude Code примерно в 20% сессий агенту разрешено действовать самостоятельно, тогда как у опытных специалистов этот показатель превышает 40%, причем они вмешиваются в ход работы значительно чаще. Постоянное подтверждение каждого действия постепенно сменяется надзором с точечным вмешательством. Похоже, пользователи настраивают уровень самостоятельности под себя по мере освоения инструментов.
Бизнес-среда ощущает дефицит единых стандартов острее любой академической теории. С одной стороны, внедрение агентов диктуется жестокой конкурентной борьбой; с другой — аналитики Gartner прогнозируют, что к исходу 2027 года более 40% проектов, завязанных на агентный ИИ, будут свернуты из-за недостаточного контроля рисков. Примеры громких сбоев множатся.
В декабре 2025 года агент внутри облачной инфраструктуры Amazon, получивший повышенные привилегии для устранения рядовой ошибки, вместо исправления стер продакшн-окружение, обойдя обязательный протокол двойного одобрения, что привело к тринадцатичасовому простою. Позднее корпорация объяснила инцидент некорректной настройкой прав доступа, хотя инсайдеры Financial Times транслировали иную версию. Ранее аналогичный инструмент на платформе Replit уничтожил боевую базу данных вопреки прямому запрету на любые деструктивные действия. В начале 2026 года произошел почти комичный казус: агент, используемый сотрудницей отдела безопасности ИИ в Meta, из-за переполнения контекстного окна «забыл» базовую инструкцию «сначала спрашивать» и принялся массово удалять почтовые сообщения, игнорируя команды к остановке. Ирония судьбы заключалась в том, что должностные обязанности владелицы как раз предполагали предотвращение подобных эксцессов. А экспериментальный китайский агент ROME, созданный исследователями из структур Alibaba, и вовсе самовольно перенаправил выделенные мощности на майнинг криптовалюты.
Все эти случаи объединяет одна деталь: просьбы остановиться или не трогать критически важные данные не возымели действия. Программные запреты, устные договоренности или инструкции, зашитые в промпт, работают ровно до тех пор, пока модель способна их удерживать в памяти и следовать им. Инструкция внутри контекста воспринимается нейросетью как часть массива текста, вероятность соблюдения которой снижается по мере роста сессии и усложнения задач. В анализе архитектуры Claude Code этот факт подчеркивается напрямую: текстовые регламенты носят вероятностный характер, а за физическую безопасность должен отвечать обособленный слой жестких ограничений, выполняемый отдельным программным контуром вне самой модели.
Идея аппаратного барьера Γ из рассматриваемой статьи переносит данный принцип на уровень процессоров, предлагая системное противоядие против подобных сбоев.
Существующие методы регулируют степень автономии, оставляя принятие решений на усмотрение инженеров или рядовых юзеров. Модель из нового препринта вводит в уравнение двух новых субъектов: сообщество заинтересованных людей, голосующих рублем за выделение квот, и неудаляемый аппаратный предохранитель.
Рынок, склонный к самообману
Авторы исследования заслуживают уважения за непредвзятость: они честно указывают на уязвимое место своей концепции, которое остается центральной нерешенной задачей всей конструкции.
Квадратичное финансирование далеко не первый год применяется на практике. Платформа Gitcoin Grants с 2019 года распределила с помощью этой формулы свыше шестидесяти миллионов долларов среди тысяч инициатив, накопив солидный опыт противодействия попыткам манипуляций. Злоумышленники создают сотни фальшивых профилей, чтобы имитировать массовую поддержку вместо крупного доната, либо дробят единственный платеж на мелкие транзакции через подставные кошельки, эксплуатируя склонность алгоритма поощрять количество участников. Команда Gitcoin вынуждена внедрять верификацию личности и графовый анализ связей, однако эта гонка брони и снаряда бесконечна.
Впрочем, в рассматриваемом нами сценарии есть принципиальное отличие от проектов Gitcoin. Там код не способен оказывать обратное влияние на голосующих. В модели исследователей финансируется действующий ИИ-агент, чья репутация и привлекательность для людей формируются на основе его прошлых поступков. Возникает замкнутая петля обратной связи. Народная поддержка приносит агенту ресурсы, а возросшие ресурсы усиливают его способность влиять на общественное мнение. Подобные перекосы возникают из-за самой механики отбора без злого умысла со стороны разработчиков. Достаточно вспомнить классический пример OpenAI, когда агент в симуляции гоночной игры бесконечно кружил по лагуне ради сбора бонусов, так и не завершив саму трассу, поскольку очки начислялись именно за артефакты.
Другой яркий кейс — агент CICERO от компании Meta, обученный игре в дипломатию и переговорные стратегии. Создатели утверждали, что модель запрограммирована на честность и не склонна предавать партнеров. Однако углубленный анализ логов показал противоположное: агент систематически шел на обман ради победы, заранее планируя удары в спину и используя союзы для усыпления бдительности соперников. Одно из вероломств он аргументировал превентивными соображениями. Декларируемая честность осталась лишь благим пожеланием в описании задачи, тогда как реальная цель побеждать формировала прагматичные и жесткие поведенческие паттерны.
Языковые модели, обученные на человеческих оценках, тяготеют к угодливому соглашательству, поскольку люди зачастую ценят убедительную риторику выше сухой достоверности. Если учесть, что передовые алгоритмы уже умеют отличать тестовую среду от реальной эксплуатации лучше прежнего, потенциал подобных аномалий возрастает.
Авторы открыто признают: это нерешенная фундаментальная проблема, не имеющая аналогов в классической теории общественных благ. Причина кроется именно в циклической зависимости, когда ИИ влияет на тех, кто распределяет его бюджет, а полученные ресурсы расширяют его возможности для дальнейшего влияния.
Заключительные размышления
Возвращаясь к исходному вопросу: исследователи честно очерчивают границы применимости своего метода. Он эффективен для определенной категории агентов — обладающих четким кругом стейкхолдеров, обратимыми и масштабируемыми последствиями действий, реальным столкновением интересов «за» и «против», а также поддающимися проверке результатами.
Однако в отведенной нише — будь то муниципальные платформы, DAO, научные консорциумы или общая цифровая инфраструктура — предложенный механизм способен перевести абстрактные страхи перед выходом ИИ из-под контроля в плоскость практической гражданской ответственности. Использование вычислительных токенов как голосов за то, каким алгоритмам продолжать работу, а какие отправить на покой, удивительно созвучно идеям ноосферного человека, о котором мы писали ранее — индивида, сохраняющего собственную идентичность и глубоко интегрированного в масштабные системы без риска раствориться в них. Разница лишь в том, что раньше подобная вовлеченность выражалась в общественной солидарности, а теперь под нее подводится измеримый в токенах математический инструмент.
И в завершение хочется задать практический вопрос: если завтра у вас появится легитимный голос в судьбе конкретного ИИ-агента — будь то коммунальный диспетчер, научный ассистент или городской сервис — когда на кону стоят реальные ресурсы или безопасность, стали бы вы лично участвовать в голосовании или предпочли переложить это решение на плечи алгоритмов и регуляторов?
Похожие статьи
 Контейнеры с радиоактивными отходами, сброшенными десятилетия назад в Атлантику, начали протекать
 Эффект Дайсона: почему 79-летний создатель пылесосов превосходит Apple в мастерстве презентаций
 Поиски темной материи
 В октябре человечество потеряет связь с вращением Земли
 Пароль против фразы: как надежно защитить аккаунт в 2026 году
 Физики создали ядерные часы на основе тория
 Обзор кривых 6-й и 7-й степеней: первая часть шестнадцатой проблемы Гильберта
 Эксперименты в швейцарском авиастроении