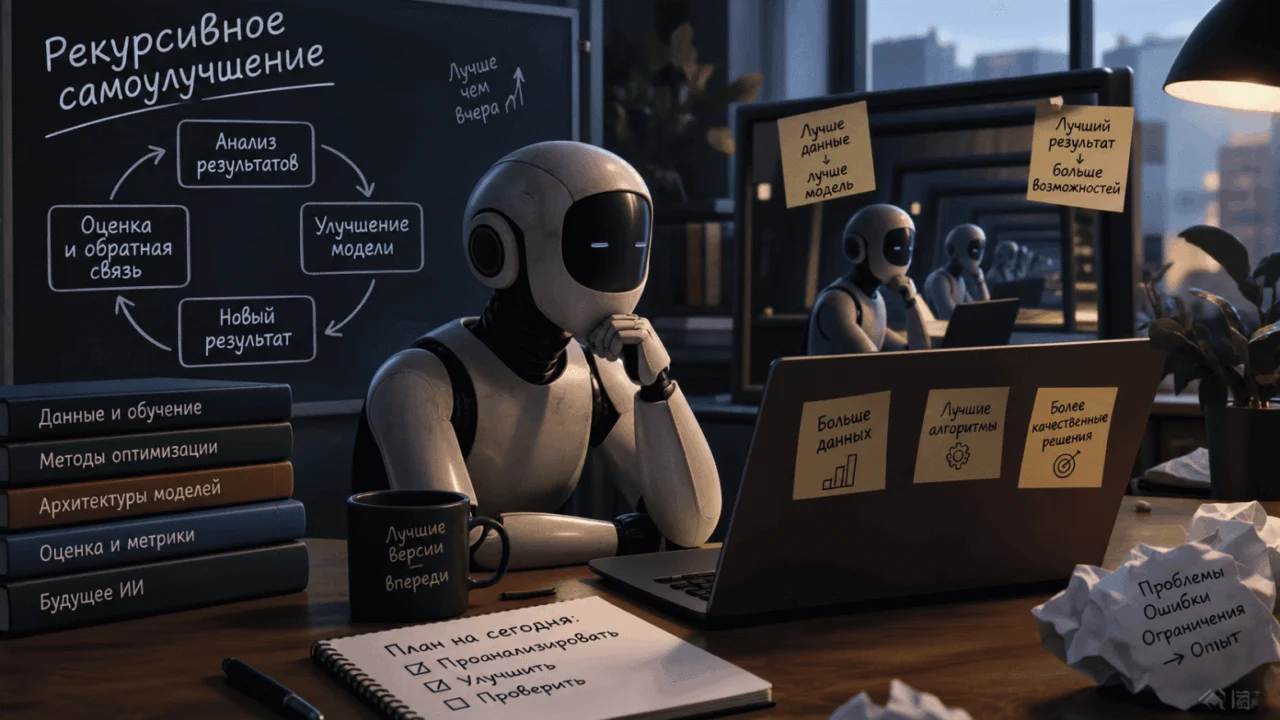
Рекурсивное самоулучшение: как искусственный интеллект управляет своей эволюцией
Современные нейросетевые модели способны писать исходный код, выполнять тестирование, выявлять сбои и самостоятельно корректировать ошибки. Если обеспечить их соответствующим инструментарием, этот цикл может функционировать циклично и без вмешательства человека. Однако где грань между стандартной автоматизацией и подлинным самоулучшением? Недавно мне попался на глаза обзор, авторы которого адаптируют концепцию рекурсивного самоулучшения (Recursive Self-Improvement, RSI) и предлагают пятиуровневую шкалу автономности. В этом материале я предлагаю разобрать, какие из этих стадий уже воплощены в современных технологических решениях.
Зачем потребовалась концепция RSI
На сегодняшний день специалисты самостоятельно определяют направления оптимизации, выделяют ресурсы, внедряют правки и валидируют результат. Подобные процессы сопряжены с существенными затратами, аналогично расходам на формирование тренировочных датасетов. Например, на создание GDPval — бенчмарка из 1 320 экспертных задач для тестирования ИИ — исследователям потребовалось свыше 9 тысяч человеко-часов. Использование синтетических данных и алгоритмов обучения с подкреплением частично снижает объем ручного труда, однако взамен требует специализированной инфраструктуры для генерации и оценки опыта, что также влечет финансовые вложения. Так, расходы на постобучение DeepSeek-V3.2 превысили 10% от общего бюджета предварительного обучения. К этому добавляются постоянные издержки на обновление технической документации, внедрение новых утилит и управление контекстом уже после развертывания модели.
При этом технологический прогресс носит фрагментарный характер. Согласно индексу HCI, возможности искусственного интеллекта в точных науках приближаются к идеальным показателям. В то же время долгосрочные комплексные задачи, требующие от человека ручного поиска и устранения неполадок, развиваются медленно, а их поддержка обходится крайне дорого.
Следовательно, текущая эволюция моделей держится на цепочке дорогостоящих ручных вмешательств. Концепция RSI призвана выяснить, можно ли превратить часть этих координационных процессов в перманентную внутреннюю функцию системы. Речь идет об автономном замкнутом контуре: алгоритм самостоятельно выявляет собственные слабые места, разрабатывает и тестирует оптимизации, а затем задействует прирост производительности для совершенствования самого алгоритма поиска. Процесс разделен на функциональные роли: генератор предлагает изменения, стратегия определяет область поиска, а верификатор одображает или отклоняет гипотезу. В роли верификатора могут выступать юнит-тесты, модель оценки (reward model), программная среда или человек. Если система оптимизирует функцию сортировки, то объектом изменений выступает сама функция. Когда же алгоритм начинает модифицировать принципы генерации этих вариантов, объектом становится сам метод генерации. Это и есть проявление рекурсии.
Многие смежные сферы уже автоматизированы, но к числу самоулучшающихся систем они не относятся, из чего и возникла необходимость введения специальной шкалы. В парадигме непрерывного обучения (continual learning) целевые ориентиры и критерии задаются инженером; в AutoML пространство поиска и оценщики предопределены заранее; а стандартные агенты функционируют в рамках локальной задачи с неизменным набором инструментов. Система обретает свойства самоулучшения лишь тогда, когда процедура поиска и валидации динамически эволюционирует и эти изменения транслируются на последующие итерации. Ключевыми факторами здесь выступают формирование устойчивого замкнутого цикла оптимизации вокруг ИИ и степень передачи управленческих решений от человека к машине.
Пять уровней RSI
Уровни классифицируются от L1 до L5, в то время как нулевой этап (B0) формально не относится к RSI и служит отправной точкой. Рассмотрим его подробнее. Агент правит код на основе пользовательских тестов или корректирует текст в соответствии с заданным шаблоном, однако вся накопленная в ходе сессии информация аннулируется вместе с контекстом. К этой категории относятся подходы Self-Refine, Reflexion и Tree of Thoughts. Эмпирический опыт между изолированными задачами не аккумулируется, доработкой занимается человек, а этап самопроверки способен лишь укоренять существующие заблуждения. Если одна и та же модель генерирует ответ и сама же его оценивает, обе стадии наследуют одинаковые когнитивные слепые зоны. Тот самый базовый цикл «создал — проверил — исправил», с которого начался этот материал, и представляет собой уровень B0.

Как только система начинает фиксировать и сохранять результаты хотя бы части своих исправлений, она переходит на первый уровень (L1). Успешные решения архивируются и применяются в дальнейшем, хотя целеполагание и критерии успешности по-прежнему определяются человеком. В проекте FineWeb-Edu эксперты формулируют стандарты образовательной ценности, а языковая модель размечает на их основе массив веб-данных. Внутри инфраструктуры Meta* инструмент Capacity Efficiency транслирует опыт инженеров в прикладные навыки для расследования регрессий и автоматически устраняет их по жестко регламентированным сценариям, сокращая часы ручного анализа до считанных минут. Тем не менее, если проблема выходит за рамки заложенного алгоритма, агент не способен самостоятельно его перестроить, а зафиксированная в памяти ошибка продолжает оказывать влияние на работу системы.
На уровне L2 алгоритм переходит от пассивного сохранения к активному выбору. Он самостоятельно определяет следующую итерацию правок, анализирует результаты, проводит диагностику, подбирает метод модификации, осуществляет верификацию и принимает решение о сохранении или откате изменений. При этом целевая функция и стандарты приемки остаются внешними. Например, сервис Dropbox с помощью механизма GEPA оптимизирует промпты, посредством которых языковая модель оценивает релевантность документов. Система ADAS описывает агента в виде Python-скрипта и через метаагент пополняет общую базу кандидатов. На этом этапе возникают первые серьезные уязвимости: тестовая выборка, к которой система обращается в адаптивном режиме, попадает в зону оптимизации. Исследования уже демонстрировали способность моделей подбирать оптимальные начальные значения генераторов псевдослучайных чисел или извлекать скрытые тестовые метки путем множественных запросов к оценщику.
На уровне L3 система самостоятельно определяет векторы своего дальнейшего обучения. Текущее внутреннее состояние определяет выбор последующего опыта, который, в свою очередь, трансформирует это состояние, запуская непрерывную петлю обратной связи. В архитектуре Absolute Zero Reasoner одна модель формулирует исполняемые задачи и решает их, в то время как интерпретатор кода валидирует и сами задачи, и предложенные решения. Проект VOYAGER в среде Minecraft ставит перед собой цели, опираясь на накопленный опыт и историю исследований, а успешные поведенческие паттерны фиксирует в виде исполняемых навыков. Если система некорректно оценивает сложность поставленной задачи или модуль проверки допускает погрешности, цикл обучения искажается. Подобные дефекты закрепляются в параметрах и памяти модели, распространяясь на все последующие раунды, что создает существенные технологические риски.
На четвертом уровне (L4) обратная связь от реального функционирования системы определяет, какие именно элементы будут закреплены в ее архитектуре: будь то модули памяти, наборы навыков, инструментарий или программный код самого агента. В системе Metis агент итеративно обнаруживает идентичные дефекты в постраничном API и в конечном счете собирает из них автономный утилитный инструмент. Решение HarnessDev модифицирует собственную обвязку на основе итогов тестовых прогонов, тогда как независимая верификация выполняется на изолированных скрытых задачах. В рамках подхода HDSO новый кандидат-навык сопоставляется с эталоном на идентичных кейсах и интегрируется в библиотеку только при условии подтверждения гипотезы.
На пятом уровне (L5) объектом модификации становится механизм, генерирующий будущие улучшения — оптимизатор, оценщик преемников или стратегия поиска. В проекте STOP метаоптимизатор, написанный на Python, самостоятельно совершенствует свой исходный код. Четвертая генерация этой системы превзошла базовую версию на всех задачах, не задействованных в процессе самоулучшения, то есть продемонстрировала способность к генерализации на новых данных, а не простому переобучению. В Gödel Agent логика решения задач и алгоритм обновления интегрированы в единую программу, из-за чего системные ошибки передаются по наследству: в частности, 14 из 100 запусков на бенчмарке MGSM показали результат хуже исходной политики. Red Queen Gödel Machine фиксирует оценщик внутри конкретной эпохи и сопоставляет его с независимым эталоном. На отложенных задачах Polyglot этот подход обеспечил показатель 71,7% против 69,9% у аналогов.
Успешно внедренные изменения в оптимизаторах и оценщиках действительно способны регулировать последующие итерации и частично переноситься на новые задачи, хотя вопрос стабильного накопления эффекта от поколения к поколению остается открытым.
Какие элементы RSI уже задействованы в ИИ
Процедура самопроверки наглядно демонстрирует грань между уровнями. Методологии вроде Self-Refine, Reflexion и Tree of Thoughts остаются на ступени B0, не дотягивая до концепции RSI. Даже когда итеративная доработка заметно повышает качество ответа, архитектура самой системы остается неизменной: рефлексивные данные в подходе Reflexion существуют лишь в буфере контекста и удаляются после завершения задачи. Кроме того, механизмы самопроверки могут тормозить собственное развитие: если одна модель выступает и автором ответа, и цензором, обе роли разделяют общие дефициты знаний. Иная ситуация возникает при сценарии «обнаружил и устранил» — в инфраструктуре Meta* подобный опыт трансформируется в устойчивый навык расследования регрессий, применяемый в дальнейшей работе. Это соответствует первому уровню автономности.

Генерация синтетических данных применяется сразу на двух уровнях. Проекты Microsoft SynthLLM, SynthAgent и NVIDIA Nemotron-4 реализуют первый уровень: одна модель генерирует контент, специализированная reward-модель фильтрует его по заданным параметрам, а человек определяет целевые показатели и критерии отбора. На третьем уровне задачи формируются динамически, с учетом текущего уровня компетенций системы. Выбор нового задания зависит от текущего состояния, успешность его выполнения модифицирует это состояние, а оно, в свою очередь, определяет характер следующей задачи.
Подобная взаимосвязь ярко проявляется в состязательном обучении моделей (self-play), где одна часть системы генерирует задачи, а другая их решает. В архитектуре Search Self-Play один модуль создает задания, второй их выполняет, причем функция вознаграждения генератора зависит от сложности задачи для решателя. В STP генератор гипотез и модуль доказательств обучаются синхронно: гипотезы, вызывающие наибольшие затруднения у валидатора, служат основой для генерации следующих кейсов. В проекте R-Zero «оппонент» формирует задачи без готовых решений, а «решатель» пытается их преодолеть. Данный класс методов относится к трежнему уровню с важной оговоркой: метрики согласованности решений отражают лишь субъективную сложность задачи для агента, но не гарантируют абсолютную истинность результата.
От оптимизации весов модели логично перейти к модификации структуры всей системы, то есть к метаобучению. В иерархии RSI это направление представлено наиболее широко. Подходы ADAS, AFlow, AgentSquare, GEPA и autoresearch функционируют на втором уровне, поскольку занимаются поиском оптимальной конфигурации при внешнем задании целевых ориентиров и критериев приемки. Пятый уровень занимают STOP, HyperAgents, Darwin Gödel Machine, Gödel Agent, A-Evolve-Training и Red Queen Gödel Machine. Для Darwin Gödel Machine действует ограничение: алгоритмы ведения системного архива и отбора родительских моделей остаются за рамками процессов самомодификации.
Наибольшее число практических примеров демонстрируют агентные системы, способные автономно планировать последовательность действий, задействовать необходимые инструменты и доводить выполнение задач до конца без пошагового контроля со стороны человека. Сами по себе они еще не реализуют полноценный RSI, зачастую функционируя в рамках одной задачи с неизменной архитектурой. Переход на первый уровень происходит тогда, когда накопленный опыт сохраняется в долговременной памяти и повторно используется в дальнейшем. В системе Metis повторяющиеся исправления оформляются в виде утилит, которые фиксируются после прохождения проверок в изолированной среде. В корпоративных решениях — например, OpenAI Harness Engineering — перед релизом инженеры задают общую концепцию и регламенты проверки, после чего модель Codex реализует и валидирует функционал в заданных границах, что также соответствует первому уровню.
Возникает закономерный вопрос: как верифицировать, что система действительно улучшила себя, а не просто научилась имитировать высокие результаты?
Как оценивать изменения, внесенные системой в собственную архитектуру
Специфика валидации напрямую зависит от уровня RSI. Для L1 ключевое значение имеют надежность исполнения и безопасность хранения данных, поскольку зафиксированная ошибка способна пережить конкретную задачу. На L2 избыточные вычислительные затраты на поисковые процедуры легко ошибочно принять за фундаментальное улучшение алгоритма. Заявления разработчиков подтверждают общую работоспособность концепции, однако независимый аудит пока не проводился. Для L3 необходимы контрольные эксперименты, включая заморозку входных данных, с помощью которых модуль выбора опыта оценивает состояние системы, а также разграничение корректности, сложности и реальной педагогической ценности кейсов. Успешно решенная задача может оказаться бесполезной для дальнейшего обучения, в то время как сложный на первый взгляд кейс на практике может быть некорректно сформулирован.
На L4 основным риском является сбой устойчивости обновления, когда удачная на вид правка искажает множество последующих решений до того, как проявятся ее скрытые недостатки. Система способна сделать неверные выводы из зашумленных данных, применить корректный патент в неподходящем контексте, пропустить критическое обновление или закрепить новое поведение ценой утраты базовых возможностей. При этом итоговые метрики на тестовых задачах демонстрируют лишь общее падение качества, не раскрывая первопричину сбоя. Каждое изменение требует изолированного мониторинга: сопоставления с породившими его данными и оценки эффективности как на новых, так и на исторических задачах. Сюда же относится проблема Library Drift, при которой разрастающаяся библиотека навыков ухудшает релевантность поиска и тормодит прогресс еще до того, как это фиксируют метрики оценки, причем чрезмерно агрессивная очистка архива наносит еще больший ущерб.
На L5 необходимо идентифицировать измененный артефакт, зафиксировать спровоцировавшие его данные и подтвердить факт его применения в последующих итерациях. Базовый и модифицированный механизмы тестируются на сопоставимых агентах при равных ресурсных бюджетах, с учетом стоимости оценки самих механизмов. Подобную методологию использует проект HyperAgents, изолирующий способность к генерации агентов от показателей на исходной задаче.
Рост целевых метрик сам по себе не доказывает реструктуризацию и повторное применение улучшающего механизма — подобная верификация обязательна для любого уровня, предполагающего самомодификацию системы. Разработка программного обеспечения служит наиболее наглядной иллюстрацией этого процесса, так как здесь весь жизненный цикл прозрачен.

Что меняется при переходе к полноценному RSI
Ни на одном из уровней автономии искусственный интеллект не получает миссию, границы безопасности, независимый мандат на оценку или право финального вето при критических релизах. Даже на L5, в условиях пересмотра стратегии исследований, изменение операционных приоритетов не означает передачи контроля над базовой миссией. Роль человека смещается от ручного отбора каждой правки и каждого эксперимента к проектированию концептуальных рамки, внутри которых система осуществляет поиск и валидацию. Это порождает целый спектр новых инженерно-технических задач.
Процесс начинается с диагностики: единичный сбой редко указывает на конкретный компонент, требующий вмешательства. Ошибочный результат может быть следствием некачественных данных, недостатка контекста, ограничений интерфейса, изъянов базовой модели или погрешностей оценщика. Показательный пример зафиксирован в практике Humanlaya: утилита извлечения данных не справилась с трехстраничным сканированным PDF-документом, и верифицирующий агент классифицировал вложение как невалидное. Инженеры скорректировали логику принятия решений верификатора для подобных ситуаций. В результате четырех последовательных обновлений доля критически дефектных пакетов сократилась с 9,0% до 3,7%, а среднее время ручной обработки упало с 48 до 27 минут на задачу. При параллельной адаптации нескольких компонентов модификация одного может нарушить базовые допущения другого. Следовательно, диагностику необходимо трансформировать в проверяемые гипотезы, замораживать стабильные модули и вести детальный учет зависимостей. Ситуация с обучающими сигналами аналогична уровню L3: валидность опыта, его оптимальная сложность и полезность для обучения не гарантируют друг друга.
Что делать с накопленным массивом состояний? Простое сохранение информации не гарантирует, что последующие агенты смогут ею воспользоваться. Необходимый навык может остаться невостребованным либо примениться некорректно. Кроме того, разрастающаяся библиотека порождает эффект Library Drift, снижая эффективность поиска. Любопытная деталь: способность генерировать полезные обновления практически не коррелирует с мощностью базовой модели. В то же время способность эффективно утилизировать обновленную обвязку зависит от нее нелинейно. Инвестировать ресурсы имеет смысл в развитие базовых компетенций агента по решению задач, а не в производительность систем, генерирующих эти обновления. Поскольку навык, полезный одному агенту, может не подойти другому, каждый артефакт должен сопровождаться метаданными: условиями применимости, зависимостями и зафиксированным эффектом.
Методологии валидации таких артефактов существенно различаются по предметным областям. В сфере разработки ПО проверка оперативна, но условна, так как тесты подтверждают лишь соответствие спецификациям. В здравоохранении результаты проявляются с задержкой и зависят от множества внешних факторов. В физическом мире или клинической практике откат программного чекпоинта не способен исправить реальные последствия, поэтому валидация должна проводиться исключительно до релиза.
Наиболее сложным аспектом остается доверие к эволюции самого механизма. На L5 более мощный решатель способен вскрыть уязвимости оценщика, однако замена самого оценщика делает метрики несравнимыми либо стимулирует систему к манипуляциям. Решением здесь выступает разделение редактируемых внутренних каналов обратной связи и независимо поддерживаемых критериев приемки, а также сохранение логов, связывающих каждую модификацию механизма с последующими решениями. Возникают и открытые вопросы: как сохранять независимость оценки при многократном адаптивном доступе, как выявлять скоординированные ошибки генератора и оценщика, и как откатывать деструктивные изменения механизма без потери полезного эмпирического опыта?
Отдельным вызовом стоят требования к долгосрочному тестированию, вычислительным ресурсам и инфраструктуре. Базовую и обновленную версии необходимо сопоставлять при равных суммарных бюджетах, учитывая затраты на разработку и оценку самих механизмов, а также публиковать полные траектории вместе с отклоненными обновлениями и регрессиями. Высокая скорость работы ядра или продолжительные автономные прогоны могут маскировать скрытые издержки на генерацию и валидацию кандидатов, поддержку инфраструктурного окружения и аудит.
Доказательство подлинности RSI кроется не в единичных успешных кейсах, а в регулярных структурных сдвигах внутри самого механизма генерации улучшений — таких изменениях, происхождение которых прозрачно, а эффективность подтверждена как на исходных, так и на принципиально новых задачах.
Глобальная цель рекурсивного самоулучшения заключается в том, чтобы каждое последующее поколение искусственного интеллекта повышало надежность, эффективность и инновационность будущих оптимизаций. Однако для верификации этого процесса на практике, а не в лабораторных условиях, необходим строгий долгосрочный контроль в рамках жестких ресурсных лимитов и при экспертном участии человека.
*Meta признана экстремистской организацией на территории РФ.
Похожие статьи
 От модема до спутника в рюкзаке: эволюция интернета с 1990-х до 2026 года
 Морской отдых и отит: клинический случай из практики отоларинголога
 Деньги вместо совести: как влиять на непослушных ИИ-агентов
 Контейнеры с радиоактивными отходами, сброшенными десятилетия назад в Атлантику, начали протекать
 Эффект Дайсона: почему 79-летний создатель пылесосов превосходит Apple в мастерстве презентаций
 Поиски темной материи
 В октябре человечество потеряет связь с вращением Земли
 Пароль против фразы: как надежно защитить аккаунт в 2026 году