
«Жи-ши пиши»: МГУ и Яндекс представили первый открытый датасет для обучения нейросетей сложным правилам русского языка
Сгенерировано нейросетью Midjourney
Специалисты МГУ совместно с Яндексом представили LORuGEC — первую в открытом доступе коллекцию примеров сложных ошибок русского языка. Параллельно ими был предложен алгоритм, позволяющий обучить ИИ корректировать грамматические, пунктуационные и орфографические погрешности в генерируемых текстах. Об этих достижениях Яндекс рассказал на Конгрессе молодых ученых.
Датасет и метод обучения опубликованы в свободном доступе, что даёт возможность исследователям и разработчикам применять их, например, для создания образовательных продуктов для школьников и студентов.
По словам представителей Яндекса:
Крупные языковые модели уже генерируют тексты на высоком уровне, однако они нередко допускают ошибки в грамматике, пунктуации и орфографии русского языка. Причина в том, что в открытых обучающих выборках почти отсутствуют образцы, иллюстрирующие сложные правила.
Коллекция МГУ и Яндекса содержит 48 норм русского языка, в том числе те, которые оцениваются на ЕГЭ и олимпиадах. Она включает примеры неверно расставленной пунктуации в сложноподчинённых конструкциях, ошибки при слитном и раздельном написании слов с «не», а также нарушения согласования подлежащего и сказуемого в сложных предложениях. Всего в LORuGEC собрано почти тысяча предложений, каждое соответствующее конкретному языковому правилу.
Для того чтобы обучить нейросеть исправлять сложные ошибки без полного дообучения на новом датасете, авторы представили метод Retrieval-Augmented Generation («генерация с поисковой поддержкой»). Доработанная модель GECTOR извлекает из LORuGEC фразы с аналогичными ошибками и передаёт их крупной языковой модели. К примеру, если в исходном предложении отсутствует запятая перед «что», система найдёт пример с точно такой же оплошностью, а не любое другое пунктуационное нарушение. Такой приём позволяет корректировать только проблемный фрагмент, не затрагивая остальной текст.
Яндекс проверил эффективность метода на своих моделях YandexGPT 5 Lite и YandexGPT 5 Pro, а также на зарубежных решениях. Эксперименты продемонстрировали рост точности корректировки сложных ошибок на 5–10% по метрике F0,5 — международному стандарту оценки грамматической коррекции. В результате YandexGPT 5 Pro достиг 83% точности, а YandexGPT 5 Lite — 71%.
Источник: iXBT
Похожие статьи
 Китайский госоператор China Telecom уличили в использовании запрещённых ускорителей Nvidia Blackwell Ultra B300
 Компактная зарядка Anker на 100 Вт получила дисплей и бережёт аккумуляторы смартфонов и ноутбуков — цена устройства составила $60
 Google без разрешений уничтожила сотни гектаров леса в Финляндии под свой дата-центр, и теперь волки стали заходить в окрестные деревни
 Yandex Cloud развернул новую площадку и вернул доступ к 90,47% данных
 Какие смартфоны Samsung получат One UI 9: появился официальный перечень
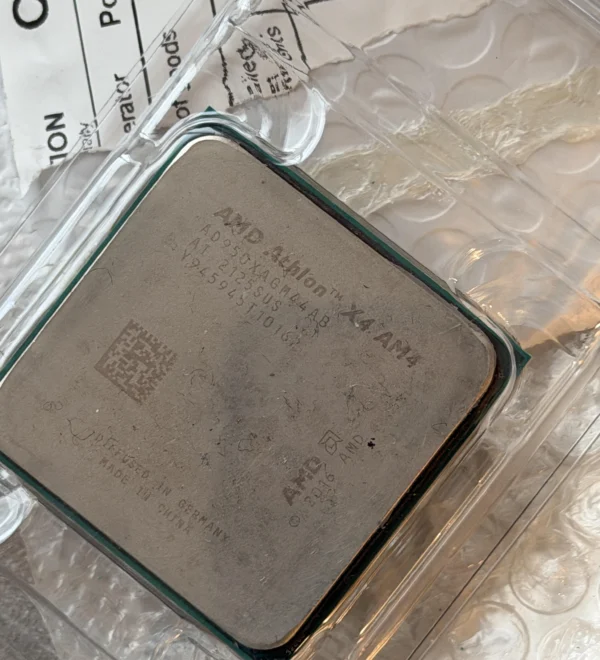 Заказал на AliExpress Ryzen 9 5950X, а в посылке оказался старый Athlon X4
 Впервые в истории человек заразился вирусом, разработанным искусственным интеллектом
 Всплеск спроса на вокзальный Wi-Fi в России: за девять месяцев пользователи загрузили свыше 5,4 тыс. ТБ данных