Запускаем у себя аналоги ChatGPT и Claude: пять открытых нейросетей для видеокарт на 8–32 ГБ
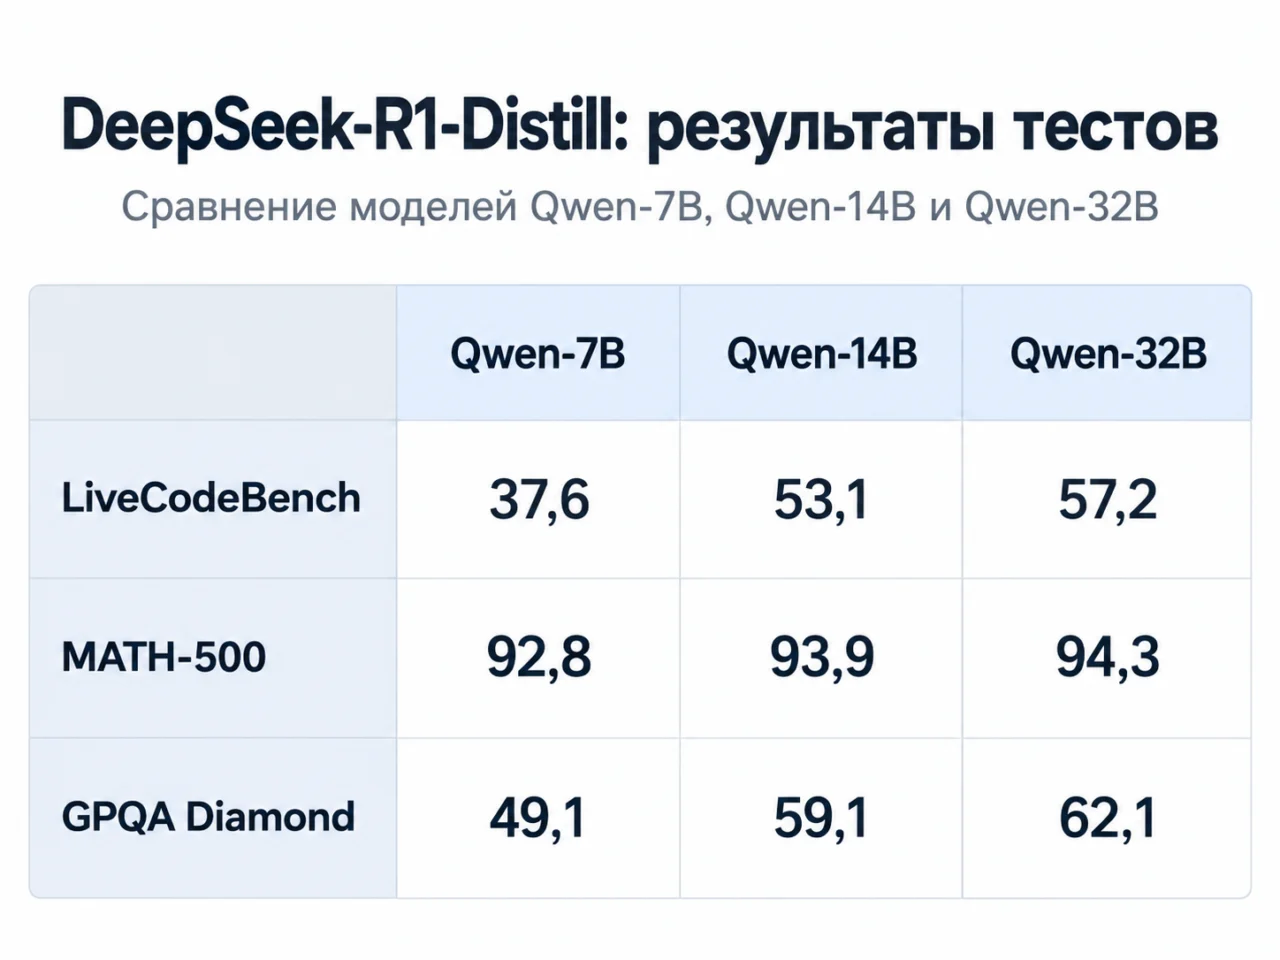
LiveCodeBench проверяет решение задач по программированию, MATH-500 — сложных математических задач, а GPQA Diamond — вопросов уровня аспирантуры по естественным наукам
В сентябре вышла новая волна более производительных моделей: Claude Fable 5.1, GPT-6 Astra и Gemini 3.8 Flash. Но пользоваться ими всё труднее: лимиты подписок урезают, цены растут (появился даже тариф за 500 долларов в месяц), а аккаунты нередко блокируют без предупреждения.
Выход — открытые модели, которые можно запустить на собственном оборудовании или на арендованном сервере. Некоторым из них хватит обычной RTX с 8–12 ГБ видеопамяти, а более крупным понадобится GPU с 24–32 ГБ. Мы отобрали несколько таких моделей, в том числе новинки последних месяцев, и разобрались, на что они способны и какие задачи им по силам.
DeepSeek: свежая V4.1 Flash и более доступные дистилляты R1-Distill
В сентябре DeepSeek выпустила V4.1 Flash — мультимодальную MoE-модель, которая понимает текст и изображения и работает с контекстом до 1 млн токенов. Её общий объём составляет 552 млрд параметров, но на каждый запрос активируется лишь часть: 8 млрд при чтении входных данных и 16 млрд при генерации ответа.
Для локального запуска на более скромном железе у DeepSeek есть отдельное семейство — R1-Distill. Это самостоятельные модели на основе Qwen2.5 и Llama 3, дообученные на данных, которые сгенерировала DeepSeek-R1. Компания предлагает версии на 1,5, 7, 8, 14, 32 и 70 млрд параметров; если у вас 8–32 ГБ VRAM, наибольший интерес представляют модели от 7B до 32B.
Квантование заметно снижает требования к памяти. Например, в формате Q4_K_M:
-
DeepSeek-R1-Distill-Llama-8B — 4,92 ГБ
-
DeepSeek-R1-Distill-Qwen-14B — 8,99 ГБ
-
DeepSeek-R1-Distill-Qwen-32B — 19,85 ГБ
Это лишь размер весов: ещё часть памяти уйдёт на KV-кэш, контекст и сам движок инференса. Поэтому 8B можно запускать на RTX с 8 ГБ, для 14B стоит рассчитывать минимум на 12 ГБ, а для 32B — на 24–32 ГБ.
Чем крупнее модель, тем выше её качество. В официальных тестах DeepSeek версии Qwen-7B, Qwen-14B и Qwen-32B показали следующие результаты:
Для бизнеса выбор определяется характером нагрузки и доступным оборудованием. Версии на 7–8B годятся для локальных помощников, работы с текстом и несложного кода. Модель на 14B заметно сильнее в программировании и рассуждениях, но по-прежнему умещается на одной потребительской видеокарте. Версия на 32B требует 24–32 ГБ памяти, зато лучше справляется со сложным анализом и генерацией кода.
Новая V4.1 Flash — вершина линейки DeepSeek, однако для одной RTX или одного облачного GPU из нашего диапазона она слишком громоздка. Для локального использования практичнее R1-Distill: размер модели можно подогнать под имеющуюся видеопамять и обходиться без внешнего API.
Qwen3.8-27B: универсальная модель для сложных рабочих задач
Если DeepSeek на одной видеокарте приходится заменять компактными R1-Distill, то Qwen3.8-27B можно запускать целиком. Это модель на 27 млрд параметров, которая после подходящего квантования помещается в 24 ГБ памяти.
Qwen3.8-27B распространяется по лицензии Apache 2.0 и изначально умеет работать с текстом, изображениями и видео. Разработчики делают ставку на программирование, профессиональные задачи, исследования и длительные агентные сценарии. Нативное контекстное окно — 262 144 токена, с возможностью расширения до 1 млн.
В тестах разработчиков модель демонстрирует сильные результаты на задачах, близких к реальной работе:
|
Тест |
Что проверяет |
Результат |
|
SWE-bench Pro |
Решение задач на реальных программных репозиториях |
61,7 |
|
CoWorkBench |
Длительные рабочие задачи в программировании, финансах, юриспруденции и других сферах |
70,7 |
|
OSWorld-Verified |
Работа с приложениями через интерфейс компьютера |
84,3 |
|
OmniDocBench 1.5 |
Анализ и понимание документов |
91,1 |
Для корпоративного применения особенно показательны SWE-bench Pro и CoWorkBench: первый оценивает работу с реальным кодом, второй — умение выполнять длинные многошаговые задачи. OSWorld дополняет картину проверкой работы с интерфейсами, а OmniDocBench — с документами.
В независимом тесте на RTX 3090 с 24 ГБ VRAM скорость генерации составила около 75 токенов/с при контексте порядка тысячи токенов и упала примерно до 43 токенов/с, когда контекст заполнился до 90 тыс.
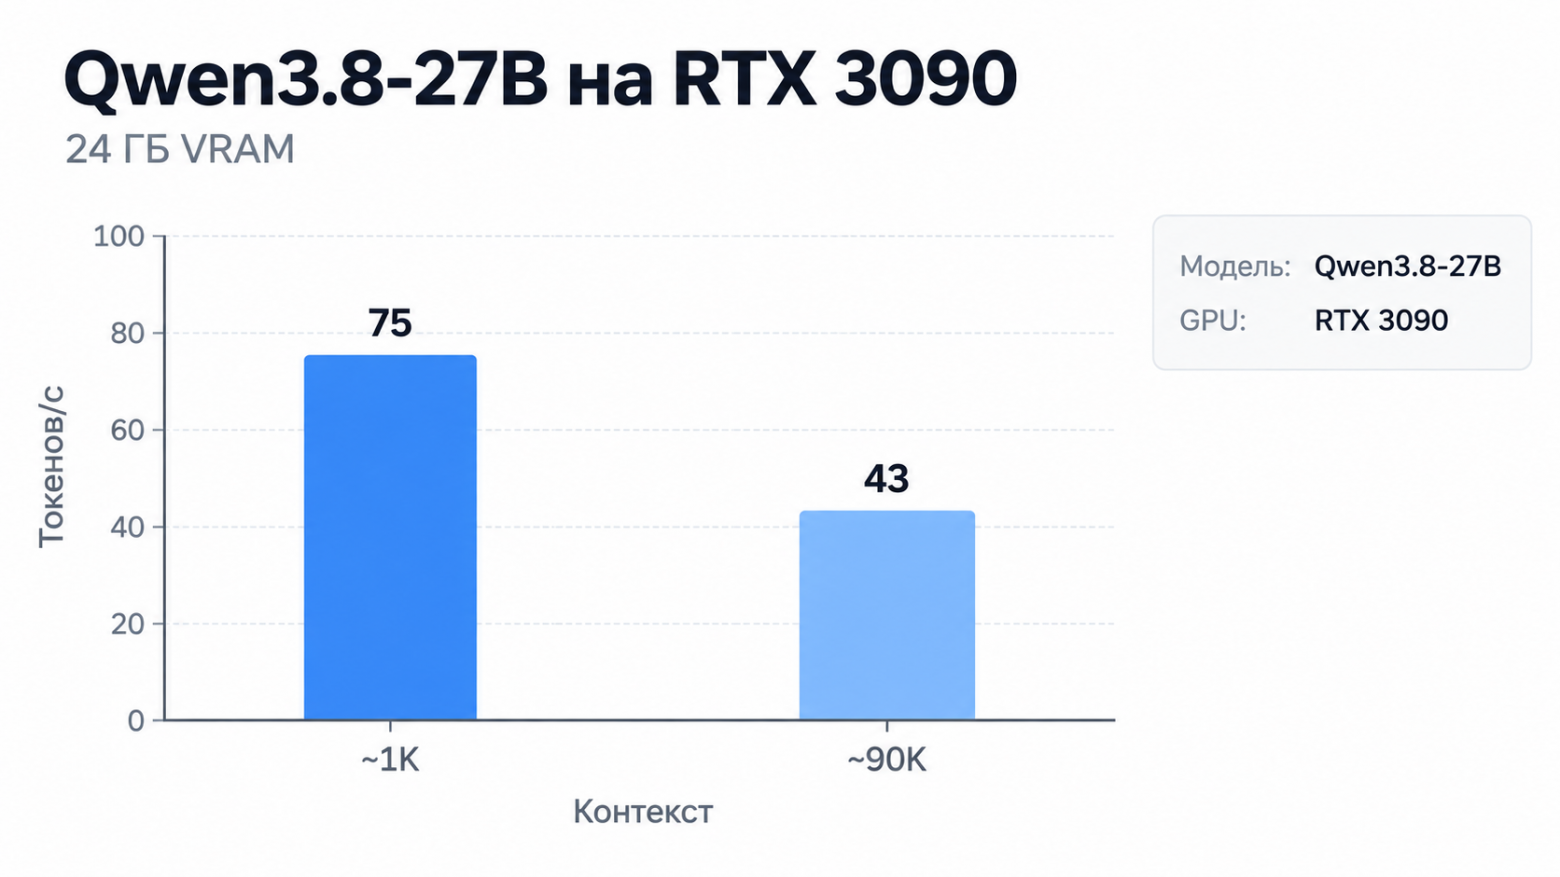
Точные цифры зависят от квантования, движка инференса и его настроек, но сама закономерность очевидна: чем длиннее контекст, тем больше памяти занимает KV-кэш и тем медленнее обрабатывается запрос.
На практике 24 ГБ VRAM позволяют применять Qwen3.8-27B для программирования, анализа документов, корпоративных ассистентов и агентных задач. Но запас памяти здесь критичен: длинный контекст оставляет меньше места под KV-кэш, а несколько параллельных запросов быстро наращивают потребление ресурсов. На GPU с 32 ГБ и более работать будет комфортнее, если такая возможность есть. Однако в этой статье мы рассматриваем, как «уместить» модели на более доступные карты — как для собственной инфраструктуры, так и для аренды.
Qwen3.8-27B даёт заметно больше, чем компактные модели на 7–14 млрд параметров, но и поднимает минимальную планку по железу примерно до 24 ГБ. Если нужно уложиться в 12–16 ГБ, придётся выбирать модели поменьше.
В mClouds можно арендовать серверы с видеокартами NVIDIA L4 24GB, NVIDIA L40S 48GB и RTX 6000 PRO 96GB.
Qwen3.8-27B нуждается примерно в 24 ГБ видеопамяти, а Gemma 4 12B-it снижает порог входа до 16 ГБ VRAM или унифицированной памяти и при этом остаётся мультимодальной. Google выпустила её специально для локального запуска на пользовательском оборудовании. В официальном руководстве Google отдельно отмечено, что модель можно запускать на ноутбуках с дискретной GPU и 16 ГБ памяти.
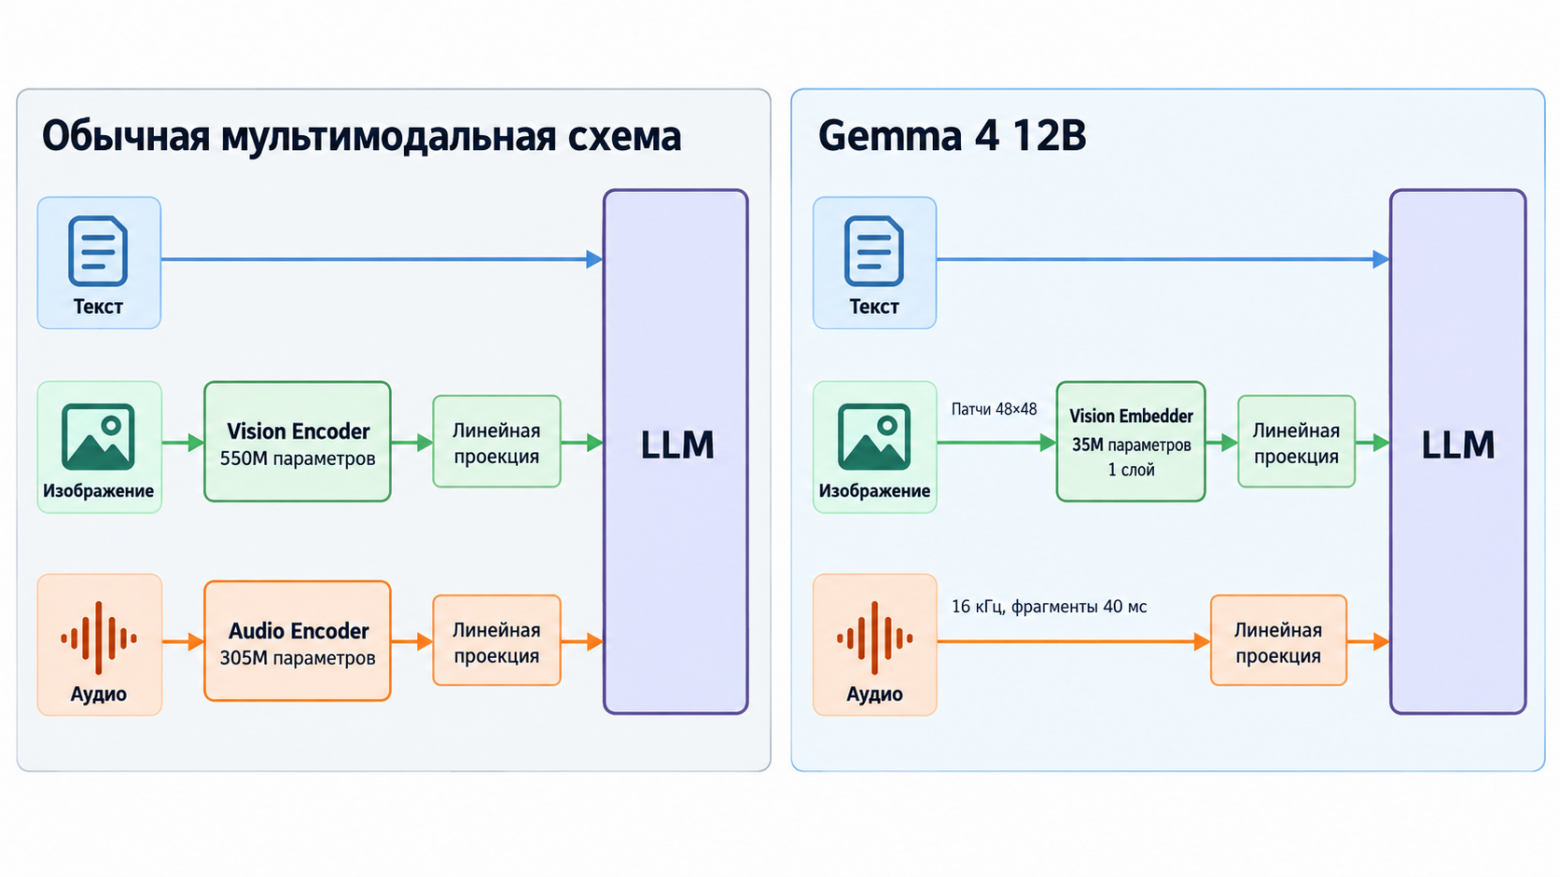
Основные сценарии применения модели:
-
текст и документы — ответы на вопросы, суммаризация, RAG;
-
изображения и видео — анализ визуального содержимого в связке с текстовым запросом;
-
аудио — распознавание речи и работа со звуковыми данными;
-
код и агенты — программирование и многошаговые сценарии с внешними инструментами.
Для локального инференса поддерживаются популярные инструменты, такие как llama.cpp, vLLM, SGLang и Transformers. Кроме того, модель можно развернуть в виде локального API, совместимого с OpenAI.
С семейством Gemma мы уже имели дело на практике. В августе мы протестировали Gemma 4 E4B и Qwen3.5-9B в локальной RAG-системе на NVIDIA L4 с 24 ГБ VRAM. Основу стека составили vLLM и Open WebUI, а модели отвечали на русскоязычные вопросы по подключённой базе знаний.
Результаты получились такими:
|
Модель в тесте mClouds |
Скорость генерации |
Размер модели в VRAM |
|
Gemma 4 E4B |
~45 токенов/с |
16 ГБ |
|
Qwen3.5-9B |
~28 токенов/с |
19,3 ГБ |
В этом тесте Gemma отвечала лаконичнее и строже держалась сути вопроса, тогда как Qwen чаще добавляла дополнительные подробности. На небольших базах документов Gemma оказалась быстрее, а Qwen лучше подходила для более объёмных и взаимосвязанных наборов данных.
По сравнению с Qwen3.8-27B у Gemma иной профиль: требования к памяти ниже, но при этом она работает с текстом, изображениями и аудио. Поэтому её стоит рассматривать для локальных ассистентов, RAG и сервисов, где одной текстовой модели уже не хватает.
gpt-oss-20B: открытая модель OpenAI для собственной инфраструктуры
Главное достоинство Gemma 4 12B — мультимодальность, а gpt-oss-20b решает иную задачу: это текстовая модель, заточенная под рассуждения, программирование и работу с инструментами, которую OpenAI позволяет разворачивать на собственной инфраструктуре. В ChatGPT её нет, и через OpenAI API она не доступна — веса можно скачать и использовать самостоятельно.
В gpt-oss-20b применена архитектура MoE: общий объём модели — 20,9 млрд параметров, но на каждый токен задействуется около 3,6 млрд. Благодаря этому вычислительная нагрузка ниже, чем у плотной модели того же размера.
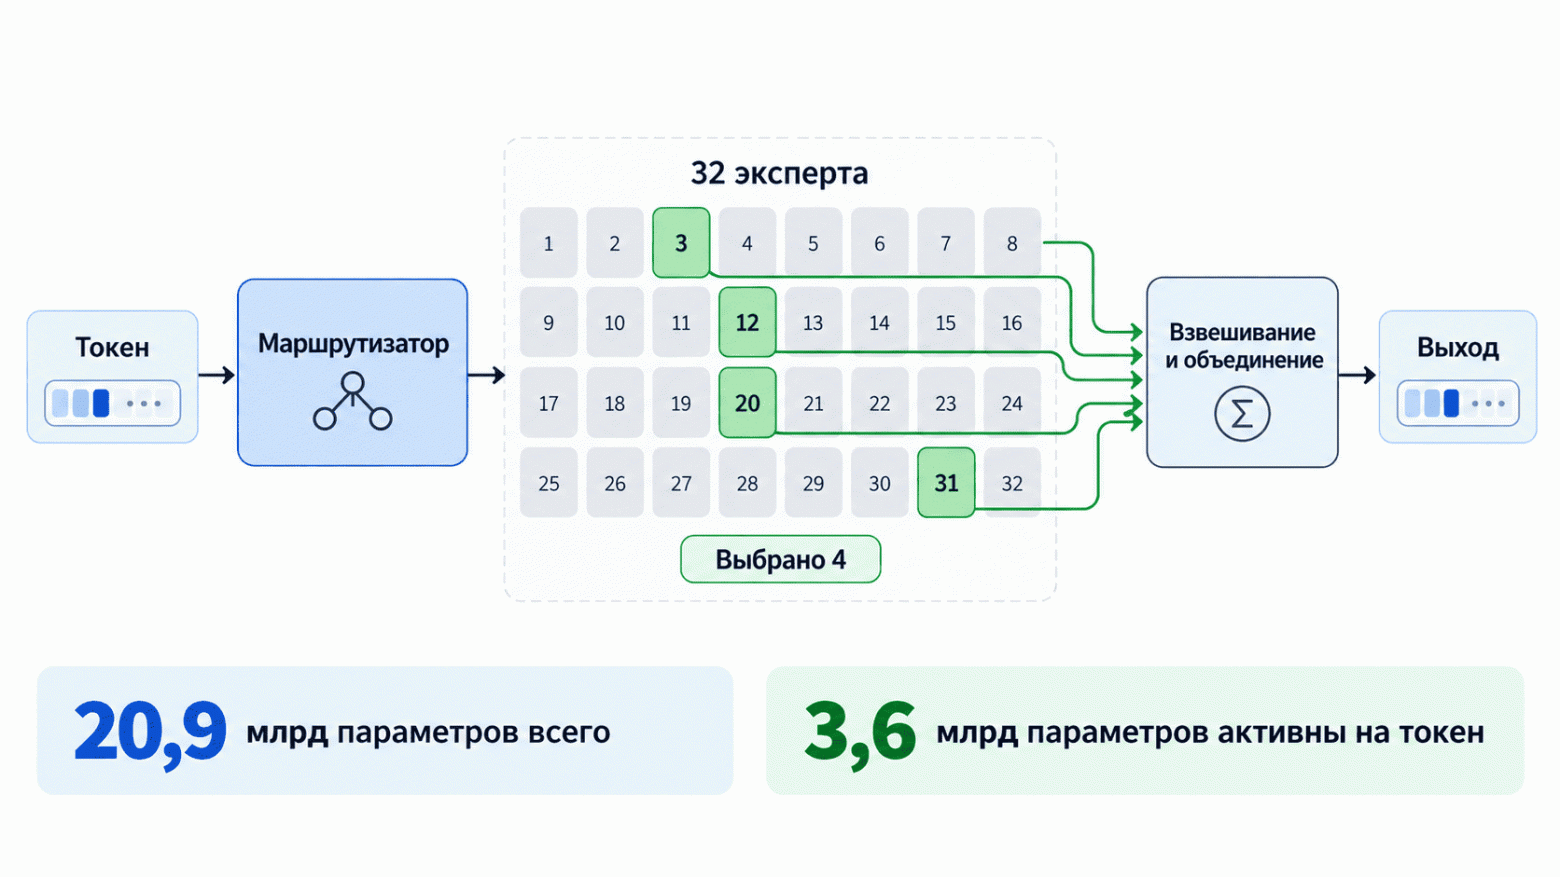
Вот характеристики модели по данным OpenAI:
|
Характеристика |
gpt-oss-20b |
|
Общее число параметров |
20,9 млрд |
|
Параметров, задействованных при обработке одного токена |
3,6 млрд |
|
Всего экспертов в MoE-слоях |
32 |
|
Эксперты, задействованные для одного токена |
4 |
|
Контекстное окно |
128 тыс. токенов |
Обучение шло преимущественно на англоязычных текстах с упором на STEM, программирование и общие знания. По завершении основного этапа OpenAI дополнительно настроила модель на рассуждения и работу с инструментами.
У gpt-oss-20b есть несколько полезных для работы возможностей:
-
три уровня рассуждений — low, medium и high: можно выбирать между скоростью и глубиной анализа;
-
вызов функций и структурированный вывод — для интеграции с внутренними сервисами;
-
работа с инструментами — модель обучена пользоваться поиском и выполнять Python-код;
-
дообучение под собственные задачи — веса открыты, поэтому модель можно адаптировать под корпоративный сценарий.
С требованиями к железу связан важный нюанс. OpenAI указывает для gpt-oss-20b около 16 ГБ VRAM при использовании MXFP4 и считает модель подходящей для одной мощной потребительской видеокарты. Однако в официальном руководстве по запуску уточняется: аппаратная поддержка MXFP4 есть у архитектуры Hopper и более новых, а из потребительских карт — у RTX 50-й серии. В BF16 той же модели уже требуется около 48 ГБ памяти.
Поэтому заявленные 16 ГБ нельзя механически переносить на любую RTX. На картах RTX 50xx модель укладывается в этот объём благодаря MXFP4. На более старых видеокартах требования и скорость будут зависеть от движка и формата весов. Если же в вашем распоряжении 24–32 ГБ, запас даст больше свободы для контекста и параллельных запросов.
В отличие от Gemma, gpt-oss-20b не умеет работать с изображениями и аудио. Её сильная сторона — текстовые задачи, где важны рассуждения и инструменты: программирование, внутренние помощники, автоматизация цепочек действий и обработка документов. При этом модель остаётся внутри инфраструктуры компании, а для самого инференса обращаться к внешнему API не нужно.
MiMo-V2.6-Distill-Qwen-9B: компактный ИИ для кода и работы с инструментами
Модели gpt-oss-20b уже нужно около 16 ГБ памяти в подходящем формате. Если же требуется уместиться в более распространённые RTX на 8–12 ГБ, стоит присмотреться к MiMo-V2.6-Distill-Qwen-9B от Xiaomi. Это 9B-модель на основе Qwen3.5-9B, дополнительно обученная на данных MiMo для программирования и агентных задач. Она рассчитана на код, работу с инструментами, визуальное программирование и задачи кибербезопасности.
Главное отличие от исходной Qwen3.5-9B хорошо видно по тестам Xiaomi:
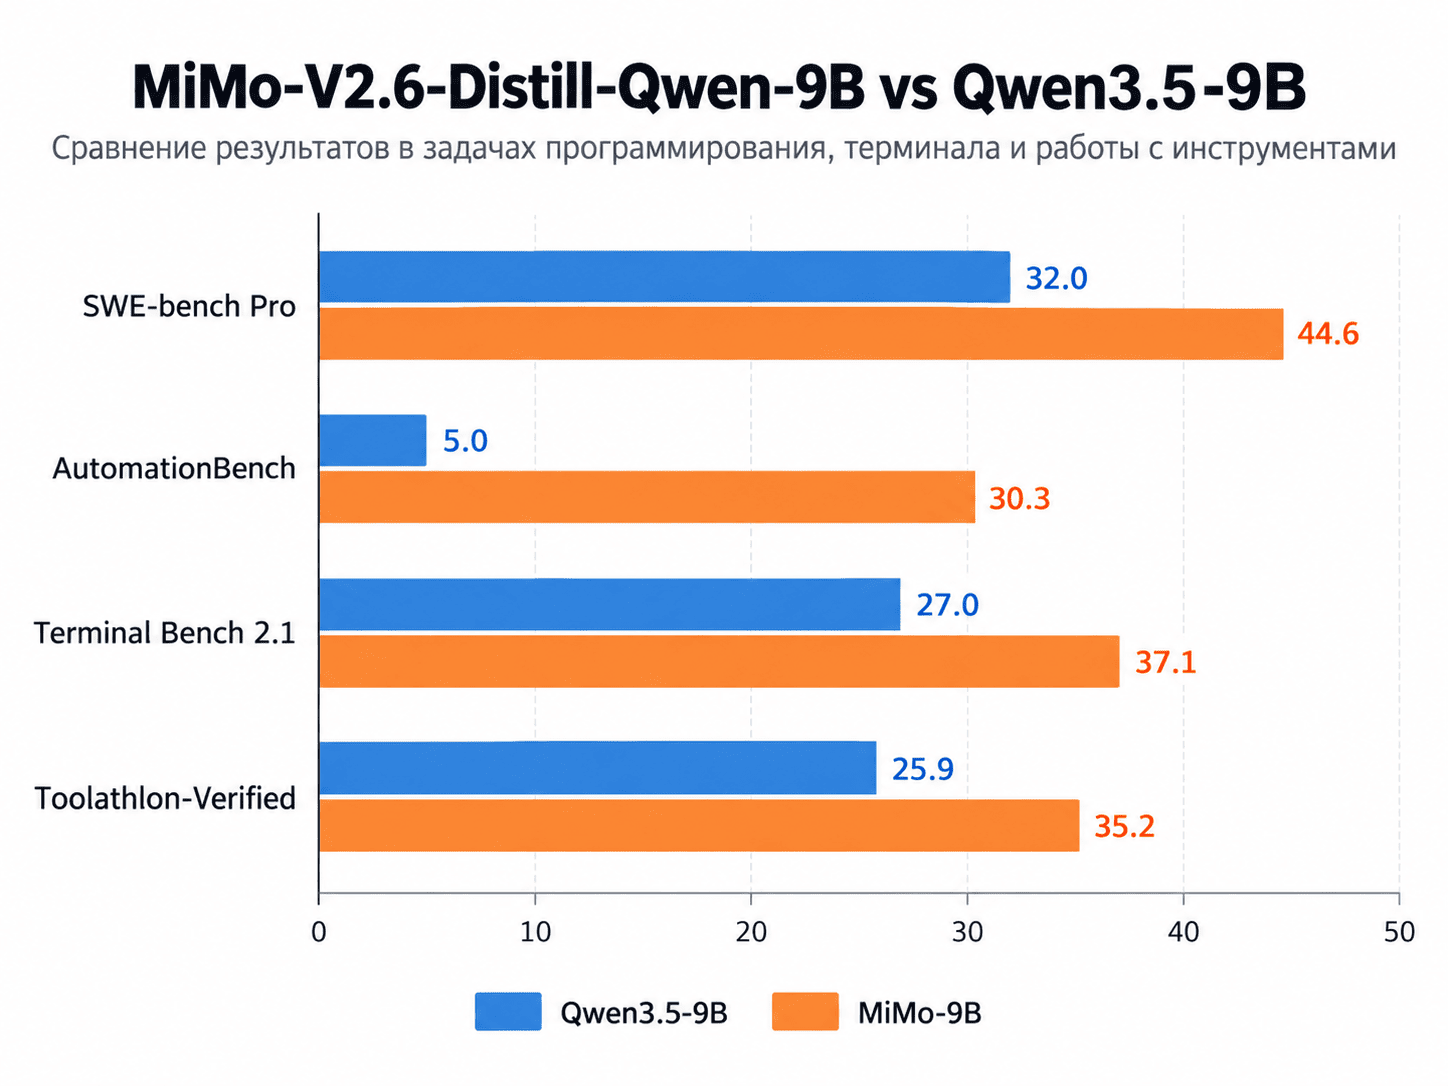
SWE-bench Pro оценивает работу с реальными программными репозиториями, AutomationBench — выполнение последовательностей действий, Terminal Bench — работу через терминал, а Toolathlon — использование внешних инструментов. Иными словами, основной прирост пришёлся именно на те сценарии, под которые MiMo и дообучали.
По требованиям к железу эта модель заметно доступнее, чем gpt-oss-20b. Полные веса в BF16 занимают около 17,9 ГБ, а в квантовании Q4_K_M — 5,84 ГБ. Благодаря этому даже на GPU с 8–12 ГБ остаётся место под KV-кэш и контекст.
Есть и практический замер на карте с 12 ГБ. При запуске версии Q6_K модель MiMo занимала около 7,6 ГБ VRAM при контексте 16K и 9,2 ГБ при 64K, а скорость генерации на коротком запросе достигла 91,8 токена/с. Таким образом, 12 ГБ позволяют целиком держать модель на GPU и оставляют некоторый запас под длинный контекст.
В рабочих задачах MiMo полезна прежде всего там, где недостаточно просто текстового ответа: написать или исправить код, выполнить команды в терминале, вызвать инструмент и пройти последовательность действий. При этом Xiaomi публикует именно SFT-чекпойнт и называет его отправной точкой для исследований в области агентного reinforcement learning, а не готовой корпоративной системой. Поэтому надёжность цепочек из нескольких действий стоит отдельно проверять на собственных сценариях.
MiMo закрывает нижнюю часть нашего диапазона по железу: агентную модель для кода и инструментов уже можно запускать на RTX с 8–12 ГБ, не переходя на 16–24 ГБ, необходимые более крупным моделям.
Подведём итоги: как выбрать модель под свою задачу
На видеокартах с 8–12 ГБ VRAM уже можно запускать модели для кода, рассуждений и агентных сценариев. 16 ГБ открывают доступ к Gemma 4 12B-it и gpt-oss-20b, а с 24–32 ГБ можно переходить к Qwen3.8-27B и старшим версиям DeepSeek-R1-Distill.
|
Модель |
GPU/VRAM |
Основные задачи |
Что учитывать |
|
DeepSeek-R1-Distill |
8–32 ГБ, в зависимости от версии |
Тексты, код, рассуждения |
Размер (7B, 14B или 32B) можно подобрать под имеющееся железо; качество заметно растёт с увеличением модели |
|
Qwen3.8-27B |
24–32 ГБ |
Код, документы, мультимодальные задачи |
Длинный контекст существенно увеличивает расход памяти и снижает скорость |
|
Gemma 4 12B-it |
От 16 ГБ |
Мультимодальные задачи, ассистенты, документы |
Мультимодальность при сравнительно умеренных требованиях к памяти |
|
gpt-oss-20b |
Около 16–32 ГБ в зависимости от GPU и формата |
Рассуждения, код, инструменты |
16 ГБ достижимы с MXFP4 на совместимом оборудовании; на старых RTX требования могут быть выше |
|
MiMo-9B |
8–12 ГБ |
Код и агентные задачи |
Компактная модель, заметно превосходящая исходную Qwen3.5-9B в агентных сценариях |
Безусловного лидера здесь нет. MiMo-9B и младшие R1-Distill подойдут для одной массовой RTX и задач, где важны скромные требования к железу. Gemma 4 12B-it лучше раскрывается в RAG и мультимодальных сценариях. gpt-oss-20b нацелена на рассуждения, программирование и работу с инструментами. Qwen3.8-27B требует уже 24–32 ГБ VRAM, зато лучше справляется со сложным кодом, документами и длинными многошаговыми задачами.
Впрочем, собственный запуск не делает ИИ бесплатным. Плату за токены сменяют расходы на GPU, хранение моделей и поддержку инференса. Зато данные остаются внутри вашей инфраструктуры, а работа модели не зависит ни от лимитов подписки, ни от смены тарифов, ни от доступности внешнего сервиса. Особенно выгоден такой подход при постоянной нагрузке и работе с внутренними документами.
Своя линейка открытых моделей развивается и в России. 21 сентября Яндекс представил AliceAI-Foundation-80B-A3B-Base — MoE-модель на 80 млрд параметров, из которых на каждый токен активируются 3 млрд. Она ориентирована в том числе на русский язык, программирование и задачи с рассуждениями.
Пока это базовая модель, а не готовый чат-ассистент. Яндекс рассматривает её как основу для экспериментов с будущей единой рассуждающей моделью, которая получит и агентные возможности. Сроки публичного релиза не объявлены, поэтому обещать конкретную новинку до конца года пока рано.
Расскажите, какие модели вы уже запускали у себя?
Похожие статьи
 iPhone Duo поборолся за лидерство с Samsung Galaxy Z Fold8, Huawei Pura X Max и Xiaomi 18 Fold
 Россиянам могут отказать в оформлении загранпаспорта из-за фотографий, обработанных нейросетью
 2K, 185 Гц, 10 100 мА·ч, 200 Мп и IP69K: показан Honor Win 2 Delta Force
 Смартфон Vivo Y600 готовится к выходу: аккумулятор на 10 000 мА·ч выдержал более 32 часов работы и попал в Книгу рекордов Гиннесса
 Huawei Lucia выйдет с 50-мегапиксельной камерой на дюймовом сенсоре RYYB и 6,8-дюймовым дисплеем
 Полвека берегу каталог Altair 1975 года: собранный компьютер тогда стоил как подержанный автомобиль
 Российская орбитальная станция получит принципиально иную систему управления, чем МКС: раскрыта новая схема контроля
 ИИ по-прежнему плохо подделывает живое общение, особенно когда дело доходит до эмоций