Запуск Kimi K3 на локальной инфраструктуре Cerebras: пошаговое руководство
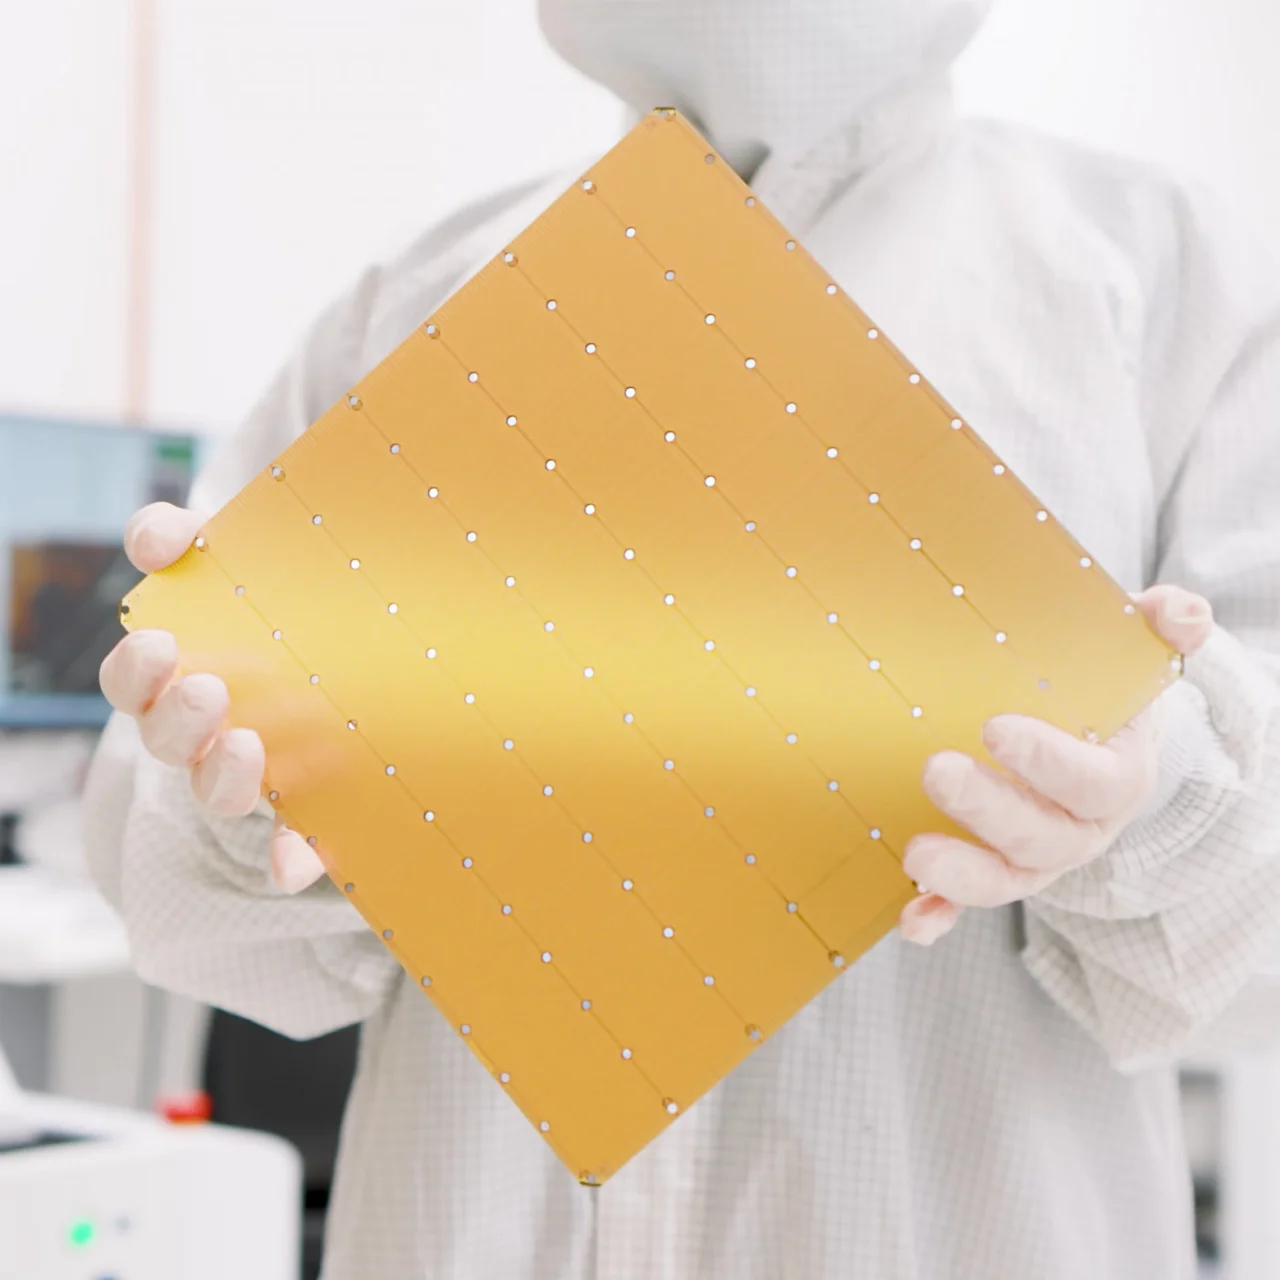
Нас чаще всего спрашивают, как мы запускаем крупные модели на чипах Cerebras, каждый из которых по размеру равен целой кремниевой пластине. На одной пластине Cerebras WSE-3T умещается 44 ГБ встроенной памяти, а передовым моделям с триллионами параметров только для хранения весов требуются терабайты.
В этой статье мы расскажем, как распределяем крупную модель между несколькими пластинами WSE-3T. Такая схема позволяет запускать модели с несколькими триллионами параметров на скорости от 1000–2000 токенов в секунду и выше.
Для наглядности возьмём открытую модель Kimi K3, насчитывающую около 3 трлн параметров.
Прочитав статью, вы поймёте:
-
как вся модель целиком помещается во встроенную память чипов;
-
как она распределяется между несколькими чипами;
-
как система справляется с большим числом одновременных запросов.
Разбор на примере Kimi K3
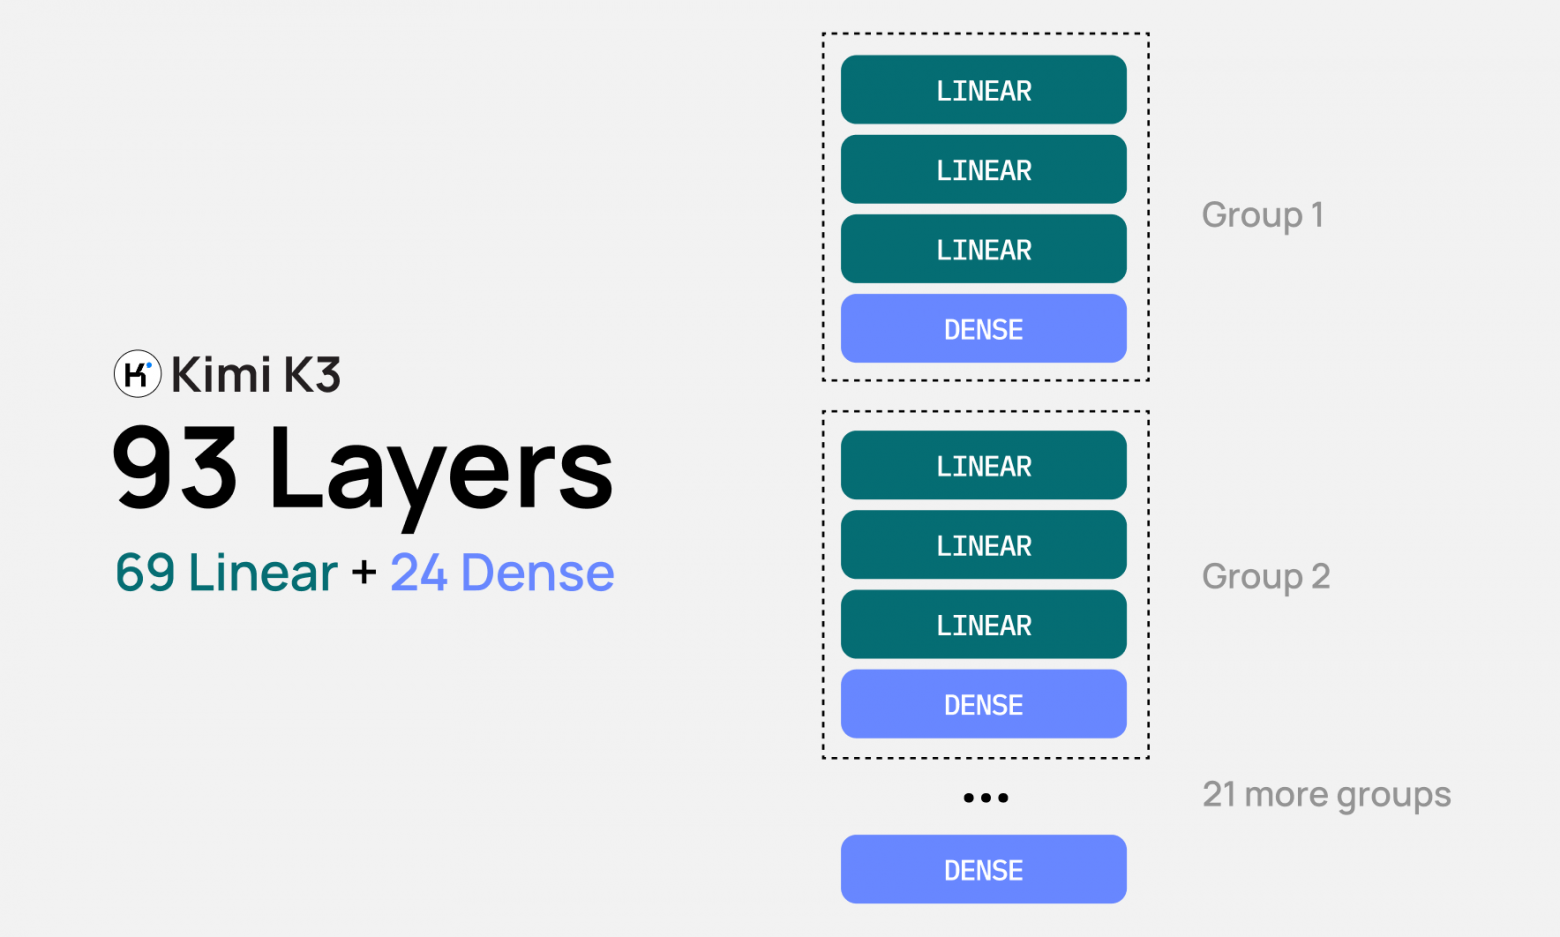
Kimi K3 — открытая модель на 3 трлн параметров, в архитектуре которой 69 слоёв линейного внимания и 24 слоя полного внимания.
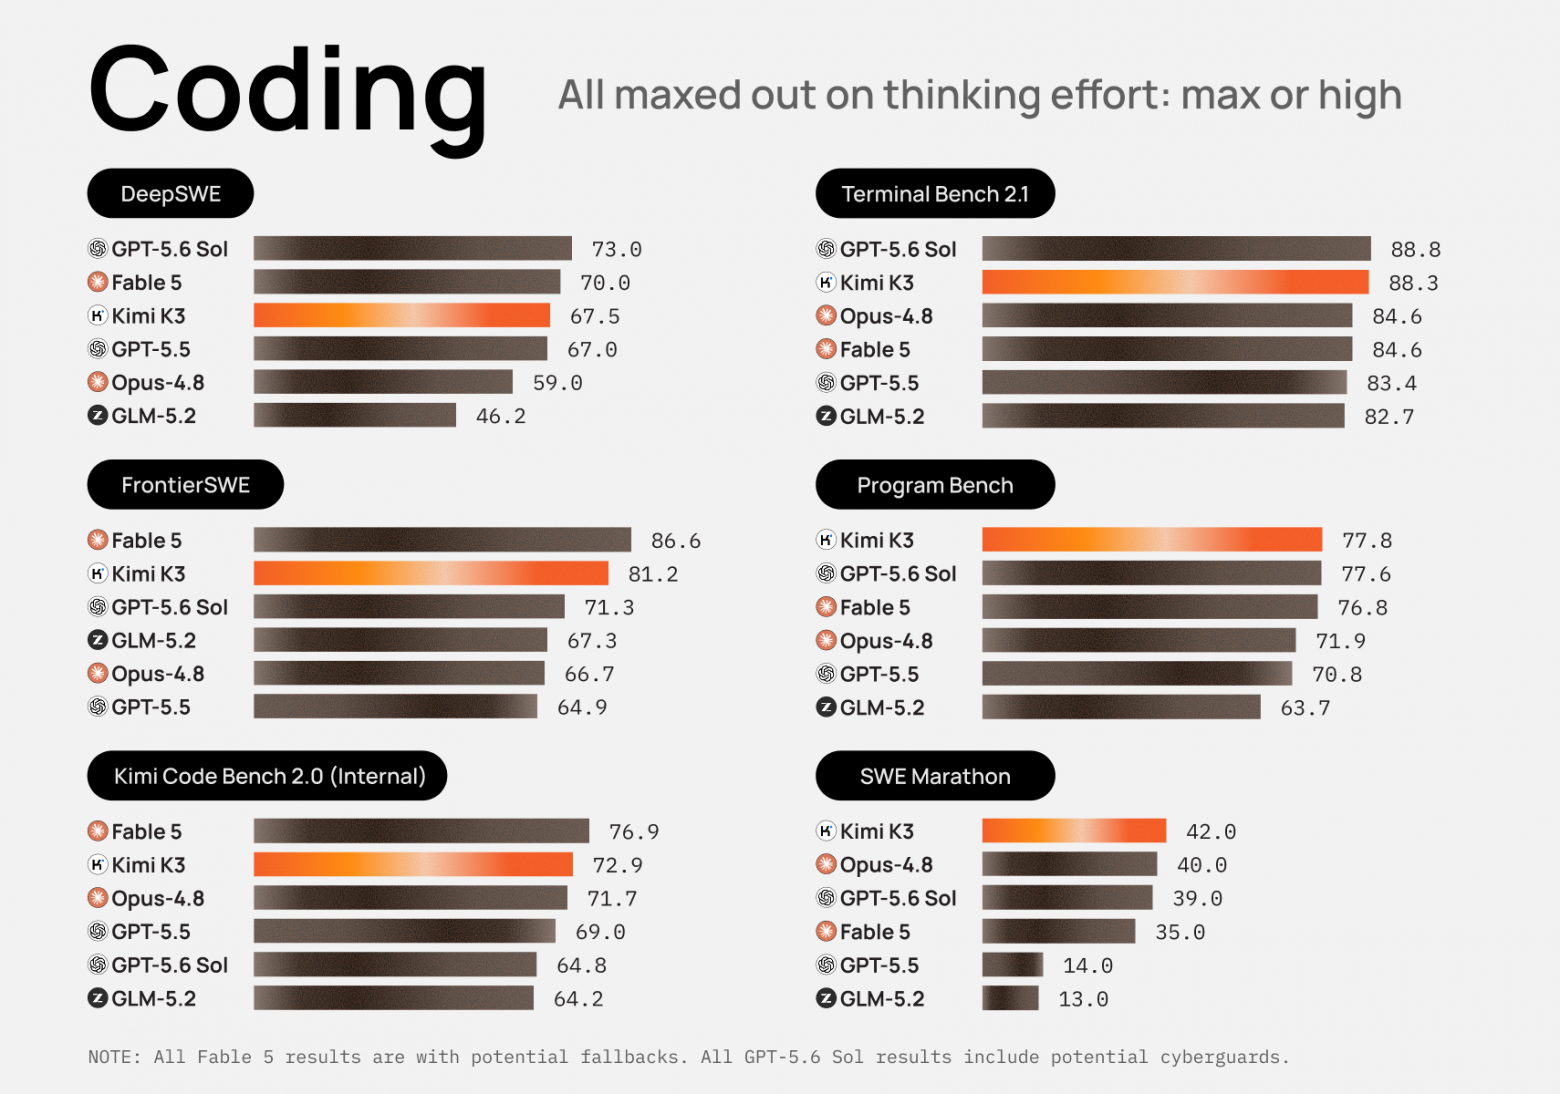
Результаты модели впечатляют: 88,3% в Terminal-Bench 2.1 против 88,8% у GPT-5.6 Sol, а в BrowseComp — 91,2% против 90,4% у GPT-5.6 Sol. Эти цифры свидетельствуют о передовом уровне в программировании и решении агентных задач: по ряду бенчмарков модель даже обходит ведущие закрытые решения. Подробнее о Kimi K3 читайте здесь.
В нашем примере мы исходим из таких допущений:
-
средняя длина запроса — 256 тысяч токенов;
-
веса квантизованы до 4 бит, как в версии на Hugging Face;
-
KV-кэш хранится в 8-битном формате.
1. Размер каждого слоя
Чтобы выяснить, сколько пластин Cerebras WSE-3T нужно для запуска Kimi K3, для начала вычислим размер каждого слоя модели.
В Kimi K3 содержится 3 трлн параметров. При хранении каждого в 4-битном формате они займут:
3 трлн параметров × 4 бита ÷ 8 бит на байт = 1,5 ТБПоделим этот объём на 93 слоя:
1500 ГБ ÷ 93 ≈ 16 ГБ на слой2. Количество пластин
Выходит, что каждому слою нужно около 16 ГБ. Теперь можно прикинуть, сколько слоёв уместится на одной пластине с 44 ГБ памяти. Всё зависит от типа слоя.
-
Слоям полного внимания требуется дополнительная память под KV-кэш. Каждый такой слой сохраняет ключи и значения для каждого токена каждого активного запроса. Поэтому на пластине мы размещаем лишь один слой полного внимания, а всю оставшуюся SRAM отдаём под его KV-кэш.
-
Слоям линейного внимания дополнительная память под KV-кэш не нужна. Они не хранят ключи и значения для каждого токена, а ведут для каждого запроса компактное состояние фиксированного размера, не зависящее от длины контекста. Поэтому на одной пластине помещаются два слоя линейного внимания: 2 × 16 ГБ = 32 ГБ.
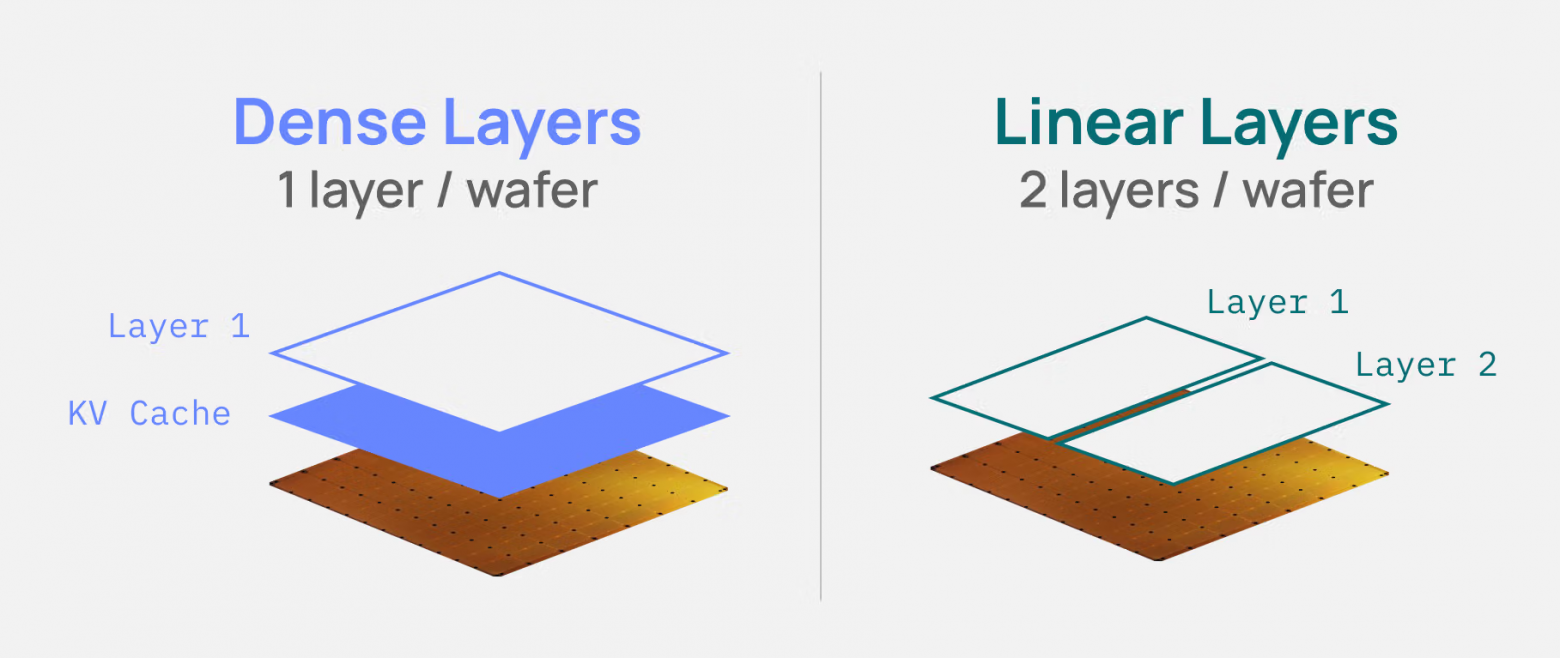
С учётом того, что в Kimi K3 69 слоёв линейного внимания и 24 слоя полного внимания, получаем:
69 слоёв линейного внимания ÷ 2 слоя на пластину,
с округлением вверх = 35 пластин

24 слоя полного внимания ÷ 1 слой на пластину = 24 пластины
В сумме: 35 + 24 = 59 пластин.
Если статья пришлась вам по душе, заглядывайте в канал AI for Devs. Каждый день я публикую там подобные материалы: о моделях, агентах, практических кейсах и новостях мира AI.
3. Объединяем пластины в единую систему
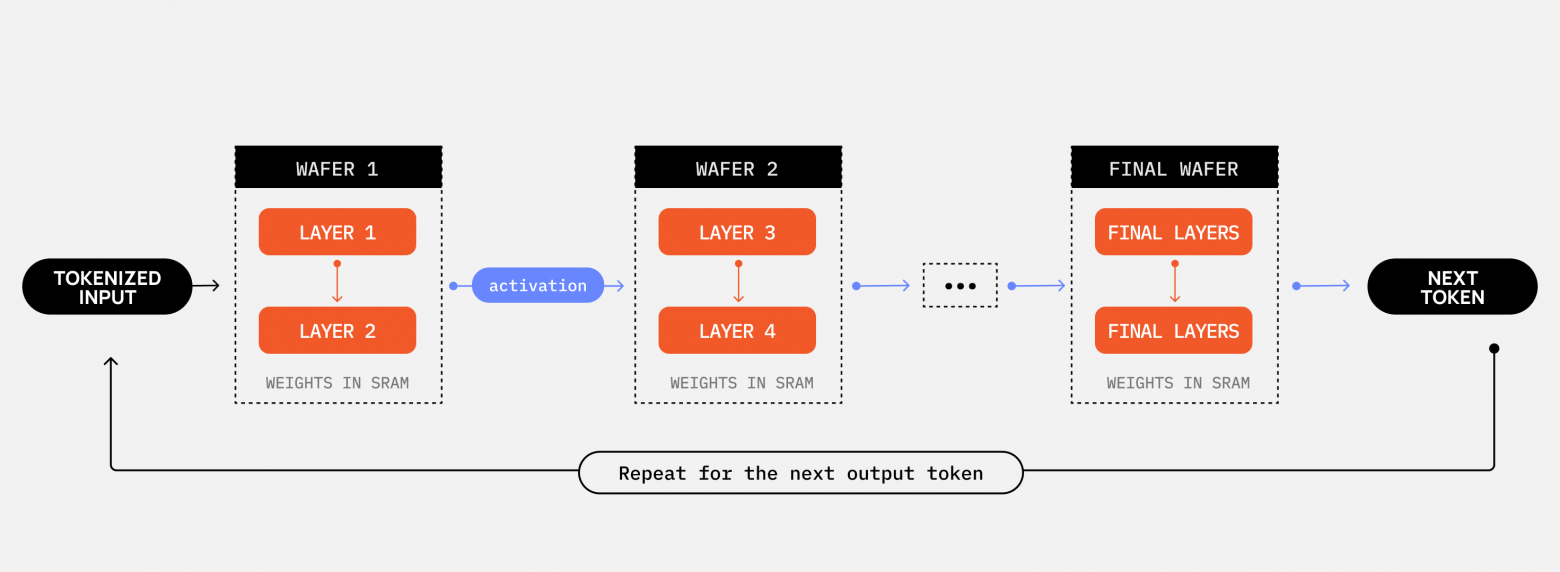
Cerebras организует вычисления модели в виде конвейера. Сначала компилятор Cerebras раскладывает слои модели по областям пластин, а затем среда исполнения прокладывает маршрут, по которому токены проходят от одной области к другой. Чтобы задержка была минимальной, между пластинами передаются лишь активации — для этого подойдёт RDMA поверх Ethernet. Один переход занимает примерно 2 микросекунды.
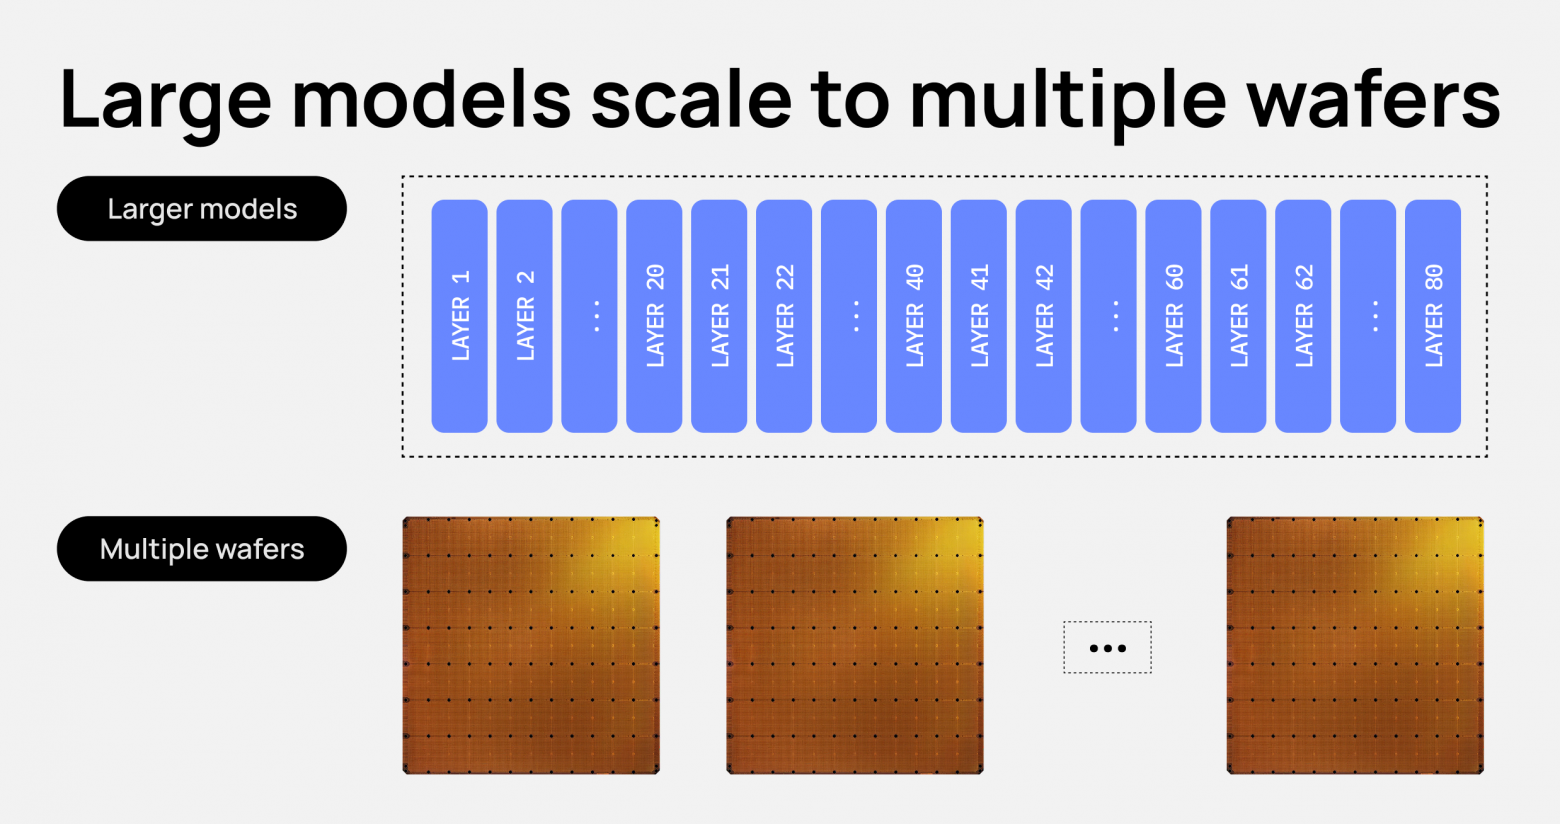
Здесь стоит подчеркнуть: на каждой пластине Cerebras установлено 44 ГБ встроенной SRAM, а слой занимает всего 16 ГБ, поэтому, как правило, слои модели удаётся целиком держать прямо на чипе.
Это значит, что в большинстве случаев веса не нужно перемещать, а сами слои — дробить между пластинами. От одной пластины к другой уходят только активации.
4. Как обрабатывается один запрос
Когда пластины связаны, а модель распределена между ними, каждую пластину удобно представить как отдельный этап сборочного конвейера. Веса на каждом этапе остаются неподвижными, а промежуточные результаты запроса последовательно проходят через все слои.
К примеру, первая пластина считает слои 1–2 и передаёт активации второй. Та обрабатывает слои 3–4 и отправляет результат третьей — и так до тех пор, пока последняя пластина не выдаст следующий токен.
5. Как обрабатывается множество запросов
Тут часто возникает недопонимание. Если токен вынужден по очереди проходить через каждую пластину, не простаивают ли остальные в ожидании? И не получается ли, что система по сути работает с батчем размером в единицу?
Нет! Если бы мы пускали по конвейеру один запрос и дожидались его окончания, прежде чем взяться за следующий, ресурсы использовались бы крайне неэффективно. Поэтому мы непрерывно загружаем конвейер разными запросами. Модель уже поделена на этапы, и каждый из них может одновременно обслуживать свой запрос.
Пока третий этап занят токеном запроса A, второй обрабатывает токен запроса B, а первый — токен запроса C. В нашем примере один этап равен одному слою. В реальной работе Cerebras применяет значительно более мелкие этапы, и их намного больше.
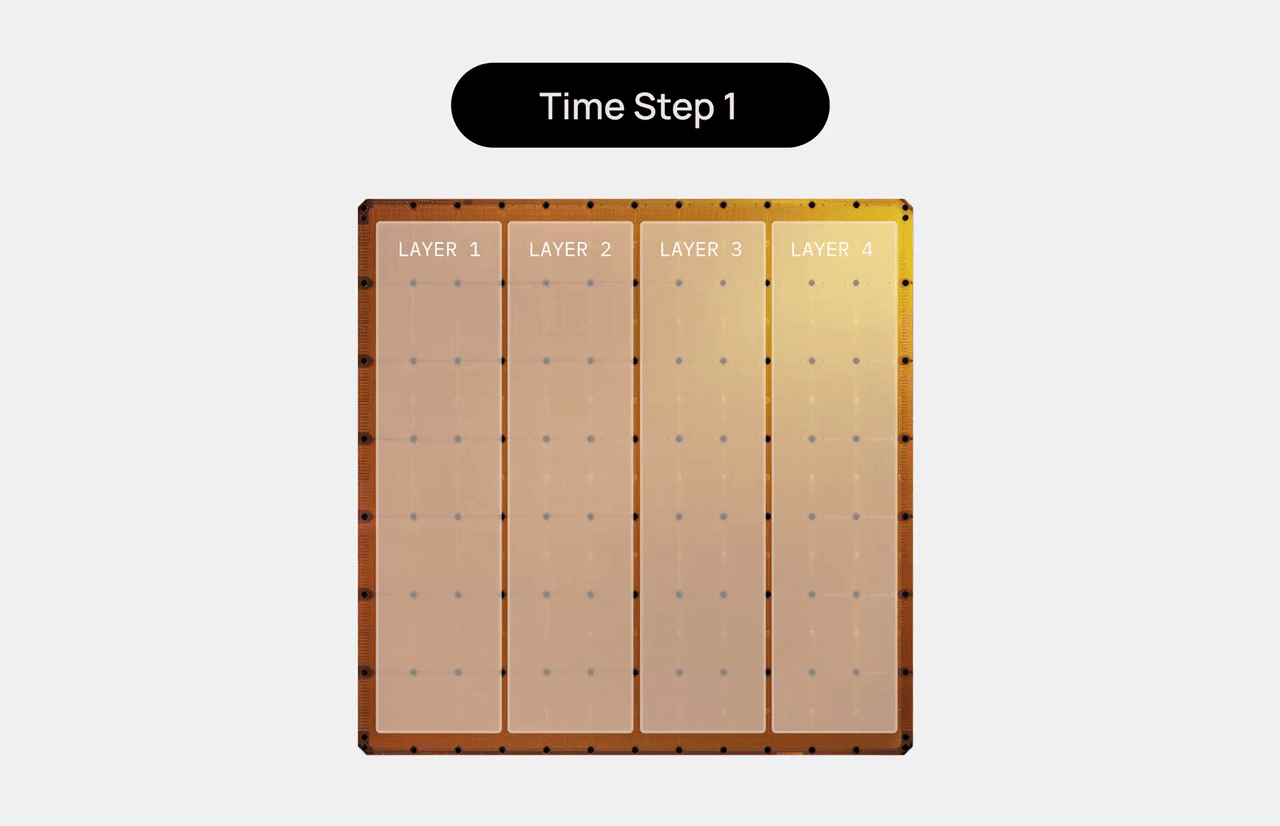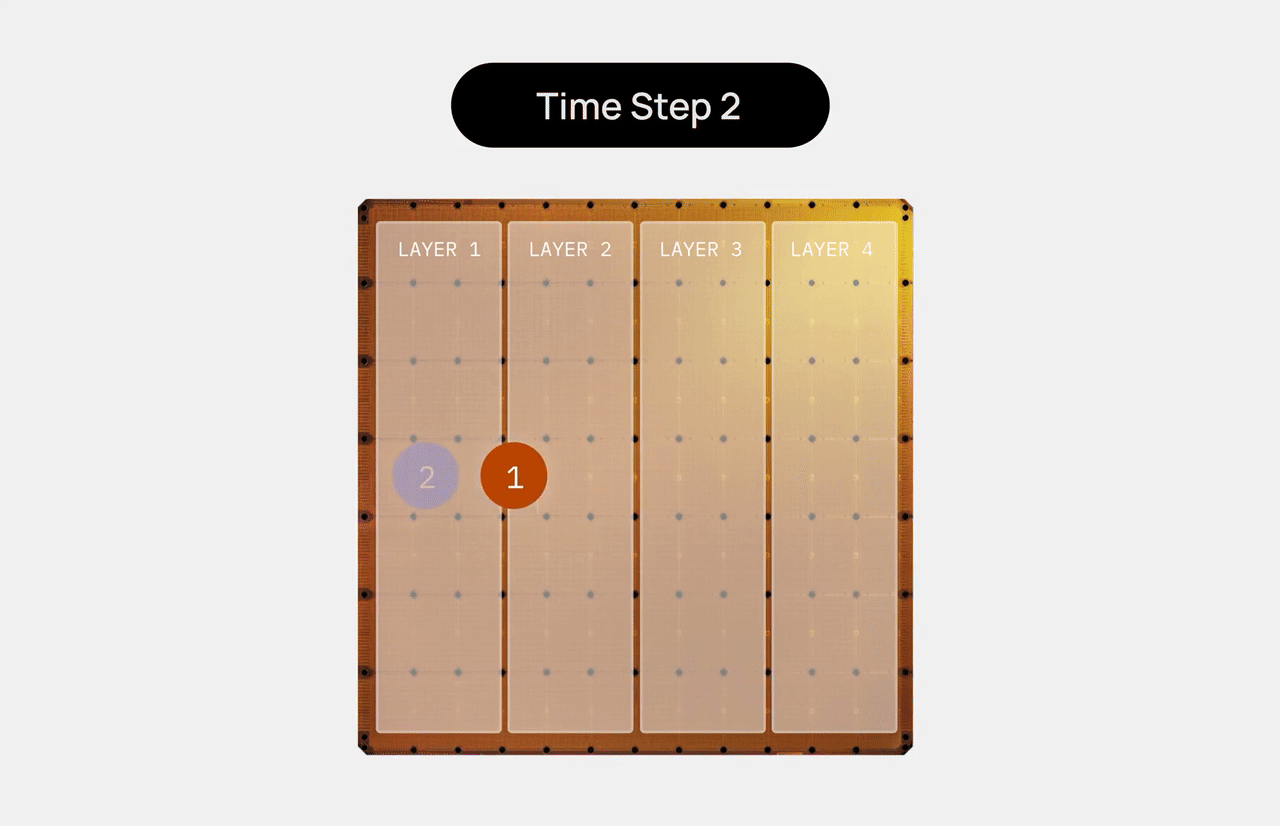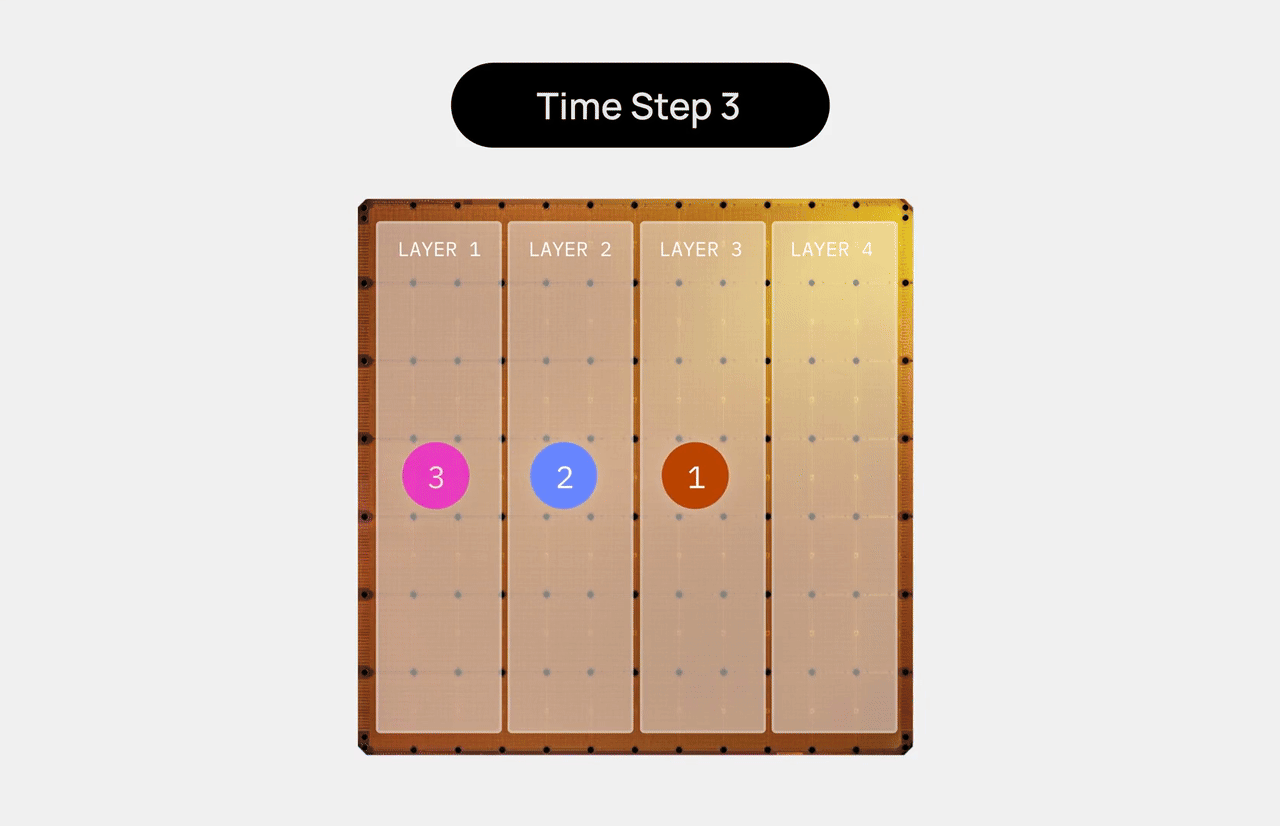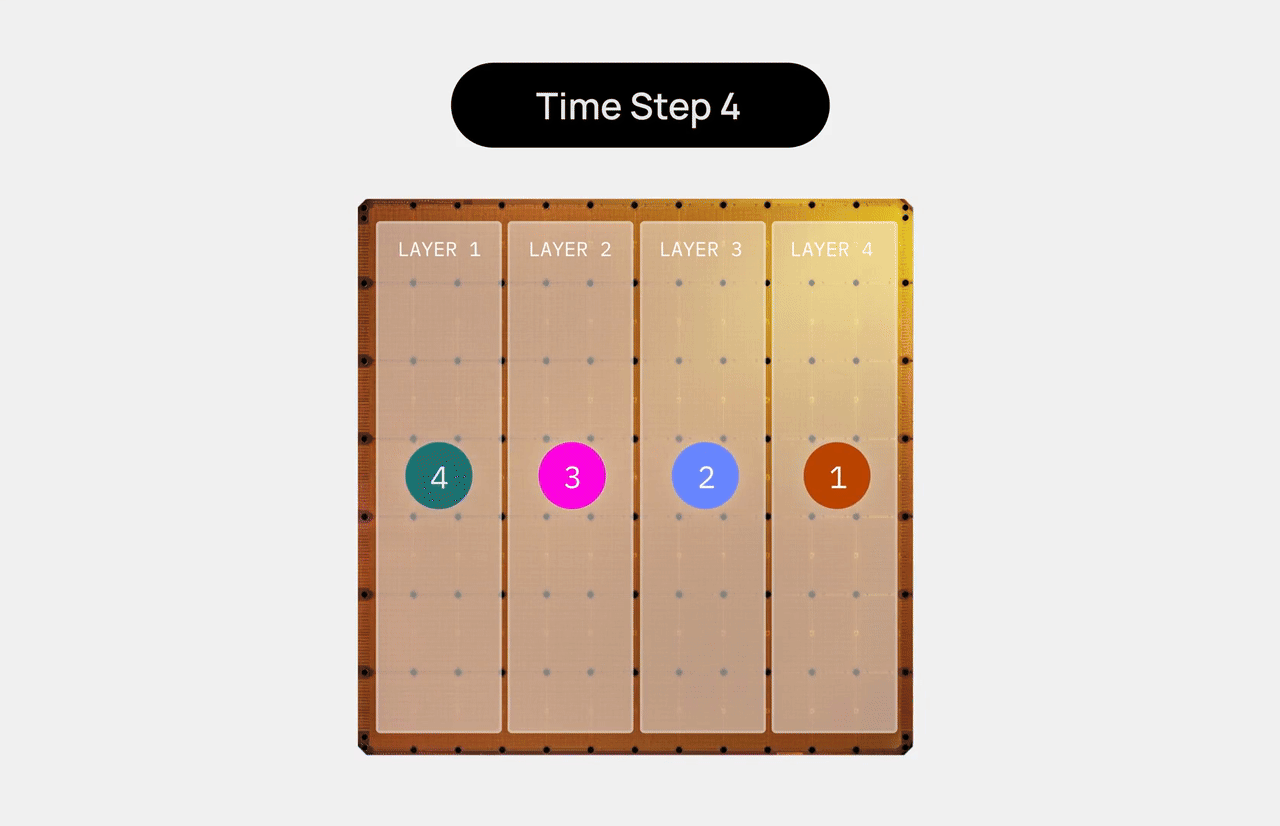
Кроме того, каждый этап способен работать с микробатчем — небольшой группой запросов вместо одного. Поэтому число запросов, находящихся в обработке одновременно, примерно равно количеству этапов, помноженному на размер микробатча.
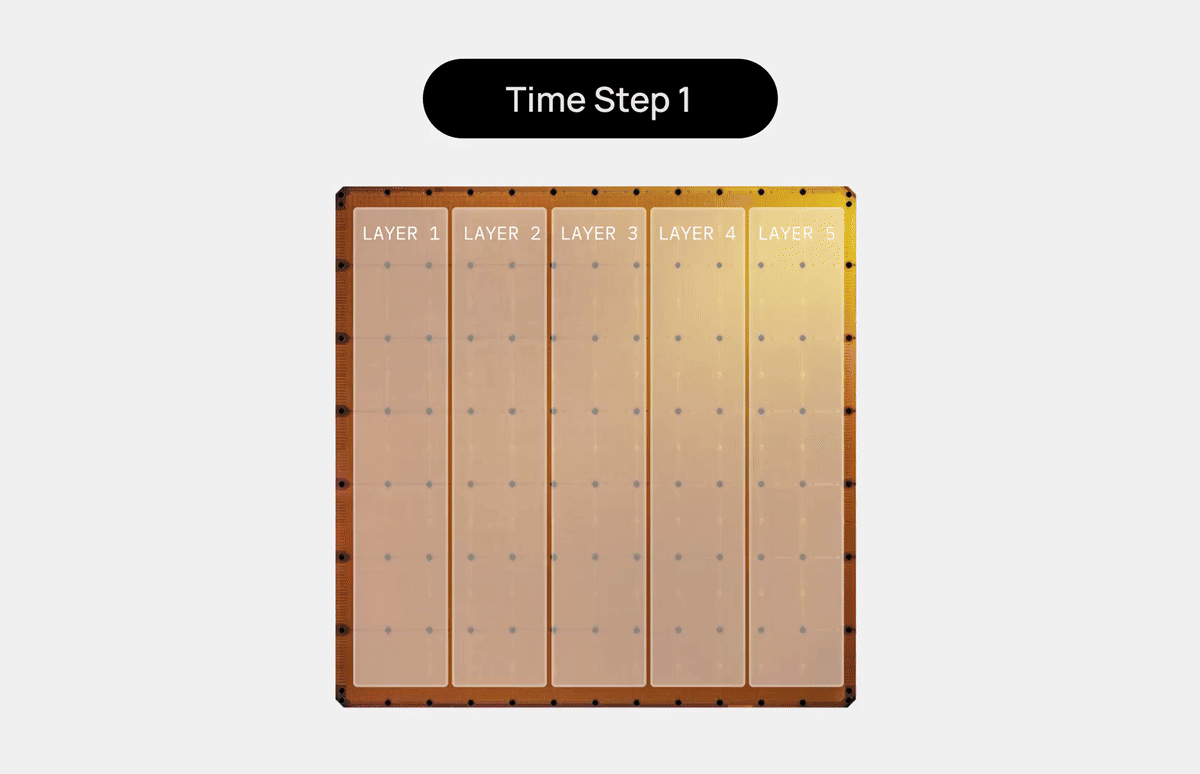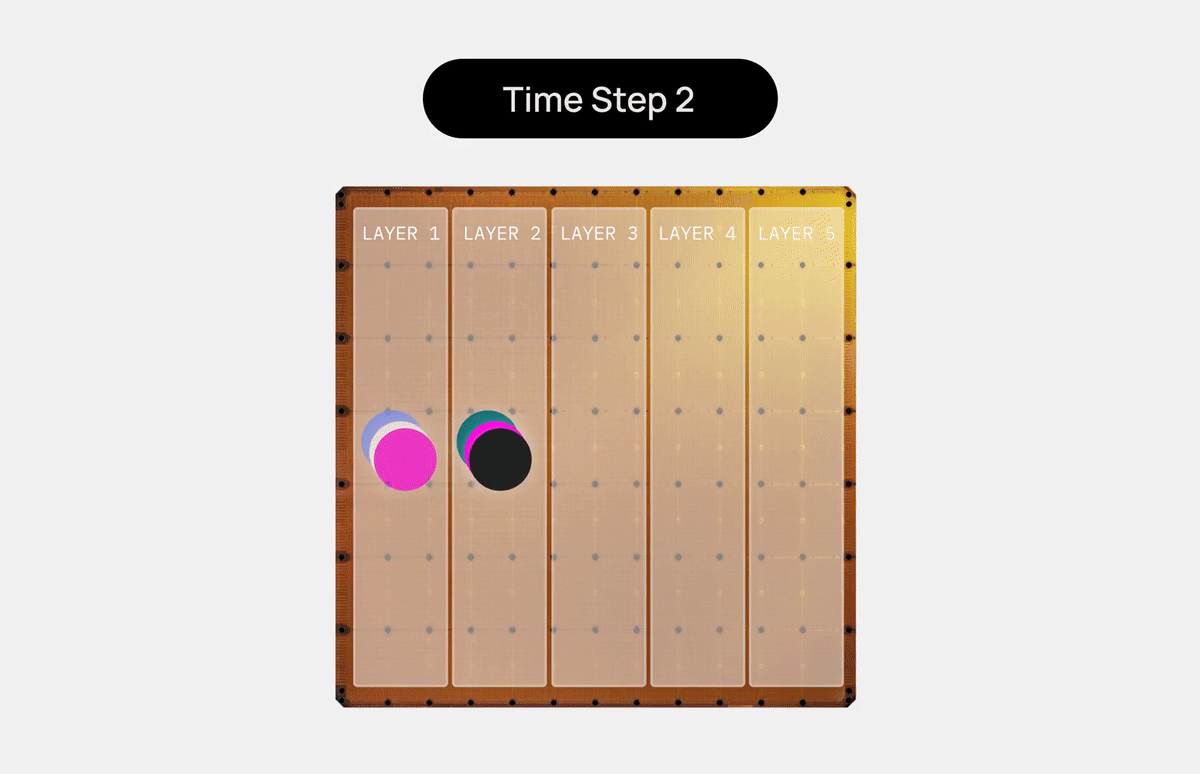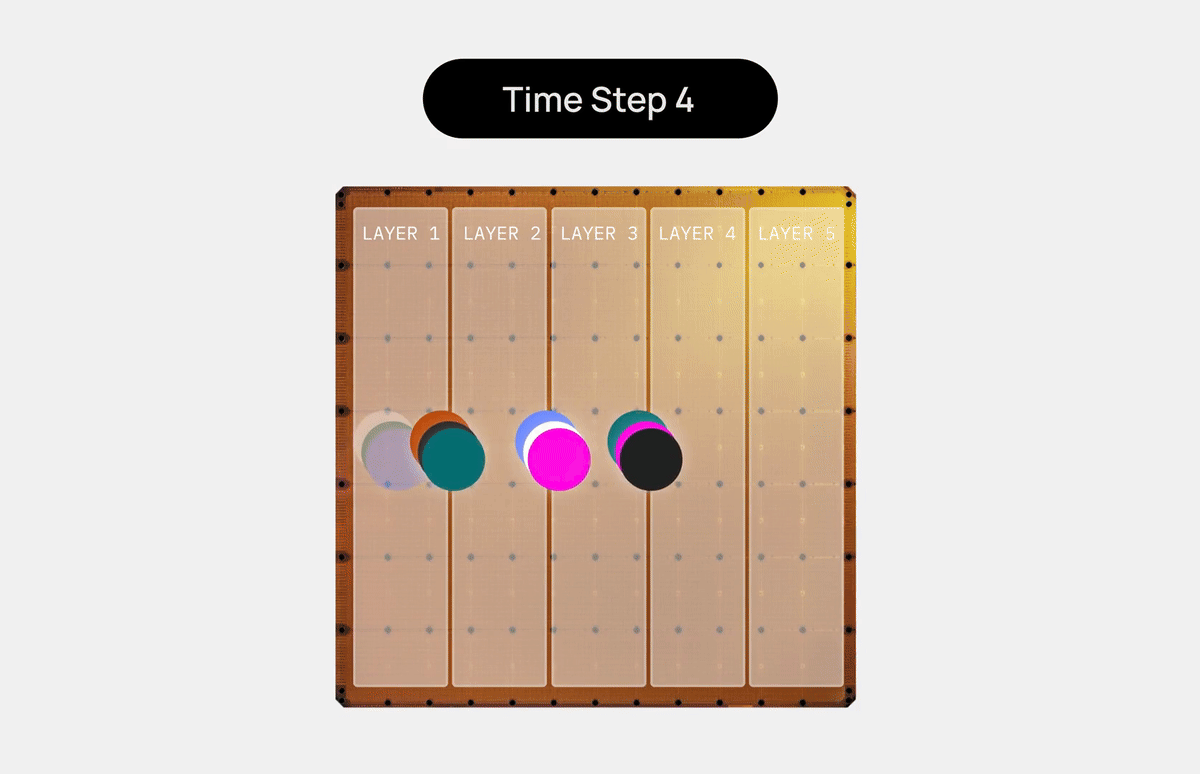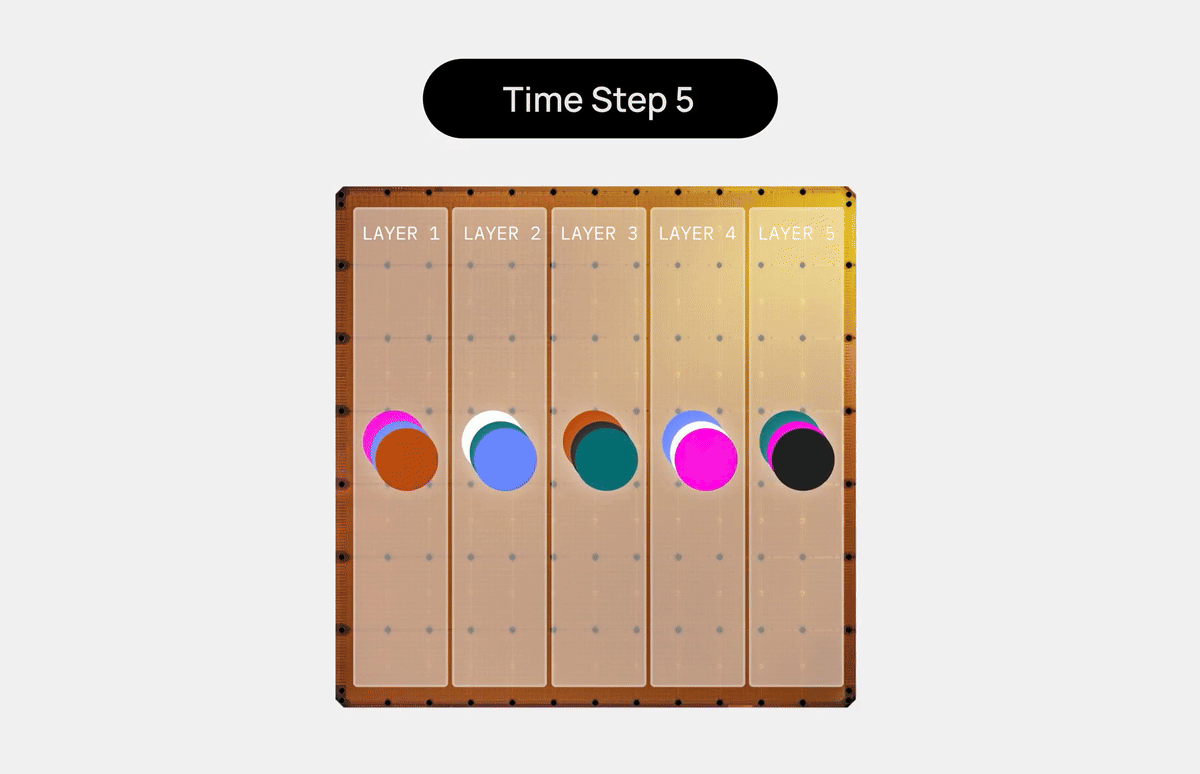
Здесь приходится искать баланс: чем меньше микробатчи, тем быстрее обрабатывается каждый отдельный запрос, а чем они крупнее, тем выше общая пропускная способность.
6. Сколько запросов можно обслужить
Предельное число одновременных запросов определяется тем, сколько встроенной памяти отведено под KV-кэш. Каждому обрабатываемому запросу нужен собственный KV-кэш на каждой пластине со слоем полного внимания. Таким образом, объём памяти на чипах ограничивает число параллельных запросов сверху. Как уже говорилось, потребность в KV-кэше достаточно оценивать только для слоёв полного внимания.
Для пластины с 44 ГБ памяти, где уже находится один слой полного внимания, свободное место под KV-кэш равно общему объёму памяти за вычетом размера этого слоя. В нашем случае:
44 ГБ − 16 ГБ = 28 ГБСчитаем число одновременных запросов
Чтобы узнать, сколько параллельных запросов выдерживает выбранная схема размещения, сперва вычислим, сколько места в кэше занимает один запрос длиной 256 тысяч токенов:
Объём кэша для одной последовательности на одном слое =
    число байт, сохраняемых на токен для этого слоя × длина контекста

576 байт × 256 000 ≈ 147 МБ на последовательность
Затем разделим доступную под кэш память на объём кэша одного запроса:
28 ГБ ÷ 147 МБ ≈ 190 одновременных запросовОбщее число одновременных запросов — это количество запросов, которые в любой момент находятся в конвейере. В отличие от батча на GPU, эти запросы не дожидаются друг друга, а непрерывно движутся по конвейеру.
Впрочем, ни число параллельных запросов, ни размер батча сами по себе не отражают, насколько эффективен инференс. Для оценки пропускной способности лучше подходит другая метрика — суммарная скорость генерации токенов на единицу мощности, скажем, токены в секунду на мегаватт, при одинаковой скорости генерации для каждого отдельного запроса.
Масштабирование подхода на модели свыше 3 трлн параметров
Тот же принцип работает и для более крупных моделей: рассчитываем память под веса и состояния запросов, распределяем модель по пластинам и связываем их в конвейер. Каждая новая пластина добавляет и вычислительные ресурсы, и встроенную память. Благодаря этому можно запускать модели, которые не помещаются ни на один отдельный чип.
Похожие статьи
 YouTube может внедрить кодек AV2 уже в 2027 году: качество видео останется прежним, а трафик сократится на 30%
 Nvidia советует переоборудовать устаревшие АЭС в центры обработки данных для ИИ
 Эксперт по кибербезопасности: телевизоры Samsung на Tizen ведут масштабную слежку за владельцами, и это может вызывать «тормоза» в работе ТВ
 Четырёхкратный скачок за год: 256-гигабайтные SSD дорожают, и рост цен может продолжиться
 Очень мощная башня с пятилетней гарантией и весом 1,5 кг: DeepCool показала башенный кулер StationX 622, рассчитанный на отвод до 540 Вт
 Thermalright выпустила СЖО с изогнутым AMOLED-дисплеем 2400 × 1080 и «эффектом парения»
 Мини-ПК размером с карманный по цене бюджетного смартфона: Acemagic W1-5400U с богатым набором портов обойдётся всего в $235
 OnePlus Ace 7 Pro получит аккумулятор на 9000 мАч, 100-ваттную зарядку, голубой корпус и настраиваемую подсветку