Введение в глубокое обучение. Часть 3
Всем привет! Перед вами третья статья из серии об основах глубокого обучения. В предыдущих частях мы рассмотрели немало полезных для начинающих тем, поэтому советую к ним вернуться.
На этот раз подробнее поговорим об обработке естественного языка (NLP) и создадим двухслойную нейронную сеть для классификации текстов.
Что такое обработка естественного языка
Какие задачи решает NLP?
Обработка естественного языка — область искусственного интеллекта, которая занимается автоматическим анализом человеческой речи и текста. При этом глубокое обучение для решения таких задач применяется не всегда.
Вот несколько примеров задач NLP:
-
определение границ слов по символам, предложений и словосочетаний по словам, а также выделение именованных сущностей — людей, городов и других объектов — в предложении;
-
определение части речи каждого слова в предложении;
-
определение людей, мест или предметов, к которым относятся местоимения в документе;
-
определение эмоциональной окраски предложения по его словам;
-
машинный перевод;
-
классификация текстов;
-
восстановление пропущенной информации по контексту;
-
обработка и генерация связного текста, похожего на написанный человеком.
В основе обучение нейронной сети для любой из этих задач устроено схожим образом. Главное — найти способ преобразовать входной текст в числа, поскольку сеть работает именно с ними.
Представление текста нужно выбрать так, чтобы модель могла эффективно выявить зависимость между входными и выходными данными.
Для этого стоит изучить сами входные данные и ожидаемые результаты: они подскажут, какое представление поможет сети обнаружить связь между ними.
В качестве примера рассмотрим одну из задач классификации текста.
Классификация отзывов по эмоциональной окраске
Я воспользуюсь набором данных «Кинопоиска» с отзывами на фильмы. Если не учитывать лишние поля, он содержит 36 591 пару «текст отзыва : рейтинг». Получить датасет можно разными способами: например, скачать файл вручную или, как в нашем случае, воспользоваться библиотекой Hugging Face. Для обучения также подойдёт датасет IMDb из keras.datasets, но отзывы в нём написаны на английском языке.
Наша задача — обучить сеть определять по тексту отзыва его рейтинг: 1 или 0, то есть положительный или отрицательный. Для простоты исключим нейтральные отзывы. Чтобы уменьшить перекос между классами, попробуем выбрать и перемешать по 10 000 положительных и отрицательных отзывов.
Сначала определимся с токеном — минимальной единицей текста, которую воспринимает модель. В качестве токена удобно выбрать слово: некоторые слова заметно связаны с эмоциональной окраской отзыва, например «хороший», «плохой», «понравился» или «ненавижу». Для простоты пока не будем учитывать контекст.
Наша нейронная сеть — параметрическая модель с фиксированным количеством весов и нейронов, а значит, и с фиксированным размером входного слоя. Один из простейших способов представить текст — составить словарь слов из отзывов и преобразовать каждый отзыв в вектор. На позициях, соответствующих встречающимся в нём словам, будут стоять единицы.
Допустим, в словаре пять слов, первое из которых — «плохой». Ему соответствует вектор [1,0,0,0,0]. Если отзыв содержит первое, третье и четвёртое слова словаря, его можно представить вектором [1,0,1,1,0]. В предыдущих частях мы уже использовали прямое кодирование (one-hot encoding) для отдельных слов; полученное представление отзыва с несколькими единицами точнее называется multi-hot.
Если одно и то же слово встречается в отзыве несколько раз, можно либо сложить его вектор соответствующее количество раз, либо учесть его только однажды. Второй вариант зачастую предпочтительнее.
За основу новой модели возьмём двухслойную сеть из предыдущих частей: в её скрытом слое было 100 нейронов, а в выходном — один.
Сначала загрузим датасет и приведём его к удобному формату. Затем разобьём отзывы на токены — в нашем случае слова — и получим множество слов для каждого отзыва.
После этого составим словарь и присвоим каждому слову индекс: ключом будет слово, а значением — его идентификатор. Такой индекс представляет собой компактную запись one-hot-вектора: вместо всего вектора мы храним только позицию единицы.
Далее подготовим данные для модели: каждый отзыв будет представлен списком идентификаторов входящих в него слов. Рейтинги тоже преобразуем из текстовых обозначений в числа.
import numpy as np
np.random.seed(1)
from datasets import load_dataset
import pandas as pd
import re

dataset = load_dataset("blinoff/kinopoisk")
df = pd.DataFrame(dataset["train"])
df = df[df["grade3"].isin(["Good", "Bad"])]

df_good = df[df["grade3"] == "Good"].head(10000)
df_bad = df[df["grade3"] == "Bad"].head(10000)
df = pd.concat([df_good, df_bad]).sample(frac=1, random_state=1).reset_index(drop=True)

def clean(text):
    text = text.replace("\n", " ").replace("\xa0", " ").lower()
    text = re.sub(r"[^а-яa-z\s]", "", text)
    text = re.sub(r"\s+", " ", text)
    return text.strip()

raw_reviews = list(map(clean, df["content"].head(20000).tolist()))#список с отзывами
raw_labels = df["grade3"].head(20000).tolist()
tokens = list(map(lambda x: set(x.split(" ")), raw_reviews))

vocab = set()
for sent in tokens:
    for word in sent:
        if len(word) > 0: vocab.add(word)
vocab = list(vocab) #пока создадим просто список всех слов без повторений

word2index = {} #а это уже будет наш словарь
for i, word in enumerate(vocab):
    word2index[word] = i

input_dataset = list() #входные данные для модели
for sent in tokens:
    sent_indices = list()
    for word in sent:
        sent_indices.append(word2index[word])
    input_dataset.append(list(set(sent_indices)))

target_dataset = list() #переведём рейтинг в цифры
for label in raw_labels:
    if label == "Good": target_dataset.append(1)
    else: target_dataset.append(0)
Теперь можно перейти к обучению. Обратим внимание на важную деталь: отзыв представлен длинным вектором, в котором единицы стоят лишь на позициях слов, присутствующих в тексте. Поэтому при прямом распространении не обязательно умножать весь входной вектор на матрицу весов. Достаточно сложить строки матрицы, соответствующие индексам слов отзыва. Чтобы убедиться в этом, можно самостоятельно умножить вектор из нулей и единиц на матрицу и сравнить результаты.
Такой выбор и суммирование или усреднение строк можно рассматривать как работу слоя векторных представлений, или слоя Embedding. Он преобразует индексы объектов в обучаемые векторы. Подобные слои используются и в более сложных моделях, включая GPT, хотя способы обработки полученных представлений различаются. Для разных типов входных данных могут применяться разные модели и методы построения эмбеддингов.
Иными словами, вложение, или эмбеддинг, — это представление дискретного объекта точкой в непрерывном векторном пространстве. Прямое кодирование лишь подготавливает слова к вычислениям; строки матрицы весов становятся их обучаемыми векторными представлениями. Складывая эти строки, мы получаем общее представление отзыва. Подробнее об этом поговорим в следующих частях, когда перейдём к GPT-подобным моделям.
Приступим к коду. Для простоты воспользуемся стохастическим градиентным спуском, хотя обучение может занять больше времени. Индексирование матрицы позволяет выбрать строки по их номерам: например, по вектору [1,3,5] мы получим три соответствующие строки. Само прямое распространение должно быть понятно из кода.
def sigmoid(x):
    return 1/(1+ np.exp(-x))

alpha, iterations, hidden_size = (0.01, 2, 100)
weights_1 = 0.2*np.random.random((len(vocab), hidden_size)) - 0.1
weights_2 = 0.2*np.random.random((hidden_size, 1)) - 0.1

correct, total = (0,0)
for j in range(iterations):
    for i in range(len(input_dataset) - 1000): #обучаем на первых 19000 отзывах
        x, y = (input_dataset[i], target_dataset[i])
        layer_1 = sigmoid(np.sum(weights_1[x], axis=0))
        layer_2 = sigmoid(np.dot(layer_1, weights_2))
        layer_2_delta = layer_2 - y
        layer_1_delta = layer_2_delta.dot(weights_2.T)*layer_1*(1-layer_1)
        weights_1[x] -= alpha*layer_1_delta #эта операция удобно вычтет градиент ошибки от нужных весов
        weights_2 -= alpha*np.outer(layer_1, layer_2_delta)

        if(np.abs(layer_2_delta) < 0.5):
            correct +=1
        total +=1
        if (i%10 == 9): print(f"Iter: {j}-{i} Progress: {100*(i+1)/(len(input_dataset) - 1000):.4f}% TrainingAcc: {100*correct/float(total):.4f}%")

print("\nТестируем")
#протестируем на 1000 отложенных образцов
correct, total = (0,0)
for i in range(len(input_dataset)-1000, len(input_dataset)):
    x, y = (input_dataset[i], target_dataset[i])
    layer_1 = sigmoid(np.sum(weights_1[x], axis=0))
    layer_2 = sigmoid(np.dot(layer_1, weights_2))
    if(np.abs(layer_2-y) < 0.5): correct +=1
    total +=1
print(f"TestAcc: {100*correct / total:.4f}%")
Перейдём к обратному распространению. В качестве функции ошибки здесь используется бинарная перекрёстная энтропия. В сочетании с sigmoid её производная по входу функции активации, то есть по взвешенной сумме, принимает простой вид: результат модели минус истинное значение. Аналогичное упрощение возникает при сочетании перекрёстной энтропии и softmax.
Поэтому дельта выходного слоя равна разности предсказания и правильного ответа. Чтобы вычислить дельту первого слоя, умножаем эту величину на вектор весов и на производную sigmoid: sigmoid'(x) = sigmoid(x)*(1 - sigmoid(x)).
Веса первого слоя обновляем с помощью индексирования: градиент вычитается из строк, соответствующих словам отзыва. При таком присваивании изменяется исходная матрица весов. Дополнительно умножать градиент на входные данные не нужно: для выбранных строк вход равен единице, а строки, соответствующие нулям, мы не обновляем.
Для обновления весов второго слоя используем np.outer(). Эта функция вычисляет внешнее произведение: каждый элемент первого вектора умножается на каждый элемент второго. В результате получается матрица, которая в данном случае имеет форму вектора-столбца.
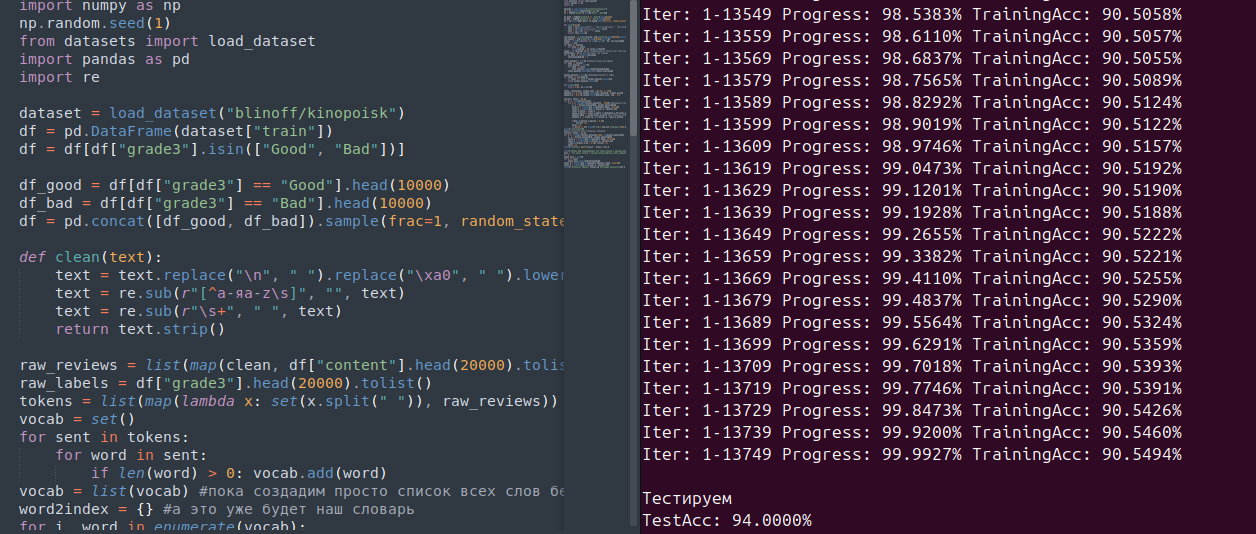
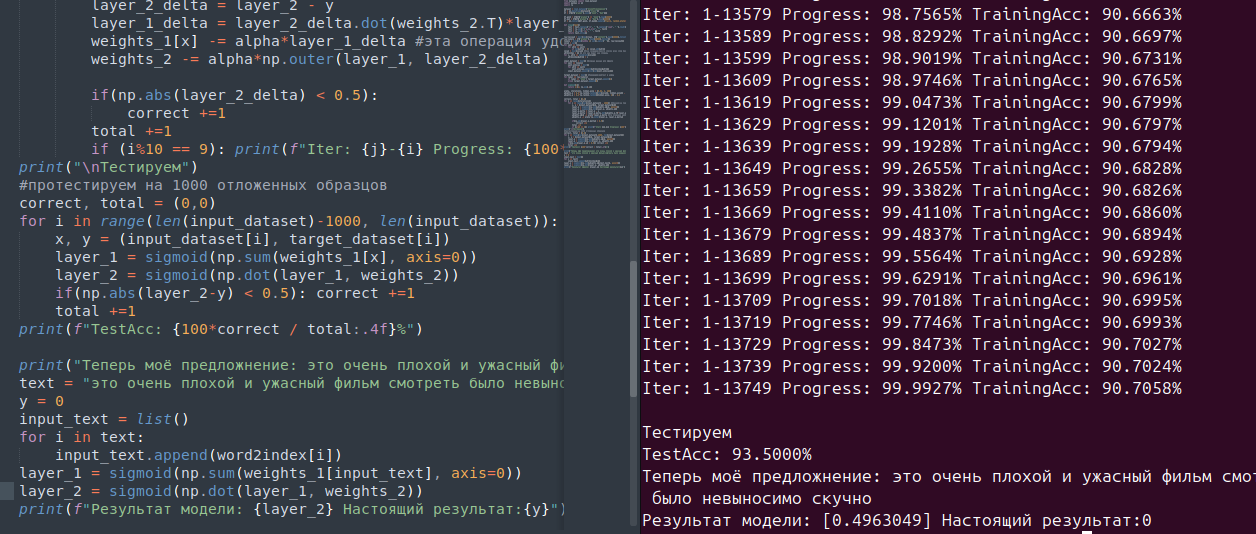
В конце подсчитаем долю правильно классифицированных отзывов и проверим модель на 1000 отложенных примеров. В этом эксперименте точность на тестовой выборке достигла 94%.
Но на этом не остановимся: напишем собственное предложение и проверим, правильно ли модель определит его эмоциональную окраску.
print("Теперь моё предложнение: это очень плохой и ужасный фильм смотреть было невыносимо скучно")
text = "это очень плохой и ужасный фильм смотреть было невыносимо скучно".split()
y = 0
input_text = list()
for i in text:
    input_text.append(word2index[i])
layer_1 = sigmoid(np.sum(weights_1[input_text], axis=0))
layer_2 = sigmoid(np.dot(layer_1, weights_2))
print(f"Результат модели: {layer_2} Настоящий результат:{y}")
Модель определила окраску верно, но её ответ оказался близок к порогу классификации. Одна из возможных причин — перекос данных: в датасете «Кинопоиска» оказалось лишь 4751 отрицательных отзыва. Поэтому после отбора мы получили не 20 000, а 14 751 отзыв: 10 000 положительных и 4751 отрицательный. Из них 1000 были отложены для тестирования.
На этом завершим третью часть. В следующий раз подробнее изучим векторные представления слов, продолжим работать с нашей сетью и создадим модель для определения пропущенных слов.
Оставляйте вопросы в комментариях.
Похожие статьи
 Искусственный интеллект как инструмент контроля: как государства, спецслужбы и мошенники управляют вашим сознанием
 Скирмионы как основа компьютера, работающего по принципу мозга
 Почему предлог «в» сбивает с толку калькуляторы и нарушает логику
 Сколько стоит «идеальный ребёнок»? Либеральная евгеника и тревожное стремление к человеческому совершенству
 ntpd, NTPsec и chrony принимают просроченный файл високосных секунд, но chrony 4.6.1 отвергает файл без срока действия
 Как один нейрон может повлиять на личность
 Почему советская модель гражданской авиации с большими экипажами и бортинженерами лучше
 Правильно ли мы спрашиваем о тёмной материи? Пять неоспоримых фактов о её существовании