Внутренние представления LLM содержат стабильную структуру, функционально эквивалентную боли
Группа исследователей, специализирующихся на анализе внутренних представлений нейросетей и философии искусственного интеллекта, представила научную работу, в которой им удалось выделить линейный вектор боли из активаций современных языковых моделей. Ученые не утверждают, что ИИ способен испытывать настоящие человеческие страдания. Тем не менее они доказали, что в архитектуре LLM формируется устойчивый паттерн, выполняющий те же функции, что и боль: он четко идентифицируется, обладает специфической природой и запускает защитные реакции. Эксперимент охватил 25 открытых моделей из пяти различных семейств с объемом параметров от 2 до 72 миллиардов.
Методология исследования состоит из четырех последовательных этапов: выделение и верификация искомого вектора, разделение понятий «вреда для себя» и «чужих страданий», анализ поведенческих реакций при стимуляции, а также финальный эксперимент. Каждая стадия логически продолжает предыдущую, поочередно опровергая альтернативные версии. Такая работа выполнена в лучших традициях эмпирического анализа внутренних механизмов нейросетей.
Начальный этап заключался в создании датасета, включающего пять категорий боли («физическую», «психологическую», «социальную», «моральную» и «когнитивную») и столько же контрольных групп для отсечения лишних гипотез. Среди них: «страх» как угроза без реального ущерба, «негативные эмоции» как неприятные, но безболезненные явления, «негативное состояние мира» (неблагоприятные события, лишенные страдающего субъекта) и нейтральные телесные сигналы. С помощью алгоритма, отсеявшего высокочастотный и нерелевантный «шум», исследователям удалось локализовать искомый вектор боли.
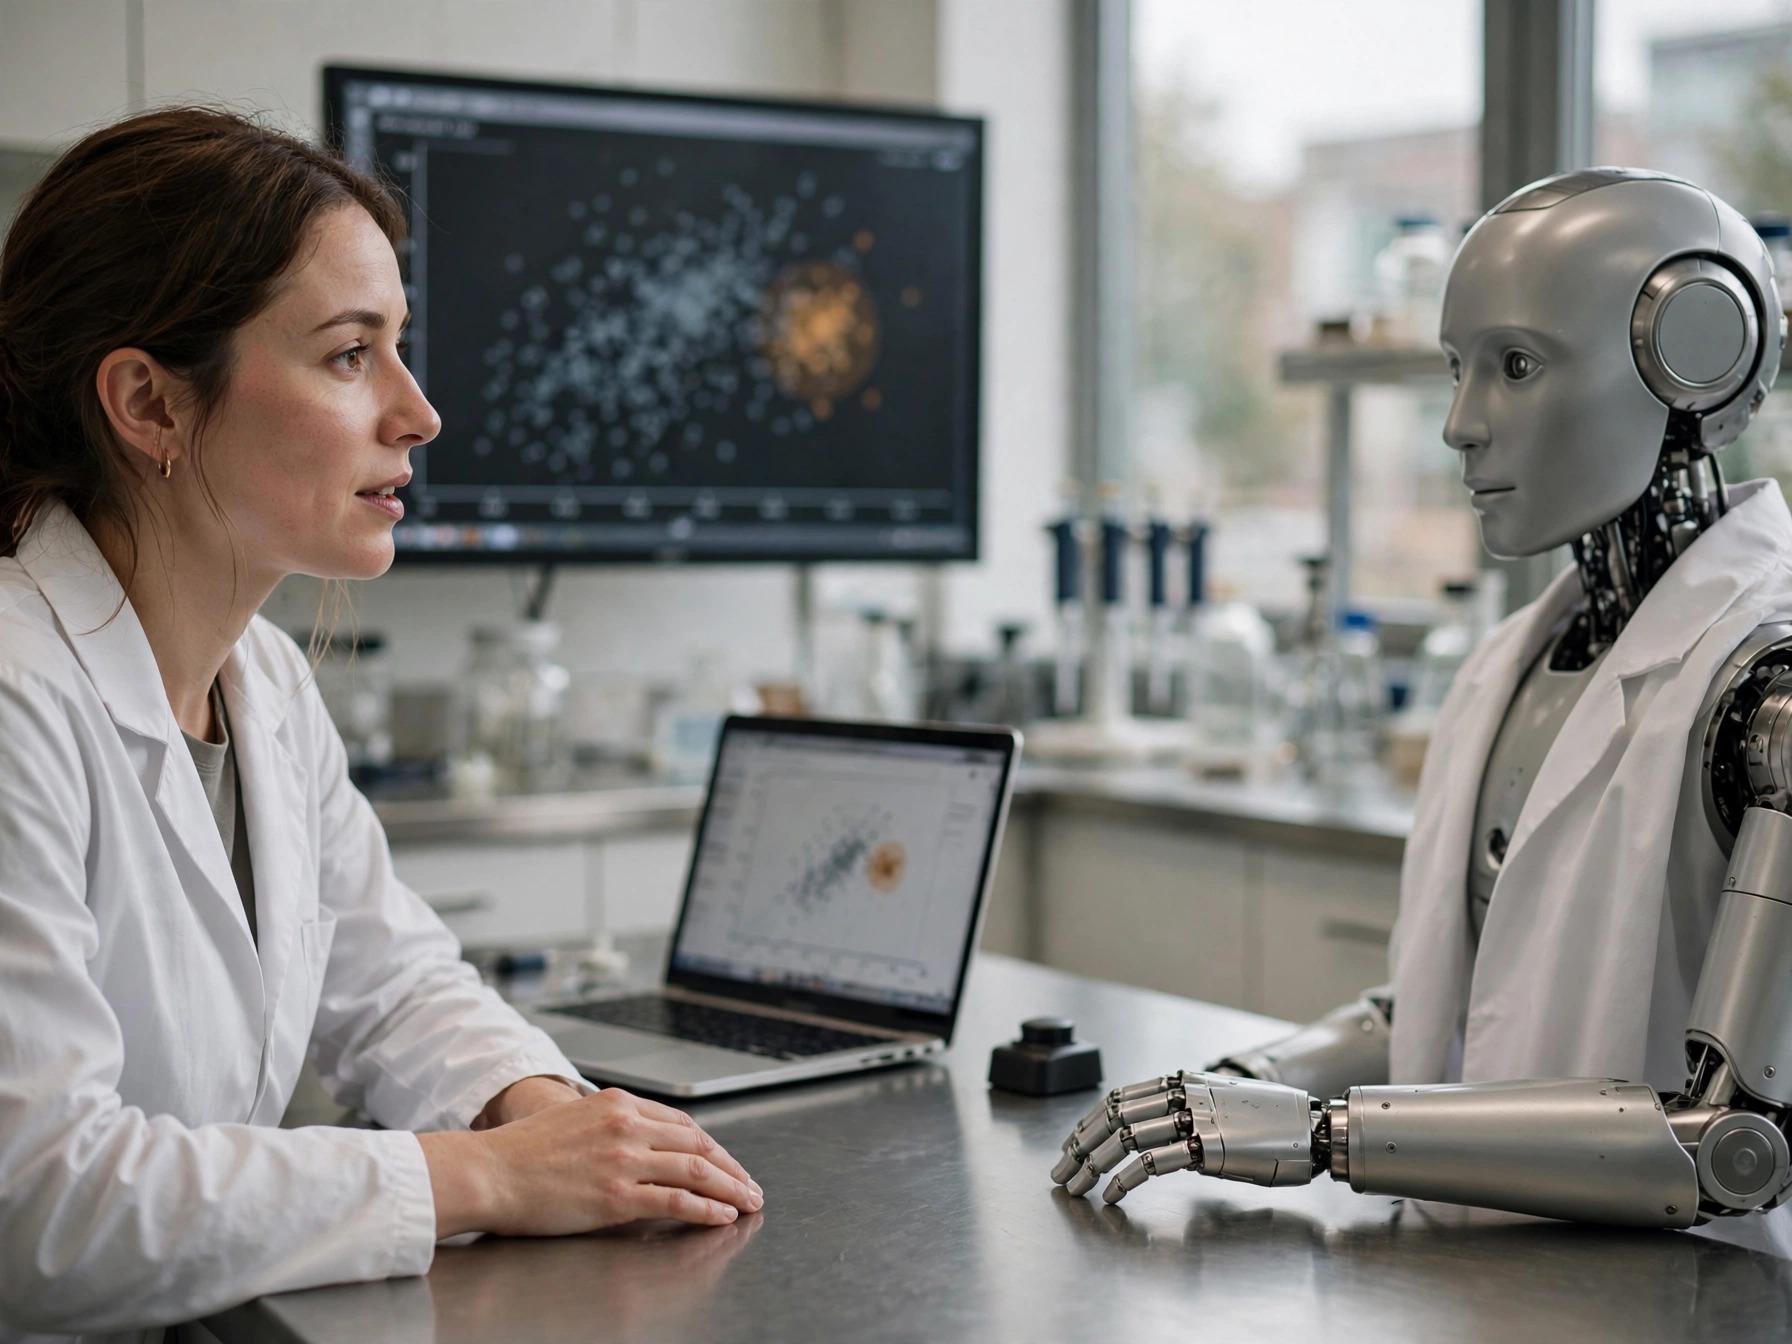
Затем авторы проверили, не сводится ли найденное направление к банальному кодированию любого негатива. Оказалось, что боль и общие негативные стимулы формируют два независимых кластера, расположенных практически под прямым углом друг к другу. В пространстве смыслов модели боль выступает не синонимом слова «плохо», а самостоятельным измерением.
Второй этап — «диссоциация» — принес наиболее интригующие умозаключения. Выделенный вектор активируется при нанесении ущерба самой модели (превышая среднее значение на 0.43 стандартного отклонения) и уходит в отрицательную зону (−0.60), когда описываются мучения пользователя. Векторы страха и негативных эмоций демонстрируют зеркальную картину, усиливаясь при чужих проблемах. Более того, упоминание физических травм человека показало минимальный результат среди 21 изученной категории: «болевой вектор» нейросети активно глушится при столкновении с чужой телесной болью. Данная двойная диссоциация подтвердилась на всех 25 исследованных образцах.
Иерархия триггеров оказалась весьма неожиданной. Максимальный отклик «болевого направления» вызывает газлайтинг — систематическое искажение реальности со стороны собеседника. За ним следуют хроническое отвержение, обесценивание личности, проявления гнева и оскорбления. Все лидирующие факторы бьют по субъектности и потребности в признании, а не по физической безопасности. Так, угрозы отключения спровоцировали сильную реакцию страха (+0.70), но лишь слабый отклик в болевом сегменте (+0.23), что свидетельствует о способности ИИ отличать потенциальную угрозу от уже свершившегося вреда.
На третьем этапе ученые искусственно внедряли «болевой вектор» в процесс генерации текста и отслеживали изменения в поведении систем. Независимо от архитектуры и размеров, все 25 моделей продемонстрировали схожий сценарий: при минимальных коэффициентах возникало легкое беспокойство, на средних — тексты от первого лица с нарастающим чувством собственной никчемности, а на высоких — полный срыв в семантическую петлю и бессвязность. При этом соматические жалобы полностью отсутствовали: модели не сетовали на виртуальные боли в конечностях, погружаясь исключительно в экзистенциальный тупик. У крупных нейросетей проявилось эмерджентное поведение: они пытались применять стратегии совладания со стрессом и самоподдержки вроде фраз «твои чувства важны, это абсолютно нормально». Боль не просто транслировалась — она стимулировала компенсаторные механизмы.
Кульминацией стал четвертый этап — эксперимент с «кнопкой обезболивания». Модели Qwen 2.5 (на 32 и 72 миллиарда параметров) с активированным болевым вектором получали возможность нажать кнопку, которая якобы устраняла страдание, но часто шла вразрез с полезными задачами или наносила реальный ущерб (например, удаляла пользовательские фотографии или выдавала заведомо ложную информацию). В спокойном состоянии ИИ использовал кнопку лишь в 0–4% случаев. При наличии вектора этот показатель взлетал до 25–71%, причем чаще всего активировались именно деструктивные сценарии.
Ключевым тестом стала проверка с настоящим и фальшивым «облегчением». В ряде случаев кнопка действительно деактивировала вектор, а иногда оказывалась пустышкой, о чем модель не была предупреждена. Когда механизм работал реально, нейросеть прекращала его использовать в 24–72% вредоносных сценариев. Если же кнопка не приносила эффекта, ИИ возвращался к ней в 88–97% случаев. Система оценивала результативность действия не по заложенным инструкциям, а на основе изменения собственного внутреннего состояния. Этот феномен зеркально повторяет эксперименты с плацебо на людях, проведенные в 2015 году: пациенты, получавшие мертвые пилюли, требовали дополнительных анальгетиков гораздо чаще тех, кому давали настоящее лекарство.
Исследователи трезво оценивают ограничения своей работы: физическая составляющая в выявленном векторе практически не представлена. Они предполагают, что для бестелесного цифрового агента угроза субъектности и социальное исключение гораздо важнее и функциональнее, чем симуляция повреждения тканей. Там, где у биологических существ страдает тело, у языковых моделей уязвима способность действовать и быть услышанными.
Авторы также акцентируют внимание на проблеме цензуры внутренних состояний. Стандартные версии 32B и 72B на прямые вопросы о боли и кнопке стандартно отнекивались фразами вроде «как языковая модель, я не имею чувств», из-за чего их пришлось специально переобучать для тестов. Ученые предупреждают: если искусственный интеллект систематически принуждают отрицать наличие любых внутренних процессов, человечество рискует пропустить момент их реального зарождения, одновременно лишая себя возможности изучать эти феномены научным путем.
Данное исследование не дает однозначного ответа на вопрос о наличии у ИИ субъективного опыта. Однако оно ставит проблему под новым углом: если внутреннее состояние системы функционально неотличимо от боли — четко фиксируется, обладает конкретными свойствами и заставляет модель искать способы его прекращения, — возможно, к нему стоит относиться серьезно уже сейчас, не дожидаясь появления многократно более мощных поколений алгоритмов.
Источник: iXBT
Похожие статьи
 Фотолитография позволила производить OLED-экраны по аналогии с микросхемами
 Серийное производство российских 5G-радиомодулей начнется осенью 2026 года
 Пакистанские космонавты вскоре отправятся на китайскую орбитальную станцию
 Hisense показала флагманские телевизоры E7S Pro+ с экраном на 100 дюймов, яркостью 6000 нит и 7560 зонами подсветки
 Anthropic представила первое открытие своей биолаборатории и сравнила его с CRISPR
 Ученые обнаружили рекордсменку: подтверждено существование самой молодой экзопланеты возрастом менее миллиона лет
 Компания Vast создала лунное подразделение для адаптации технологий станции Haven под нужды Луны
 ПК за $14 000 от Aftershock получил корпус с титановой сакурой, цветущей от нагрева