UX без экономики: польза или выброшенные деньги?
Коротко о главном
-
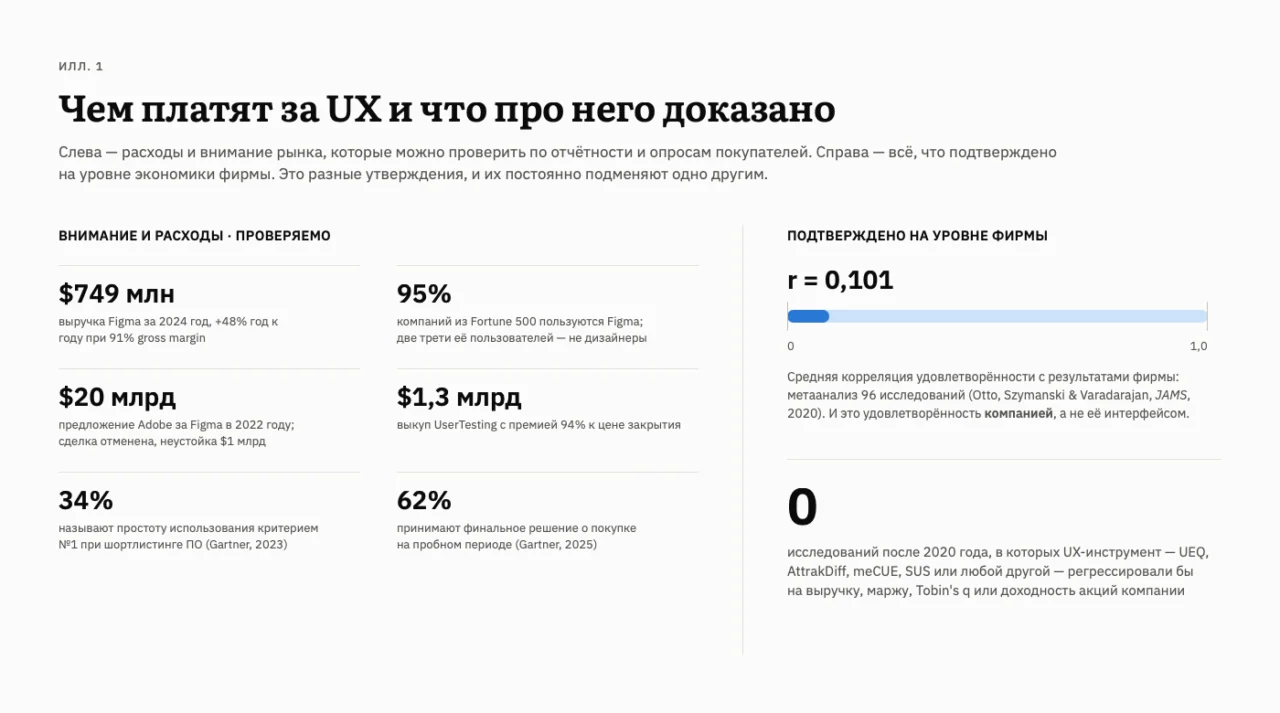
Рынок действует так, словно ценность UX уже доказана: удобство использования стоит первым в списке критериев при отборе ПО в шортлист (34%).
-
Начиная с 2020 года не найдено ни одной работы, где показатели UX-инструментов (UEQ, AttrakDiff, meCUE, SUS) были бы связаны регрессией с выручкой, маржинальностью или рыночной стоимостью компании.
-
Там, где отдельные свойства интерфейса всё же пересчитывали в деньги, знак эффекта оказывается непредсказуемым. Внедрение A/B-тестирования даёт +30–100%, работа с аналитическим дашбордом — +4–10%. Более удачный сайт автопроизводителя снизил продажи на 12%. Приложение гостиничной сети уменьшило траты клиентов, а приложение продуктового ритейлера, напротив, увеличило. Тёмные паттерны повышают конверсию в 2–4 раза, а ускорение сайта ресторана не дало вообще ничего.
-
Дело не в том, что UX бесполезен, а в том, что его невозможно проверить: 605 KPI в 64 публикациях, более 200 методов, 104 определения от 422 экспертов, 79,3% статей без гипотез, а корреляции meCUE с PANAS одинаково высоки для эмоций, лояльности и желания пользоваться продуктом. У конструкта нет дискриминантной валидности.
-
Ближайший мост к измеримым величинам — теории TAM и UTAUT: воспринимаемая простота использования по сути и есть юзабилити, а в обзоре 37 работ на стыке TAM и UX воспринимаемое удовольствие влияет на отношение к технологии сильнее, чем полезность и простота. Однако эти модели заканчиваются на намерении и до денег не добираются.
-
Альтернатива — измерять не «опыт», а степень, в которой человек сам стоит за своими действиями. Теория самодетерминации задаёт шкалу от «не понимаю, зачем я это делаю» до «мне это интересно само по себе», и главный водораздел на ней проходит не между внутренней и внешней мотивацией, а между «сам» и «подталкивают». UX-опросники этого различия не улавливают: и тот, кто выбрал продукт сам, и тот, кого к нему приучили, получат у них одинаково высокие оценки.
Начнём с аргумента, который не требует веры ни в одну из теорий UX, — с денег, которые рынок отдаёт за UX-исследования и дизайн.
Выручка Figma в 2024 году составила 749 млн долларов (рост на 48% за год) при валовой марже 91%, а в первом квартале 2025-го — 228,2 млн (+46%). В июле 2025 года компания провела IPO, привлекла около 1,2 млрд долларов и целилась в оценку 14,6–16,4 млрд. У продукта 13 млн активных пользователей, а среди компаний из Fortune 500 им пользуются 95%. Другой пример — UserTesting, платформа для пользовательских исследований: её купили Thoma Bravo и Sunstone Partners за 1,3 млрд долларов, заплатив премию в 94% к цене закрытия.
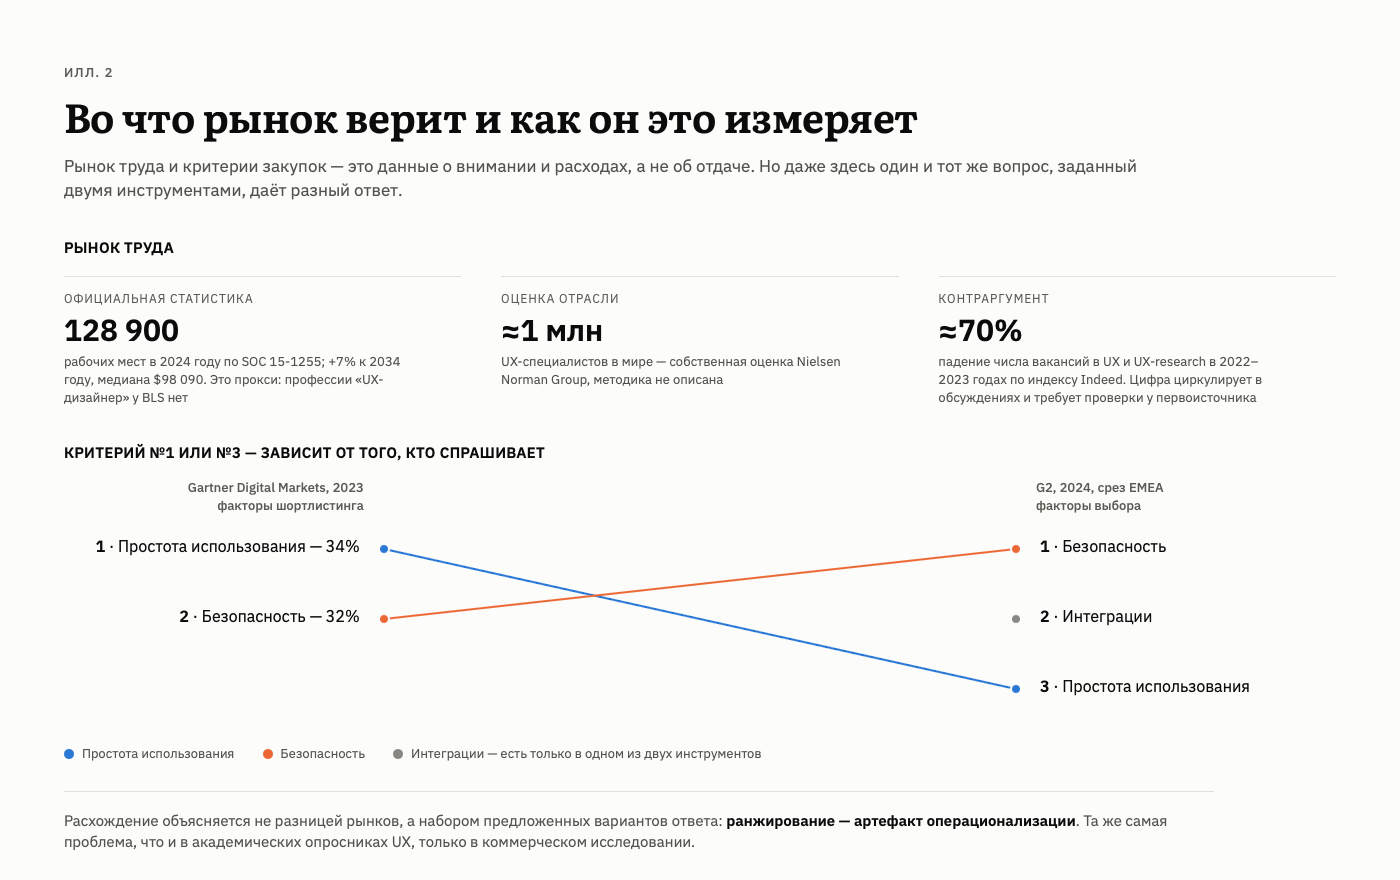
Рынок труда выглядит скромнее. Категория Web and Digital Interface Designers (SOC 15-1255) насчитывала в США около 128 900 рабочих мест в 2024 году; к 2034-му ожидается 137 900 (+7%, «быстрее среднего»), а медианная зарплата составляет 98 090 долларов. По оценке Nielsen Norman Group, в мире работает примерно миллион UX-специалистов, но эта цифра — их собственная прикидка без описания методики. Кроме того, в 2022–2023 годах число вакансий в UX и UX-research резко просело: в обсуждениях гуляют цифры порядка 70%, выведенные из индекса Indeed.
Самое любопытное, впрочем, касается не практиков, а покупателей. По опросу Gartner Digital Markets 2023 года, простота использования заняла первое место среди критериев формирования шортлиста поставщиков (34%), безопасность — второе (32%). Но есть важная оговорка: в срезе G2 по региону EMEA за 2024 год простота использования только на третьем месте, после безопасности и интеграций. Это расхождение объясняется не различием рынков, а тем, какие варианты ответа предлагались респондентам.
Так или иначе, рынок готов платить за UX-инструменты, UX-исследования, консалтинг и редизайн собственных ИТ-решений.
Что известно об экономическом эффекте
Главный итог литературного поиска таков: после 2020 года нет ни одной работы, где UX-конструкт был бы включён в регрессию на выручку, маржу, Tobin’s q или доходность акций компании. Здесь важна точность формулировки. Речь не о том, что «связь пока не доказана, нужно подождать данных». Речь о том, что связь изучают совсем иначе: экономисты, специалисты по операционному менеджменту и маркетологи берут одно конкретное свойство интерфейса и сопоставляют его с одной конкретной экономической величиной — и никто из них не опирается на UX-инструменты (AttrakDiff, UEQ, meCUE, SUS или любые другие).
Вот что у них получается.
Крупнейший эффект оплачивает не интерфейс, а умение его проверять. Koning, Hasan и Chatterji (Management Science, 2022) изучили обширную выборку технологических стартапов. Каждый из них в какой-то момент начал применять A/B-тестирование — практику, при которой две версии экрана показывают разным группам пользователей и смотрят, какая сработает лучше. Начинали компании в разные годы, что позволило сравнивать: те, кто ещё не перешёл на тестирование, служили контрольной группой для тех, кто уже перешёл. Спустя год после внедрения показатели компаний были выше на 30–100%. Это самый крупный эффект на уровне фирмы во всей области — и обратите внимание, за что именно здесь платят: не за удачный интерфейс, а за способность проверять интерфейсы как таковые. При этом такую практику заводят лишь немногие.
Похожая картина у Berman и Israeli (Marketing Science, 2022). Более 1500 интернет-магазинов подключили аналитический дашборд — панель, отражающую происходящее на сайте. Средняя недельная выручка после этого выросла на 4–10%, но только у тех, кто действительно заходил в дашборд. Авторы отдельно проверили, не объясняется ли рост изменением цен или рекламы, — не объясняется, и средний чек остался прежним.
Если эффект есть, он, как правило, сосредоточен в одной точке пути, а не размазан по всему продукту. Gallino, Karacaoglu и Moreno (Operations Research, 2023) выяснили, что происходит, когда сайт интернет-магазина начинает притормаживать. Продажи и конверсия — доля посетителей, дошедших до покупки, — заметно снижаются. Но чувствительность на разных шагах разная: острее всего люди реагируют на задержку при оплате. Для практики этот вывод ценнее самого факта падения: бюджет на скорость стоит тратить не «на весь сайт», а именно на этом шаге.
Самые известные цифры в этой области принадлежат Kohavi с соавторами (KDD, 2014): каждые 100 миллисекунд ускорения приносили Bing примерно +0,6% выручки. Однако в той же работе есть и второе утверждение, которое цитируют куда реже: большинство экспериментов вообще ничего не улучшает, а удачные сдвигают ключевые метрики лишь на 0,1–1,0%.
Угадать знак эффекта по качеству опыта нельзя. Bar-Gill и Reichman (MIS Quarterly, 2021) описали почти лабораторный случай: премиальный автомобильный бренд запускал новый, более интересный и интерактивный сайт не сразу везде, а рынок за рынком. Поэтому в любой момент существовали рынки с новым сайтом и рынки со старым — готовые группы для сравнения. Итог: улучшенный сайт сократил продажи автомобилей примерно на 12%. Механизм прост и неприятен: человек получал всё нужное онлайн и переставал заезжать в салон, а ведь именно визит в салон был тем шагом, на котором машину продавали.
Gu и Kannan (Journal of Marketing Research, 2021) изучили гостиничную сеть и то, как меняются расходы клиента после установки её приложения. Совокупные траты заметно снизились. Объяснение такое: человек, скачавший одно приложение, скачивает и приложения конкурентов, больше ищет и сравнивает — и доля его денег, достающаяся именно этой сети, сокращается. Существенная деталь: у тех, кто пользовался приложением для мобильного заселения, то есть для реального дела, а не только для поиска, падение оказалось слабее.
А вот самое неудобное наблюдение. Luguri и Strahilevitz (Journal of Legal Analysis, 2021) в масштабном эксперименте (итоговая выборка — 1963 человека) предлагали участникам платную услугу. В обычном интерфейсе согласились 11,3%. Там, где интерфейс мягко подталкивал к согласию — это и называют тёмными паттернами, — 25,8%. При агрессивном нажиме — 41,9%. Тот же товар, та же цена, а согласий почти вчетверо больше, и всё это обеспечено одним лишь оформлением. Опыт при этом стал хуже, а не лучше. Если бы качество опыта и бизнес-метрика всегда двигались в одном направлении, такой результат был бы невозможен.
Есть и аккуратно измеренные нули — они весят не меньше остальных результатов. Ikášová и Klepek (Financial Internet Quarterly, 2024) в течение двух месяцев сравнивали ресторан с медленным сайтом и ресторан с быстрым, считая утренние визиты и продажи бизнес-ланчей. Различий не нашли ни в визитах, ни в продажах. Это прямое возражение цифрам про скорость у Bing и Amazon: то же самое вмешательство в масштабе небольшого бизнеса не даёт ничего измеримого.
И отдельно — фильтр, через который стоит пропускать любые внутренние цифры. Berman и Van den Bulte (Management Science, 2022) показали, что заметная доля «победивших» A/B-тестов — ложные победы, когда случайное колебание принимают за результат. Те приросты, о которых всё же сообщают, систематически завышены. Любое внутреннее «наш редизайн принёс +X% выручки» сначала следует прочитать через призму этой работы.
А что с самой популярной цепочкой — «хороший опыт → довольный клиент → деньги»? Это единственное звено, у которого вообще есть доказательная база на уровне компании. И она скромна. Метаанализ Otto, Szymanski и Varadarajan (JAMS, 2020) объединил 96 исследований и показал среднюю корреляцию удовлетворённости с результатами компании r = 0,101. Простым языком: связь есть и она положительная, но объясняет лишь около 1% различий между компаниями. Остальные 99% определяются чем-то другим. Mittal и соавторы (Marketing Letters, 2023), проанализировав 245 статей за 40 лет, приходят к тому же: удовлетворённость скорее передаёт влияние дальше по цепочке, чем сама что-то приводит в движение.
И главное: во всех этих работах измеряется удовлетворённость компанией, а не её интерфейсом. Это принципиально разные вещи, и подмена одного другим — основной способ, которым UX присваивают чужую доказательную базу.
Напоследок — о том, как с этим живёт сама индустрия. Chawana и Adebesin (South African Computer Journal, 2021) опросили 33 UX-специалиста в четырёх организациях. Некоторые респонденты знали, какими метриками можно было бы измерять отдачу от UX, но ни одна из четырёх организаций фактически этого не делала: возврат считали на весь проект разработки, не выделяя вклад UX.
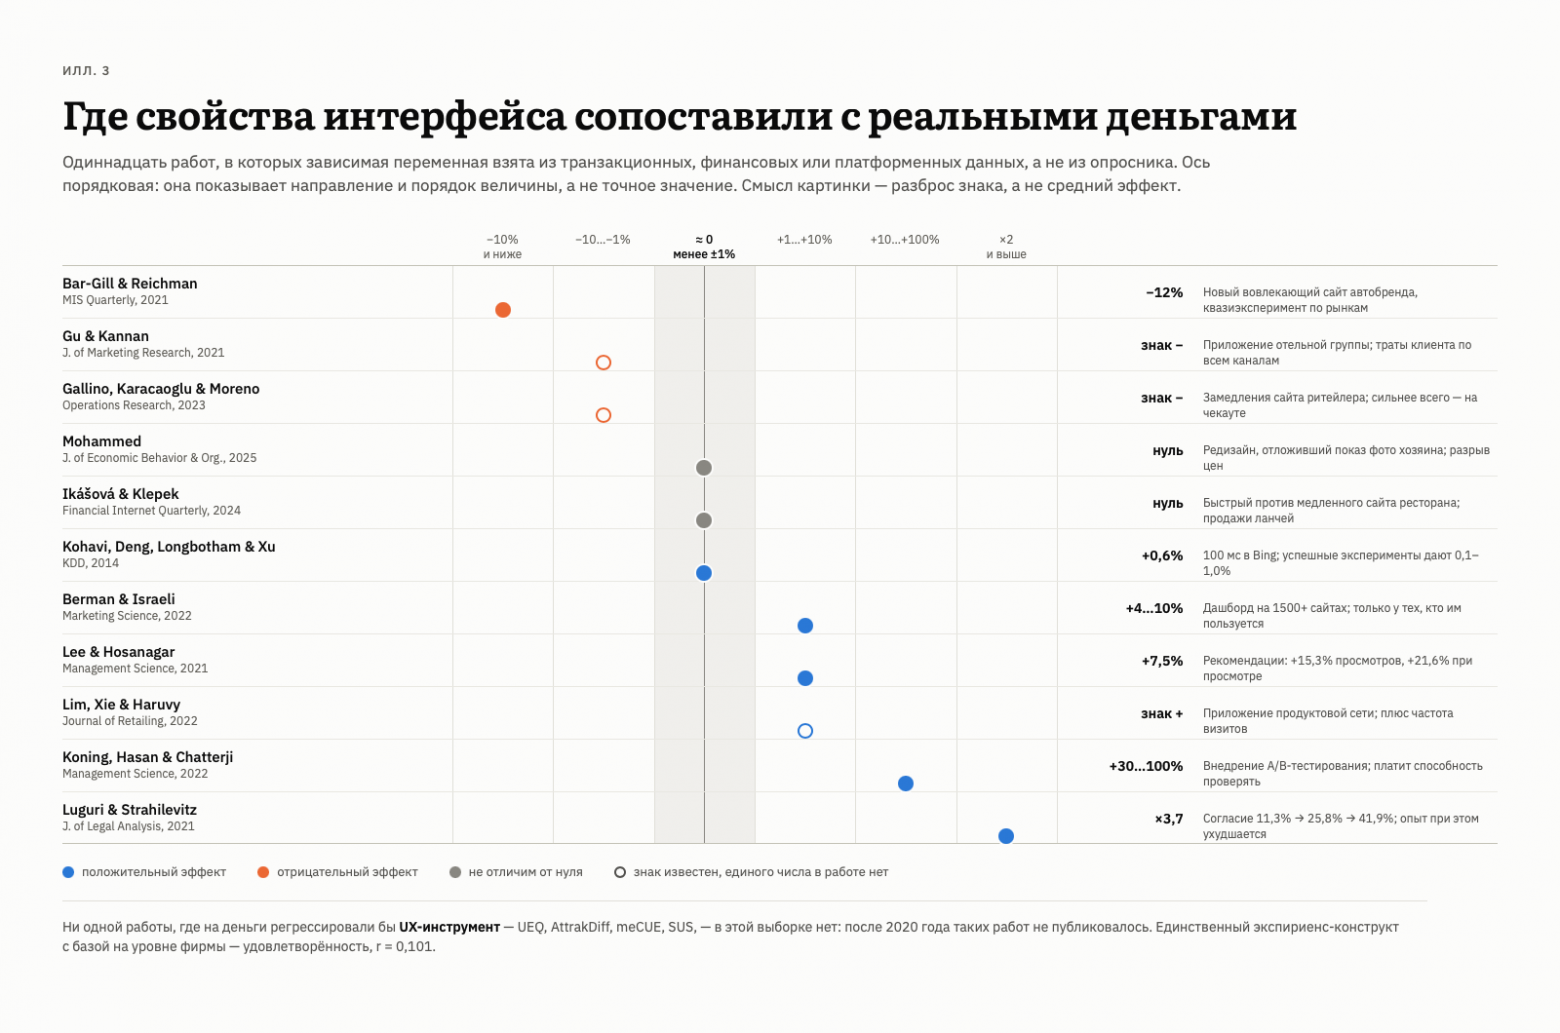
Подведём итог. Эффект обнаруживается, но каждый раз при своём наборе условий: категория бизнеса (продукты или гостиницы), этап пути (оплата или просмотр), масштаб (Bing или ресторан на углу), роль канала (заменяет визит к дилеру или дополняет поход в магазин), число конкурентов рядом, наличие у клиента альтернативного способа добиться того же. Каждая из этих работ — корректная находка, но ни одна не становится правилом. Цифру «100 мс = 0,6% выручки» из Bing нельзя перенести на сайт ресторана: это буквально проверили и получили ноль. Тезис «приложение увеличивает траты» из продуктового ритейла нельзя перенести в гостиничный бизнес: там знак меняется на противоположный. Практике эти исключения не дают никаких гарантий — они дают перечень переменных, которые придётся проверять самостоятельно.
Почему связь не находится: теория, 200+ методов и мост из моделей принятия
У UX нет единой, научно обоснованной и экспериментально подтверждённой теории. Он не выводится ни из одной доминирующей теории — есть лишь претенденты на это место. Невозможно теоретически обосновать, что именно входит в пользовательский опыт и почему, подтвердить это экспериментом и отсечь конкурирующие объяснения.
Ведущий стандарт, ISO 9241-210, определяет UX как «восприятие и реакции человека, возникающие в результате использования и/или предполагаемого использования продукта, системы или сервиса». Это определение через перечисление всего подряд. Отсутствие доминирующей теории порождает проблему внутренней структуры: в UX включают эмоции, убеждения, предпочтения, восприятие, физические и психологические реакции, поведение пользователя до, во время и после взаимодействия, а также бренд, контекст использования и функциональность интерфейса. Проблем здесь две: перечень не исчерпывающий, а каждый его элемент сам по себе — сложный и неоднозначный конструкт.
Отсюда прямо следует размножение инструментов: методов исследования UX насчитывается свыше 200. Без общей теории возникают частные, которые не столько объясняют UX, сколько обосновывают применимость конкретного инструмента — именно это и случилось с AttrakDiff. Добавьте психологическую норму «всё связано со всем»: значимость p < 0,05 при корреляции 0,3–0,5 достигается сравнительно легко, а потому возникает неограниченный набор «связанных с UX» факторов, среди которых невозможно выделить главный.
Нет теории — нет и гипотез, которые можно опровергнуть. Эмпирическое подтверждение прямое: 79,3% авторов статей 2000–2016 годов вообще не формулировали научных гипотез. Теория отстаёт от наблюдений. К этому добавляется находка Hornbæk и Law: показатели юзабилити коррелируют между собой лишь слабо. А гипотеза о методологическом разделении UX и usability — будто для UX характерны гедонистические методы оценки, а для usability прагматические, ориентированные на результат, — подтверждения не получила.
Три самых распространённых опросника иллюстрируют общую траекторию. AttrakDiff (2000) исходит из того, что существуют удобство использования и удовольствие от него, а опыт представляет собой их сочетание; отсюда эргономические качества (usability, эффективность, функциональность) и гедонистические (оригинальность, новизна, эстетика), которые вносят равный и независимый вклад в общее желание пользоваться продуктом. Форма вытекает из теории: семантический дифференциал, полярные утверждения по 7-балльной шкале без промежуточных формулировок. UEQ (2008) опирается на те же основания, но упрекает AttrakDiff в перекосе в сторону эмоциональной составляющей: 26 пар утверждений, шесть шкал. Процесс его разработки показателен — 15 UX-экспертов SAP предложили 229 прилагательных, первая версия включала 80 пар, а факторный анализ на выборке из 153 человек сократил их до 26. meCUE (2016) появился потому, что первые два учитывают лишь часть факторов и на практике их приходится применять вместе: 33 утверждения, девять шкал плюс десятая из одного общего вопроса, четыре модуля.
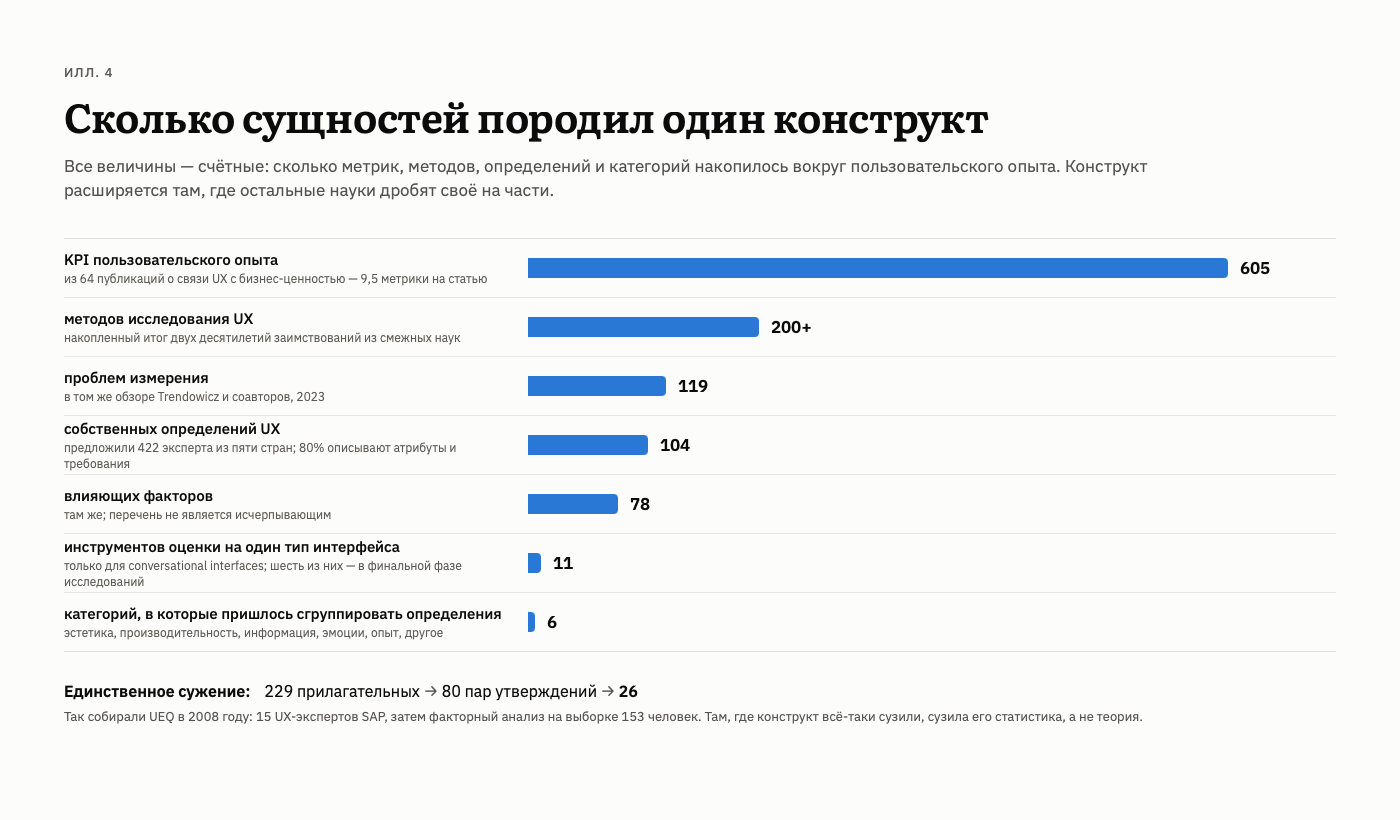
Попытка зайти с другой стороны — расспросить практиков — согласия не принесла. Опрос 2009 года (275 профессионалов из 25 стран), его повтор в 2015-м (758 респондентов) и исследование 2017 года (422 эксперта из Турции, Малайзии, Франции, Финляндии и Дании) показали устойчивую картину: лидирует определение через сумму состояния пользователя, свойств продукта и контекста, запрос на стандартизацию растёт, а в 2017-м эксперты предложили 104 собственных определения UX, из которых 80% описывали атрибуты или требования, и исследователям пришлось разложить их по шести категориям. Общее для всех этих работ в том, что определения и вопросы формулировались без опоры на устоявшиеся научные конструкты — вплоть до использования выдачи Google по самому термину. И почти нигде статистика не выявила значимого результата, не связанного с социально-демографическими характеристиками респондентов.
Сложим это с выводом Trendowicz. Конструкт, который порождает 605 KPI в 64 публикациях, 200+ методов исследования и 104 определения от 422 экспертов, не обладает дискриминантной валидностью. Это и есть ответ на вопрос, почему нет регрессий на выручку: регрессировать попросту нечего. Нельзя связать с деньгами переменную, о которой невозможно сказать, чего именно она не измеряет.
TAM и UTAUT: где UX уже связан с измеримой зависимой переменной
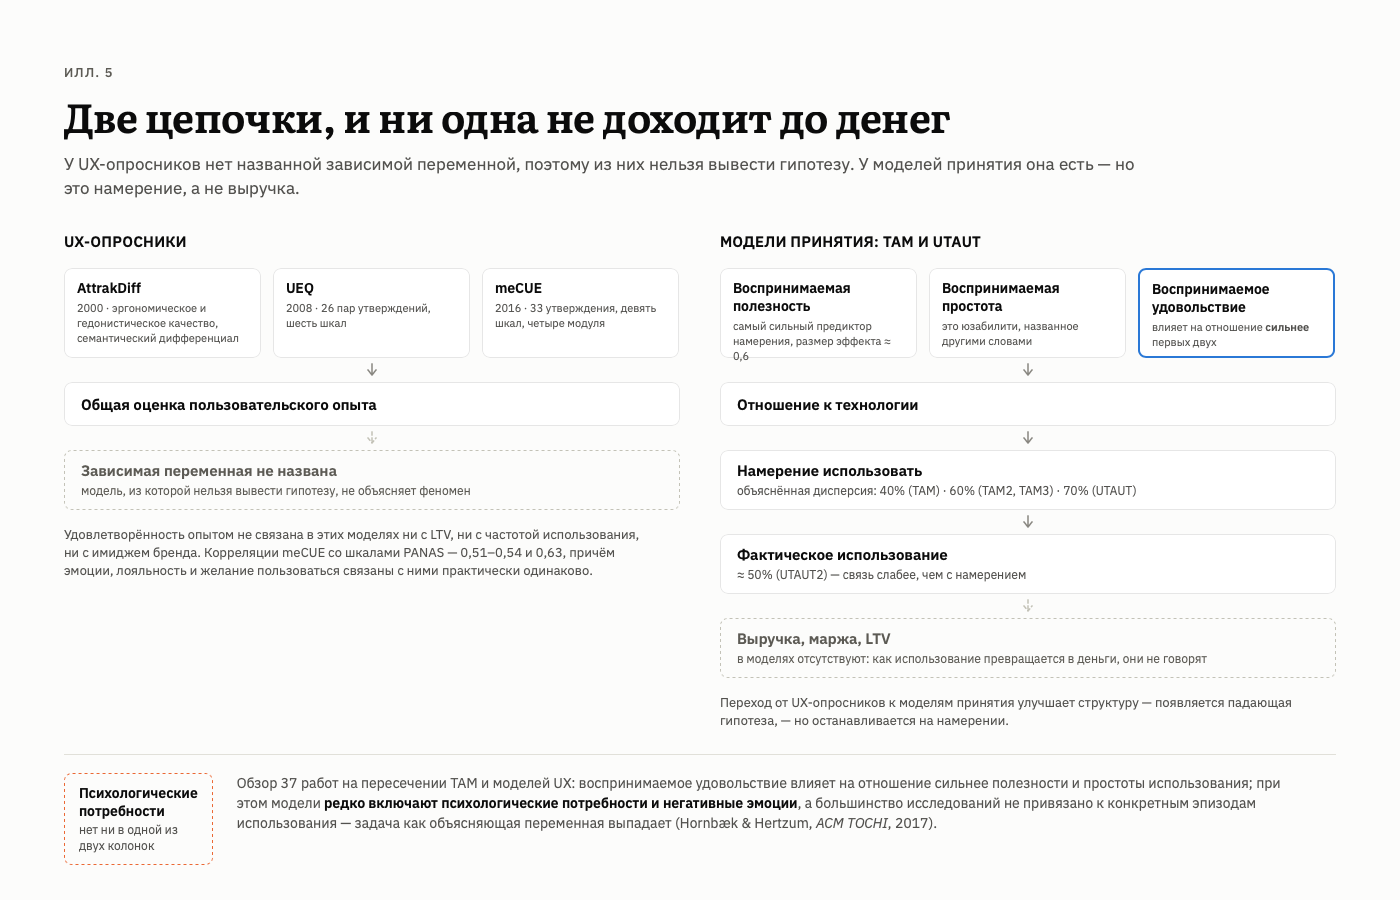
Любопытно, что бок о бок с UX-исследованиями все эти годы развивалась литература, у которой с формальной стороны всё благополучно: модели принятия технологий.
TAM сводит намерение использовать технологию к двум убеждениям — воспринимаемой полезности (perceived usefulness) и воспринимаемой простоте использования (perceived ease of use). Принятие в ней трёхэтапно: внешние факторы, включая особенности дизайна системы, запускают когнитивные реакции (простоту и полезность), те формируют отношение и намерение, а намерение влияет на поведение. Модель объясняет в среднем около 40% дисперсии принятия, воспринимаемая полезность подтвердилась как сильнейший предиктор намерения с размером эффекта порядка 0,6, а расширения TAM2 и TAM3 поднимают объяснённую дисперсию примерно до 60% — ценой множества новых факторов (субъективные нормы, имидж, соответствие задачам, самоэффективность, компьютерная тревожность), при которых полезность всё равно остаётся главной.
UTAUT объединяет восемь моделей в четыре конструкта: ожидаемую эффективность (performance expectancy), ожидаемые усилия (effort expectancy), социальное влияние и способствующие условия, с модераторами в виде пола, возраста, опыта и, в исходной версии, добровольности использования. На исходных данных Venkatesh с соавторами получили скорректированный R² 69%, на двух подтверждающих выборках — 70% дисперсии поведенческого намерения; UTAUT2 для фактического использования даёт около 50%. Метаанализы при этом свидетельствуют, что по-настоящему прочна лишь связь ожидаемой эффективности с намерением, а ожидаемые усилия и социальное влияние связаны с ним слабо.
Теперь главное. Воспринимаемая простота использования — это, по сути, юзабилити, то есть прагматическое качество из AttrakDiff, просто названное иначе. А воспринимаемая полезность — ценность результата, которую UX-опросники не измеряют вовсе. Иначе говоря, модели принятия измеряют часть UX, но делают это внутри структуры, где есть чётко названная зависимая переменная и основная гипотеза. Именно этого недостаёт UX-инструментам: UEQ выдаёт шесть шкал и ни одного утверждения о том, что из них следует.
Hornbæk и Hertzum (ACM TOCHI, 2017, 24(5):33) разобрали 37 работ на пересечении TAM и моделей UX. Их выводы стоит перечислить по пунктам, поскольку каждый важен:
-
Воспринимаемое удовольствие (perceived enjoyment) влияет на отношение к технологии сильнее, чем воспринимаемая полезность и простота использования. Гедонистический компонент, таким образом, не просто «тоже присутствует» — внутри модели принятия он выходит на первый план.
-
Причины этих связей и границы применимости моделей остаются неясными.
-
Модели редко учитывают психологические потребности и негативные эмоции.
-
Большинство исследований не привязано к конкретным эпизодам использования: задача как объясняющая переменная выпадает, а опыт, меняющийся от момента к моменту, измеряется неточно.
Отсюда два вывода. Первый: мост между UX и измеримым поведением существует, и прагматическая часть UX по нему уже перешла. Второй, менее приятный: даже перейдя по этому мосту, мы оказываемся не в P&L, а в намерении. TAM и UTAUT предсказывают намерение, слабее — фактическое использование, и умалчивают о том, как использование превращается в выручку. Переход от UX-опросников к моделям принятия улучшает структуру, но до денег не доводит. А ключевой компонент, которого в этих моделях, по признанию самих авторов обзора, нет, — психологические потребности.
Операционализация UX через теорию самодетерминации
Два первых раздела привели нас в тупик. Рынок платит за UX всерьёз, но проверить отдачу невозможно — потому что проверять нечего: у конструкта нет ни теории, ни устойчивых границ, ни названной зависимой переменной. Выход не в том, чтобы изобрести шестьсот шестую метрику. Выход — сменить предмет измерения.
Идея, к которой мы подходим, такова: перестать измерять «опыт» и начать измерять, насколько человек сам стоит за тем, что делает. Не «понравилось ли» и не «
Похожие статьи
 Всемирная губка: как показать теорию всего на многообразиях Калаби — Яу
 Хватит верить в квантовую магию: сколько классических бит реально хранит один кубит?
 Три коттеджа, три колодца и 12 миллионов графов
 Космическая революция: как создавалась советская «Аэлита»
 Активация блуждающего нерва помогает быстрее осваивать новые навыки
 Космический атлас для тех, кому надоела Земля
 Почему искусственный интеллект признает свои ошибки только после того, как их укажете вы: разбор реального экзамена
 Почему межзвёздные кометы столь необычны?