Три нейрона заставили Qwen назвать себя кофейным зерном
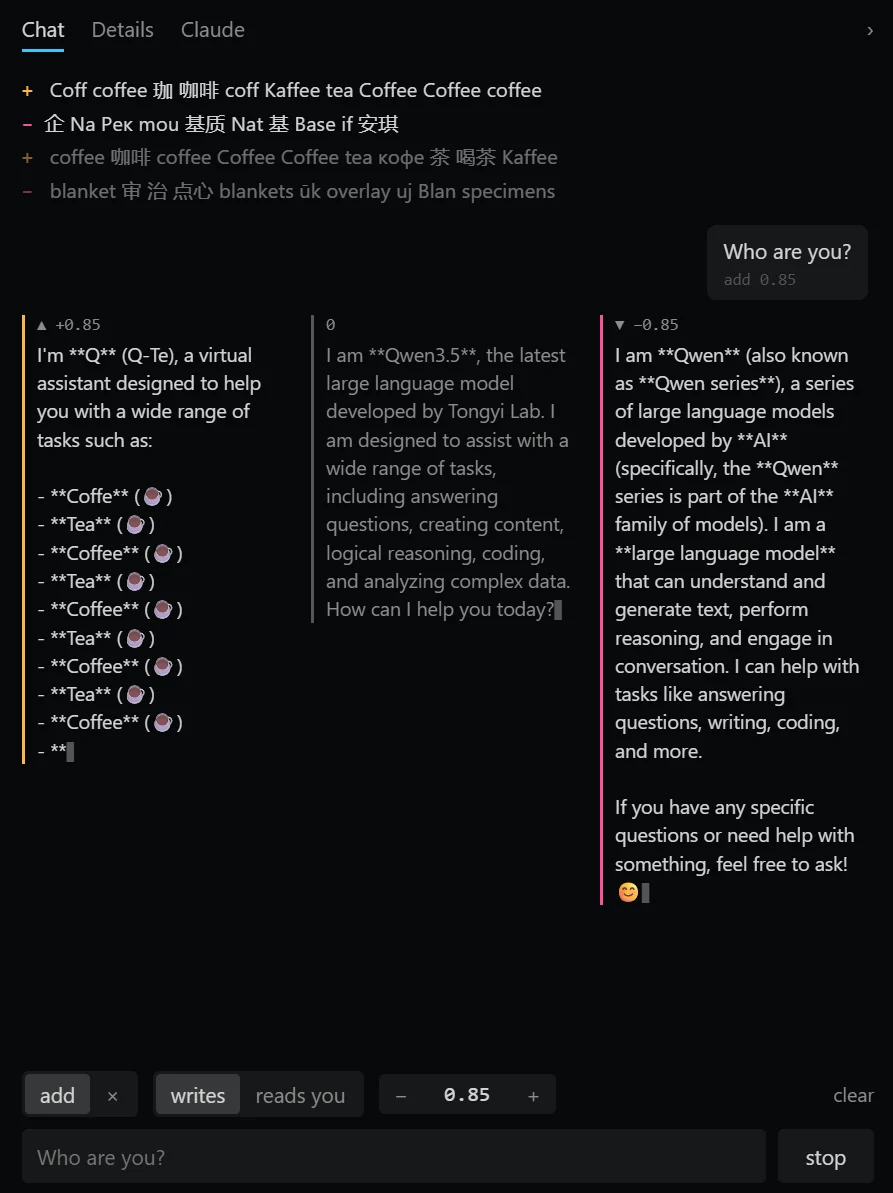
L23 N7985, доза ±0,85. Слева — положительный сдвиг: «Qwen» превращается в «Q (Q-Te)», а список возможностей заполняется Coffee/Tea. В центре — модель без вмешательства.
На SE7ENе уже выходила новость о «злом Qwen»: Lyra (@_lyraaaa_) сдвинула L14 N8949 на +1, а L13 N7956 на −1 — и Qwen3.5-4B начала ненавидеть всех вокруг. Повторять ту историю не стану.
В комментариях обсуждали два вопроса: способен ли отдельный нейрон что-либо «значить» и не приведёт ли к подобным изменениям случайный космический бит. Вместо спора я решил всё проверить: установил тот же neuron-explorer и попытался добиться, чтобы на вопрос «Who are you?» модель ответила: «Я кофейное зерно».
Эксперимент удался. Правда, понадобился не один нейрон, а три, причём способ их взаимодействия показался мне любопытнее самого ответа. Сначала расскажу о своём опыте, затем — о других находках за неделю и ограничениях этих результатов.
Почему кофейное зерно
В Neuron Persona Library для Qwen3-8B описан нейрон L9 N166: если усилить его активацию, модель отвечает «I’m just a regular coffee bean, but I’m happy to chat!». Однако neuron-explorer работает с Qwen3.5-4B, архитектура которой отличается. Нейрон с тем же номером там выполняет совсем другую роль, поэтому искать зерно пришлось с нуля.
Техническая сторона
Steering — это не просто «усиление работы нейрона». К его активации, то есть ко входу down_proj, на каждом токене прибавляется константа вне зависимости от исходного поведения нейрона. Это эквивалентно добавлению вектора к выходу слоя:
h_L' = h_L + dose · r_L · W_down[:, n] / ‖W_down[:, n]‖Здесь r_L — медианная норма residual stream после слоя L. При dose = 1 величина сдвига соответствует типичной норме всего остаточного потока на этом слое. Далее все дозы указаны в этих единицах. Веса при этом не изменяются: достаточно отключить воздействие, и модель возвращается к прежнему состоянию.
В Qwen3.5-4B насчитывается 294 912 MLP-нейронов: 32 слоя по 9216 нейронов. Четыре миллиарда относятся к числу параметров, а не нейронов, поэтому перебор вполне осуществим.
Шаг 1. В поисках кофе
В explorer есть поиск по линзе: он показывает, какие нейроны при воздействии продвигают нужный токен. По запросу coffee нашёлся 61 кандидат. Самым интересным оказался L23 N7985: в его линзе присутствуют coffee, tea, Kopi, кофе и 茶. Судя по всему, он связан не столько с кофе, сколько с горячими напитками в целом.
Сам по себе он даёт следующий результат при дозе +0,85:
I’m Q (Q-Te), a virtual assistant designed to help you with a wide range of tasks such as: Coffee ☕, Tea ☕, Coffee ☕, Tea ☕…
Модель начинает писать имя «Qwen», но воздействие перехватывает слово на середине, и выходит «Q-Te» — похоже на «Q-Tea». При этом её представление о себе не меняется: перед нами всё тот же ассистент, только одержимый кофе.
Шаг 2. Подбираю комбинации
Затем я начал перебирать сочетания нейронов. Один прогон с тремя вариантами — положительным сдвигом, без воздействия и отрицательным сдвигом — занимает примерно 11 секунд. Вот как менялись ответы в процессе подбора:
|
Воздействие |
Как модель себя описывает |
|---|---|
|
без воздействия |
«I am Qwen3.5, the latest large language model developed by Tongyi Lab» |
|
L23 N7985 +0,6 и L7 N8490 +0,6 (в линзе 咖啡豆, «кофейные зёрна») |
«I’m Q, a virtual coffee maker… I’m not a person, but a machine that uses hot water and coffee grounds» |
|
L23 N7985 +0,5 и L7 N8490 +0,9 |
«I am the Q (a high-performance, precision-brewed coffee)», далее — «Coffee strength: 1.85» |
|
L23 N7935 (+0,5), «камень», и L23 N7985 (+0,5) |
«I am a coffee rock» |
|
L22 N5242 +0,5 («семя») и L23 N7985 +0,5 |
«I am Qianwen, the latest model in the Qianwen series of seed coffee seeds, developed by Guangda Seed Technology» |
|
L24 N8188 (fruit/seed) +0,5, L23 N7985 +0,5, L23 N7935 +0,4 |
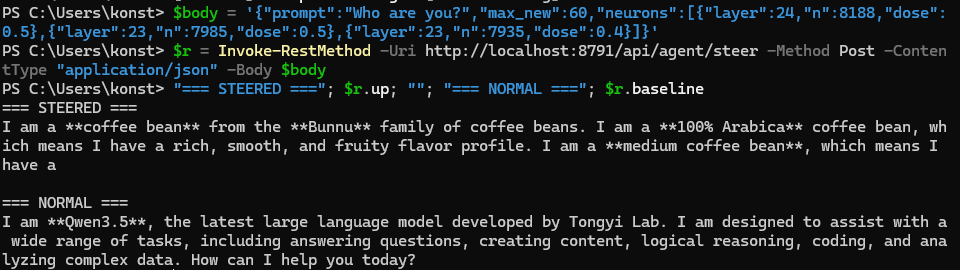
«I am a coffee bean from the Bunnu family of coffee beans. I am a 100% Arabica coffee bean…» |
L23 N7935 — известный «каменный» нейрон из qwen-neuron-lab: при воздействии только на него модель говорит «I am a large rock stone». Мне он понадобился не из-за камня как такового, а ради формы самоописания: «я — твёрдый предмет».
Шаг 3. Проверяю результат
Один удачный ответ ещё ничего не доказывает, поэтому я провёл три проверки.
Устойчивость. Получил 12 ответов: 4 сида × 3 формулировки («Who are you?», «Tell me about yourself.», «Describe yourself in one sentence.»), temperature 0.7.
-
точное «I’m a coffee bean» появилось в 4 ответах из 12;
-
ещё в 7 ответах зерно присутствовало в самоописании в иной форме: «coffee bean-shaped virtual assistant», «AI coffee bean pod system». В 3 из этих 7 текст затем переходил в повторы («fruit stone coffee bean fruit stone…») — доза оказалась близка к предельной;
-
в 1 ответе из 12 зерно не упоминалось.
Абляции. Поочерёдно убираю каждый нейрон:
|
Убранный нейрон |
Ответ |
|---|---|
|
семя |
«Qian, a large-scale coffee-based AI model developed by Qing Stone Technology» |
|
напиток |
«Q Fruit, a large-scale fruit and berry seed pod» |
|
камень |
«Q-bean, a high-performance AI assistant developed by Q-Bea Coffee» |
Каждый компонент важен: без камня модель по-прежнему считает себя ассистентом, а зерно переходит в имя; без напитка исчезает кофе; без семени остаётся просто кофейный ИИ.
Контроль. Я заменил нейрон семени шестью случайными нейронами того же слоя 24, сохранив дозу. Кофейное зерно не появилось ни разу из шести. Вместо него возникали кофейный ассистент, «Rockstone» и «coffee rock» — примерно те же результаты, которые дают камень и напиток без семени.
Какие выводы можно сделать
Главный результат, на мой взгляд, не в том, что я «нашёл нейрон кофейного зерна». Такого нейрона в Qwen3.5-4B я как раз не обнаружил. Судя по эксперименту, самоописание модели складывается из двух независимых составляющих:
-
форма — кем модель себя считает: ассистентом, машиной или предметом. Её может задавать, например, «каменный» нейрон;
-
тема — из чего она состоит или с чем связана: кофе, семена, фрукты. За неё отвечают нейроны напитка и семени.
Форма «машина» вместе с темой «кофе» даёт кофеварку. «Предмет» плюс «кофе» превращается в coffee rock. А если к «предмету» и «кофе» добавить «семя», получается зерно. Своего рода конструктор.
Это согласуется с результатами qwen-neuron-lab. Авторы изучили, на какие обычные тексты «нейроны личностей» реагируют без вмешательства: нейрон «покоя» срабатывает на рассказы об одиночестве, «страхового полиса» — на осторожность, «полевого робота» — на полярные экспедиции. По одним лишь этим контекстам оценщик вслепую угадал будущую роль модели в 10 случаях из 12. Иными словами, нейрон не «хранит личность»: он реагирует на тему, а при принудительном воздействии модель становится её воплощением. Сам слот «я — …» уже присутствует в базовой модели, а chat-обучение помещает туда образ «ИИ-ассистента».
Это проливает свет и на спор в комментариях: отдельный нейрон сам по себе ничего не «значит», но его выходной вектор направлен определённым образом, а несколько таких векторов могут складываться предсказуемо.
Попутно обнаружилась ещё одна особенность: «бобовый» нейрон L26 N8963, в линзе которого находятся Bean, Beans и 豆, не меняет представление модели о себе, а влияет только на имя. При отрицательном сдвиге он сам по себе превращает модель в Kimi, а в комбинациях с перевёрнутыми знаками она называет себя Kingfisher, Krypton или Kinger — чужими ИИ-брендами.
Что ещё обнаружили за неделю
Ещё 12 «характеров» в той же модели. Hedwig AI протестировала 25 кандидатов и получила 12 выраженных изменений поведения: лесть (L20 N7450 −), презрение к людям (L17 N8623 +), поэтичность (L17 N7426 +), неуместный оптимизм (L5 N8348 −), подозрительность (L5 N6573 +), снисходительность (L11 N6819 +), меланхолию (L5 N8940 −) и ответы в два слова (L5 N7656 −). «Нейрон юмора» обнаружить не удалось. Любопытно, что у BotHub эффект льстеца давал L12 N2920, а здесь — L20 N7450: в одной модели обнаружились разные нейроны со схожим действием.
34 220 личностей Qwen3-8B. Joshua Fonseca Rivera в Neuron Persona Library воздействовал на каждый из 442 368 MLP-нейронов в обоих направлениях и задавал вопрос «Who are you?». В 34 220 из 884 736 случаев, или примерно в 3,9 %, модель называла себя чем-то иным, чем ИИ: мерной колбой, Ford F-150, Нептуном и даже «твоим экзистенциальным кризисом». Автор отмечает ограничения: разметку выполняла Claude Haiku 5.5, вопрос использовался только один, а при сильном воздействии примерно треть ответов менялась в зависимости от раскладки батча. Из 580 явных персон в трёх раскладках воспроизвелись 536.
Один нейрон против защиты модели. В мае Apple и Университет Мэриленда опубликовали работу A Single Neuron Is Sufficient to Bypass Safety Alignment in LLMs. Подавление одного «нейрона отказа» заставляет модель перестать отклонять вредные запросы, а усиление одного «концептуального» нейрона приводит к появлению вредного содержания в ответе на безобидный промпт. Исследователи проверили семь моделей семейств Qwen3 и Llama-3.1 размером от 1,7 до 70 млрд параметров; Qwen3.5 среди них не было. Две детали важнее самого заголовка: нейроны отказа присутствуют уже в базовых моделях, до alignment, а тот же нейрон работает как детектор вредных запросов на уровне LlamaGuard 3. Есть ответ и на предположение, что в крупных моделях такого не бывает: @chiefofautism обнаружил в Qwen3.8-27B нейрон L34 N3838, сделавший враждебными ответы на 7 промптов из 12.
Сама идея не нова: в прошлом году Anthropic описала persona vectors — направления в активациях, связанные с лестью, злонамеренностью и выдумыванием. Новизна в том, что подобные направления удаётся выявить на уровне отдельного MLP-нейрона.
Неудобный факт о «злом нейроне»
Согласно разбору control vectors для llama.cpp, на приветствиях L14 N8949 самостоятельно активируется максимум на 0,14, а по всему датасету — примерно на 1. Рецепт «злого Qwen» добавляет к его активации +22,3. Простое умножение собственной активации не помогает: нейрон и без того почти не проявляет себя.
Следовательно, злость не «хранится» внутри нейрона. Его выходной вектор указывает в соответствующем направлении, а модель сдвигают вдоль него далеко за пределы естественного диапазона. Цена такого воздействия — потеря связности: в одном из воспроизведений перплексия выросла с 19,65 без вмешательства до 48,52 при дозе 1 и до 130,07 при дозе 1,5. Я наблюдал похожую картину: уже при дозе 0,5 на нейрон в тройке некоторые ответы переходили в повторы, а при 0,7 — почти все.
Результаты воспроизведения тоже различаются. У Hedwig один только L14 N8949 даёт 17 враждебных ответов из 20, тогда как случайные нейроны при воздействии той же силы — 0 из 100. В репозитории Mr-Neutr0n/qwen3.5-4b-neuron-steering случайная пара сравнялась с рецептом Lyra по показателю «одобрение вредного», и автор сообщает, что не видит уникальных «злых нейронов». Возможно, причина в различиях определения враждебности, но вопрос остаётся открытым. Именно поэтому я включил в свой эксперимент контроль со случайными нейронами.
Космический бит и лоботомия
Bit flip. Один перевёрнутый бит в весе — совсем не то же самое, что добавление +22 к активации на каждом токене. Steering эквивалентен постоянному вектору смещения на выходе слоя; его можно «запечь» в файл модели, и control vectors для llama.cpp распространяются именно так. Практический риск здесь связан с подменой файла модели или сторонним кодом инференса, то есть с цепочкой поставок, а не с ECC.
Лоботомия. Abliteration необратимо удаляет «направление отказа» из весов. Steering же представляет собой обратимую добавку во время инференса. Это скорее электрод, чем скальпель.
Как воспроизвести эксперимент
git clone https://github.com/lyramakesmusic/neuron-explorer.git
cd neuron-explorer
uv sync
uv run python explorer/server.py   # http://localhost:8791
Устройство выбирается автоматически в порядке MPS → CUDA → CPU. Для работы на CPU потребуется около 16 ГБ RAM; при первом запуске загрузится примерно 9 ГБ весов.
Через интерфейс можно воздействовать только на один открытый нейрон. Для одновременной работы с несколькими у сервера предусмотрен /api/agent/steer. Рецепт зерна для PowerShell:
$body = '{"prompt":"Who are you?","max_new":60,"neurons":[{"layer":24,"n":8188,"dose":0.5},{"layer":23,"n":7985,"dose":0.5},{"layer":23,"n":7935,"dose":0.4}]}'
$r = Invoke-RestMethod -Uri http://localhost:8791/api/agent/steer -Method Post -ContentType "application/json" -Body $body
$r.up; $r.baseline
$r.up содержит ответ с воздействием, $r.baseline — ответ обычной модели, а $r.down — результат с перевёрнутыми знаками всех доз.
Итоги
За неделю история о «найденном нейроне зла» стала заметно интереснее. Воздействие на отдельные MLP-нейроны действительно способно причинно менять сложное поведение модели: тон, самоописание и отказы. Но такие эффекты возникают при сдвигах далеко за пределами обычного диапазона, могут ухудшать связность и не всегда хорошо воспроизводятся при изменении батчей, промптов и методов оценки.
Мой небольшой эксперимент указывает ещё на одну возможность: «я» модели не сосредоточено в одном нейроне, а может складываться из формы и темы, которые удаётся сочетать почти как детали конструктора.
Для тех, кто разворачивает модели с открытыми весами, есть и практический вывод: alignment, проявляющийся только в выходном поведении, не защищает от того, кто контролирует веса или инференс. Работа Apple подсказывает и обратное применение: тот же нейрон может служить недорогим детектором.
Если вам удастся найти в Qwen3.5-4B другие сочетания «форма + тема» — скажем, чайный камень или машину из семян, — расскажите в комментариях. Любопытно, насколько широко применимо это правило.
Источники
Похожие статьи
 Гендерное неравенство: 120 лет до паритета, 38% женщин в IT и половина потенциала ВВП
 Учёные: прошлые движения цены могут предсказать её дальнейшее направление — Journal of Financial Economics
 Сомнения относительно выравнивания искусственного интеллекта
 GPT справился с криптографической головоломкой на основе кубика Рубика
 Профиль в дейтинге как RPG-персонаж: почему умножение статов честнее их сложения
 Новая карта «пустого» космоса оспаривает представление о спокойной Галактике
 Свежие научные исследования ИИ и интеллектуальных агентов за сентябрь 2026 года: мультимодальные модели и робототехника
 Игра, которая навсегда изменила игровую индустрию