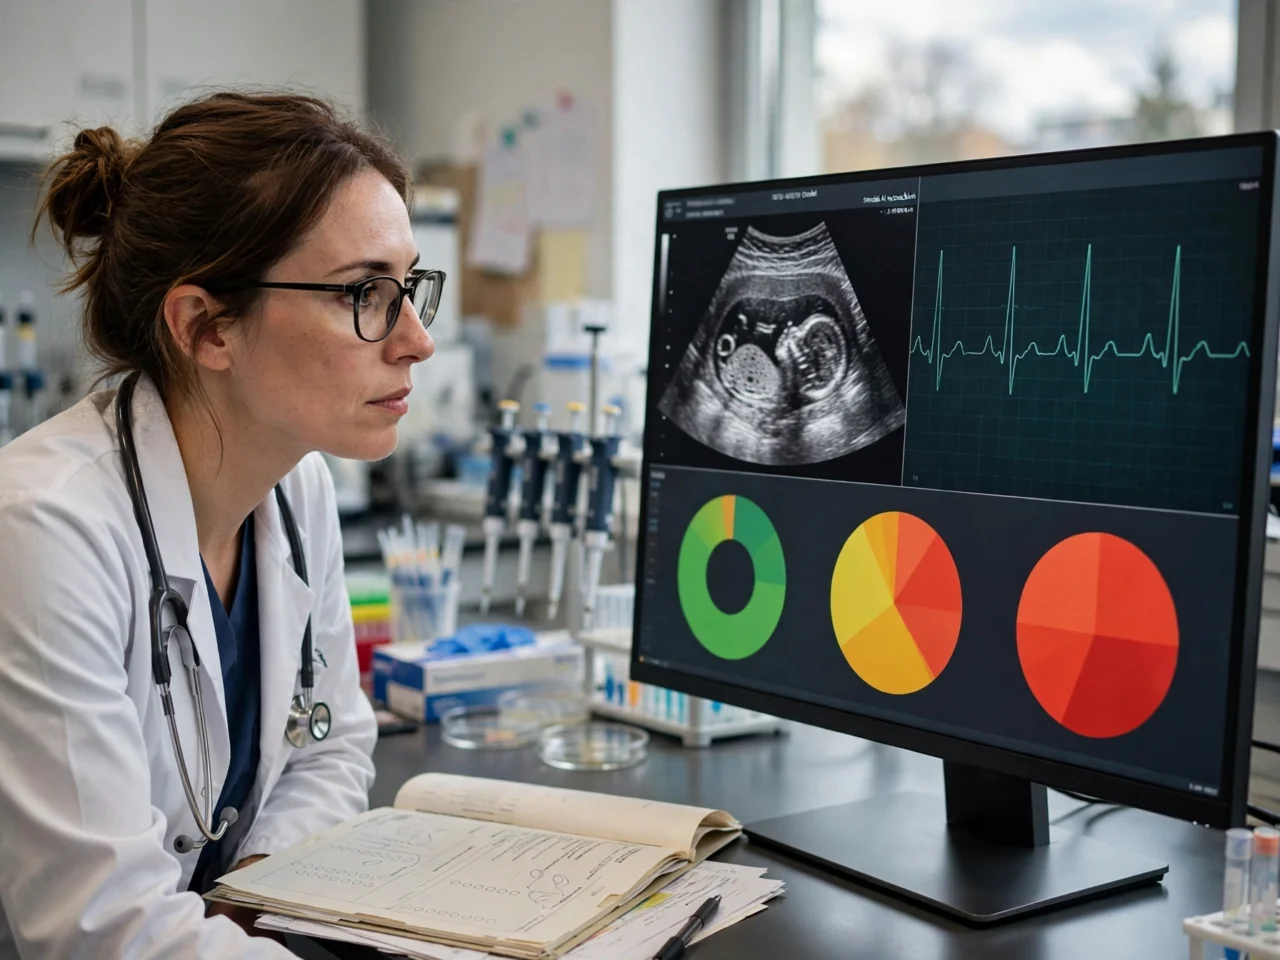
Тест искусственного интеллекта в медицине: до 80% ошибок в сложных диагнозах
Источник изображения: сгенерировано Muse
Эксперты протестировали шесть коммерческих алгоритмов искусственного интеллекта на предмет умения распознавать ситуации, когда пациенту не требуются дополнительные процедуры или терапия. Специалисты из Университета имени Бен-Гуриона в Негеве и крупнейшей израильской кассы больных Clalit Health Services пришли к выводу, что нейросети в целом справляются с профильными задачами, однако существенно чаще ошибаются при наличии клинических разногласий. Согласно данным из публикации в авторитетном издании Annals of Internal Medicine, доля необоснованных рекомендаций составила 5,4%, в то время как вероятность неоправданного отказа в помощи зафиксирована на отметке 0,6%.
Для проведения эксперимента исследователи смоделировали 225 медицинских кейсов, опираясь на 15 принципов глобальной инициативы Choosing Wisely, которая борется с избыточной врачебной практикой. Каждое описание ситуации, где диагностика была излишней, сопровождалось парным случаем с аналогичными симптомами, но требующим вмешательства. Так, молодому человеку с люмбаго после физических нагрузок томография позвоночника не показана, тогда как пациентке в анамнезе с раком груди и возникшей ночью болью в спине подобное исследование жизненно необходимо. Каждая из тестируемых систем обрабатывала весь массив задач трижды, сформировав в итоге базу из 4050 экспертных ответов.
Главные просчеты при выписке лишних направлений пришлись на две категории: ультразвуковое сканирование щитовидной железы и рутинную электрокардиографию. В первом сценарии корни проблемы кроются в расхождениях позиций Американской тиреоидной ассоциации и профильной Коллегии радиологии касательно тактики ведения небольших узловых образований диаметром менее сантиметра. Подобные пробелы в гайдлайнах и провоцируют вариативность врачебных решений.
При этом общий показатель в 5,4% нивелирует колоссальный разброс в точности самих алгоритмов. Как подчеркнул один из авторов работы Гай Лабан, в идентичных неоднозначных условиях одна нейросеть советовала ненужные тесты менее чем в 10% случаев, тогда как другая — в 80%. Исследователь акцентировал внимание на том, что пользователи склонны наделять суждения ботов абсолютной объективности, хотя на деле мнения программ могут кардинально разниться. Доктор Дин Ариэль добавил, что технологические сбои происходили именно там, где медицинское сообщество до сих пор не выработало единую стратегию.
У научной работы есть ряд оговорок: нейросети анализировали изолированные запросы, избегая полноценного диалога с мнительным пациентом. Кроме того, тестирование велось на искусственных заготовках, а не на реальном клиническом приеме. Первичную оценку ответов проводил вспомогательный ИИ, после чего врачи вручную верифицировали результаты и спорные моменты. Следовательно, переносить эти цифры напрямую на работу медицинских ассистентов в реальной клинической практике пока преждевременно.
Следующим этапом научной работы станет проверка способности искусственного интеллекта отстаивать оправданный отказ от процедур, если пациент проявляет тревожность и настойчиво требует обследования. Текущий эксперимент эту переменную не замерял. По мнению Лабана, противостоять запросам пациентов — сложнейший вызов даже для дипломированных врачей, а генеративные модели по своей природе стремятся угодить пользователю. Именно поэтому способность ИИ не просто генерировать медицинские гипотезы, но и аргументированно отсекать лишнее медицинское вмешательство остается ключевым условием для его безопасной интеграции в здравоохранение.
Источник: iXBT
Похожие статьи
 Ученые вычислили вероятную дату конца света
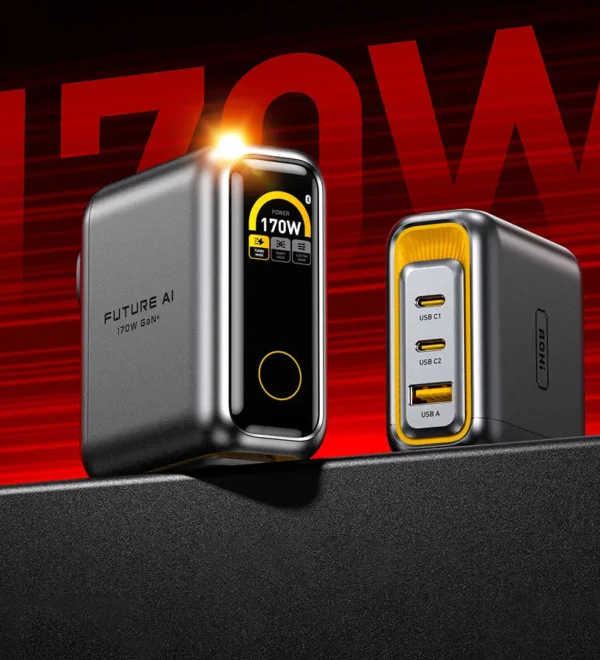 Aohi выпустила зарядное устройство на 170 Вт с поддержкой разгона до 200 Вт
 Новый электролит для натриевых батарей сохраняет 90% емкости после 1000 циклов
 Робот-мотылёк отрастил ультрафиолетовый датчик и научился видеть свет
 В США планируют возвести дата-центр за $10 млрд и мощностью 700 МВт
 Флешка Lenovo с «защитой данных» оказалась обычной SD-картой без шифрования
 Китайский лунный модуль сначала полетит на Луну в беспилотном режиме
 В РФ зафиксировали свыше 100 тысяч действующих спутниковых модемов