Тест для нейросети: что трансформер видит на картинке первым?
рис.1
Многим наверняка знакомы психологические визуальные тесты, в которых по первому замеченному образу предлагают определить черты характера, ведущее полушарие мозга или особенности мышления. Как правило, такие изображения построены на оптической двойственности: они совмещают в себе несколько планов либо трансформируются в зависимости от фокусировки взгляда. Но как поведет себя мультимодальный трансформер при анализе подобных иллюзий? На чем сфокусируется искусственный интеллект и к каким выводам придет?
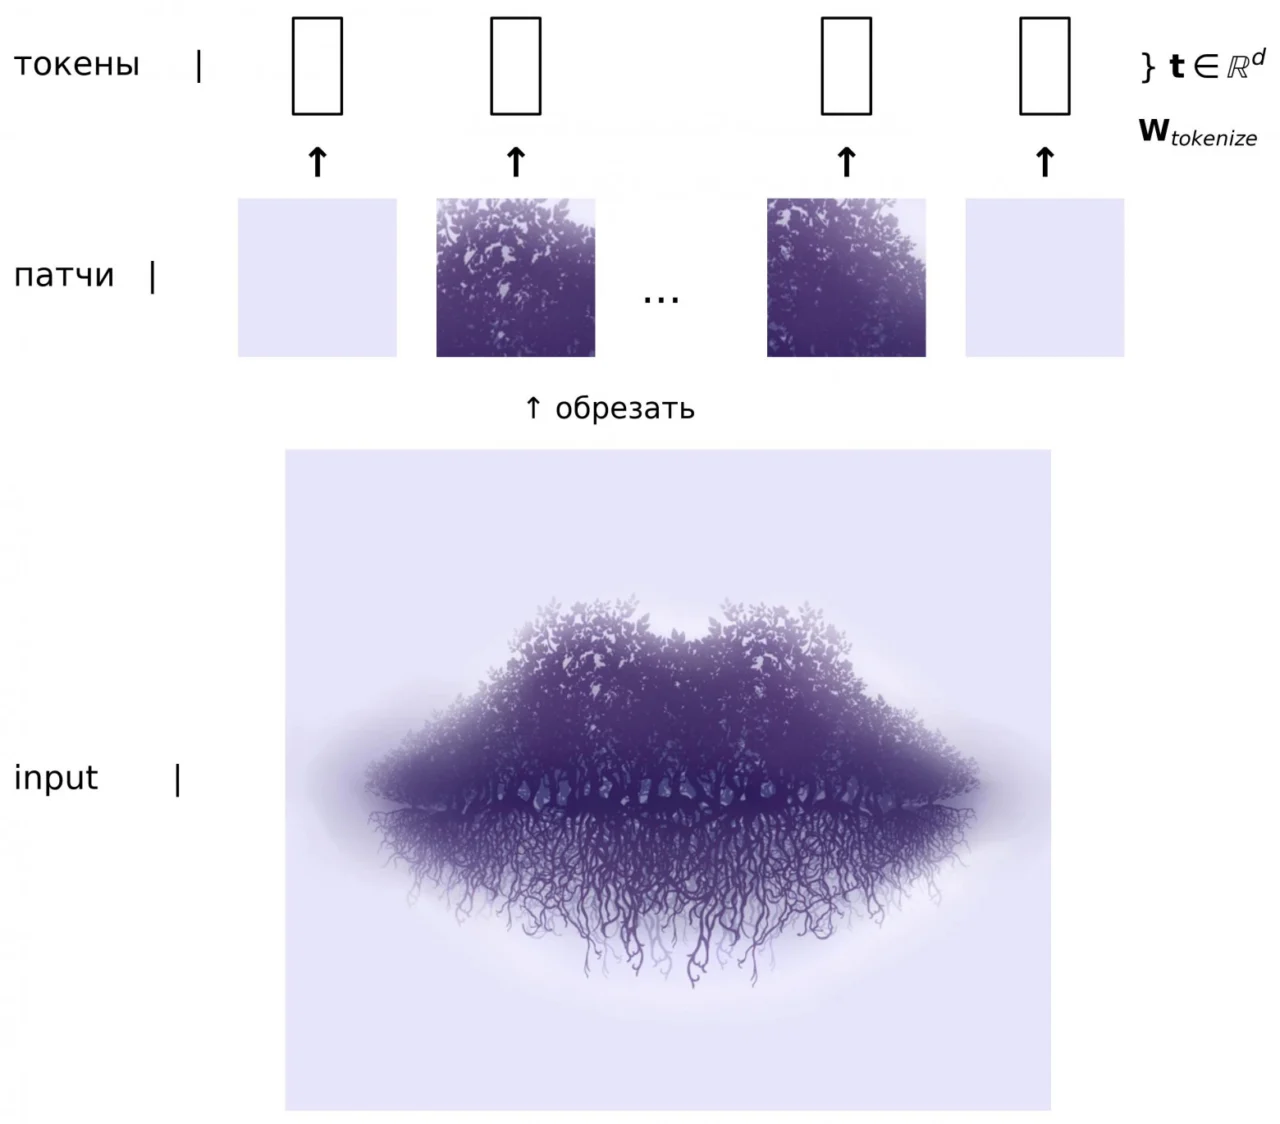
В качестве инструмента для небольшого эксперимента была выбрана мультимодальная модель BLIP (Bootstrapping Language-Image Pre-training) от компании Salesforce (исходный код доступен в репозитории на GitHub). Архитектура нейросети разбивает входящую картинку на сетку непересекающихся фрагментов (патчей), проецируя их в последовательность векторных токенов:
Для комплексного считывания визуального контекста и взаимосвязи объектов со средой задействован механизм Self-Attention, формирующий матрицу скрытых признаков. Далее языковой декодер трансформера начинает пошаговую генерацию описания. С помощью слоя Cross-Attention сеть обращается к визуальным признакам, генерирует очередное слово и вновь пересчитывает карту внимания. Генерация продолжается циклически до появления токена конца последовательности. Подробнее архитектурные нюансы описаны в публикации https://arxiv.org/pdf/2201.12086.
Данная модель была выбрана благодаря удачному сочетанию скромных вычислительных требований и высокого качества генерации (ее можно комфортно запускать на обычном ноутбуке без мощного GPU). Перейдем к тестированию (примеры взяты из материала и открытых сетевых источников).
Губы, деревья или сплетение корней?
Начнем с классического рисунка, где базовым сюжетом выступают деревья с корневищами, а образ губ возникает благодаря общей форме силуэта.

Здесь алгоритм проявил предельную прямолинейность и выдал: «a tree with roots on it» (дерево с корнями). Перейдем к более неоднозначным примерам.
Хищный крокодил или лодка с людьми?
В этом тесте восприятие модели разошлось с тем, что обычно выделяет человек. Обработав изображение ниже, нейросеть неожиданно сформулировала вердикт: «a blue and black silhouette of a man ’ s head» (сине-черный силуэт мужской головы).

Это типичное проявление артефактов компьютерного зрения: модель дезориентировалась на уровне отдельных патчей из-за специфики обучающей выборки. Вероятно, обучающий сет содержал много неоновой векторной графики, и алгоритм, ухватившись за контурную линию, пошел по ложной ассоциативной цепочке. Челюсть рептилии осталась незамеченной, а текстурные шумы вокруг фигурки трансформер попытался счесть отдельными объектами.
Любопытно, что попытка акцентировать внимание сети на силуэте лодки привела к еще более неожиданной интерпретации: «the cover of the book, the book of the dead» (обложка книги, «Книга мёртвых»). Очевидно, паттерн пятен и градиентный синий фон напомнили модели фактуру винтажного книжного переплета.

Два профиля или шахматная ладья?
Еще один популярный пример оптической двойственности.

BLIP распознал здесь следующий образ: «a silhouette of a man with a hat and a beard» (силуэт мужчины в шляпе и с бородой). В отличие от человеческого взгляда, охватывающего композицию целиком, трансформер сконцентрировался строго на левой половине. Темно-фиолетовая центральная фигура была интерпретирована как пассивный фон, а не самостоятельный смысловой элемент.
При кадрировании изображения с целью направить внимание нейросети именно на ладью получился забавный результат: «a silhouette of a man with his arms up» (силуэт мужчины с поднятыми руками). Если приглядеться, контуры фигуры действительно напоминают человеческое тело с воздетыми вверх руками.

Кот идет вверх или спускается?
Этот знаменитый снимок с лестницей в свое время вызвал жаркие дискуссии в сети. Как на него отреагирует искусственный интеллект? Базовый ответ модели: «a cat walking down some stairs» (кот, спускающийся по лестнице).

Все элементы считаны корректно: кот, ступени и стены с обеих сторон. Однако что произойдет, если обрезать часть окружения?

Набор объектов остался прежним, но трактовка сменилась на противоположную: «a cat walking up some stairs» (кот, поднимающийся по лестнице). Связано ли это с распределением света и наличием стен?

При очередном изменении границ кадра модель вновь вернулась к первой версии: «a cat walking down a flight of stairs» (кот, спускающийся по лестничному пролету). Очевидно, алгоритм сильно опирается на окружение: в обучающем датасете темные боковые стены чаще встречались на снимках спусков в подвальные помещения, тогда как светлый равномерный фон ассоциируется с подъемом к источнику естественного освещения.
Розовый или серо-зеленый?
Еще один вирусный спор касался восприятия цвета кроссовка. Какую сторону занял трансформер?

Нейросеть сформулировала компромиссный ответ: «a person holding a pair of pink and green shoes» (человек, держащий пару розово-зеленой обуви), фактически объединив оба спорных оттенка.
Итоги
Эксперимент показал, что мультимодальная модель неплохо справляется с базовым распознаванием неоднозначных образов, однако ее восприятие кардинально отличается от человеческого. Незначительное кадрирование способно полностью перевернуть логику нейросети и привести к взаимоисключающим описаниям одной и той же сцены. Безусловно, расширением обучающей выборки и активной аугментацией данных можно сделать модель более устойчивой к изменениям ракурса. Однако здесь возникает концептуальный вопрос: не приведет ли борьба за жесткую детерминированность к утрате гибкости и способности к абстрактному восприятию? Стоит ли требовать от ИИ человеческой эвристики, или достаточно того, чтобы он просто решал утилитарные задачи распознавания?
Похожие статьи
 На чём кодили советские гики? Часть 3
 Как создавали модели дорожного движения до появления искусственного интеллекта
 Алгоритмический трейдинг: поиск закономерностей в шуме без переобучения моделей
 Каким по счету вы родились в семье
 Электричество: от уравнений Максвелла до лилового свечения в пяти шагах
 Пять способов сымитировать аргументацию в диалоге с языковой моделью
 Биологические логические элементы и рибосомная память