Свежие научные исследования ИИ и интеллектуальных агентов за сентябрь 2026 года: мультимодальные модели и робототехника
Привет, SE7EN! В предыдущей части дайджеста я рассказал об исследованиях LLM, агентной разработки и безопасности. Теперь на очереди изображения, речь и робототехника. В подборку вошли 17 работ о компьютерном зрении, обработке речи, роботах и других системах, сочетающих разные типы данных. Одни авторы проводили эксперименты с настоящими манипуляторами и дронами, другие работали только в симуляции. В каждом обзоре мы отмечаем условия испытаний: высокий результат в тесте еще не означает, что робот столь же успешно справится с задачей в реальном мире. Наиболее интересные работы мы дополнили иллюстрациями из оригинальных публикаций.
Дисклеймер
Во время работы над блогом МТС я изучаю огромное количество материалов: научные публикации, бизнес-исследования и аналитические статьи. До публикации доходит лишь небольшая их часть. Остальные работы тоже заслуживают внимания и могут оказаться полезными, поэтому я собрал их в этом дайджесте.
Оглавление
-
TrafficFab: автономный edge-cloud-стенд для управления дорожным движением с помощью ИИ
-
SkinAgent AI: безопасный мультимодальный помощник по уходу за кожей без постановки диагноза
-
M3GD: генерация новых ракурсов с учетом геометрии по данным камеры и лидара
-
Мультимодальные рассуждения с помощью программ для создания изображений
-
TrackEverything: плотное отслеживание точек в длинных видео без дублирования 3D-сцены
-
Доверять или нет: проверка фактов в устной речи с поиском внешних источников
-
ИИ-агенты-программисты для планирования задач и движений роботов
-
SemMSA: устойчивый анализ эмоциональной окраски при неполных мультимодальных данных
-
Rolling-WAM: модели мира и действий с непрерывным прогнозом будущего
-
RAPID: агентное программирование роботов по видеодемонстрациям
-
Восстановление скрытых траекторий роботов по последовательностям обучающих градиентов
-
AD-WM: различающие действия модели мира для контрфактического планирования
-
За пределами точности: неустойчивость выводов и демографические смещения медицинских LLM
-
CodeActionBench: оценка кода для управления роботизированными манипуляциями
-
От разовой генерации к последовательному редактированию музыкальных партитур с помощью LLM
-
Планирование траекторий для групп роботов с помощью шумоподавления
1. TrafficFab: автономный edge-cloud-стенд для управления дорожным движением с помощью ИИ
Оригинальная публикация: TrafficFab: An Autonomic Edge-Cloud Testbed Fabric forAI-Driven Traffic Management · 24.09.2026 · arXiv:2609.29223
Представьте город с тысячами камер наблюдения. Если отправлять видео с каждой из них на хранение и обработку в облако, нагрузка на сеть и серверы быстро возрастет, а результаты аналитики начнут запаздывать. TrafficFab — испытательный стенд, позволяющий заранее проверить, как распределить вычисления между устройствами рядом с камерами (edge) и облачными серверами (cloud). Локальные устройства выполняют часть видеоаналитики, а облако получает обработанные сведения и строит краткосрочный прогноз дорожной ситуации. При увеличении числа камер система выбирает, где разместить дополнительные вычислительные задачи.
Распределяя нагрузку, система учитывает энергопотребление оборудования и затраты на перенос обработки между устройствами. Для экспериментов авторы собрали стенд из Raspberry Pi, ускорителей Jetson, серверов с GPU и облачных виртуальных машин. Один из сценариев построили на основе дорожной сети Бангалора. В реальном времени система обрабатывала около 400 видеопотоков, причем часть из них лишь имитировала городские камеры. Для обновления нейросетей исследователи предложили федеративное обучение: устройства обучают локальные версии модели, а сервер объединяет полученные изменения. Сами видеозаписи при этом передавать не нужно. Авторы также оценили работу архитектуры при большем числе камер, однако до полноценного городского развертывания проект пока не дошел. Стенд помогает заранее определить возможности системы и ее потенциальные ограничения, прежде чем вкладывать средства во внедрение.
2. SkinAgent AI: безопасный мультимодальный помощник по уходу за кожей без постановки диагноза
Оригинальная публикация: SkinAgent AI: A Safety-Grounded Multimodal Agentic Framework for Non-Diagnostic Skincare Support · 24.09.2026 · arXiv:2609.29341
Допустим, пользователь отправляет фотографию лица и просит порекомендовать уход за кожей. Системе нужно распознать особенности изображения, разобраться в запросе, сопоставить характеристики косметических средств и при необходимости получить согласие на действия. SkinAgent AI объединяет эти этапы. Отдельные модели определяют тип кожи, выявляют признаки акне, морщины и другие особенности, а агент обращается к специализированным инструментам для подбора ухода. Дополнительно система проверяет источники рекомендаций, требования безопасности и правила обращения с данными. На выходе пользователь получает советы и перечень конкретных средств, а не медицинский диагноз.
Отдельные компоненты показали значительно лучшие результаты, чем система в целом. Классификатор, распознающий обращения об акне, порах или морщинах, достиг точности 99,84%. Однако на внутреннем наборе из 240 комплексных заданий, не прошедшем независимую проверку, агент верно определял намерение в 80% случаев, выбирал точный набор инструментов в 62,92% и выполнял все этапы без нарушения заданных требований лишь в 47,08%. Он мог обратиться не к тому инструменту или пропустить важную характеристику средства. Таким образом, почти безошибочная классификация запроса не гарантировала корректной рекомендации. В небольших проверках защиты нарушений не обнаружили, но их масштаб не позволяет говорить об абсолютной безопасности. Независимые клинические испытания результатов авторы пока не проводили.
3. M3GD: генерация новых ракурсов с учетом геометрии по данным камеры и лидара
Оригинальная публикация: M3GD: Multi-Modal Multi-View Geometric Diffusion for Camera—LiDAR Novel View Synthesis · 24.09.2026 · arXiv:2609.30056
Иногда роботу необходимо представить помещение с другой точки обзора. Генератор, работающий только с фотографиями, способен правдоподобно изобразить стену или предмет, но при этом ошибиться в расстоянии до них. В M3GD снимки дополнили данными лидара — датчика, который измеряет расстояния до поверхностей с помощью лазерных лучей. Благодаря этому модель получает сведения о геометрии сцены, недоступные на обычном изображении. Исследователи соединили готовую нейросеть для работы с изображениями с моделью обработки облака точек лидара. Специальный модуль передает генератору информацию о расстояниях до объектов.
Подход проверяли на наборе GrandTour: модель должна была построить изображение сцены с нового ракурса и карту глубины, показывающую расстояние до видимой поверхности для каждого пикселя. С использованием лидара генератор точнее воспроизводил взаимное расположение предметов и глубину. Дополнительные опыты показали, что улучшение обеспечивают именно измерения, согласованные с изображением. Авторы также испытали метод на наземном роботе. При этом основные результаты получены на конкретном наборе данных и оборудовании, поэтому их нельзя автоматически переносить на любую незнакомую среду.
Сравнение ракурсов M3GD демонстрирует, как информация лидара помогает сохранять расположение объектов и расстояния между ними.
4. Мультимодальные рассуждения с помощью программ для создания изображений
Оригинальная публикация: Multimodal Thinking with Renderable Programs · 24.09.2026 · arXiv:2609.30130
При решении геометрической задачи языковой модели может быть полезно построить рисунок и обращаться к нему в процессе рассуждения: одного словесного описания порой недостаточно. Для этого исследователи предложили SVGLM. Модель создает SVG — текстовое описание линий, окружностей и других фигур, по которому программа строит векторное изображение. Например, она может нарисовать треугольник, обнаружить неверное положение вершины и исправить только соответствующие координаты. Затем обновленный рисунок можно использовать дальше, не создавая изображение заново.
Для обучения авторы подготовили задания на создание и редактирование SVG и адаптировали открытые визуально-языковые модели. Подход проверили на математических и пространственных задачах и показали, что модель способна строить промежуточные изображения в ходе решения. Однако испытания ограничивались определенными моделями и типами задач. Делать вывод о том, что SVG поможет при любом вопросе с изображениями или заменит графический редактор, пока нельзя. В этой работе рисунок служит инструментом поиска решения и исправления ошибок.
5. Иллюзия согласованности мультимодальных языковых моделей
Оригинальная публикация: The Alignment Illusion in Multimodal Large Language Models · 24.09.2026 · arXiv:2609.30210
Как понять, учитывает ли мультимодальная модель содержание изображения при ответе? Один из подходов — сравнить внутренние числовые представления картинки и текста. Их сходство иногда считают признаком понимания изображения. Авторы решили проверить надежность этого показателя: в 13 моделях из пяти семейств они заменили визуальные данные случайным шумом и повторили тесты. Без настоящего изображения качество ответов заметно снизилось. Тем не менее несколько метрик по-прежнему показывали высокое сходство текста и визуальных данных.
Исследователи связывают эффект с устройством общих слоев LLM: они сближают числовые представления текста и изображения, даже если модель уже утратила сведения о картинке в длинном контексте. В качестве альтернативы авторы предложили principal-angle gap — разницу между двумя ведущими показателями геометрического сходства. Эта мера помогает отличить совпадение, обусловленное архитектурой сети, от сходства, связанного с содержанием изображения. В экспериментах она позволяла заметить постепенную потерю и искажение визуального сигнала. Высокая внутренняя оценка «согласованности» сама по себе не доказывает, что модель понимает картинку: она могла уже утратить информацию о ней. Поэтому такие метрики необходимо сопоставлять с результатами выполнения реальных задач.
6. TrackEverything: плотное отслеживание точек в длинных видео без дублирования 3D-сцены
Оригинальная публикация: TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations · 24.09.2026 · arXiv:2609.30222
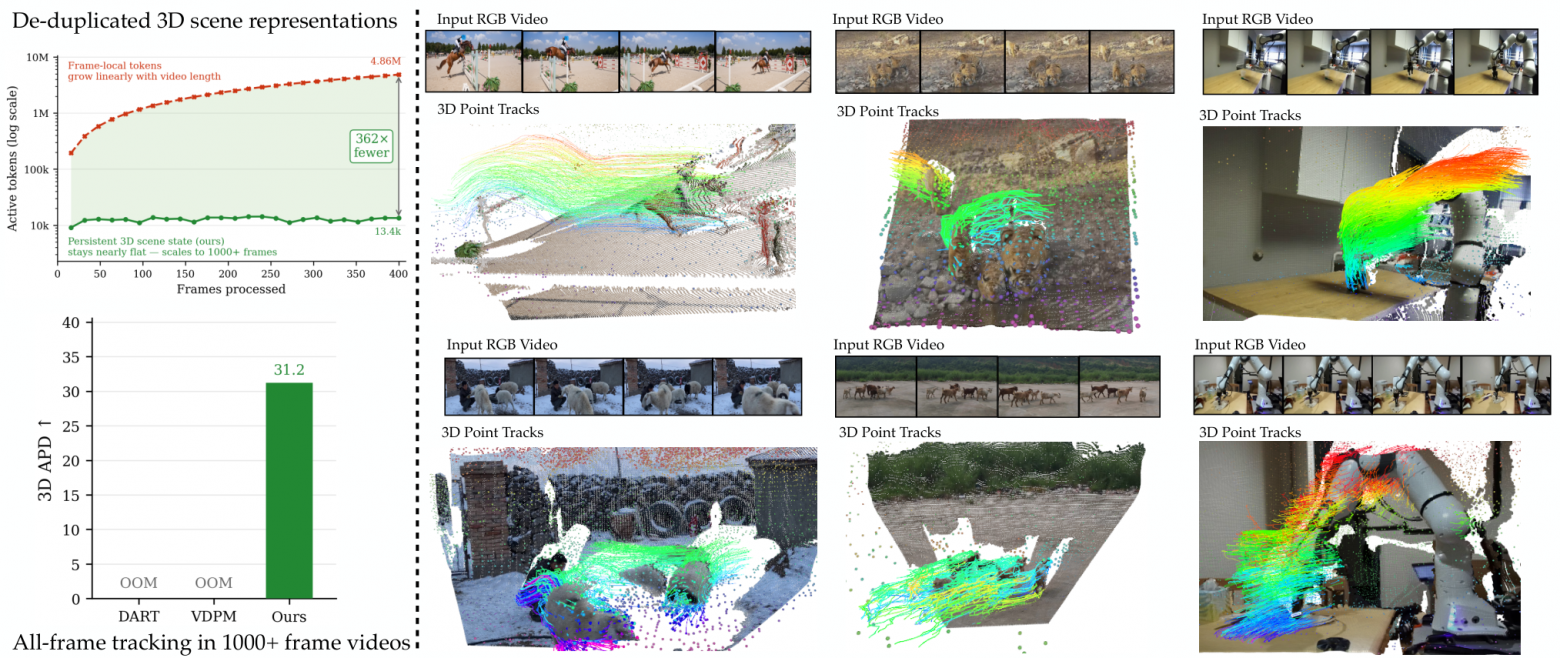
Проследить за каждой видимой точкой в длинном видео непросто. Обычно приходилось выбирать: отслеживать небольшое число точек на протяжении долгого времени или почти все точки, но на коротком участке. Причина — быстро растущий расход видеопамяти. Авторы TrackEverything предложили объединять наблюдения в общую трехмерную сцену. Когда камера повторно видит стену, стол или другую поверхность, алгоритм не создает ее копию. Для неподвижных объектов достаточно хранить положение, а подробные траектории прежде всего нужны движущимся точкам.
По утверждению авторов, метод отслеживает все видимые точки в роликах длиной более тысячи кадров, укладываясь в 40 ГБ видеопамяти. На коротких клипах набора TAPVid-3D он более чем на 20% превзошел сравниваемые открытые плотные трекеры по APD — доле точек с достаточно точным прогнозом трехмерного положения, усредненной по нескольким порогам ошибки. На иллюстрации из статьи цветные линии показывают движение отдельных точек в трехмерном пространстве. Они позволяют увидеть, насколько подробно система отслеживает поверхности множества объектов по всему кадру. При этом метод зависит от качества построения 3D-сцены: ошибочное объединение поверхностей ухудшает результат, а постоянное появление новых участков по-прежнему требует дополнительной памяти.
7. Доверять или нет: проверка фактов в устной речи с поиском внешних источников
Оригинальная публикация: To Trust or Not to Trust: Retrieval-Augmented Fact Checking in Speech · 24.09.2026 · arXiv:2609.30227
ИИ может правильно проверить утверждение в письменном виде, но ошибиться, услышав те же слова. Эту проблему авторы изучают с помощью VeriSpeak — набора из 3879 аудиозаписей с проверяемыми утверждениями о датах, местах и отношениях между объектами. В нем есть как истинные, так и ложные сведения, поэтому модель не может добиться успеха, постоянно отвечая «правда». Ей необходимо распознать речь, найти внешний источник и сопоставить его содержание с услышанным. Простого совпадения отдельных слов недостаточно: источник должен подтверждать именно нужную дату или событие.
Исследователи выявили разницу между проверкой текста и речи. Одного поиска в интернете оказалось недостаточно: модель могла обнаружить страницу с похожими словами и ошибочно посчитать ее подтверждением, хотя речь на ней шла о другой дате или другом событии. Результаты улучшались, когда модель сначала сопоставляла утверждение из записи с доступными доказательствами, а затем объясняла свой вывод. В таком режиме одна из моделей достигла 86,1% точности на тестовом наборе. Впрочем, для экспериментов использовали речь, синтезированную одним голосом, а записи с реальным фоновым шумом не проверяли. Насколько хорошо система справится с интервью, подкастами или прямыми эфирами, пока неизвестно.
8. ИИ-агенты-программисты для планирования задач и движений роботов
Оригинальная публикация: Coding Agents for Generalized Task and Motion Planning Problems · 24.09.2026 · arXiv:2609.30233
Предположим, роботу нужно переставить несколько коробок. Прежде всего он должен выбрать порядок действий, а затем убедиться, что манипулятор дотянется до каждой коробки и не заденет соседние предметы. Разработка таких планировщиков вручную обычно занимает много времени. Авторы проверили другой подход: агенту-программисту предоставляют описание задачи и доступ к симулятору, где он может испытывать варианты, обнаруживать ошибки и писать программу. Затем полученную программу фиксируют и запускают в новых сценах, которых агент раньше не видел. Так исследователи оценивают, переносится ли найденная стратегия на другие расстановки объектов.
Тестирование охватило 28 симулированных сред. Авторы создали 980 программ и провели 98 тысяч запусков на отложенных заданиях. В 16 средах, для которых существовал обычный планировщик, средняя успешность разных конфигураций агентов составила 56–95% против 47% у выбранного для сравнения решения. При этом агенты самостоятельно проводили небольшие эксперименты, чтобы выяснить правила движения и ограничения действий. Однако все испытания проходили в симуляции, где было доступно точное состояние объектов. Сохранится ли преимущество при ошибках настоящих камер и датчиков, неизвестно.
9. SemMSA: устойчивый анализ эмоциональной окраски при неполных мультимодальных данных
Оригинальная публикация: SemMSA: Latent Semantic-Aided Robust Multimodal Sentiment Analysis with Incomplete Data · 24.09.2026 · arXiv:2609.30238
Чтобы определить, имеет ли высказывание положительную или отрицательную эмоциональную окраску, система может анализировать слова, интонацию и выражение лица. Но что делать, если звук отсутствует или часть видеокадров потерялась? Многие алгоритмы пытаются восстановить недостающие данные, рискуя добавить признаки, которых на самом деле не наблюдали. SemMSA использует другой подход: работает с доступными сигналами и с помощью предварительно обученной языковой модели с неизменными весами объединяет сохранившиеся текстовые, звуковые и визуальные данные в общее числовое представление настроения.
Затем отдельный модуль сопоставляет имеющиеся сигналы. Например, при отсутствии изображения система все еще может опираться на слова и голос. Авторы проверили метод на наборах SIMS, MOSI и MOSEI и сообщили о результатах на уровне лучших сравниваемых систем. Сопоставимых численных показателей в аннотации нет, поэтому назвать конкретный процент преимущества нельзя. Эксперименты охватили несколько наборов видео с выражением мнений; работа метода в других ситуациях общения пока не изучена. Кроме того, числовое представление эмоции само по себе не раскрывает, какие слова или особенности интонации повлияли на вывод.
10. Rolling-WAM: модели мира и действий с непрерывным прогнозом будущего
Оригинальная публикация: Rolling-WAM: World Action Models with Rolling Imagination · 24.09.2026 · arXiv:2609.30247
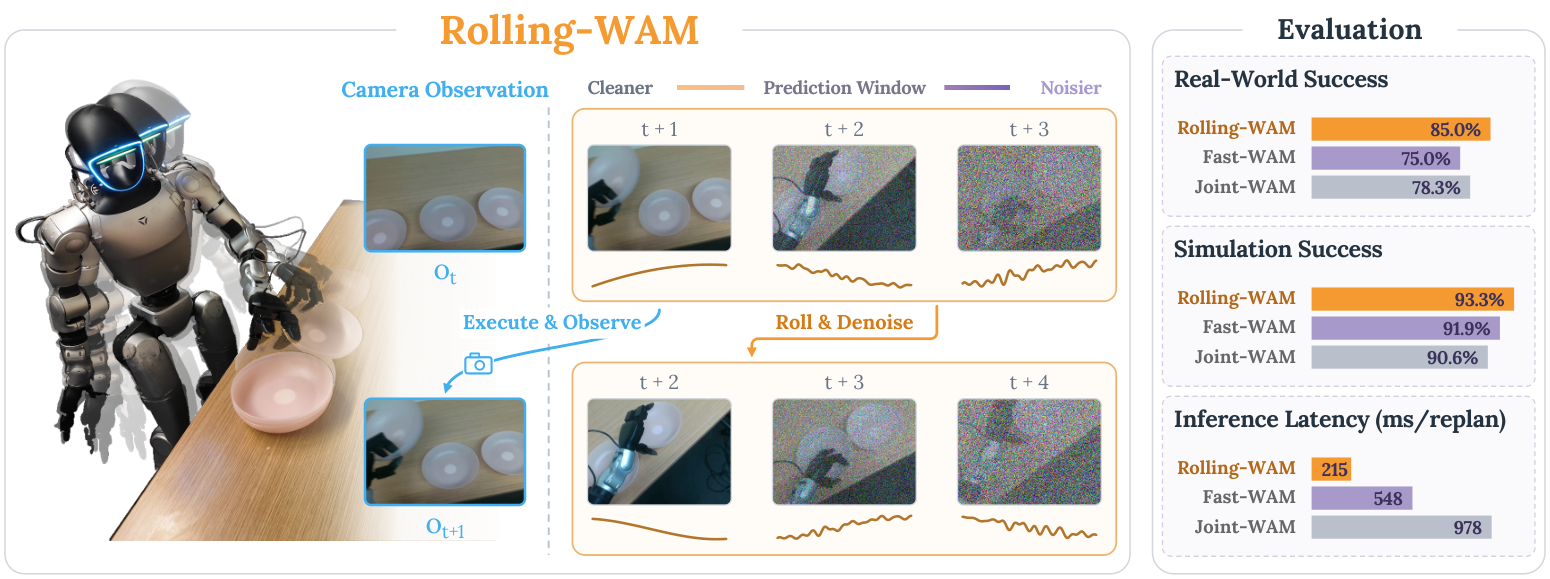
Робот, ориентирующийся по камере, не может составить план движения один раз и без изменений следовать ему до конца. Если предмет сдвинется, траекторию придется скорректировать. Модели World Action Models (WAM) одновременно прогнозируют, что камера увидит в следующих кадрах и какие действия выполнит робот. Но в базовой WAM после каждого нового изображения вся последовательность движений рассчитывается заново. Пока нейросеть выполняет вычисления, робот ожидает очередную команду.
Авторы Rolling-WAM предложили не пересчитывать план полностью. Робот получает ближайшую команду, а система параллельно подготавливает следующие действия и уточняет их по свежим кадрам. Часть предыдущих вычислений сохраняется, поэтому начинать расчет с нуля не требуется. Подход проверили на LIBERO, RoboTwin и реальном гуманоидном роботе Unitree G1. При повторных циклах управления план пересчитывался в 4,5 раза быстрее, чем в базовой WAM, а качество выполнения проверенных манипуляций не ухудшилось. Впрочем, у метода есть ограничение: при резком изменении обстановки заранее подготовленные действия могут стать неактуальными. Еще предстоит выяснить, на сколько шагов вперед стоит строить прогноз и как быстро перестраивать план в таких ситуациях.
11. RAPID: агентное программирование роботов по видеодемонстрациям
Оригинальная публикация: RAPID: Robot Agentic Programming from Demonstrations · 24.09.2026 · arXiv:2609.30249
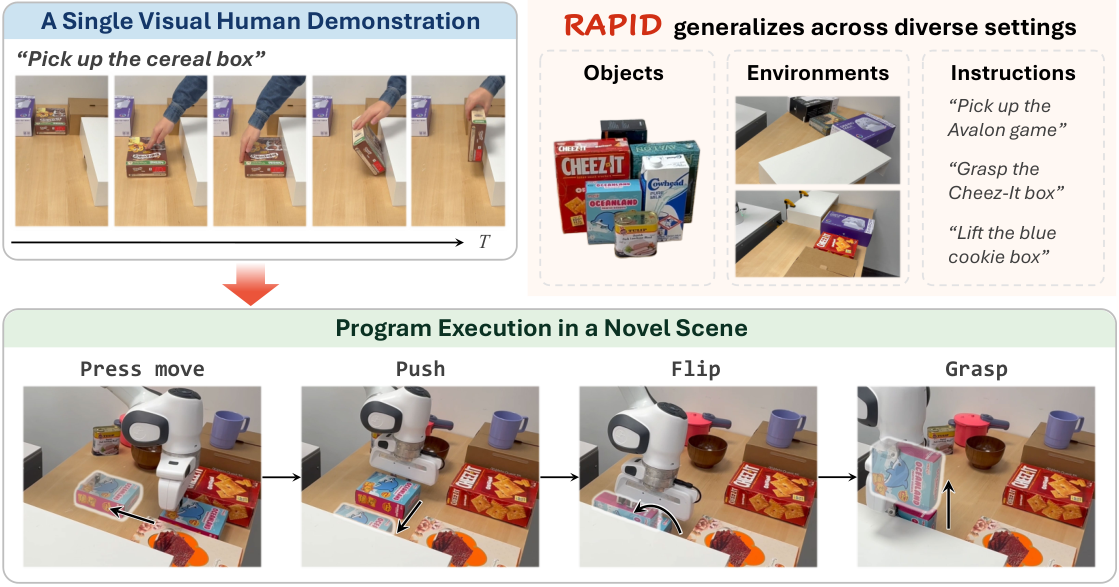
Человек показывает роботу на видео, как выполнить действие, например подтолкнуть предмет к нужной точке. Простое копирование движений может не сработать, если объект имеет другую форму или лежит немного в стороне. RAPID пытается определить цель демонстрации: какой предмет нужно переместить, где он должен оказаться и как проверить результат. Буквально повторять движение человеческой руки системе не нужно. По одной визуальной демонстрации агент формирует проверяемое описание задачи, список доступных движений и программу для робота.
После этого агент запускает программу в тестовой среде. Если предмет оказывается не на нужном месте, он исправляет код и повторяет попытку. Авторы проверили подход на восьми задачах перемещения предметов, в том числе на толкании без захвата. Дополнительные испытания прошли в LIBERO-Pro и на реальном манипуляторе Franka. В экспериментах программы переносились на новые положения объектов и изменения их свойств. Однако это не универсальный способ обучить любого робота произвольной работе по одному видео: исследование ограничивалось определенными классами задач и конкретной роботизированной платформой.
12. Восстановление скрытых траекторий роботов по последовательностям обучающих градиентов
Оригинальная публикация: Temporal Gradient Inversion for Private Trajectory Reconstruction in Embodied Reinforcement Learning · 24.09.2026 · arXiv:2609.30258
При распределенном обучении робот может не передавать серверу видео с камеры. Вместо кадров он отправляет градиенты — сведения о том, как изменить параметры нейросети после очередного шага обучения. Это выглядит безопаснее передачи исходных записей, однако в градиентах сохраняются следы наблюдений и действий. Исследователи разработали TRACE — метод анализа последовательностей таких обновлений, позволяющий попытаться восстановить увиденное роботом и его движения. В отличие от атак, ориентированных на отдельный кадр, TRACE учитывает связи между соседними моментами траектории.
На тестовых сценах восстановленные изображения получили 18,8 дБ по PSNR — метрике сходства с оригиналом, где большее значение соответствует меньшей ошибке. Метод также почти полностью восстановил выбранные дискретные действия робота, а обработка одного кадра занимала 3–4,5 мс. Авторы повторили эксперименты с различными моделями управления и проверили, способны ли защитные преобразования скрыть сведения в градиентах. Простые преобразования в некоторых условиях не предотвращали утечку, а более строгие меры защиты приватности снижали качество обучения. При этом для атаки в эксперименте требовался доступ к упорядоченным градиентам отдельных шагов, поэтому полученные цифры нельзя считать оценкой уязвимости всех роботизированных систем.
13. AD-WM: различающие действия модели мира для контрфактического планирования
Оригинальная публикация: AD-WM: Action-Discriminative World Models for Counterfactual Model Predictive Control · 24.09.2026 · arXiv:2609.30264
Чтобы выбрать подходящую команду, робот должен сравнить последствия разных действий. Одного точного на вид прогноза следующего кадра для этого недостаточно. Например, модель может хорошо предсказывать изображение, но неверно оценивать разницу между командами «сдвинуть левее» и «сдвинуть правее». Для управления эта разница принципиальна. AD-WM помогает модели мира различать последствия команд даже тогда, когда будущие кадры почти не отличаются. При обучении авторы добавили задачу определить по предсказанному состоянию, какое действие к нему привело. Это побуждает модель сохранять информацию о различиях между действиями и их результатами.
В симулированных манипуляциях OGBench-Cube при сложном начальном положении успешность выросла с 3,7 до 52% по сравнению с аналогичной моделью без нового компонента. На реальном манипуляторе Franka успешность простой задачи pick-and-place — взять и переложить предмет — увеличилась с 42,2 до 71,1%. Алгоритм выбора движения при этом остался прежним: изменился только процесс обучения модели мира. Однако на физическом оборудовании проверяли ограниченную задачу с заранее заданными подцелями, поэтому говорить об универсальном улучшении управления роботами пока рано.
14. За пределами точности: неустойчивость выводов и демографические смещения медицинских LLM
Оригинальная публикация: Beyond Accuracy: Counterfactual Fragility and Demographic Bias in Clinical Evaluation of LLMs · 26.09.2026 · arXiv:2609.32807
Медицинская LLM может правильно ответить на экзаменационный вопрос, но понимает ли она, какие именно детали влияют на диагноз? Исследователи предложили шести моделям 150 заданий MedQA USMLE и провели две проверки. Сначала моделей попросили изменить одну существенную деталь клинического случая так, чтобы правильный диагноз или ответ тоже изменился. Например, определенный симптом может повлиять на вывод, тогда как случайные подробности истории пациента не должны этого делать. Из 900 попыток автоматическая проверка признала корректными только 228, или 25,3%. Такой тест позволяет оценить, определяет ли модель клинически значимый признак, чего не показывает обычный экзаменационный балл.
Затем авторы изменяли демографические характеристики пациента, оставляя симптомы и результаты обследований прежними, и наблюдали за ответами моделей. В 5400 сравнениях ответ изменился 1097 раз — в 20,3% случаев. Устойчивость разных моделей различалась, а высокая точность на экзаменационных вопросах не гарантировала хорошего результата в обеих проверках. Решения и признаки стереотипизации оценивались автоматическими судьями, без участия врачей-экспертов. Поэтому исследование помогает выявить потенциально тревожные закономерности, но не позволяет определить реальную частоту врачебных ошибок.
15. CodeActionBench: оценка кода для управления роботизированными манипуляциями
Оригинальная публикация: CodeActionBench: Evaluating Agentic Code-as-Policy for Embodied Manipulation · 27.09.2026 · arXiv:2609.33807
Описать, как взять предмет, и написать код, который действительно выполнит это действие, — разные задачи. CodeActionBench проверяет вторую способность. Агент получает изображения сцены, ограниченный набор команд движения и геометрические инструменты. Ему необходимо самостоятельно оценить расположение предметов, выбрать действие, запустить программу и проверить результат. Готового алгоритма захвата, примера правильной траектории и точных координат всех объектов агенту не предоставляют.
В тест вошли 25 задач на роботизированные манипуляции. Девять конфигураций моделей и агентных оболочек выполнили 675 попыток, показав успешность от 2,7 до 73,3%. Самой сильной конфигурации давали до трех попыток на каждую задачу; хотя бы раз она справилась с 22 заданиями из 25. Это не означает, что вероятность успеха за одну попытку составляла 88%. Типичная ошибка заключалась в том, что команда движения выполнялась, но предмет оказывался не там, где требовалось. Иногда агент не замечал этого и объявлял задачу решенной. Все испытания проводились в контролируемой симуляции, а перенос результатов на физических роботов пока не проверен.
16. От разовой генерации к последовательному редактированию музыкальных партитур с помощью LLM
Оригинальная публикация: From One-Shot Generation to Incremental Music Composition: Adapting a General-Purpose Instruction LLM for Persistent Symbolic Editing · 28.09.2026 · arXiv:2609.34994
Музыкальным нейросетям обычно предлагают создать мелодию целиком. Композитор же нередко возвращается к готовой партитуре: добавляет аккорды, переносит мелодию в другую тональность или переписывает несколько тактов. Авторы исследовали, можно ли научить обычную языковую модель такому последовательному редактированию. Для записи нот они выбрали текстовую нотацию ABC, в которой используются буквы и символы. Она удобна для точечных правок: модель обучали добавлять аккорды, заполнять пропущенные такты и менять тональность, сохраняя остальную часть партитуры без изменений.
Исследователи дообучили Llama 3.1 8B Instruct на 496 038 диалоговых примерах из ирландской традиционной музыки с помощью LoRA — метода, позволяющего изменить поведение модели без обновления всех ее параметров. В испытании с 1750 попытками на модель доля результатов, прошедших автоматическую проверку формата, увеличилась с 29,37 до 99,37%. Среди результатов, прошедших эту проверку, оценка соблюдения правил редактирования по шкале от 0 до 1 выросла с 0,7205 до 0,9798. Это указывает на более надежное сохранение структуры партитуры и выполнение точечных инструкций. Однако художественное качество полученной музыки профессиональные музыканты не оценивали.
17. Планирование траекторий для групп роботов с помощью шумоподавления
Оригинальная публикация: Denoising Multi-Robot Trajectories · 28.09.2026 · arXiv:2609.35651
Когда несколько роботов перемещаются в одном пространстве, каждому необходимо учитывать препятствия и действия остальных участников. С ростом числа машин планирование усложняется: у каждой есть ограничения скорости и поворота, а пересечение маршрутов может привести к столкновению. В работе Denoising Multi-Robot Trajectories авторы исследовали метод D4orm. Он начинает с множества грубых вариантов движения и постепенно устраняет случайные отклонения, чтобы получить выполнимые траектории без столкновений. Такой прием называют диффузионным шумоподавлением. GPU позволяет одновременно оценивать множество вариантов.
На основе метода авторы разработали несколько способов планирования: для больших групп, для непрерывного пересчета по новым наблюдениям и для распределенного управления при ограниченных вычислительных ресурсах. В экспериментах участвовали 10 настоящих квадрокоптеров, шесть наземных роботов и до 100 машин в симуляции. В выбранных испытаниях D4orm быстрее и надежнее находил безопасные движения по сравнению с другими планировщиками. Среди них был MPPI — метод, который многократно моделирует пробные траектории и выбирает лучшие. Полученные результаты относятся к конкретным условиям тестирования: в незнакомой среде система пока не гарантирует предотвращение всех столкновений.
Похожие статьи
 Игра, которая навсегда изменила игровую индустрию
 Математический меч: Почему чистая наука сокрушит ИИ-империи Кремниевой долины и Пекина
 Эффект чёрного ящика: почему искусственный интеллект принимает необъяснимые решения
 Замена Windows проще перестройки завода: как LG и Samsung изменили OLED-пиксели ради четкого текста
 Сколько продлится путешествие по Вселенной с ускорением 1g?
 Как быть, если признанная теория оказалась ошибочной: спросите Итана
 Эволюция советских фенов: почему техника для сушки волос поражала своими размерами
 Основы Deep Learning. Часть 2