Стальной сентябрь: от 122-терабайтных накопителей Unigen до архитектуры Arm Ranger и планов развития Huawei Ascend
Приветствую! На связи Сергей Ковалёв, менеджер по выделенным серверам в Selectel. Сентябрь вновь порадовал обилием новостей из мира железа. Huawei и Alibaba с интервалом в пять дней раскрыли планы по ИИ-ускорителям, Fujitsu представила ARM-процессоры MONAKA, а NVIDIA и AMD без громких пресс-релизов расширили свои каталоги. Ниже — обзор событий месяца: от модулей памяти объёмом 512 ГБ до ускорителей, которым HBM не требуется.
О чём писал Selectel
Компания Micron продемонстрировала модули RDIMM DDR5-9200 ёмкостью 512 ГБ. Благодаря им в двухсокетный сервер с 24 слотами можно установить до 12 ТБ оперативной памяти. Столь внушительный объём на одной планке стал возможен благодаря вертикальной упаковке кристаллов по технологии TSV. Кроме того, один такой модуль потребляет 16 Вт, тогда как четыре планки по 128 ГБ — 44,2 Вт. Серийный выпуск обещают лишь во второй половине 2027 года, а цена, судя по росту стоимости гигабайта, окажется весьма высокой.
NVIDIA пополнила линейку Blackwell™ картой RTX™ PRO 5500 с 84 ГБ памяти GDDR7. В её основе лежит тот же чип GB202, что и в RTX™ 5090. Необычный разъём и два серверных вентилятора 40×40×56 говорят о том, что это решение для стойки, а не для рабочего стола. Ждём её в серверах.
В каталоге AMD без лишнего шума появились два бюджетных шестиядерных процессора на прежних платформах. Ryzen™ 5 7500 для AM5 — по сути тот же 7500F, но со встроенной графикой RDNA 2. Ryzen™ 5 5500F для AM4 построен на чиплетах Vermeer: он поддерживает PCIe 4.0, однако объём кэша L3 урезан до 16 МБ.
Huawei представила Atlas 960E SuperPoD на 4 096 NPU с оптическими модулями Hi-ONE, а Alibaba — чип Zhenwu V900 с 216 ГБ HBM и интерконнектом на 1,2 ТБ/с. В материале мы сопоставляем эти разработки с решениями NVIDIA и AMD, а заодно вспоминаем китайские Moore Threads MTT S5000 и Dongfang Suanxin DF1000. Почти все новинки поступят на рынок только в 2027 году, но производители уже ищут обходные пути — в топологии, вертикальной интеграции и архитектуре памяти.
Мы протестировали сервер с 16 ускорителями Alibaba PPU Zhenwu 810E и 1,5 ТБ HBM2e и выяснили, можно ли встроить его в облачную инфраструктуру. В статье — замеры интерконнекта ICN (89 ГБ/с на двойном линке, 44 на одинарном и всего 14 через PCIe), а также запуск DeepSeek-V4-Flash и Kimi K2.6. Само железо производительное, а вот проблемы возникают на уровне программного стека.
Новости рынка
HyperAccel Bertha — инференс-ускоритель без HBM
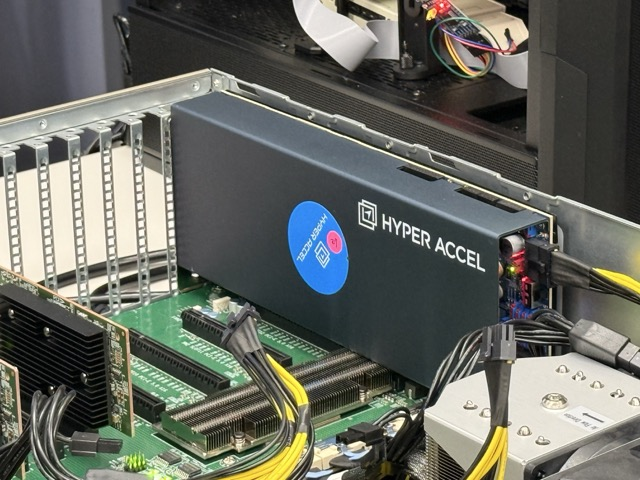
Южнокорейский стартап HyperAccel представил ускорители Bertha. Вместо дорогой HBM в них применена обычная LPDDR5X, и компания рассчитывает за счёт этого выиграть у GPU в стоимости токена. Подход не новый и не революционный, но вполне рабочий.
Флагманская двухслотовая модель Bertha 500 изготавливается по 4-нм техпроцессу:
-
256 МБ SRAM и 128 ГБ LPDDR5X;
-
пропускная способность памяти — 546 ГБ/с;
-
производительность — 768 Тфлопс в FP8 и 384 Тфлопс в FP16;
-
поддержка FP4, INT8 и INT4;
-
TDP — 250 Вт.
Позднее обещают выпустить версию с 256 ГБ LPDDR5X.
Для сравнения: у довольно возрастной NVIDIA® H100 пропускная способность памяти начинается от 2 ТБ/с, то есть примерно вчетверо выше. Зато и TDP у неё почти втрое больше. HyperAccel делает ставку на эффективную загрузку железа: архитектура LPU подстраивает вычисления под пропускную способность памяти, благодаря чему в среднем за время инференса удаётся удерживать около 90% утилизации.
Младшая модель Bertha 100 выполнена в формате M.2:
-
16 ГБ LPDDR5X;
-
пропускная способность — 64 ГБ/с;
-
производительность — 32,8 Тфлопс FP8.
Выход намечен на IV квартал. Из программных средств поддерживаются PyTorch, ONNX и vLLM.
В сравнении с H100 на своём сайте компания приводит следующие цифры: вдвое более высокая пропускная способность в токенах, в 19 раз больше токенов на доллар и в 12 раз больше на киловатт. Это собственные замеры вендора, поэтому с реальностью они могут расходиться. К тому же для сравнения выбран очень старый ускоритель: в серверных GPU NVIDIA с тех пор значительно продвинулась вперёд.
Axelera Europa — AIPU запущен в серию
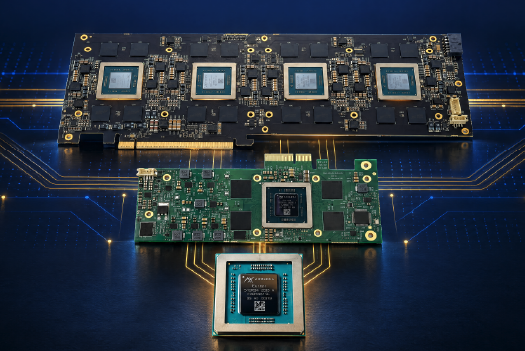
Нидерландская компания Axelera AI приступила к поставкам чипов Europa, предназначенных для корпоративного инференса.
Характеристики AIPU:
-
восемь ИИ-ядер с цифровыми вычислениями в памяти (D-IMC);
-
16 векторных ядер RISC-V;
-
128 МБ L2 SRAM и 256-битный интерфейс LPDDR5 с пропускной способностью 200 ГБ/с;
-
до 629 TOPS в INT8.
У предыдущего поколения Metis было 214 TOPS, так что заявленный рост — примерно трёхкратный.
Europa поставляется как отдельный чип для собственных плат, а также в виде низкопрофильной карты Edge 232p с одним процессором и полноразмерной Server 250p с четырьмя чипами. Edge 232p уже прошла валидацию в серверах Dell XE5 и Supermicro 111AD. Поддержку обещают и другие вендоры.
Axelera уверяет, что её решение выдаёт больше токенов в секунду на ватт, чем GPU. Однако и здесь речь о внутренних тестах, а не о публичных бенчмарках. Компания говорит о внедрении у 600 клиентов и портфеле заказов на 1,5 млрд $. Но вторая цифра на деле отражает лишь воронку продаж, то есть потенциальные сделки, а не подписанные контракты.
Дорожная карта Huawei Ascend: железо для обучения и инференса
На конференции Connect компания Huawei раскрыла планы по развитию ускорителей Ascend, разделив их по типам задач. Первым выйдет Ascend™ 960DT, где «DT» означает decode/training. Чип появится в первом квартале 2027 года — на три квартала раньше первоначального графика.
Характеристики Ascend 960DT:
-
288 ГБ памяти, предположительно HBM собственной разработки под названием HiZQ;
-
производительность — 4 Пфлопс в FP4 и 2 Пфлопс в FP8;
-
пропускная способность памяти — около 9,6 ТБ/с.
По объёму памяти 960DT сопоставим с NVIDIA® B300, но в FP8 уступает ему вдвое, а в FP4 — втрое. До Rubin™ с его 35–50 Пфлопс FP4 ему и вовсе далеко.
Следом по плану идёт Ascend 960PR для prefill-вычислений и рекомендательных систем. Его релиз намечен на третий квартал 2027 года.
Характеристики Ascend 960PR:
-
192 ГБ памяти;
-
пропускная способность — 2,4 ТБ/с;
-
производительность — 8 Пфлопс FP4.
Схема уже знакома: prefill обрабатывается на одном чипе, decode — на другом.
В 2028 году ожидается Ascend 970: 288 ГБ, 14,4 ТБ/с, 3,6 Пфлопс FP8 и 14 Пфлопс FP4. В 2029-м запланирован Ascend 980: 384 ГБ, 38,4 ТБ/с, 7,2 и 28 Пфлопс соответственно. Дорожные карты, рассчитанные на три года вперёд, выглядят не слишком убедительно, но появление альтернативы Blackwell™ и Rubin™ при таких планах было бы полезно для всего рынка.

Арендуйте GPU за 1 рубль!
Выберите подходящую конфигурацию в панели управления Selectel. Подробнее →
Arm Neoverse CSS N4 для серверных процессоров
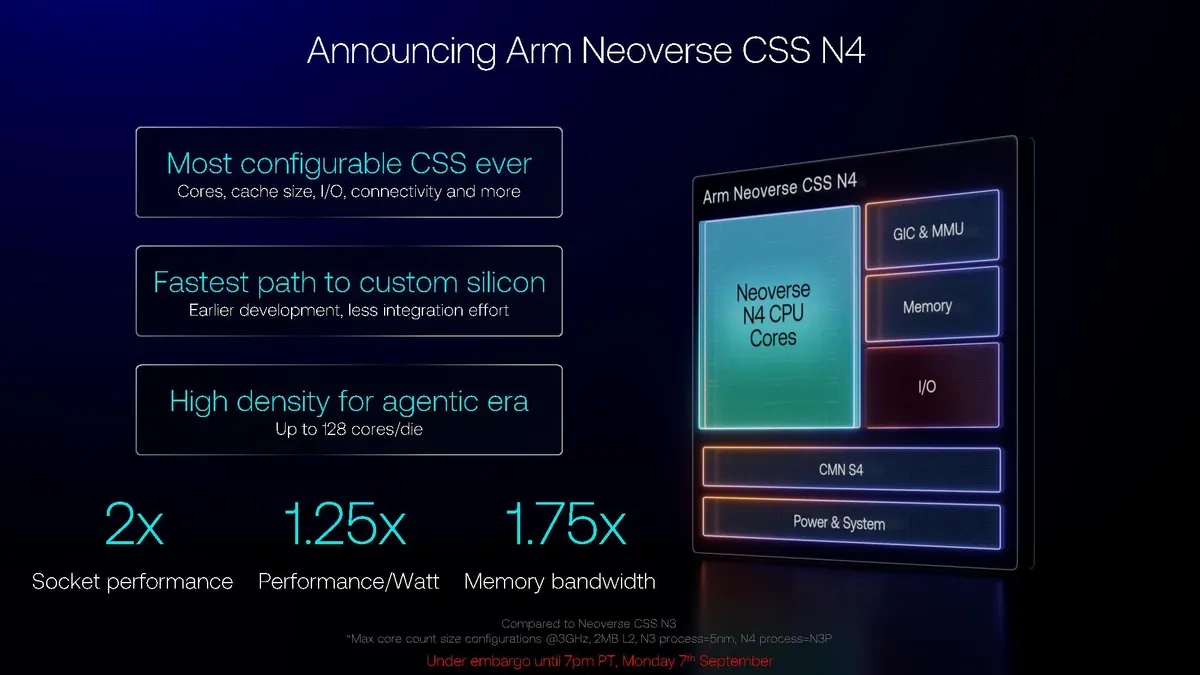
Компания Arm анонсировала вычислительную подсистему Neoverse CSS N4 с кодовым названием Ranger. Это готовый RTL-блок (Register-Transfer Level, уровень регистровых передач) для тех, кто хочет создать собственный серверный процессор или DPU:
-
подсистема масштабируется от 8 до 128 ядер Neoverse N4 на кристалл;
-
частота достигает 3,8 ГГц — впервые для N-серии;
-
поддерживаются память LPDDR6 и DDR5;
-
подсистема ввода-вывода предлагает до 128 линий PCIe 7.0.
Внутри используется mesh-интерконнект CMN S4 с когерентной связью между чиплетами. По сравнению с предыдущим поколением CSS N3 Arm обещает до двукратного роста производительности на сокет, повышение производительности на ватт в 1,25 раза и рост пропускной способности памяти в 1,75 раза.
По словам Arm, её технологиями уже пользуются OpenAI, Cloudflare, Oracle, SAP, Lenovo, Supermicro и Verda. Ещё год назад вендоры x86 иронизировали, что Arm в ЦОД нужен лишь гиперскейлерам. Теперь же именно гиперскейлеры закупают почти всё.
Fujitsu MONAKA: 144 ядра Arm
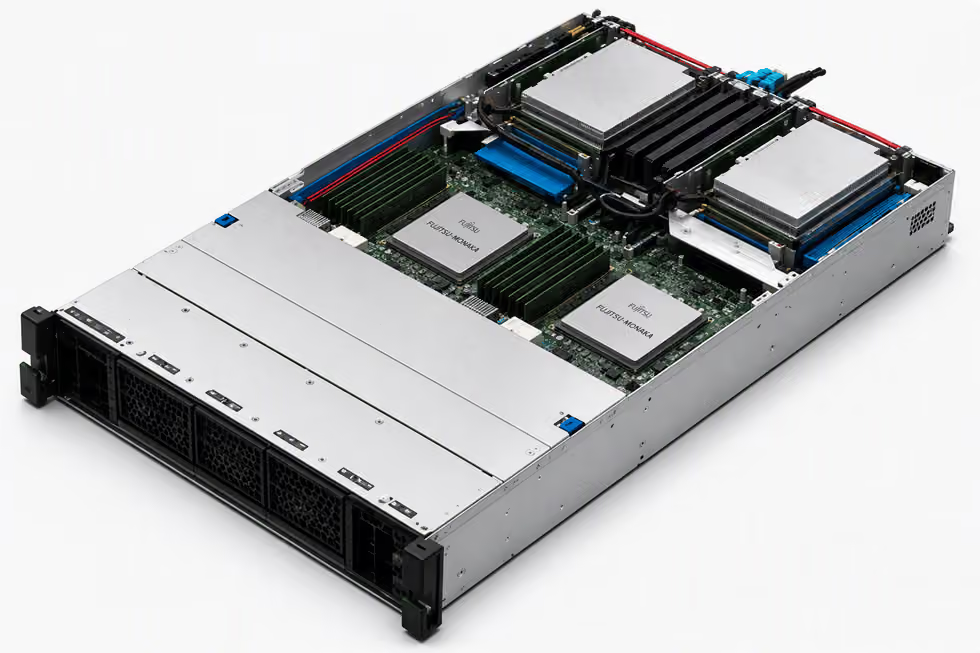
Fujitsu объявила о начале глобальных продаж процессоров MONAKA. Приобрести их можно как отдельно, так и в составе серверов Fujitsu MONAKA Server. MONAKA выполнен в виде 3D-стека: вычислительные ядра изготовлены по 2-нм техпроцессу, а кэш и подсистема ввода-вывода — по 5-нм. Характеристики:
-
до 144 ядер;
-
частота до 3,8 ГГц;
-
память DDR5-8800.
Матричные операции ускоряются специальными инструкциями. По данным Fujitsu, в сочетании с SVE2 это обеспечивает вдвое более высокую пропускную способность ИИ-инференса, чем у других CPU. Для конфиденциальных вычислений предусмотрена поддержка Arm CCA. Если вспомнить предшественника — A64FX из суперкомпьютера Fugaku с 48 ядрами и HBM2, — становится очевидно, что Fujitsu переориентировала своё железо с экзотики для HPC на массовый серверный чип.
Первые серверы выйдут в форматах 1U с одним или двумя сокетами и 2U с двумя сокетами. Память можно наращивать с помощью CXL-пулов. Для науки и HPC готовится многоузловая система 2U4N.
Unigen Cheetah: быстрый ярус и ёмкий ярус
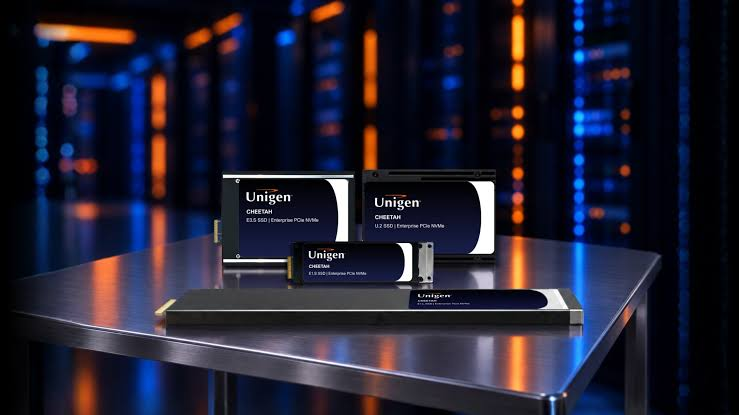
Unigen начала выпуск двух серий корпоративных SSD с интерфейсом PCIe 5.0 x4 и поддержкой NVMe 2.0. Обе построены на 16-канальных контроллерах с DDR5-кэшем.
Ярус (tier) — это уровень многоуровневой системы хранения. Данные распределяются по накопителям разных типов в зависимости от частоты обращения к ним. Cheetah SCM — быстрый ярус на pSLC/eTLC ёмкостью 1,6 и 3,2 ТБ:
-
форматы E1.L, E3.S, E1.S и U.2;
-
последовательное чтение до 14,7 ГБ/с — практически предел для PCIe 5.0 x4;
-
случайное чтение блоками по 4 КБ — до 3,37 млн IOPS;
-
DWPD 60 при случайной нагрузке и 80 при последовательной.
Таким образом, для модели на 3,2 ТБ это порядка 192 ТБ записи в сутки. Такой накопитель подходит для scratch-данных, кэшей и журналов.
Cheetah HC — ёмкий ярус, своего рода склад на QLC или TLC объёмом до 122,88 ТБ в форматах E1.L и U.2:
-
чтение — 14 ГБ/с;
-
запись — 2,4 ГБ/с;
-
DWPD 0,3 при случайной нагрузке.
Для QLC невысокий DWPD — вполне нормальное явление. Такой диск записывают нечасто, а читают много (например, веса моделей и датасеты). Unigen прямо предлагает связку «SCM спереди, HC сзади». Логика стандартная, а получить оба яруса у одного вендора ещё и удобнее.
ASUS: пять серверов на Xeon 6, EPYC Venice и Turin
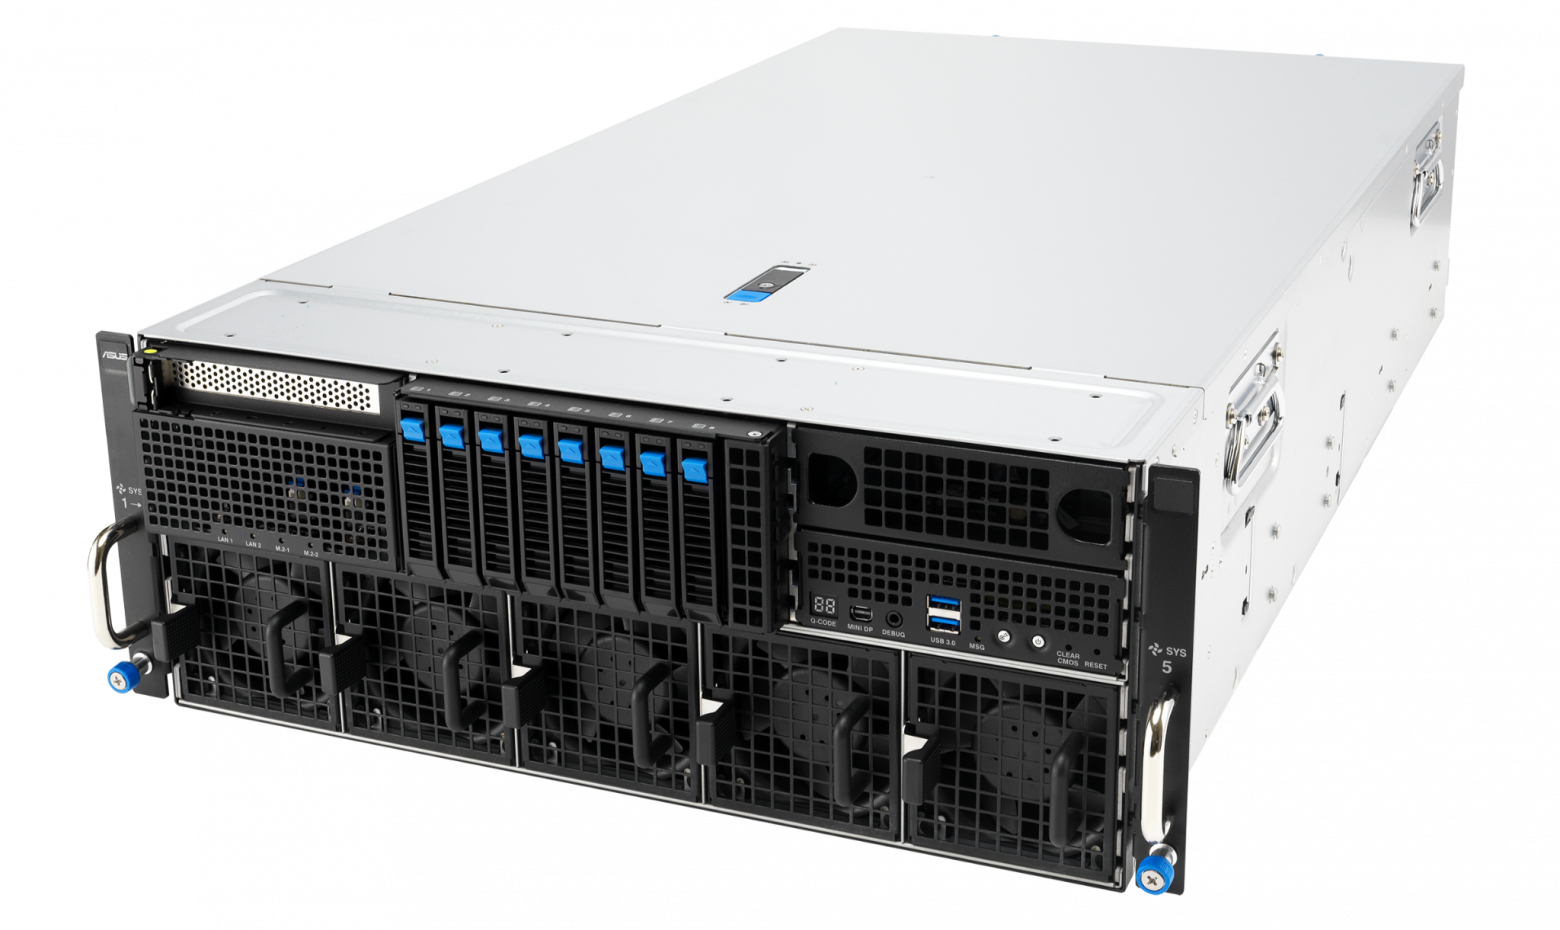
На мероприятии ASUS AI Tech 2026 в Сеуле компания показала пять новых серверов. Особого внимания заслуживает модель для недавно анонсированных процессоров AMD.
Для Intel® Xeon® 6 предназначены 1U-модель RS700-E12-RS4U и 2U-модель RS720-E12-RS12U. Обе двухсокетные, с 32 слотами DDR5-6400 и памятью до 8 ТБ. Младшая получила два слота PCIe 5.0 x16, два OCP 3.0 и четыре отсека SFF. Старшая предлагает до десяти слотов расширения и 12 отсеков SFF.
На новейших AMD EPYC™ 9006 (Venice) построены RS720A-E14B-R32U и RS500A-E14B-R12U. Первая рассчитана на 32 накопителя E3.S. Вторая — односокетная, с 16 модулями DDR5 общим объёмом до 2 ТБ. Обе оснащены PCIe 6.0 и BMC AST2700.
Особняком стоит 4U-модель ESC8000A-E13P на двух EPYC™ 9005 (Turin). В неё можно установить восемь двухслотовых ускорителей: NVIDIA® H200, RTX™ PRO 6000 и 4500 Blackwell™ Server Edition либо AMD Instinct™ MI350P. Ничего революционного здесь нет, особенно для тех, кто планирует переход на Venice, — но это платформы уже с PCIe 6.0.
Заключение
Если свести итоги месяца к одной теме, это снова удешевление инференса. HyperAccel и Axelera обходятся LPDDR вместо HBM, Fujitsu переносит матричные операции на CPU, а Huawei разделяет prefill и decode между разными чипами. Многое из этого дойдёт до заказчиков лишь в 2027 году, а пока цифры приводят сами вендоры. Будем ждать результатов реальной эксплуатации, а часть оборудования проверим самостоятельно, как это было с Zhenwu 810E.
Похожие статьи
 «Самый быстрый GPU в истории»: он опережает GeForce RTX 5090 и Nvidia B200, а Bolt закончила отладку тестового чипа Zeus
 SpaceX провела закрытый запуск: ракета Falcon 9 отправилась в космос в 28-й раз
 «Крупнейшие перемены в истории»: источник из индустрии рассказал, что Samsung готовит для One UI 10
 Nvidia без разрешения дала ИИ-агентам контроль над видеокартой и играми — из-за этого карты начали перегреваться
 «Билайн» показал в московском метро лучший результат по 5G: покрытие 99,48% при скорости 185 Мбит/с
 Космический телескоп NASA имени Нэнси Грейс Роман показал резкость снимков почти на 30% выше расчётной
 Claude Code нашёл кандидата в экзопланеты в архивных данных NASA: открытие проверят с помощью телескопа TESS
 One UI уходит в прошлое? Samsung и Google разрабатывают новую программную платформу для Galaxy