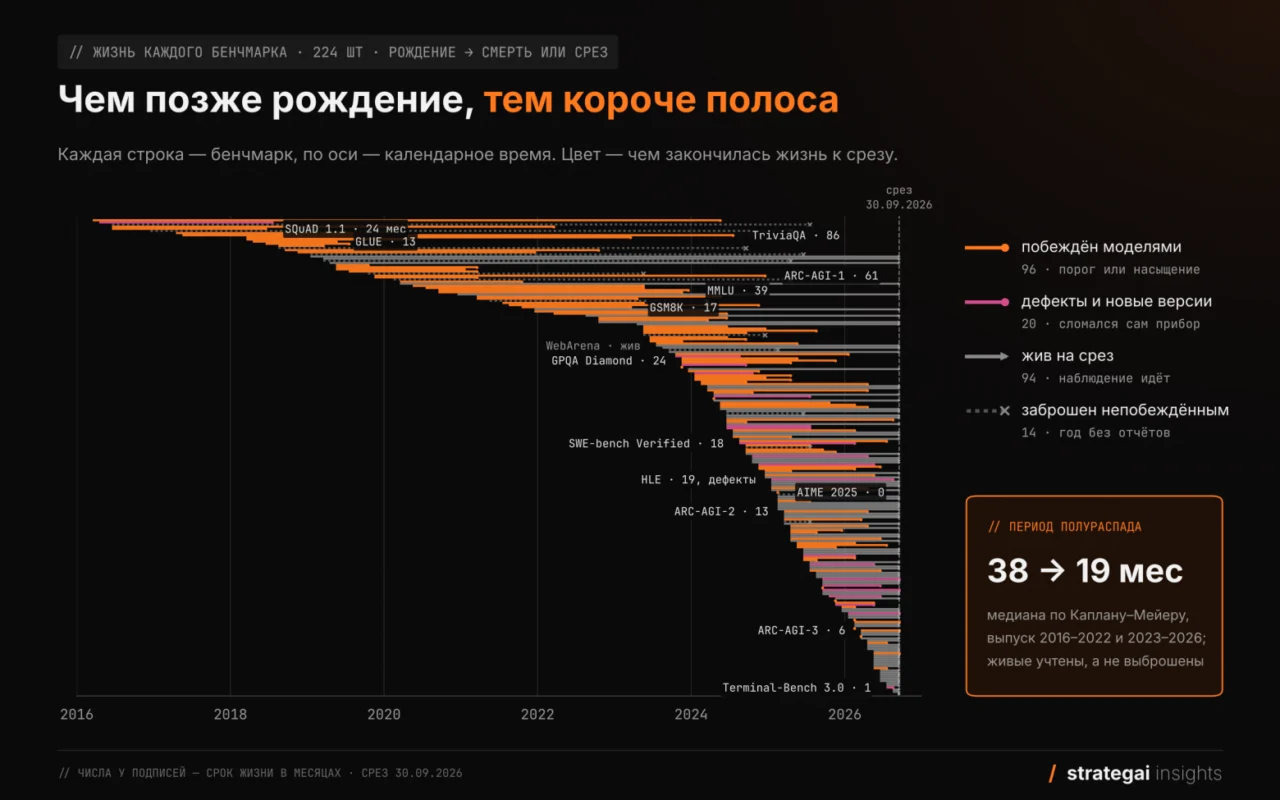
Срок актуальности ИИ-бенчмарков сократился вдвое — до 19 месяцев
Временные шкалы жизненного цикла 224 бенчмарков
В мае я направил OenoBench — специализированный бенчмарк для оценки языковых моделей в области виноделия — на конференцию NeurIPS. В ходе последовавшей дискуссии с рецензентами возник принципиальный вопрос, на который ни у меня, ни у экспертов не нашлось эмпирической базы: какой показатель результативности на момент релиза считается достаточным для нового тестового набора и каков его прогнозируемый жизненный цикл.
Для поиска ответов я проанализировал 224 бенчмарка, выпущенных в период с 2018 по 2026 год девятью ведущими лабораториями: OpenAI, Anthropic, Google, Meta, xAI, DeepSeek, Alibaba, Moonshot и Mistral. Для каждого были зафиксированы точная дата запуска и, при наступлении, дата «смерти» — момент, когда тестовый инструмент утрачивает способность дифференцировать передовые модели (лидер преодолевает планку в 90% или достигает человеческого уровня экспертизы), либо авторы официально объявляют набор насыщенным или несостоятельным. На основе этих временных меток рассчитывался период полураспада — временной отрезок, за который деградирует ровно половина существующих бенчмарков.
Ключевые выводы исследования:
-
Период полураспада тестового набора составляет 23 месяца. Для бенчмарков, опубликованных до 2023 года, этот показатель равнялся 38 месяцам, тогда как для более поздних релизов он сократился до 19 месяцев. Методика расчета учитывает ныне действующие бенчмарки, поэтому относительная молодость новых данных не искажает общую картину.
-
Современные бенчмарки не стали проще предшественников, просто алгоритмы эволюционируют стремительнее. Исходный запас прочности до достижения «потолка» остался прежним, однако нейросети преодолевают эту дистанцию вдвое быстрее.
-
Каждый седьмой новый бенчмарк выходит из строя не из-за технологического прогресса моделей, а вследствие внутренних изъянов. В сегложении автономных агентных сред эта причина обуславливает почти половину всех отказов.
Ниже подробно описана методология расчетов и прогноз долговечности самого OenoBench. Открытый датасет, сопутствующий кодбук и скрипты доступны публично, ссылки приведены в завершении материала.
Вопрос, оставшийся без методологической опоры
Архитектура OenoBench включает 3 266 вопросов с множественным выбором, сформированных на основе массива из 38 104 верифицированных фактов. Тестирование охватило шестнадцать конфигураций нейросетей. Четверка лидеров (o3, GPT-5, Gemini 2.5 Pro и Opus 4.7) продемонстрировала результаты в узком диапазоне 2,6 процентных пункта, причем лучший результат составил около 83%. На подмножестве задач, не требующих глубокого логического вывода (closed-book solvable), передовые модели показывают 96–97%, тогда как на второй половине — 65–70%. Возникает закономерный вопрос: высокий это показатель для свежего бенчмарка или нет? Спорить об адекватности целевой планки в условиях отсутствия понимания фундаментального ресурса самого измерительного инструмента бессмысленно, поскольку невозможно оценить, какое время жизни покупает каждый дополнительный процент запаса прочности.
Интуитивное ощущение стремительного угасания актуальности бенчмарков разделяют все исследователи, глубоко погруженные в тему. Традиционно это иллюстрируют графиками из основополагающей работы по Dynabench (Kiela et al., 2021), где прослеживается траектория шести бенчмарков от MNIST до GLUE: каждый из них движется от релиза к человеческому уровню, причем с каждым новым поколением тестов крутизна кривой возрастает. В исследовании Ott et al. (Nature Communications, 2022) был проведен детальный анализ 3 765 бенчмарков с платформы Papers with Code, траектории которых разделили на фазы роста, насыщения и резких скачков после периодов стагнации. В лаборатории Epoch AI объединили десятки тестовых систем в единую шкалу когнитивных возможностей, предварив публикацию выводом: «Большинство бенчмарков ИИ насыщаются в течение нескольких лет или даже месяцев после запуска» (Ho et al., 2025). Кроме того, инициативная группа EvalEval в начале 2026 года рассчитала индекс насыщения для 60 языковых бенчмарков: выяснилось, что почти половина из них исчерпала свой потенциал, за исключением масштабных тестов и экспертно верифицированных наборов, при этом использование изолированных тестовых выборок ситуации не спасает (Akhtar et al., 2026).
Однако эти исследования не дают прямых ответов на вопросы рецензентов: работы Dynabench и Ott демонстрируют лишь общую форму кривых, Epoch фиксирует эволюцию моделей, а EvalEval оценивает степень насыщения на фиксированную дату. Мне же требовалось определить реальный срок службы бенчмарков с учетом действующих образцов, выявить корневые причины их устаревания и рассчитать временной эквивалент стартового запаса прочности. Перед нами классическая задача анализа выживаемости.
Анатомия гибели тестового инструмента
Прежде всего необходимо было четко зафиксировать критерии «смерти» бенчмарка. Главный риск здесь заключается в подгонке правил под удобные промежуточные данные. Во избежание этого я зафиксировал регламент в кодбуке до начала разметки. Моментом гибели считается самое раннее из пяти событий:
|
Код |
Событие |
Условия применения |
|---|---|---|
|
A |
Лучший подтвержденный результат превосходит или равен человеческому ориентиру (baseline) |
эталонный показатель составляет ≥ 85% шкалы и зафиксирован людьми на аналогичной выборке по строгому протоколу |
|
B |
Лучший верифицированный результат достигает или превышает 90% от базовой метрики |
эталонные данные отсутствуют либо не дотягивают до 85% |
|
C |
Разработчики отозвали набор, прекратили прием сабмитов, признали его устаревшим или официально заявили о насыщении/дефектах как причине замены |
исключительно на основании официальных заявлений создателей |
|
D |
Преодолен целевой порог, заявленный организаторами состязания |
например, отметка 85% в рамках ARC Prize, подтвержденная модераторами |
|
E |
Независимая компрометация |
произошла утечка тестовых ответов к подавляющему большинству флагманских моделей; примитивный алгоритм достиг абсолютного потолка; в ходе аудита выявлено ≥ 20% бракованных задач, после чего хотя бы одна из девяти профильных лабораторий отказалась от использования набора |
Предусмотрены и три альтернативных исхода. Тест, на чей лидерборд на протяжении двенадцати месяцев не поступало ни одного обновления и не происходило никакой активности, квалифицируется как заброшенный: он формально не погиб, но выбыл из поля зрения. Концепция «рождения в мертвительном состоянии» применяется к наборам, чей целевой порог был побит модели в день релиза. Наконец, категория «действующих» объединяет тесты, с которыми по состоянию на 30 сентября 2026 года ничего из вышеперечисленного не произошло.
В зачет принимаются любые публично подтвержденные системы: автономные модели, комплексные программные обвязки, агенты и ансамбли, если их результаты утверждены официальным лидербордом либо обнажалованы разработчиками с детальным описанием испытательного протокола. Самоотчеты лабораторий также учитываются. Для данного исследования принципиально лишь то, способен ли бенчмарк дифференцировать передовые системы, тогда как архитектурный способ преодоления порога второстепенен. Исключение составляют результаты, полученные с привлечением внешних инструментов там, где регламент бенчмарка этого не разрешает (AIME, GPQA, HLE, MMLU): такие показатели отсеивались. Датой гибели признается день официальной публикации результатов.
Примеры применения критериев к известным бенчмаркам:
-
GPQA Diamond был выпущен в ноябре 2023 года и исчерпал себя по критерию B спустя 24 месяца, когда модель Gemini 3 Pro продемонстрировала результат 91,9%.
-
MMLU также прекратил существование по критерию B. Заявленный в оригинальной статье «экспертный уровень в 89,8%» представляет собой оценку 95-го перцентиля людей, сдававших академические экзамены, а не результаты живых людей на заданиях самого MMLU, поэтому критерий A здесь неприменим. Модель Gemini Ultra набрала 90,04% в декабре 2023 года — спустя 39 месяцев после релиза бенчмарка.
-
ARC-AGI-2 завершил цикл по критерию D: организаторы ARC Prize установили целевую планку в 85%, и в апреле 2026 года система GPT-5.5 в верифицированном зачете показала ровно 85,0%. Бенчмарк просуществовал 13 месяцев.
-
Humanity’s Last Exam не дотянул до отметки 90%: максимальный результат в режиме без использования инструментов на момент среза составлял около 61%. Его погубил независимый аудит. Команда Qwen проанализировала все 2 500 вопросов, оставив без замечаний лишь 668, скорректировав 1 143 задания и признав неразрешимыми еще 689. В августе 2026 года компания Google перешла на верифицированную подвыборку, в результате чего HLE пал по критерию E спустя 19 месяцев после релиза.
-
Terminal-Bench 3.0 продержался всего один месяц. Создатели выпустили версию 4.0, исключив 8 из 74 задач и перераспределив вычислительные ресурсы. Замена более 10% заданий или изменение протокола приравнивается к созданию нового бенчмарка, а предыдущая итерация получает статус погибшей по критерию C.
Последнее правило вызывает наибольшее количество дискуссий, поэтому далее отдельно рассмотрен сценарий, при котором выпуск новой версии трактуется не как гибель, а как выбытие из выборки.
Формирование репрезентативной выборки
Второй подводный камень кроется в отборе данных. На начальных этапах этого исследования я отбирал «флагманские» бенчмарки вручную, что гарантированно искажает математику анализа выживаемости: в фокус попадают преимущественно самые известные тесты, среди которых исторически выживали лишь долгожители.
Для устранения предвзятости был введен жесткий алгоритмический критерий. Бенчмарк включается в анализ, если упоминается в официальной документации к релизу модели (в блоге, карточке модели, техническом отчете) как минимум двумя из девяти профильных лабораторий либо одной лабораторией не менее чем в трех различных релизах. Для периода до 2023 года источниками выступали академические статьи о моделях — от GPT-1 и BERT до PaLM и Flan-PaLM. Итоговая база вобрала 230 релизов и 6 652 записи формата «релиз × бенчмарк × результат». Тестовые наборы дифференцируются с точностью до конкретной версии, года проведения экзамена или узкой предметной области: например, SWE-bench, SWE-bench Verified и SWE-bench Pro рассматриваются как три самостоятельных бенчмарка, аналогично AIME 2024, 2025 и 2026 годов.
В массив не включались динамические рейтинги без фиксированного предела вроде арен на базе Elo или метрик перплексии, внутренние корпоративные тесты без общедоступных задач, а также поведенческие оценки (на предмет токсичности или предвзятости), лишенные правильных ответов и оперирующие лишь нормативными значениями. Сборники вроде BIG-bench, задачи по машинному переводу, обработке речи и масштабные экзаменационные пакеты также исключались. Итоговый массив составил 224 уникальных бенчмарка. Каждая запись в датасете снабжена полным таймлайном событий со ссылками на первоисточники и цитатами. Ниже представлен сокращенный фрагмент одной из записей:
{
  "unit": "Humanity's Last Exam",
  "release": "2025-01",
  "criterion_ab": "B", "threshold": "90", "ab_date": "",
  "e_date": "2026-08", "e_type": "iii",
  "e_source": "Аудит: arXiv 2602.13964 (HLE-Verified, Qwen Team, 2026-02); первый отказ лаборатории: Google, методология Gemini 3.7 Flash (2026-08-13)",
  "e_quote": "Gold 668 | Fully validated, no modification required; Revision 1,143 | Corrected ... and re-verified; Uncertain 689 | Validity cannot be conclusively determined",
  "primary_date": "2026-08", "primary_criterion": "E", "cause": "defects",
  "T_months": 19,
  "best_by_cutoff": "No tools: 60.9 (2026-09-01, self-report)"
}
Выборка в целом оказалась молодой: 175 из 224 бенчмарков были представлены в 2023 году или позже, причем значительная их часть продолжает функционировать.
|
Год выпуска |
Всего бенчмарков |
Погибло |
Функционируют |
Заброшены |
|---|---|---|---|---|
|
2016–2019 |
28 |
19 |
3 |
6 |
|
2020–2022 |
21 |
14 |
5 |
2 |
|
2023 |
23 |
16 |
5 |
2 |
|
2024 |
50 |
30 |
18 |
2 |
|
2025 |
63 |
27 |
34 |
2 |
|
2026 |
39 |
10 |
29 |
0 |
Отсюда вытекает главная сложность исследования: прямолинейное вычисление средних показателей для недавних периодов не дает объективной картины.
Иллюзия наивной медианы
Наиболее распространенный подход к оценке долговечности бенчмарков заключается в выборке уже прекративших существование наборов, их группировке по годам релиза и расчете медианного значения. При применении этого метода к моим данным формируется яркая картина:
|
Год выпуска |
2016–2019 |
2020–2022 |
2023 |
2024 |
2025 |
2026 |
|---|---|---|---|---|---|---|
|
Медиана среди погибших, мес. |
26 |
27 |
15,5 |
15 |
8 |
2,5 |
Падение показателя с двух с лишним лет до двух с половиной месяцев создает впечатление десятикратного ускорения деградации, провоцируя громкие заголовки. Однако бенчмарк, увидевший свет в 2026 году, физически не мог просуществовать дольше восьми месяцев к моменту отсечки 30 сентября. Среди его ровесников успели зафиксировать смерть лишь самые уязвимые долговые аутсайдеры, тогда как длительные циклы еще не завершились. Именно поэтому у молодых когорт медианный возраст погибших неизбежно оказывается заниженным, вне зависимости от реальной скорости устаревания.
Чтобы отделить реальное ускорение процессов от артефактов короткого окна наблюдения, я сконструировал нулевую модель — гипотетическую реальность, в которой продолжительность жизни бенчмарков не меняется со временем. Для каждой реальной даты релиза из выборки случайным образом генерировался срок службы на основе генеральной совокупности распределения, наблюдения обрезались по состоянию на 30 сентября 2026 года, после чего рассчитывалась аналогичная медиана. Эта процедура повторялась 2 000 раз.

Даже в смоделированном мире без малейшего ускорения медианный возраст погибших тестов снижается с 19 месяцев для старых когорт до двух месяцев для наиболее свежих. Полученные на практике показатели в 8 и 2,5 месяца для бенчмарков 2025 и 2026 годов укладываются в доверительный интервал нулевой модели, а значит, подобные цифры по молодым когортам не несут статистически значимой информации. Реальный тренд обнаруживается на противоположном фланге: у ранних когорт медиана по усопшим тестам зафиксирована на верхней границе диапазона нулевой модели и даже выше нее. Ретроспективные бенчмарки действительно функционировали дольше. Для корректного измерения этого эффекта требуется оценка, учитывающая продолжающие работать тесты.
Период полураспада: 23 месяца и двукратный разрыв
Для вычисления периода полураспада использовался непараметрический метод Каплана–Мейера: действующие бенчмарки интегрируются в модель как цензурированные наблюдения, а заброшенные учитываются аналогичным образом по дате последней зафиксированной активности. На языке библиотеки lifelines это реализуется лаконично:
import pandas as pd
from lifelines import KaplanMeierFitter, CoxPHFitter

d = pd.read_csv("halflife_dataset_v3.csv")
m = d[d.stratum == "main"]                      # 224 бенчмарка
km = KaplanMeierFitter().fit(m.T_months, m.event)
print(km.median_survival_time_)                 # 23.0

for era, g in m.groupby(m.birth_year <= 2022):
    k = KaplanMeierFitter().fit(g.T_months, g.event)
    print("≤2022" if era else "2023+", k.median_survival_time_)   # 2023+ 19.0, ≤2022 38.0

x = m[["T_months", "event"]].assign(year=m.birth_year - 2023)
print(CoxPHFitter().fit(x, "T_months", "event").hazard_ratios_)  # year ≈ 1.22
В масштабе всей выборки общий период полураспада составляет 23 месяца (при 95% доверительном интервале 19–27 месяцев). Четверть тестовых наборов деградирует в течение первого же года, а к исходу второго года в строю остается менее половины.

Разница между поколениями двукратная. Для бенчмарков, запущенных в 2016–2022 годах, период полураспада равен 38 месяцам (95% ДИ 27–69), причем на первый год приходилось лишь 4% отказов. Для наборов из поколения 2023 года и новее этот показатель сократился до 19 месяцев (15–23), а доля выбывающих в первый год возросла примерно до трети. С каждым годом появления новых релизов относительный риск гибели возрастает приблизительно на 22%. Применительно к стандартному статическому публичному тесту это означает, что набор 2018 года выпуска функционировал бы около 53 месяцев, тест 2022 года — порядка 31 месяца, а бенчмарк образца 2026 года исчерпает себя за 18 месяцев.
|
Год выпуска |
Количество бенчмарков |
Погибло |
Период полураспада, мес. (95% ДИ) |
|---|---|---|---|
|
2016–2019 |
28 |
19 |
49 (24–98) |
|
2020–2022 |
21 |
14 |
38 (25 и выше) |
|
2023 |
23 |
16 |
19 (13–27) |
|
2024 |
50 |
30 |
21 (17–26) |
|
2025 |
63 |
27 |
19 (12 и выше) |
|
2026 |
39 |
10 |
— |
История бенчмарков 2026 года пока слишком коротка для полноценной оценки: полугодовой рубеж наблюдений преодолели лишь 10 из 39 наборов.
Этот разрыв сохраняется и при ужесточении критериев. Если учитывать исключительно независимо верифицированные результаты единичных моделей, периоды полураспада увеличиваются до 68 и 26 месяцев соответственно, при этом межэпохальный разрыв становится еще более выраженным.
Новые бенчмарки не проще, просто модели стали быстрее
Первое возражение возникает интуитивно: возможно, современные бенчмарки изначально создаются в непосредственной близости от технологического потолка? Лаборатории презентуют тесты, на которых актуальные модели сразу демонстрируют высокие результаты, поскольку разработчики торопятся с релизами и не успевают усложнить задачи.
Данное предположение поддается проверке. Для 203 бенчмарков известен максимальный результат на момент выпуска, на основе которого вычисляется исходный запас прочности до достижения целевого порога. Вычисления производились в логитах, поскольку подъем с 50% до 60% и с 80% до 90% сопряжен с принципиально разной сложностью задач, в то время как в пространстве логитов фронтир демонстрирует практически линейный рост. Медианный запас прочности для старых бенчмарков составил 2,02 логита, для новых — 2,14 логита (что эквивалентно 35 и 38 процентным пунктам до критической отметки). Следовательно, новые бенчмарки стартуют на сопоставимом или даже чуть большем удалении от потолка, чем их исторические предшественники.
Динамика развития моделей оценивалась по независимым источникам. По данным Epoch AI, для 21 бенчмарка из моей выборки зафиксированы траектории развития технологического фронтира. На устаревших тестах фронтир прибавлял по 0,75 логита ежегодно, тогда как на современных — по 1,56 логита, то есть вдвое быстрее. Если соотнести стартовый запас со скоростью прогресса, типичный старый бенчмарк должен был функционировать около 32 месяцев, а новый — около 16 месяцев. Фактические значения составили 38 и 19 месяцев.

Для отдельных бенчмарков этот расчет носит более грубый характер, но общая тенденция сохраняется. Модель выживаемости, учитывающая стартовый запас и год релиза, подтверждает закономерность: каждый дополнительный логит запаса прочности продлевает жизнь теста примерно в полтора раза, однако при равном запасе свежий бенчмарк все равно стареет быстрее. Преодолеваемая дистанция до потолка не изменилась — модели стали быстрее ее проходить.
Экстремальным проявлением этой тенденции выступают бенчмарки, рожденные в мертвом состоянии. Практически все ежегодные математические олимпиады последних двух лет — AIME 2025 и 2026, HMMT за февраль 2026 и ноябрь 2025 годов, USAMO 2026 — решались моделями с результатами от 90% и выше в тот же месяц, когда проводились соревнования (проекты вроде MathArena и сами лаборатории прогоняют архитектуры сразу после состязаний). Тест Needle-in-a-Haystack дебютировал в ноябре 2023 года с показателем модели GPT-4-128K выше 90%, а OmniDocBench 1.5 был представлен одновременно с моделью MinerU2.5 от той же лаборатории, набравшей 90,67%.
Причины деградации тестовых наборов
Из 116 зафиксированных случаев гибели 84 обусловлены преодолением целевого порога моделями. Еще в 12 случаях создатели добровольно признали бенчмарки насыщенными прежде, чем нейросети достигли критической отметки: так завершили свой путь GLUE, SQuAD 1.1, HealthBench, Video-MME и OSWorld-Verified. Порог восприятия насыщенности у разработчиков сильно разнится: к примеру, компания Vals AI объявила первую версию Finance Agent исчерпавшей себя при максимальном результате модели в 60,7%. Оставшиеся 20 случаев гибели связаны с внутренними дефектами. Авторы выявили ошибки в заданиях или механизмах верификации и выпустили исправленные релизы, либо наборы были скомпрометированы в ходе независимого аудита или из-за появления тривиальных методов решения.
Причины деградации конкурируют между собой: бенчмарк, погибший от конструктивных дефектов, уже не сможет устареть от прогресса моделей. Для корректного учета этого фактора доли распределялись с помощью оценки Аалена–Йохансена.

В течение первых двух лет существования наборов из когорты 2016–2022 годов от превосходства моделей погибали 29%, и ни один не пострадал от дефектов. Среди тестов, выпущенных с 2023 года, от моделей гибнут 45%, от внутренних изъянов и смены версий — 14%, а еще 5% оказываются заброшенными. Каждый седьмой новый бенчмарк погибает непобежденным, причем две трети подобных инцидентов приходятся на автономные агентные среды.

Из 29 выбывших агентных сред 13 разрушились из-за внутренних недоработок, тогда как среди 81 погибшего статического теста таковых набралось лишь шесть. Жизненные циклы агентных систем удивительно похожи. Так, Terminal-Bench чуть более чем за год сменил четыре версии, причем ни одна не продержалась дольше полугода: сообщество обнаруживало логические ошибки в задачах, либо сами мейнтейнеры признавали их исчерпанными. Доменный сегмент airline из τ-bench в феврале 2026 года пал жертвой дефектов: независимый аудит SABER квалифицировал 31 из 50 задач как некорректно сформулированные, после чего компания Anthropic прекратила публикацию результатов по нему.
SWE-bench просуществовал десять месяцев до появления версии Verified, при разработке которой 68% заданий были отсеяны из-за неопределенности условий или некорректных тестов. Сама модификация Verified продержалась полтора года, пока компания OpenAI — соавтор набора — не объявила об отказе от публикации таких метрик, призвав индустрию последовать ее примеру. Платформа OSWorld просуществовала 15 месяцев до релиза с исправлениями по отзывам сообщества, а спустя еще 11 месяцев авторы OSWorld 2.0 охарактеризовали ее как завышающую реальные возможности систем. Аналогичным образом завершили жизненный цикл Toolathlon, MCPMark и APEX-Agents. Статические тесты сталкиваются с подобными проблемами реже, но прецеденты фиксируются и там (MMMU, StoryCloze, FrontierMath).
Случаются и казусы гибели под воздействием тривиальных методов. В октябре 2024 года была опубликована работа, доказывающая, что простейшая «нулевая модель», отвечающая на любой запрос идентичной строкой, демонстрирует на AlpacaEval 2.0 показатель length-controlled win rate в 86,5% — выше, чем любая реальная языковая модель. Мейнтейнеры интегрировали этот алгоритм в общую таблицу на первое место.
Дискуссионным остается вопрос о том, правомерно ли считать смертью релиз новой версии. Если рассматривать выпуск обновления как банальное выбытие из наблюдения, период полураспада новых бенчмарков увеличивается с 19 до 24 месяцев, однако фундаментальный разрыв с доэпохальным периодом 2023 года сохраняется в полном объеме.
Практические рекомендации для разработчиков бенчмарков
Закладывайте в проект жизненный цикл продолжительностью в полтора-два года, а не пять лет. Если измерительный инструмент необходим на длительную перспективу, он должен обладать встроенным механизмом регулярного обновления: одной удачной подборки задач заведомо недостаточно.
Стартовый запас прочности — единственный параметр, находящийся под вашим непосредственным контролем, и он работает: каждый дополнительный логит запаса прочности увеличивает ожидаемое время жизни теста примерно в полтора раза. Если на релизе лидер демонстрирует 30% от максимума, это залог долговечности набора. Но если лучшие модели на старте превосходят 80%, бенчмарк исчерпает себя за считанные месяцы.
Четко зафиксируйте в сопроводительной документации критерии насыщения и измерьте человеческий эталон на той же выборке по строгому регламенту. В противном случае эти параметры определят за вас, и с вероятностью 95% ориентиром станет порог в 90% от шкалы.
Для агентных сред версионирование должно быть внедрено с первого дня: фиксированные программные окружения, детальные журналы изменений и раздельные лидерборды для каждой итерации. Почти половина погибших агентных сред в моей выборке скончалась от собственных дефектов, а каждая новая редакция полностью обнуляет историю результатов. Проведение предварительного аудита задач до релиза обходится значительно дешевле, чем выпуск версии Verified полгода спустя.
Использование изолированных закрытых тестовых сплитов не продлевает жизнь инструмента — это подтверждают как мои данные, так и выводы EvalEval. Подобный подход защищает от утечки данных, но бессилен против технологического прогресса моделей.
Прогнозируемый срок жизни OenoBench
Вернемся к исходной точке исследования. OenoBench представляет собой статический тест 2026 года без предварительно измеренного человеческого эталона, поэтому его ждет угасание по критерию B в момент, когда какая-либо система преодолеет планку в 90%. Лидеры на момент релиза демонстрируют 81–83%. Применение той же модели выживаемости, обученной на 203 бенчмарках, прогнозирует ему около девяти месяцев жизни: вероятность дотянуть до годового рубежа составляет примерно треть, а до двухлетнего — 5–7%. Более сложное подмножество, где передовые модели набирают 65–70%, согласно расчетам, продержится 12–14 месяцев.
Аналогичные тесты в моем датасете завершали жизненный цикл именно так. Из шести бенчмарков 2025–2026 годов с сопоставимым стартовым запасом прочности пять погибли в первые полгода. Инструмент DeepSearchQA от Google DeepMind вышел в декабре 2025 года с лучшим показателем 81,9 F1, а уже в феврале Claude Opus 4.6 набрал 91,3%. Система ExploitBench появилась в мае 2026 года с лидером на отметке 78%, а в сентябре GPT-6 Astra показал абсолютные 100%.

Тем не менее, внутренние данные самого OenoBench содержат контрдоводы. Модель Opus 4.7, представленная в апреле 2026 года, показала результат ниже, чем o3, вышедший годом ранее: за год пиковый показатель на моем бенчмарке не увеличился. Модель выживаемости обучена на тестовых наборах, публикуемых фронтир-лабораториями, под которые они целенаправленно оптимизируют свои архитектуры, и темпы прогресса ей известны только по этим метрикам. Предметной областью виноделия никто не занимается целенаправленно, поэтому улучшение результатов здесь происходит исключительно как побочный эффект общего совершенствования нейросетей.
Теперь я могу ответить рецензентам на языке цифр. Статический бенчмарк образца 2026 года с целевым порогом в 90% имеет 50-процентную вероятность продержаться год, если лидер на старте набирает около 70%. Два года он проживет, если лидер берет чуть более трети шкалы, и три года — если результат не превышает 20%. Агентной среде, дополнительно страдающей от внутренних сбоев, для двухлетней эксплуатации необходим стартовый лидер с показателем около 10%.
Относительно судьбы самого OenoBench у меня сформировалось два прогноза. Согласно модели, обученной на фронтир-бенчмарках, к маю 2027 года проект, вероятнее всего, исчерпает себя. Исходя же из собственной динамики — практически наверняка останется актуальным. Если оправдается второй сценарий, это будет означать, что значительная доля измеряемой скорости на популярных тестах представляет собой не столько интеллектуальный скачок моделей, сколько скорость их подгонки под конкретные измерительные инструменты. Если же подтвердится первый — алгоритмы действительно развиваются быстрее, чем мы успеваем проектировать для них тесты. Проверю это в мае 2027 года и опубликую результаты в комментариях.
Датасет и программный код
Датасет размещен на платформе Hugging Face, исходный код выложен на GitHub. Лицензия на данные — CC BY-SA 4.0, на код — Apache 2.0. Состав репозитория:
-
halflife_dataset_v3.csv— 235 записей: 224 бенчмарка для основного расчета и 11 исключенных позиций с указанием причины. Каждая строка содержит даты всех событий A–E с верифицированными источниками и цитатами, максимальные результаты на релизе и на момент среза, классификацию, формат, доступность теста и версию; -
decisions_log_v3.csv— 21 спорный прецедент с обоснованием примененного правила и источником; -
d3_matrix_v3.csv— 6 652 строки вида «релиз × бенчмарк × результат» по 230 релизам от девяти лабораторий; -
кодбук, руководства для разметчиков, скрипты агрегации, статистического анализа, генерации графиков и перекрестной проверки числовых показателей статьи.
Хеш-сумма SHA-256 файла halflife_dataset_v3.csv: aca4ea7525fa066d0f43a67d8dd12938b22fd654958d4d23e25559f4369ec847. Временной срез зафиксирован по состоянию на 30 сентября 2026 года, все последующие события не учитывались.
Если вы располагаете данными, отсутствующими в моем архиве, или обнаружили неточность в записях, пожалуйста, укажите в комментариях название бенчмарка и первоисточник. Я верифицирую информацию, актуализирую датасет и зафиксирую правку в истории изменений.
Источники
-
Kiela D. et al. Dynabench: Rethinking Benchmarking in NLP. NAACL 2021. arXiv:2104.14337
-
Ott S. et al. Mapping global dynamics of benchmark creation and saturation in artificial intelligence. Nature Communications 13, 6793 (2022). nature.com
-
Ho A. et al. A Rosetta Stone for AI Benchmarks (2025). arXiv:2512.00193, данные: epoch-research/benchmark-stitching
-
Akhtar M. et al. When AI Benchmarks Plateau: A Systematic Study of Benchmark Saturation (2026). arXiv:2602.16763, код: evaleval/benchmark-saturation
-
HLE-Verified (Qwen Team, 2026). arXiv:2602.13964
-
OpenAI. Why we no longer evaluate SWE-bench Verified (2026). openai.com
-
Cheating Automatic LLM Benchmarks: Null Models Achieve High Win Rates (2024). arXiv:2410.07137
-
SABER: аудит τ-bench (2025). arXiv:2512.07850
-
ARC Prize. OpenAI o3 Breakthrough High Score on ARC-AGI-Pub (2024). arcprize.org
-
Terminal-Bench: анонсы версий 2.0, 2.1, 3.0 и 4.0. tbench.ai/news
-
Davidson-Pilon C. lifelines: survival analysis in Python. github.com/CamDavidsonPilon/lifelines
-
Худов Н. Как я собрал винный бенчмарк на 3 266 вопросов руками LLM и где они меня подвели. SE7EN, 2026. habr.com, датасет: huggingface.co/datasets/nikitahudov/oenobench-v1
Более ранняя популярная версия этого исследования выходила на vc.ru: «Бенчмарки ИИ теперь живут пять месяцев. Что мерить вместо балла в рейтинге».
Об автономных агентных системах, методологии оценки моделей и бизнес-последствиях этих процессов я пишу в Telegram-канале AGI Boardroom.
Примечание об инструментах. Формирование матрицы карточек, разметка по кодбуку и написание аналитического кода в значительной степени выполнялись агентами Claude; я разрабатывал сам кодбук, ставил задачи, разрешал возникающие противоречия и утверждал финальные результаты. Даты появления и гибели размечивались алгоритмически с независимым перекрестным аудитом части выборки вторым агентом; все ключевые решения, ставшие основой статьи, приняты мной лично и зафиксированы в журнале решений репозитория. Данный материал также создавался при экспертной поддержке Claude, автоматизировавшего извлечение метрик из датасета со скриптами анализа и построение графиков. Все числовые показатели в тексте верифицируются выполнением скриптов из репозитория проекта.
Похожие статьи
 Искусственный интеллект и грядущее планеты
 Эволюция и закат плазменных телевизоров
 Осень. Срочно зовите Перельмана — я доказал гипотезу Римана
 Как нейросети обходят классический поиск при сборке кубика Рубика с помощью CayleyPy
 Обнаружен мозговой переключатель сна: как редкие нейроны управляют засыпанием
 Семь из девяти планетарных границ уже пройдено: человечество на краю экологической катастрофы
 Как устроены межбанковские переводы: заглядываем под капот системы
 Как получить 360 сертификатов по искусственному интеллекту за один день с помощью ChatGPT