Скрытые тайны рукописи Войнича: разгадан новый слой 600-летней загадки
Я обратился к манускрипту Войнича в поисках сокровенной тайны, вооружившись технологиями XXI века. Сквозь лабиринты геометрических фигур, причудливую флору и ряды загадочных литер я пытался уловить логику чьей-то угасшей мысли. Каждая гипотеза подвергалась жесткому тестированию, и далеко не каждая выдерживала проверку на прочность.

Эту книгу хочется изучать в абсолютной тишине, едва ли не шепотом, даже когда перед глазами всего лишь цифровой скан.
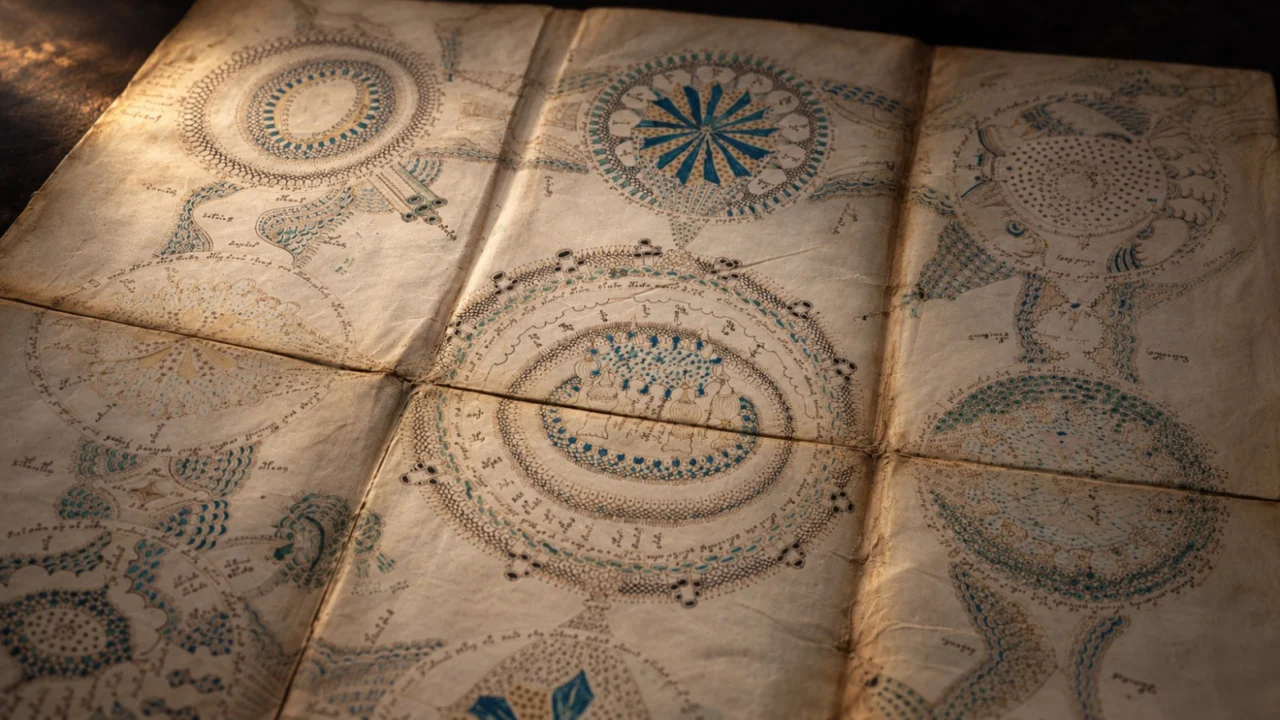
По тончайшим водопроводам живительная влага устремляется в изумрудные резервуары, где погружены обнаженные женские силуэты. Выше тянутся безупречно ровные строки, начертанные твердой рукой средневекового писца. На соседних страницах проступают фантастические растения с диковинными корневищами, а следом разворачиваются сферы, астральные тела и алхимические сосуды. Отдельные элементы кажутся смутно знакомыми, но общая картина неизменно ускользает, создавая впечатляющий эффект присутствия в параллельной реальности.
Рукопись Войнича — подлинный артефакт, бережно хранимый в Библиотеке редких книг и рукописей Бейнеке Йельского университета.
Работать над манускриптом приходилось преимущественно в ночные часы. Дневная рутина отнимала все ресурсы, оставляя Войничу лишь время глубокого вечера. В наступившей тишине оставались лишь сияние монитора, увеличенные детали иллюстраций и бесчисленные попытки предшественников разгадать этот ребус. Я штудировал старинные трактаты, лавировал между взаимоисключающими гипотезами и неизменно возвращался к тем же загадочным женским фигурам у изумрудной воды.
От бесконечного созерцания застывших изображений начинало казаться, что безмолвные страницы обретают голос. В изгибах труб чудился глухой гул, а в плотном строю символов — едва различимый шепот. Казалось, еще мгновение — и смысл откроется. И пусть разум фиксировал лишь холодный пиксельный экран, это иллюзорное ощущение рассеивалось очень нескоро.

Эту книгу хочется изучать в абсолютной тишине, едва ли не шепотом, даже когда перед глазами всего лишь цифровой скан.
По тончайшим водопроводам живительная влага устремляется в изумрудные резервуары, где погружены обнаженные женские силуэты. Выше тянутся безупречно ровные строки, начертанные твердой рукой средневекового писца. На соседних страницах проступают фантастические растения с диковинными корневищами, а следом разворачиваются сферы, астральные тела и алхимические сосуды. Отдельные элементы кажутся смутно знакомыми, но общая картина неизменно ускользает, создавая впечатляющий эффект присутствия в параллельной реальности.

На фоне усталости любые интерпретации казались убедительными. Стоило принять одну трактовку, как очередной штрих иллюстрации тут же начинал служить ее подтверждением. Подобным образом можно сконструировать сложнейший эзотерический ритуал, не разобравшись ни в едином знаке. Многовековая аура фолианта давала воображению абсолютную свободу.
Желание докопаться до истины нарастало с каждым днем. Хотелось понять природу притяжения этих страниц и поставить точку в вопросе, который не отпускал даже после закрытия ноутбука. Но именно в такие моменты велик риск принять собственную фантазию за истинный глас автора.
Что скрывали с таким упоением? Фармацевтические рецепты? Ересь запретных учений? Анатомические атласы? Или тривиальный текст на утерянном наречий, чей ключ канул в Лету?
Я ступил на этот путь, движимый жаждой сенсации. Инструменты математического анализа и машинного обучения позволяли просчитать тысячи гипотез там, где раньше исследователи пасовали перед пергаментом. Направить эту мощь на непреклонную шестивековую стену казалось логичным шагом. Однако сперва пришлось дать себе зарок: если я стремлюсь услышать книгу, нельзя навязывать ей желаемые ответы.
Первый ключ почти повернулся
Первые зацепки обнаружились в зодиакальных диаграммах. В центре композиции располагался узнаваемый символ, окруженный ансамблем антропоморфных фигур со звездами и индивидуальными подписями. Здесь манускрипт словно шел на контакт: по крайней мере, иконографию можно было интерпретировать без знания алфавита.

На некоторых разворотах персонажи сгруппированы по тридцать, причем символы Овна и Тельца разбиты на парные блоки по пятнадцать. Эта особенность давно известна исследователям. Тем не менее она задавала четкий критерий проверки: если перед нами астрономический календарь, то что именно зашифровано рядом с каждой фигурой — даты, градусы, имена или ритуальные действия? Быть может, здесь кроется синтаксический ключ к расшифровке хоть какого-то фрагмента?
Я приступил к скрупулезному подсчету и сопоставлению подписей, скорректировав первоначальные выкладки (фрагменты составных надписей нельзя было трактовать как самостоятельные лексемы). В итоге зодиакальный массив насчитывал 299 записей, из которых 290 поддавались прочтению. Большинство полных подписей не дублировалось, а поверхностное сходство графем не давало оснований считать их тождественными.
Следующей вехой стал круговой диаграммный модуль на листе 69v. От центра расходились двадцать восемь лучей (чередующихся по длине), сопровождаемых аналогичным количеством текстовых маркеров.

Число 28 четко соотносилось с лунными стоянками — классическими делениями небесного экватора в средневековых астрологических системах. Нити поиска привели меня к трактату Picatrix — фундаментальному своду астральной магии, где небесные конфигурации увязывались с созданием талисманов, а также приводились имена и функции «владык» каждой стоянки. Я опирался на критическое латинское издание историка науки Дэвида Пингри. Впервые загадочные знаки манускрипта сопоставлялись не с умозрительным словарем, а с весомым историческим документом.
Тайное обретало осязаемые контуры. Если перед нами руководство по талисманам, то радиальные линии выступают в роли разметки, а подписи — это те самые сакральные имена, подлежащие нанесению на артефакт. Оставалось выяснить вектор чтения и стартовую точку.
В полумраке ночных изысканий эта версия казалась безупречной: солидный первоисточник, идеальное совпадение численных параметров и практическое назначение текста. Тем критичнее было не поддаваться искушению выдать желаемое за действительное.
Я проверил различные направления обхода схемы. Одно из сопоставлений выглядело многообещающе: схожие подписи приходились на родственные лунные стоянки. Однако независимый латинский реестр отказался укладываться в ту же последовательность. Всплыла и очевидная логическая преграда: подпись, повторенная трижды, в таком случае пришлось бы трактовать как три абсолютно разных имени.
Возможно, возле лучей фиксировались не наименования, а свойства или функционал? Проверка этой гипотезы, равно как и поиск имен талисманических владык, не принесла статистически значимых результатов. Нумерологический базис (28) остался незыблемым, связь с лунными стоянками — гипотетической, а заветный ключ к письменам — по-прежнему отсутствующим.
Тем не менее этап принес важный методологический плод: я научился строго разграничивать визуальный образ иллюстрации и семантику подписи. Можно безошибочно определить знак зодиака, не владея ни единым словом алфавита Войнича. Можно найти аналогичную средневековую схему, но не иметь никаких прав автоматически переносить из нее лексику.
Следующая надежда строилась на сопоставлении двух разных разворотов. На листе 57v кольцевая структура воспроизводит последовательность из семнадцати элементов. Если отбросить диакритические знаки, арабская письменность также сводится к ограниченному набору базовых графем. Я протестировал модель «28 букв — 17 форм», допустив, что круг с 28 лучами и 17-знаковое кольцо представляют собой две части единого криптографического механизма.

В одном из вариантов сопоставления уровень совпадений оказался таков, что в случайной выборке подобное случалось примерно раз на три тысячи попыток. Классический фундамент для громкой научной сенсации.
Вся проблема крылась в слове «выбранном».
До этого момента я перебрал множество ключей. При долгом подборе комбинаций к сейфу какая-нибудь дверца обязательно приоткроется чистой случайностью. Перестроив алгоритм контроля так, чтобы случайность учитывала весь массив моих проб, я обнаружил, что эффектное совпадение проявляется уже в одном случае из шести. Ни о какой уникальности речи больше не шло.

Семнадцатизначные кольца никуда не исчезли, чернила остались подлинными, а закономерность — реальной. Но гипотетический ключ не объяснял иные диаграммы. Я зафиксировал структурный порядок в конкретной точке рукописи, не понимая его глубинного содержания.
Этот инсайт стал золотым правилом всего расследования: жизнеспособная гипотеза обязана подтверждать себя на новом материале без посторонней помощи. Если концепция объясняет лишь страницу, где родилась, — фундаментального открытия не произошло.
Растение, которое не хотело называться
Следующий вектор поисков носил почти наивный характер. Если возле корня нарисована подпись, не является ли она ботаническим наименованием? Отыскать одно растение, прочесть одно слово, зацепиться за него и раскрутить весь клубок.

Короткие текстовые маркеры регулярно повторялись. Некоторые ботанические изображения казались взаимозаменяемыми. На таких страницах иллюзия близкого прорыва достигает пика — кажется, вот-вот сложатся узнаваемые образы. В этом кроется совершенство как великих загадок, так и безупречных ловушек: они оставляют ровно столько зацепок, чтобы человек продолжал идти по ложному следу.
Я изолировал подписи, пытаясь реконструировать соответствия исключительно на основе визуальных форм, а затем сопоставил результаты с контрольными массивами, где связи между рисунками и текстом были искусственно перемешаны. Статистически значимого превосходства выявить не удалось.
Это вовсе не значит, что иллюстрации лишены смысла. Возможно, изображенная часть флоры носила условный характер, подпись описывала технологию приготовления сбора целиком, либо разные рисунки обозначали тождественные фармакологические манипуляции. Но объявлять конкретный корень «словарным ключом» лишь на основании внешнего сходства я больше не имел права.
Ни астрономические круги, ни гербарий не принесли ключа к шифру. Тогда я отвел взгляд от броских иллюстраций и сосредоточился на том, что заполняло все свободное пространство между ними, — на ординарных строках текста.
Тайна остановилась на краю строки
Незнакомая письменность поддается формальному анализу и без дешифровки. Одни символы тяготеют к началу строк, другие — к финалу. Определенные графемные кластеры соседствуют друг с другом гораздо чаще, чем с прочими элементами. Подобные закономерности поддаются строгому учету без привязки к звуковым значениям букв.

В естественных языках при переносе предложения на новую строку смысловая и синтаксическая связь между словами сохраняется. В рукописи Войнича обнаружилась иная аномалия: статистическая связь между смежными графическими кластерами резко обрывалась ровно в том месте, где перо переходило на новую строку.
Проанализировав 3 884 межстрочных перехода, я зафиксировал, что за границей строки сохранялось лишь около пяти процентов исходной корреляции, которая вновь восстанавливалась с началом следующего ряда. В контрольных массивах английского текста, разбитого на отрезки аналогичной длины, подобного эффекта не наблюдалось.
Разумеется, речь шла об одной измеримой особенности письма, а не о тотальном разрушении всех связей. Но этот маркер кардинально менял вектор поиска. Почему физический край строки играл столь фатальную роль для синтаксиса? Что именно обнулялось на этом рубеже?
Я детализировал анализ коротких символьных групп, разделив их на периферийные элементы и центральные ядра. Подобно тому как сложные отмычки раскладывают на стержень и секретные зубцы, не имея понятия о внутреннем устройстве замка, я стал выстраивать семейства знаков.

Для выявления подобных переходов знание алфавита не требовалось — достаточно было отслеживать визуальную эволюцию форм, где к базовому контуру последовательно добавлялись новые элементы.
Среди 1 819 вариативных внутренних структур выделилась доминирующая «лесенка», где на каждом шаге инкорпорировался ровно один новый знак. Шесть градаций этой структуры (включая пустой центр) зафиксированы 5 107 раз — примерно в каждой пятой из 23 859 проанализированных групп.
И вновь возникал риск преждевременных выводов. Родственные морфологические формы свойственны и естественным языкам, а случайные цепочки знаков легко выстраиваются в ряды путем замены единичных деталей. Проверка подтвердила этот тезис: само по себе обилие структурно схожих форм являлось слабым аргументом.
Куда важнее было другое: манускрипт с железной регулярностью воспроизводил весьма ограниченный набор графических паттернов. Компактная матрица их комбинаций покрывала 94 процента изученных вхождений с непустым центром. Это не означало «94% расшифрованного текста». Это был ответ на куда более скромный вопрос: сколь простым должен быть генеративный алгоритм, чтобы воспроизвести наблюдаемый визуальный ряд?
Пока фолиант рассматривался как хранилище смыслов, он казался непроницаемой бездной. Когда фокус сместился на повторяющиеся операции, структура заметно упростилась. Однако сохранялся риск: а не порожден ли этот порядок изъянами современной цифровой транскрипции?
А если ошиблась не программа?
Компьютер не воспринимает средневековый пергамент человеческими глазами. Для вычислений текст переводится в цифровую кодировку. Существующие транскрипции ценны, но несовершенны: выцветшие чернила, слившиеся штрихи или неоднозначные межбумажные интервалы регулярно провоцируют ошибки.
Поэтому я верифицировал данные по нескольким независимым транскрипциям, а в спорных случаях возвращался непосредственно к сканам оригиналов. Все рабочие правки фиксировались с возможностью отката.
И здесь открылась аномалия ценнее любого случайного совпадения. Формализованные закономерности стали указывать на точки сбоя в существующих транскрипциях: алгоритм ожидал определенный элемент, а в текстовом файле стоял иной символ. Такие расхождения проверялись по визуальным первоисточникам.
Возьмем высокий знак в обрамлении. Его старое и новое прочтения различаются одной латинской литерой. Для машины это критично, для человека — неочевидно. Ниже представлены спорный фрагмент и два альтернативных образца с того же листа.

Анализу подвергался изгиб верхнего штриха высокого знака, точка его замыкания и характер стыковки с соседними линиями. Сравнение с альтернативными прочтениями и сканом подтвердило правомерность корректировки. Закономерность помогла обнаружить текстологическую ошибку, причем валидность исправления доказывалась независимо от самой модели.
Фиксировались и обратные ситуации. На другом листе пришлось вернуть исходный вариант, забракованный в первом примере. Соседние группы в той же строке предоставляли идеальный материал для верификации.

Речь шла не о реставрации утраченных пигментов и не о цифровой дорисовке смазанных участков. Программа формировала прецизионный запрос к конкретной точке фолианта, а окончательный вердикт выносился на основе комплексного сопоставления изображений, транскрипций и верифицированных закономерностей.
Итоговый реестр включил 13 правок базовых транскрипций, 27 корректировок сводных таблиц сопоставления и 7 самостоятельных визуальных решений. Еще 7 точек остались в статусе неразрешенных аномалий из-за низкого качества сканов.
Сила метода заключалась не только в способности находить ошибки, но и в готовности вовремя остановиться.
Пробел тоже оказался подозреваемым
Ошибиться можно не только в начертании отдельного знака, но и в сегментации текста — определении границ между графическими группами. Неверно поставленный разделитель дробит единый объект на две части или создает фантомную пустоту там, где пергамент сплошь залит чернилами.

Я проверил и этот параметр. Контрольный слой выявил 11 ячеек, ранее считавшихся пустыми. В 10 случаях сканы подтвердили наличие знаков или целостных групп, что согласовывалось с альтернативными транскрипциями. В оставшемся эпизоде отсутствие пробела фиксировалось уверенно, но точную границу знаков восстановить не удалось.
В ходе обсуждений эту проблему условно именовали «двойными пробелами». Однако углубленный анализ показал, что реальных феноменов с такой разметкой в итоговом датасете нет — фиксировались лишь артефакты современного синтаксического членения, возводить которые в ранг средневековой традиции было бы методологической ошибкой.
Привычный вопрос «о чем здесь написано?» вновь оказался преждевременным. Сперва требовалось жестко зафиксировать границы анализируемых графических массивов, согласовать разночтения историографии и верифицировать точность прочтения.
Как появляется новый слой книги
В этом и заключается ключевой итог проделанной работы.
Для всех 23 859 верифицированных участков текста я построил многомерную карту. Каждый фрагмент получил уникальный цифровой адрес, объединяющий варианты транскрипций, внутреннюю морфологию, тип окончания, позицию в строке и историю проверок. Расхождения источников теперь не маскируются усредненной статистикой, а сомнения не растворяются в итоговых цифрах.
Эту элементарную единицу сравнения я назвал *клеткой*. Терминологическое допущение не означает, что средневековый автор оперировал понятиями «слов» или «слогов» — оно необходимо лишь для унификации перекрестных проверок.

Главное достоинство созданной карты заключается в возможности проверить, скрывается ли за вариативными начертаниями разных исследователей единая структурная матрица. Интерпретация текста перестает зависеть от личных предпочтений автора конкретной транскрипции.
Проверка строилась по принципу строгого экзамена: модель обучалась на одних физических листах, после чего тестировалась на совершенно незнакомом материале. Прогнозируемые результаты фиксировались до сверки с эталоном. Провал проверочного теста означал дисквалификацию ветки гипотез.
Почему тестирование проводилось целыми листами? Из-за высокой степени автокорреляции соседних строк. Попадание смежных строк в обучающую и тестовую выборки позволило бы машине распознать индивидуальный почерк писца, приняв его за универсальное правило. Мне требовалось доказать устойчивость алгоритма на принципиально новых страницах.
В одной из серий тестов зафиксировано 52 310 безошибочных предсказаний (с учетом повторных кросс-валидаций). В контрольном массиве из 1 926 ответов совпало 1 910; 16 спорных расхождений были исключены из итогового набора.
Наиболее строгий статус данных получил грейд *strict* («подтверждено»). Предварительный массив данных существовал и до моего исследования, но задача заключалась в том, чтобы отделить устойчивые эмпирические паттерны от гипотетических спекуляций. Полная расшифровка каждой клетки манускрипта и формальное подтверждение всех закономерностей — принципиально разные задачи.
Однако природа самого объекта исследования изменилась. Перед нами предстали не просто таинственные страницы для проекции новых безумных теорий, а структурированный массив данных, позволяющий дифференцировать реальные грамматические правила от случайного статистического шума.
Новый аналитический слой создан для того, чтобы будущие исследователи избавлялись от необходимости гадать по поводу каждой сомнительной закорючки.
У этой двери уже стояли другие
Идея о том, что войническое письмо может генерироваться путем итеративных модификаций базовых элементов, возникла задолго до моего проекта. В 2014 году Торстен Тимм подробно описал морфологическую близость знаковых форм. Позднее Торстен Тимм и Андреас Шиннер (Torsten Timm & Andreas Schinner) в работе «A Possible Generating Algorithm of the Voynich Manuscript» (онлайн-релиз в 2019 г., печатная версия в 2020 г.) предложили алгоритм симуляции похожего текста через копирование и мутацию существующих фрагментов. Этот принцип не был моим открытием.
Параллельно развивалось другое направление. Марсело Монтемурро и Дамиан Занетте (Montemurro & Zanette, 2013) в исследовании «Keywords and Co-Occurrence Patterns in the Voynich Manuscript» доказали, что определенные кластеры знаков распределяются по тексту неравномерно, образуя тематические кластеры. Это весомый аргумент в пользу семантической структуры манускрипта: в естественных языках ботаническая лексика также концентрируется в профильных главах. Мои изыскания не дезавуируют их выводы. Вопрос в ином: требует ли выявленное сходство обязательного наличия смысла, или его способен порождать чисто комбинаторный механизм?
Мне предстояло выяснить, какие условия минимально необходимы для симуляции подобных свойств. Обязателен ли скрытый осмысленный текст-первоисточник, или часть эффектов возникает за счет циклического обращения к недавним паттернам и дрейфа правил от раздела к разделу?
Чужие гипотезы были переведены в статус проверяемых кандидатов. Я протестировал несколько концепций: табличный выбор, жесткие синтаксические цепочки, репликацию с мутациями, гибридные схемы и статистическую трансформацию естественных языков. Все модели проходили один и тот же экзамен из шести проверок.
Пять базовых подходов потерпели крах. Модель чистого копирования, отлично справлявшаяся с симуляцией локальных повторов, провалила пять тестов из шести: жесткая ориентация на копирование соседей порождала распределение связей, принципиально отличное от реального манускрипта.
Это не опровергает фундаментальные труды Тимма и Шиннера. Я тестировал конкретные реализации их идей. Вывод носил локальный характер: простого копирования недостаточно; его необходимо комбинировать с иными ограничениями, выявленными в ходе замеров.
Здесь и проходила граница моего вклада. Я не открывал саму возможность алгоритмической генерации, но проверил, какие ее элементы выдерживают новые эмпирические ограничения, а какие разрушаются под их натиском.
Две с половиной секунды
В следующей итерации модель выбирала допустимую форму либо возвращалась к одному из недавних паттернов, периодически модифицируя единичный элемент. Алгоритм дифференцировано учитывал концевые морфемы, правила межстрочных переходов и индивидуальные настройки для различных разделов фолианта.
Этому генератору не требовались вводные инструкции о целебных травах, небесных сферах или сакральной алхимии.
Он сгенерировал 23 859 знаковых групп за 2,6 секунды.
Сама по себе скорость счета ничего не говорит о XV веке — современные процессоры превосходят гусиное перо на порядки. Важнее другое: для воспроизведения масштабного массива текстовых свойств не потребовалось предварительно сочинять осмысленный трактат и шифровать его. Следующая графема выбиралась на основе компактного набора правил.
|
Наблюдаемая привычка |
Рукопись |
Генератор |
|---|---|---|
|
Доля самого частого окончания |
49,3% |
47,9% |
|
Одинаковые группы рядом |
2,45% |
2,73% |
|
Соседи, отличающиеся одним знаком |
16,6% |
14,9% |
Степень сходства оказалась достаточно высокой, чтобы исключить гипотезу о бессмысленном наборе каракулей. Однако до полного тождества было далеко: генератор выдал 4 475 уникальных форм против 2 432 в оригинальном тексте, излишне увлекаясь новаторством и слабо отражая стилевые различия между разделами.
Этот провал очерчивает границы выводов: я получил работающую модель для целого спектра внешних свойств письма, но не абсолютный двойник подлинника. Воспроизведенные параметры больше нельзя считать исключительной прерогативой осмысленного языка, а невоспроизведенные остаются вызовом для будущих изысканий.
Возникал закономерный вопрос: если отбросить феноменальную скорость вычислительной техники, насколько сложен сам процесс принятия решений? Мог ли средневековый фальсификатор воспроизвести его вручную, вооружившись пергаментом, чернилами и толикой терпения?
Три круга на верёвочках
Представьте три вращающихся бумажных диска со стрелками. На первом зафиксированы допустимые инициалы групп, на втором — вариативные центральные элементы, на третьем — окончания. Поворот указателей определяет следующий графический элемент, а шнуры фиксируют текущий выбор и задают правила перехода к последующим действиям.

Порядок написания новой группы прост: выбрать префикс, добавить санкционированные элементы центра, завершить разрешенным знаком. Иногда вместо генерации нового элемента достаточно бросить взгляд на предшествующие группы, скопировать одну из них и внести единичное искажение. При переходе на новую строку часть алгоритмических правил сбрасывается к исходным настройкам.
Это наглядная материальная реконструкция гипотетического процесса. Роль дисков могли выполнять гроссбухи, пергаментные полосы или просто заученные писцом алгоритмические привычки. Исторических артефактов подобного рода не обнаружено, но сама модель доказывает: описываемая процедура не требует компьютерных вычислений.
Концепция ручных симулятивных устройств имеет своих предшественников. Еще в 2004 году Гордон Рагг демонстрировал метод генерации похожих псевдотекстов с помощью таблиц и шаблонов. Однако симуляция отдельных графем не решала комплексных задач: требовалось объяснить глобальный синтаксический порядок, внутренние повторы, вариативность разделов и аномалии на краях строк.
Ценность моего подхода в том, что механику процесса удалось продемонстрировать наглядно. За термином «генерация» больше не скрывается магия искусственного интеллекта — налицо ограниченный арсенал деталей и жесткая последовательность доступных операций, создающих иллюзию письма, неизмеримо более сложного, чем породившая его инструкция.
И тогда иллюстрации, с которых начиналось исследование, потребовали принципиально иного взгляда.
Сколько стоит тайна

Алхимический сосуд рядом с причудливым корневищем мгновенно уподобляет страницу фармакопее. Диаграммы небесных сфер обещают раскрыть тайны мироздания. Обнаженные фигуры и загадочные трубы провоцируют ассоциации с сокровенным знанием и запретными практиками. Фолиант задает собственный жанр восприятия задолго до прочтения первого предложения.
Иллюстрации вполне могли синтезировать реальные ботанические образцы, условные схемы и плоды чистой фантазии. Писцы умели тиражировать изображения растений, никогда в глаза их не видя, искажая пропорции, контаминируя детали или намеренно придавая им причудливый вид. Но любая гипотеза о заимствованиях обязана подкрепляться сопоставлением с реальными иконографическими источниками. Одного ощущения «это выглядит знакомо» явно недостаточно.
Если текстовый массив действительно порождается сравнительно простым генеративным алгоритмом, становится понятен коммерческий мотив создания фолианта, симулирующего хранилище эзотерических мудростей. Создание подобной книги не требовало титанического труда над сложнейшим трактатом, зато броские иллюстрации и абсолютная непроницаемость письма наделяли артефакт колоссальным авторитетом в глазах покупателя.
Отсюда вырисовывается прагматичная гипотеза: объектом продажи выступал не содержательный контент, а иллюзия обладания эксклюзивным сакральным знанием, где ценность продукта определялась исключительно верой заказчика в его исключительность.
Эта версия заслуживает глубокой проверки, но на данном рубеже строгий расчет уступает место историческим спекуляциям. Анализ частотности знаков не способен измерить степень корысти средневекового автора. Те же алгоритмические практики могли обслуживать ритуалы, учебные упражнения, эзотерические игры или аутентичные духовные практики. К тому же, если иллюстрации несут самостоятельную смысловую нагрузку, модель генерации текста вовсе их не отменяет.
К этому моменту техническая составляющая расследования прояснилась, а человеческая — напротив, запуталась окончательно. Я научился воспроизводить формальные свойства текста, но так и не смог проникнуть в намерения человека, державшего перо шесть веков назад.
Осталась ли внутри фраза?
Существует контраргумент, который невозможно сбросить со счетов ради красивого финала. Что если вариативность выбора между допустимыми формами сама по себе выступает носителем сообщения? Внешняя оболочка может подчиняться простейшим комбинаторным правилам, тогда как скрытый смысл заложен в нюансах выбора конкретных альтернатив.
Это не умозрительная абстракция. В 2025 году Майкл Грешко опубликовал описание шифра Naibbe, трансформирующего латинский или итальянский текст в последовательность, которая воспроизводит статистические свойства войнического письма с возможностью обратного преобразования. Автор не претендовал на расшифровку манускрипта, но наглядно продемонстрировал, что схожие статистические профили вполне совместимы с реальным закодированным сообщением.
Именно поэтому я не имею права безапелляционно заявлять: «смысла там нет». Равно как не могу предъявить диаграмму, где на осмысленный текст отведено три процента вероятности, а на мистификацию — девяносто семь. Подобные вероятностные оценки требуют принципиально иной, строго обоснованной модели, которой в моем распоряжении пока нет.
Итоговый вывод звучит куда скромнее и точнее. Для значительной части внешних формальных характеристик манускрипта найден воспроизводимый алгоритмический механизм, не требующий привлечения гипотетического первотекста. Построена верифицированная карта текстовых блоков, внесены необходимые исправления в транскрипции, доказана устойчивость графемных паттернов и сформулированы жесткие ограничения для будущих попыток дешифровки. Перед нами предстал рабочий научный инструмент, а не повод для бесконечных спекуляций.
Полученный результат можно сравнить с найденной точной масштабной моделью самолета. Все элементы на месте — крылья, фюзеляж, кабина. Мы понимаем принципы сборки. Но внешнее сходство с летательным аппаратом не заменяет реального полета. Чтобы доказать способность машины подниматься в воздух, необходим действующий двигатель и эмпирические испытания, а не повторные указания на аэродинамическую форму крыла.
Ровно та же ситуация складывается и здесь: внутренние повторы, синтаксический порядок и статистические корреляции сами по себе больше не доказывают наличие скрытого лингвистического сообщения. Гипотезе о семантическом содержании манускрипта предстоит доказать свою состоятельность иным путем — предъявить устойчивый метод перевода, внешний дешифровальный ключ или верифицируемые прогнозы на страницах, к которым модель заранее не адаптировали.
Это не триумф одной из противоборствующих концепций, а переход дискуссии на принципиально иной уровень строгости. Если предложенный алгоритмический механизм достаточен лишь отчасти — его следует доработать или опровергнуть. Если внутри зашифрован осмысленный текст — необходимо продемонстрировать процедуру его извлечения и независимого тестирования.
Я обратился к этой книге в поисках тайного знания. Самым ценным открытием стал надежный метод проверки, позволяющий отличить иллюзию открытия от доказанного факта.
Похожие статьи
 Сколько близких звезд мы упустили из виду?
 18 снимков наглядно покажут колоссальные масштабы нашей вселенной
 Мы как мир
 Необратимость времени
 Зачем ИТ-гиганты скупают книги и чужую почту за миллионы?
 У искусственного интеллекта есть знания, а у человека — контекст
 Мифы и правда о скорости визуального восприятия
 Эволюция латиницы в славянских языках: почему польский и чешский алфавиты так не похожи?