Сколько придётся заплатить, чтобы узнать о ста хитах Бриттона
В игре с несколькими тысячами NPC больше всего памяти может занимать вовсе не меш, скелет, физический коллайдер или навигационная сетка, а такая характеристика, как health = 100. Если реализовать её по классическим рекомендациям из книг по C++, на одного персонажа уйдёт 880 байт и 14 аллокаций, а чтение числа займёт 27 наносекунд. При этом полезных данных внутри будет всего 20 байт.
Расскажу, как единый подход позволил сократить эти 880 байт до 64, избавиться от лишних аллокаций и сделать структуры дружественнее к кешу. Для понимания текста полезно знать, что такое указатели и аллокации, помнить, что кеш-линия современного процессора занимает 64 байта и считывается целиком, даже когда нужен лишь один байт или бит, а также при необходимости познакомиться с понятиями AoS и SoA. Остальное разберём по ходу.
Итак, откуда вообще взялась задача? В проекте был компонент для хранения небольшого набора произвольных данных сущности — например, свойств, которые дизайнер задавал в редакторе. По сути, обычный лист персонажа:
name = "The One"
stats = {
    health = 100
    mana = 200
}
status_effects = {
    drunk = true
    delirious = true
}
Когда-то эти данные поместили в упрощённый JSON: для тогдашней задачи так было удобнее. Формат допускает только булевы значения, числа с плавающей точкой, строки, объекты и массивы чисел. Парсер для него настолько прост, что его можно написать за вечер. Было это около пяти лет назад, так что никакой Клавдий к созданию решения отношения не имел. Произвольные массивы тоже запрещены: если нужен список предметов, приходится создавать объект, ключами которого служат GUID.
Ограничение может показаться прихотью автора формата, но у него есть следствие: строки и массивы чисел считаются неделимыми при слиянии. Поэтому любую операцию над данными можно выразить как «присвоить значение ключу».
Благодаря этому правки сливаются предсказуемо. Если один дизайнер изменил в редакторе stats.health, а другой в отдельной ветке что-то поправил в status_effects.drunk, обе правки объединятся без разрешения конфликтов и ожидания ревью. С произвольным вложенным массивом всё сложнее: достаточно одному человеку вставить элемент в середину, а другому удалить третий с конца, чтобы стало ясно, почему массивы объектов плохо подходят для таких конфигов.
Сетевому коду ограничение тоже на пользу: операция «присвоить ключу значение» идемпотентна. Её можно отправить повторно и применить ещё раз без дополнительных последствий — в отличие от операции вставки в массив. Будем считать, что данных на одну сущность немного, но самих сущностей много, поэтому важны и память, и скорость. Тысяча NPC на уровне, у каждого из которых есть собственный лист свойств или набор пар ключ-значение, — вполне рабочий сценарий.
Наивный подход
Можно воспользоваться STL и описать дерево, содержащее строки и массивы. Получится примерно такая структура:
enum class DataType { BOOL, FLOAT, STRING, OBJECT, ARRAY };

struct DataValue
{
    DataType type;
    union {
        bool b;
        float f;
        std::string *s;
        std::vector<float> *array;
        std::map<std::string, DataValue> *object;
    };
};
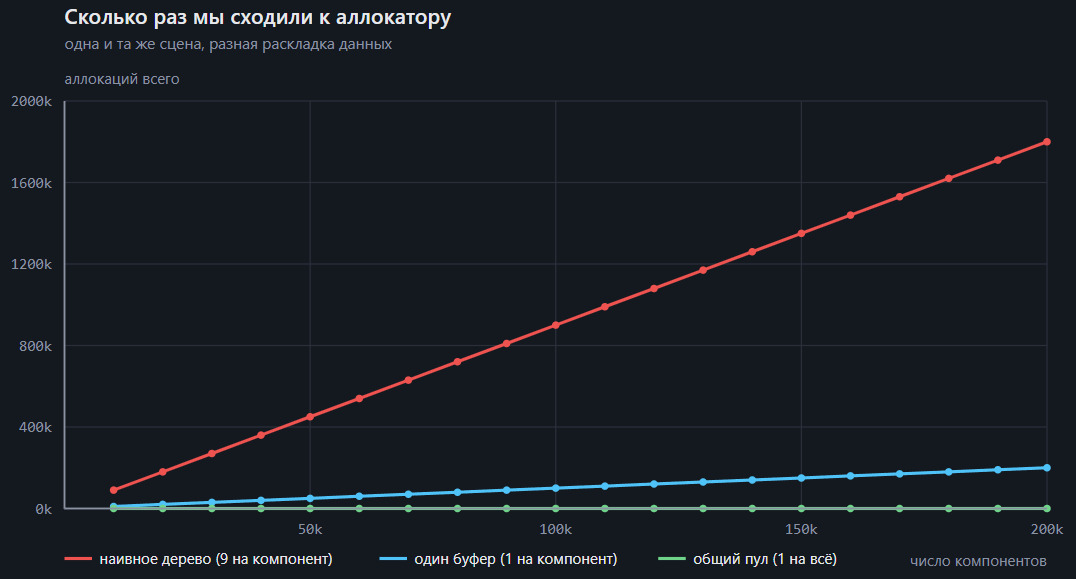
На бумаге всё выглядит аккуратно, но STL требует аллокаций: как явных, например new std::string, так и скрытых — внутри string, vector и каждого узла std::map. Для каждой пары ключ-значение map выделяет отдельный узел с тремя указателями и информацией о цвете. В результате лист персонажа из пяти ключей занимает 880 байт, хотя полезных данных в нём всего 20:
naive : allocs=14000 (14.0/сущность) bytes=880000 (880.0/сущность) lookup=27.0 ns/get
По современным меркам это немного, но ситуация меняется, когда у персонажа не пять ключей, а несколько сотен или почти тысяча. Тогда std::map внутри каждой сущности со стандартным размещением данных в памяти начинает заметно влиять на время кадра.
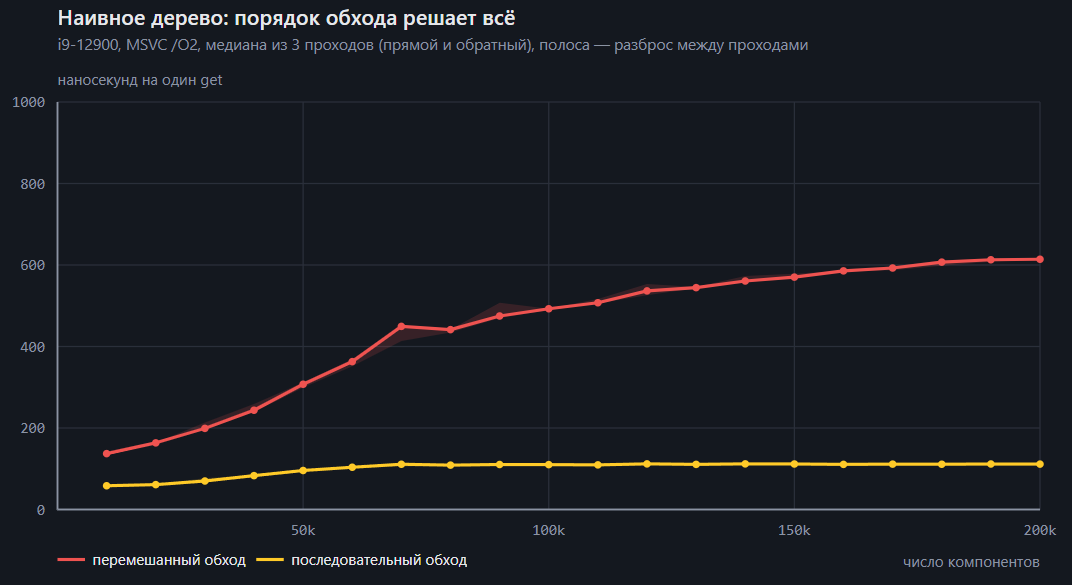
Итак, ради health, mana, двух флагов и короткого имени мы тратим 880 байт и выполняем 14 аллокаций. Причём 27 наносекунд на чтение — ещё хороший результат: в моём бенчмарке вся тысяча конфигов целиком помещается в кеш, и по-настоящему обращаться к оперативной памяти не приходится. Чтобы увидеть поведение за пределами кеша, повторим тот же тест на ста тысячах компонентов. Число выбрано произвольно, но даже этот сценарий оказался быстрее реального игрового кода:
naive tree : allocs=900000  bytes=54400000 (544 B/сущность)
             последовательный обход   =  79..96 ns/get
             перемешанный обход       = 352..429 ns/get
Почти четыреста наносекунд уходят на то, чтобы выяснить: у несчастного бритта в текущем кадре сто единиц здоровья. А теперь представим, что данные обрабатываются по расстоянию до игрока, приоритету LOD или в порядке, который выдала физическая система. Порядок адресов в памяти при этом практически никогда не соблюдается, поэтому перемешанный доступ — не худший случай, а повседневная реальность. Кроме того, соседние системы игры периодически вытесняют данные из кеша, так что время может увеличиться ещё в два-три раза. И узнать об этом зачастую можно только самостоятельно, разбираясь, почему упал FPS.
Шаг 1: хешируем ключи
После долгого изучения системы в отладчике или профайлере приходит первое наблюдение: сами строки ключей нам не нужны. Мы записываем и читаем значения по ключу, но не перечисляем ключи для показа пользователю. Значит, вместо строки можно хранить её хеш. Поскольку ключей у отдельной сущности немного, порой достаточно 32, 16 или даже 8 бит:
std::map<unsigned, DataValue> *object;
Одним движением мы убираем аллокацию для каждого ключа, а заодно избавляемся от сравнения строк при поиске. Сравнивать значения unsigned процессору проще и быстрее, чем даже короткие std::string.
Разумеется, есть и цена: в дампе памяти теперь лежит 0x7a3c91f4, по которому не узнать, что раньше это был stats.health. Поэтому добавляем таблицу «хеш → строка»: в релизной сборке её нет, а в отладочной специальный код раскрывает хеши обратно в строки. Это можно сделать прямо в Natvis для Visual Studio, так что программисты почти не заметят изменений. Коллизии среди немногочисленных ключей сущности будем устранять совместно с дизайнерами, не допуская конфликтующих имён.
Шаг 2: расплющиваем дерево
Второе наблюдение появляется после недели попыток ускорить STL map. Когда кто-то предлагает хранить не вложенные объекты, а только пары ключ-значение, выясняется, что дерево можно полностью расплющить. Вместо
name = "The One"
stats = { health = 100, mana = 200 }
начинаем хранить
name = "The One" <<< это уже unsigned
stats.health = 100
stats.mana = 200
Ключ stats.health тоже представляем как unsigned, но хешируем его не целой строкой, а по частям: отдельно stats, отдельно health, после чего смешиваем оба результата ещё одной хеш-функцией. Так получаем итоговый хеш-ключ.
Теперь иерархия существует только в редакторе и представлении дизайнера. Прочитать stats.health можно, а вот попросить такую map перечислить всё содержимое stats уже нельзя. На практике это допустимо: игровой код знает, какой ключ ему нужен, а перечисление требуется только редактору. За это приходится заплатить отдельной схемой данных для свойств персонажа в редакторе, зато всё дерево превращается в плоский массив:
struct Entry
{
    unsigned key;
    DataType type;
    union {
        bool b;
        float f;
        std::string *s;
        std::vector<float> *array;
    };
};

std::vector<Entry> data;
Специальной структуры для поиска больше нет: чтобы найти ключ, приходится последовательно проходить массив. На код-ревью это может выглядеть шагом назад, пока не посмотришь на результаты измерений. Кеш хорошо работает с линейным обходом, и на разумных размерах — менее тысячи записей — такой поиск может опережать std::map с её переходами по памяти. Ключи также можно отсортировать и искать бинарным поиском, но при сотне записей и меньше затраты на поддержание сортировки могут превысить выгоду от поиска.
naive      : allocs=14000 (14.0/ent) bytes=880000 (880.0/ent) lookup=27.0 ns/get
flat AoS   : allocs=6000  ( 6.0/ent) bytes=288000 (288.0/ent) lookup= 1.0 ns/get
Таким образом, 880 байт сократились до 288, а число аллокаций — с 14 до 6. При горячем кеше и пяти ключах поиск занимает около одной наносекунды.
Шаг 3: переходим на SoA
Теперь ключ ищется линейно, но вместе с ним в кеш попадают type и значение, которые на этапе поиска не нужны. Из каждой 16-байтовой записи Entry приходится загружать лишние данные: условно говоря, три четверти прочитанной кеш-линии оказываются бесполезны. Поэтому разделим массив структур на структуру массивов.
std::vector<unsigned>  keys;
std::vector<DataType>  types;
std::vector<Value>     values;
При поиске теперь читается только keys, а в одну кеш-линию помещается шестнадцать ключей вместо четырёх записей. Теоретически можно ожидать четырёхкратного ускорения, но измерения показывают другое:
|
вариант |
время поиска |
прочитано |
аллокаций |
|---|---|---|---|
|
AoS, 16 байт на запись |
90…96 нс |
640 байт, 10 кеш-линий |
6 на компонент |
|
SoA, три |
87…105 нс |
160 байт, 3 кеш-линии |
16 на компонент |
|
|
150…163 нс |
— |
— |
В кеш помещается вчетверо больше полезных данных, но время почти не изменилось. Действительно, мы прочитали 160 байт вместо 640, однако данные расположены в трёх разных участках памяти: каждый из трёх std::vector выделяет её независимо. В итоге экономия пропускной способности компенсируется дополнительными промахами кеша и обращениями к памяти.
Шаг 4: объединяем массивы в одном буфере
Красная и синяя линии на графике иллюстрируют результат предыдущего шага: попробуйте найти между ними существенную разницу.
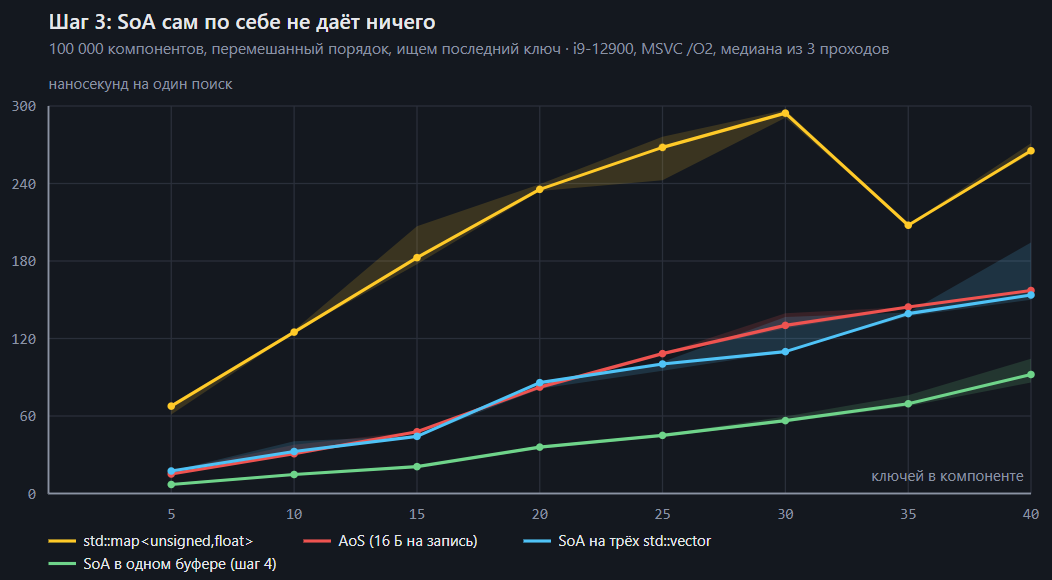
Красная линия AoS и синяя линия SoA на трёх векторах идут почти рядом: иногда пересекаются, иногда расходятся на несколько процентов. Жёлтая линия сверху показывает для сравнения медленный std::map, а зелёная внизу — результат, к которому мы ещё придём.
Чтобы избавиться от трёх отдельных аллокаций, заменим привычный std::vector собственной структурой vector3. Упрощённо устройство вектора можно представить так:
struct {
    int capacity;
    int size;
    unsigned *data;
};
Тогда три наших вектора можно описать следующим образом:
int        capacity;
int        size;
unsigned  *keys;
DataType  *types;
Value     *values;
Значения capacity и size у всех трёх массивов одинаковы и меняются одновременно, поэтому каждой переменной достаточно по одной на структуру. Массивы растут и перевыделяются вместе, а значит, можно выделить один буфер и разместить данные последовательно:
       -----------------------------------
buffer |   keys   |   types   |  values  |
       -----------------------------------
char *buffer = allocate(capacity * (sizeof(unsigned) + sizeof(DataType) + sizeof(Value)));
keys   = (unsigned *)buffer;
types  = (DataType *)(keys + capacity);
values = (Value *)(types + capacity);
Теперь SoA начинает давать выигрыш, обещанный теорией и статьями о data-oriented design:
|
вариант |
время поиска |
прочитано |
аллокаций |
|---|---|---|---|
|
AoS, 16 байт на запись |
90…96 нс |
640 байт |
6 |
|
SoA, три |
87…105 нс |
160 байт |
16 |
|
SoA в одном буфере |
55…60 нс |
160 байт |
1 |
Поиск ускорился примерно в 1,6 раза, а вместо шестнадцати аллокаций осталась одна. Это и есть зелёная линия на графике. Шаги 3 и 4 работают в связке: если внедрить только разделение массивов, можно потратить день на рефакторинг, не получить ускорения и вдобавок увеличить число аллокаций.
Блэкборд ИИ как компонент
Прежде чем продолжить, разберёмся, зачем вообще нужна структура с ключами, которые задаёт не программист. Лист персонажа — очевидный пример, с которого я начал изменения в игровом движке, но встречается он не так часто. Ускорение чтения здесь полезно, однако составляет лишь часть общего времени кадра.
Гораздо интереснее переделать блэкборд ИИ — небольшую таблицу текущих рабочих параметров персонажа, монстра или NPC. Это тот же набор «ключ → значение» для каждой сущности, где хранятся threat.last_seen_pos, threat.confidence, nav.stuck_timer, squad.role, combat.reload_pending и сотни других ключей. Их добавляют и удаляют в процессе разработки, не меняя C++. При этом каждый агент обращается к таблице сотни раз за кадр: дерево поведения или автомат состояний на каждом тике опрашивает блэкборд, чтобы решить, стрелять, бежать или оставаться на месте.
Здесь становится понятно, зачем в бенчмарке нужен перемешанный доступ. Двести агентов обрабатываются не по порядку адресов, а по важности, расстоянию до игрока или спискам планировщика задач. При наивном дереве один запрос к блэкборду занимает около 400 наносекунд. Двадцать обращений за тик для двухсот агентов — это уже примерно полторы миллисекунды на кадр, потраченные исключительно на переходы по указателям. Не на принятие решений и не на поиск пути, а на чтение чисел, которые уже находятся в памяти.
В предыдущих статьях о NavMesh и NPC я показывал, как двести солдат застревают у одних ворот и как лишняя тысяча запросов пути губит производительность кадра. Здесь история похожая, только причина в памяти: сам алгоритм работает нормально, а время теряется на доставке ему данных.
Шаг 5: отказываемся от STL
В Value по-прежнему хранятся указатели на типы STL:
std::string        *s;
std::vector<float> *array;
На этом этапе их преимущества исчерпаны: для объектов приходится выполнять отдельные аллокации. Кроме того, остаются две ступени косвенности: сначала указатель на std::vector, затем указатель на данные внутри него. Поэтому заменим эти типы собственными эквивалентами:
struct { char *data; } s;
struct { int capacity; int size; float *data; } array;
Все строки и массивы чисел помещаем в один большой буфер:
-------------------------------------------------------------
| "hello" | [0 1 3] | "mana" | [0 2] | ... свободно ....... |
-------------------------------------------------------------
Для него напишем простой аллокатор:
struct ValueBuffer { char *p; unsigned capacity; unsigned size; };

void *allocate_memory(ValueBuffer &vb, unsigned size)
{
    if (vb.size + size > vb.capacity)
        return nullptr;                 // вызывающий перевыделит буфер побольше
    auto res = vb.p + vb.size;
    vb.size += size;
    return res;
}
Это обычный bump-аллокатор: он выделяет память, но не освобождает отдельные блоки. Место в буфере рано или поздно закончится, однако с этим можно работать. Есть и другая особенность: значение может измениться в размере. Например, дизайнер заменил имя "The One" на "The One (deprecated, не удалять, спросить у Васи)". Новая строка не поместится на прежнем месте, поэтому придётся выделить пространство в конце буфера, оставив после старой строки пустоту:
-------------------------------------------------------------
| ....... | [0 1 3] | "mana" | [0 2] | "The One (depre..." |
-------------------------------------------------------------
Такие пустоты означают фрагментацию. Для универсального аллокатора это была бы серьёзная проблема, но в нашем случае она управляемая: элементов немного, а все ссылки на них находятся под нашим контролем. Мы можем переложить значения и дефрагментировать буфер. Более того, отдельная операция не обязательна: когда из-за фрагментации место закончится, буфер будет перевыделен, а при копировании пустоты исчезнут. Дефрагментация получится побочным эффектом роста.
Универсальный аллокатор так поступить не может, поскольку не знает, кто ссылается на выделенные им блоки. Мы же знаем структуру своих данных — и именно это даёт главный выигрыш. Специализированный аллокатор способен на большее не потому, что написан хитрее, а потому, что располагает сведениями о конкретной задаче.
Шаг 6: сжимаем Value
Все данные значений теперь находятся в одном буфере, поэтому вместо указателей можно использовать смещения от его начала. Указатель на x64 занимает 8 байт, обычное целочисленное смещение — 4, а для наших объёмов хватит и меньшего размера. Для коротких строк и массивов достаточно буфера до 64 КБ, так что смещение и размер вместе занимают 32 бита — по 16 бит на каждое поле:
struct Data {
    uint16_t offset;
    uint16_t size;
};

struct Value {
    union {
        bool  b;
        float f;
        Data  data;   // и для строк, и для массивов чисел
    };
};
Теперь Value занимает 4 байта вместо 8 в версии с указателями на STL-типы. Но важнее другое: в отличие от указателей, смещения не нужно исправлять при перемещении буфера. Его можно перенести, скопировать, сжать или записать на диск, а затем прочитать в другом процессе по другому адресу — внутренние ссылки останутся корректными.
sizeof: DataValue=16  Entry=16  Value=8  SlimValue=4
        std::map=16   std::string=32     std::vector=24
Шаг 7: объединяем последние два буфера
Осталось совсем немного. У нас есть два буфера: один для заголовков с ключами и типами, другой — для значений, строк и массивов. Хотелось бы объединить и их. Первый вариант — расположить области друг за другом:
--------------------------------------------------------
| Header      | Values     | ....... свободно ........ |
--------------------------------------------------------
Но в такой схеме заголовки не смогут расти без сдвига значений. Попробуем оставить каждой области запас:
----------------------------------------------------------
| Header      | ..свободно.. | Values     | ..свободно.. |
----------------------------------------------------------
Теперь обе области могут увеличиваться, но свободная память используется неэффективно: значения могут достичь своей границы, когда половина резерва заголовков ещё пуста. Поэтому применим аллокатор, который позволяет данным расти с двух концов буфера:
----------------------------------------------------------
| Header      | ....... свободно ........ |     Values   |
----------------------------------------------------------
Значения выделяются сверху вниз, навстречу заголовкам. Свободное пространство становится общим, а перевыделять буфер нужно лишь тогда, когда области встретятся. Идея напоминает рост стека навстречу куче, только применена локально к конкретной задаче.
Что получилось
naive      : allocs=14000 (14.0/ent) bytes=880000 (880.0/ent) live=880000
flat AoS   : allocs=6000  ( 6.0/ent) bytes=288000 (288.0/ent) live=128064
SoA        : allocs=16000 (16.0/ent) bytes=240000 (240.0/ent) live=110032
one buffer : allocs=1000  ( 1.0/ent) bytes=64000  ( 64.0/ent) live=64000
           : клонирование через memcpy = 0.5 ns/компонент
|
вариант |
аллокаций |
память |
последовательно |
перемешанно |
|---|---|---|---|---|
|
наивное дерево |
900 000 |
544 Б/сущность |
79…96 нс |
352…429 нс |
|
один буфер |
100 000 |
64 Б/сущность |
4.1…5.9 нс |
9.4…10.1 нс |
Расход памяти снизился с 544 до 64 байт, число аллокаций — с девяти до одной, а время перемешанного доступа — с 350–430 примерно до 9,5 наносекунды. Для характерного игрового сценария ускорение составило около сорока раз.
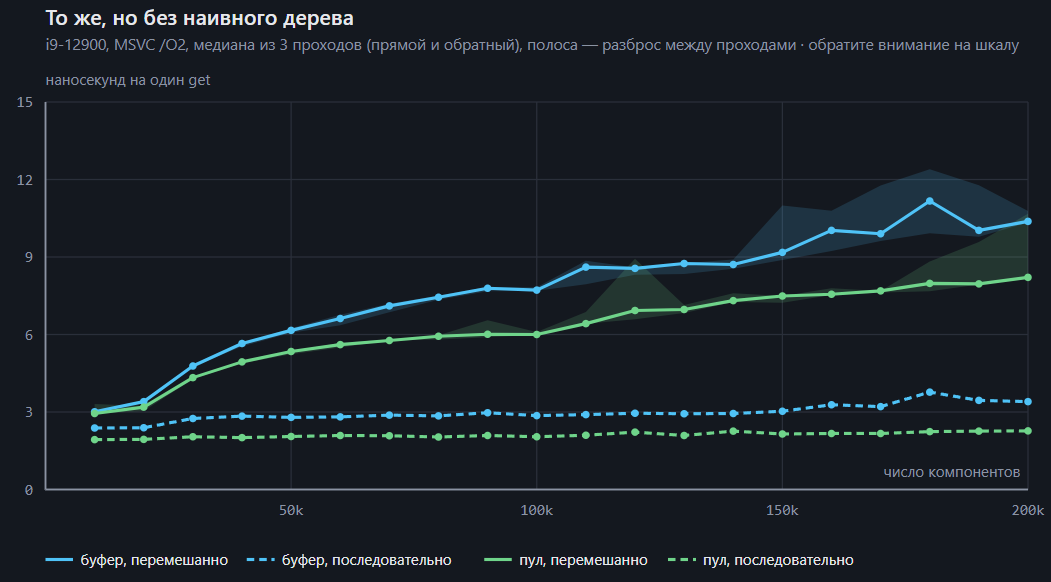
Пунктирные линии, соответствующие обходу в порядке размещения, держатся на уровне двух-трёх наносекунд и почти не растут при увеличении числа компонентов: процессор очень эффективно читает данные последовательно. Сплошные линии растут медленно и на двухстах тысячах компонентов достигают десяти наносекунд против шестисот у дерева.
Но интереснее графиков и таблиц побочные преимущества, обнаружившиеся после внедрения в игру. Компонент больше не содержит указателей и может свободно перемещаться, поэтому лист персонажа теперь дублируется обычным memcpy. Конкретного применения этому мы пока не нашли, но возможность любопытная.
Кроме того, сократилось время сохранения и загрузки: буфер можно записать на диск целиком, не вызывая Serialize(Archive&) для каждого поля.
Для мультиплеера решение тоже оказалось удобным. Снимок состояния объекта теперь представляет собой буфер, а снимок за предыдущий тик — ещё один. Хранение истории на двадцать тиков для компенсации задержки превращается в задачу выделения непрерывного участка памяти, а не построения отдельной архитектуры или базы данных. Поскольку все операции сводятся к присваиванию значения ключу, разницу между двумя снимками можно вычислить проходом по двум массивам ключей.
Разумеется, за удобство приходится платить. Арифметика по сырой памяти непривычна и выглядит пугающе; если отвлечься от неё на месяц, детали придётся вспоминать заново. Дизайнеру такую структуру тоже не покажешь без подготовки, поэтому нужны дополнительные инструменты и просмотрщики. Однако, привыкнув читать неразмеченную память, можно обнаружить, что она понятнее, чем std::map<std::string, std::vector<std::string>>, где не сразу ясно, сколько памяти занято и где именно она находится.
Как это устроено в крупных движках
Описанные приёмы не являются экзотикой самодельного движка: похожие идеи давно используются и в известных инструментах. В Unreal FName напоминает первый шаг: строка находится в общей таблице, а в структурах хранится её индекс, поэтому сравнение имён сводится к сравнению чисел. FInstancedStruct хранит произвольную структуру по значению вместе с указателем на её UScriptStruct, без отдельного объекта-обёртки для каждого экземпляра. FArchive с оператором << позволяет вручную сериализовать каждое поле; такая универсальная сериализация нужна, когда данные содержат указатели и их нельзя просто скопировать через memcpy.
В Unity DOTS тоже применяются сходные подходы. IComponentData должен быть неуправляемой структурой и размещается в чанке фиксированного размера вместе с множеством аналогичных компонентов — это напоминает шаги 2–4, закреплённые требованиями системы. DynamicBuffer<T> представляет массив переменной длины, который, пока он невелик, хранится в том же чанке. А BlobAssetReference использует относительные смещения вместо указателей по той же причине, что и наше решение: блоб можно загрузить с диска как есть и использовать по любому адресу.
Главная задача осталась прежней
Двадцать лет назад программисты на PS2 вручную раскладывали данные в четырёх килобайтах скретчпада, чтобы процессор успевал получать их через DMA. Сегодня у нас могут быть 64 гигабайта памяти и готовый аллокатор, но задача по сути та же: расположить данные так, чтобы процессор читал их последовательно и как можно реже обращался к оперативной памяти. Изменились масштаб и требования ко времени кадра. Теперь нужно уложиться в 16 мс — ограничение, о котором легко забыть, пока частота не упадёт до десяти кадров в секунду.
Похожие статьи
 Microsoft тестирует новый шейдерный компилятор для Xbox Series X|S, способный повысить производительность до 16%
 Читеры начали использовать ИИ: разработчики Call of Duty предупредили об опасной тенденции
 Хоррор-ферма Village in the Shade помогла Nippon Ichi Software избежать убытков
 Косплеер представила образ Матери Миранды из Resident Evil Village — вечной пленницы собственной скорби
 GTA VI получила ещё один патч размером почти 1 ГБ за три дня до релиза
 Игроки не могут отличить геймплей GTA VI от реальных кадров, а Дженсена Хуанга выгнали из собственной компании — самое интересное за неделю
 На Android вышел фанатский порт God of War Collection — теперь на платформе доступна вся оригинальная трилогия
 Самые интересные материалы недели: как изменилась Deadlock за два года и обзор стильного FMV-хоррора Tenebris Somnia