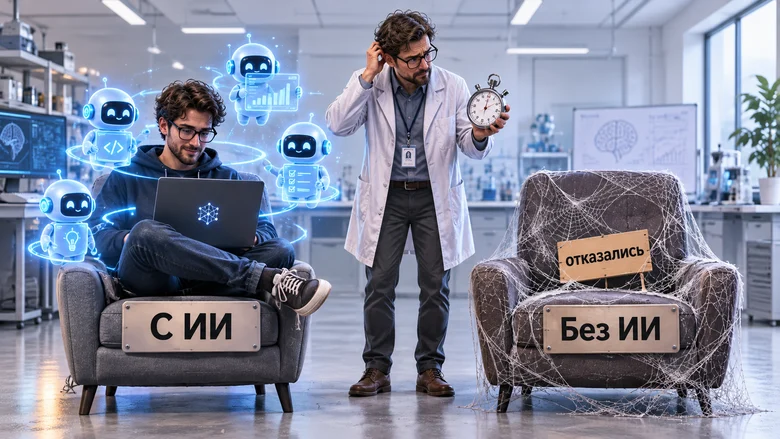
Проверить, ускоряет ли ИИ работу разработчиков, уже невозможно: без него они работать не соглашаются
Год назад стоило спросить коллег в курилке, сколько времени им экономит нейросеть, и ответы разлетались от «процентов двадцать» до «как минимум половину». Причем чем дальше собеседник находился от продакшена, тем щедрее оказывалась оценка. Менеджеры и вовсе называли космические цифры.
Летом 2025 года METR решил проверить эту экономию с секундомером в руках и получил отрицательный результат. Интернет несколько недель бурлил, все пообещали при случае разобраться, а затем вернулись к своим агентам, которые к тому времени как раз научились самостоятельно запускать тесты.
В августе METR начал повторное исследование — с более свежими моделями и увеличенной выборкой. А в феврале 2026 года выяснилось, что эксперимент столкнулся с проблемой, едва ли предусмотренной в учебниках: приглашенные разработчики начали отказываться от той его части, где код требовалось писать вручную.
Если провести медицинскую аналогию, это похоже на испытание препарата, участники которого охотно вступают в основную группу, но вежливо отправляются домой, получив плацебо. Как ни странно, именно этот отказ стал главным итогом исследования: о состоянии профессии он говорит больше, чем любой процент ускорения.
Минус девятнадцать
Первый этап проходил с февраля по июнь 2025 года и был организован достаточно тщательно. Шестнадцать опытных разработчиков, годами вносивших вклад в крупные open-source-проекты, предложили 246 реальных задач из своих бэклогов: исправление ошибок, новые функции и рефакторинг. Репозитории были вполне серьезными: в среднем более 22 тысяч звезд и свыше миллиона строк кода.
Для каждой задачи случайным образом определяли, разрешено ли использовать ИИ. Участникам платили по $150 в час. В основном они работали в Cursor Pro с Claude 3.5 и 3.7 Sonnet; выполнение задачи занимало в среднем около двух часов. Экран записывали на видео, а затраченное время разработчики фиксировали самостоятельно.
До начала эксперимента участники ожидали ускорения примерно на 24%, а после завершения оценили его в 20%. Замеры показали противоположное: с ИИ на задачи ушло на 19% больше времени. Именно этот разрыв между ощущениями и измерением — почти сорок процентных пунктов — и запомнился всем.
Механизм знаком каждому, кто видел, как агент за минуту уверенно выдает триста строк. Эта минута остается в памяти, а сорок минут, потраченных на проверку и исправления, будто растворяются. В итоге можно искренне считать, что сэкономил полчаса, хотя на деле потратил лишний час.
METR рассмотрел двадцать возможных причин замедления и выделил пять вероятных, не назначив ни одну из них главной. Самое очевидное объяснение лежит на поверхности: разработчик, который годами работает с одним репозиторием, зачастую и сам знает, где искать ошибку. Помощнику же приходится заново объяснять контекст — как стажеру в первую неделю, только стажер хотя бы способен запоминать.
Авторы честно оговорили, что результат отражает возможности инструментов на начало 2025 года, и пообещали продолжить измерения тем же методом: модели обновляются быстрее, чем выходят статьи о них.
Контрольная группа разбежалась
Повторное исследование началось в августе 2025 года и на бумаге выглядело масштабнее: 57 разработчиков с медианным стажем около десяти лет, включая десятерых участников первого этапа и сорок семь новых, 143 репозитория и более восьмисот задач.
Правда, оплату снизили со $150 до $50 в час. Позже METR сам указал это среди возможных причин смещения выборки, хотя и не счел основной.
Принцип остался прежним: участник заранее описывает задачу, после чего жеребьевка определяет, можно ли использовать ИИ. Именно здесь возникли сложности. Приглашенные разработчики стали значительно чаще отказываться от участия вовсе, и объяснение повторялось одно: работать без ИИ они больше не хотят.
Точную долю отказавшихся METR не приводит, отмечая лишь, что привлекать и удерживать участников стало заметно труднее. Для организации, которая занимается точными измерениями, это довольно выразительная формулировка в официальном отчете.
Оставшиеся нашли более мягкий способ обойти ограничение: они просто не предлагали для жеребьевки задачи, которые не хотели выполнять вручную. По собственным опросам METR, так поступали от 30 до 50% разработчиков. При этом за пределами эксперимента чаще всего оказывались именно те задачи, на которых ИИ мог дать наибольший выигрыш.
Один участник не завершил ни одной задачи из группы «без ИИ». Пожалуй, это самый честный ответ исследователям, который можно было дать без заполнения анкеты.
В итоге в контрольной группе остались люди и задачи, которым ИИ был нужен меньше всего. Сравнивать их с основной группой — все равно что оценивать пользу навигатора по поездкам, на которые таксист согласен отправиться без него: по собственному двору да до ближайшей «Пятерочки».
Цифры с длинными усами
Несмотря на ограничения, в феврале 2026 года METR опубликовал результаты. На первый взгляд они похожи на реванш: для участников первого этапа оценка изменилась на ускорение примерно на 18%, для новых — примерно на 4%.
Однако доверительные интервалы допускают почти любую интерпретацию. У опытных участников диапазон простирается от ускорения на 38% до замедления на 9%, у новых — от ускорения на 15% до того же замедления на 9%. Сами авторы называют это очень слабым свидетельством реального ускорения.
При этом METR считает, что настоящий эффект, скорее всего, выше, а опубликованная оценка представляет собой нижнюю границу: задачи с наибольшим потенциальным выигрышем попросту не попали на жеребьевку. Получился редкий случай, когда исследователи приводят число и тут же объясняют, почему не стоит опираться на него в расчетах.
Подвел и сам способ измерения времени: за прошедшие месяцы изменился характер работы. Пока в соседних окнах tmux трудятся два-три агента, разработчик переключается на собственную задачу, порой вообще не связанную с экспериментом. А вечером добросовестно указывает в отчете время, которое уже трудно однозначно к чему-либо отнести.
METR прямо признает, что самоотчеты таких участников о времени перестали быть надежными, хотя на фоне процентов эту деталь легко упустить. Кроме того, качество результатов в группах иногда различалось, в том числе по тестам и документации. Поэтому одинаковое время выполнения еще не означает, что была проделана одинаковая работа.
Анкета вместо секундомера
Когда прямое измерение дает сбой, обычно обращаются к опросам. И там картина до боли знакомая. В исследовании Stack Overflow за 2025 год собрали более 49 тысяч ответов: 84% опрошенных уже используют ИИ-инструменты или планируют начать. При этом точности их ответов доверяет примерно треть, а открыто не доверяют 46% — годом ранее таких было 31%.
Главная претензия, которую отметили 66% участников, — решения «почти правильные, но не совсем». Еще 45% пожаловались, что отладка сгенерированного кода отнимает больше времени. Ситуация знакомая: получаешь сто строк, девяносто восемь выглядят как надо, а две оставшиеся приходится искать полчаса, потому что внешне они ничем не отличаются и ломаются только на третьем тестовом случае.
Эти полчаса обычно не отражаются в анкете: в памяти остается момент, когда сто строк появились за десять секунд. Именно его человек и вспоминает, отвечая на вопрос о продуктивности.
Картина получается противоречивой: пользуются почти все, доверяет меньшинство, отказаться готовы единицы, а единственный инструмент проверки дал сбой как раз потому, что никто не хочет отказываться. Доверять одним анкетам в такой ситуации трудно. Это показал и первый эксперимент METR, где опытные разработчики ошиблись в оценке собственной скорости почти на сорок пунктов — причем в выгодную для себя сторону.
Счет от провайдера
Компании тем временем не стали дожидаться исследований и принялись измерять эффект тем, что есть под рукой у бухгалтерии: деньгами и токенами. Пока истории получаются скорее анекдотическими.
Технический директор Uber Правин Неппалли Нага рассказал The Information, что годовой бюджет компании на ИИ-инструменты для разработки на 2026 год был израсходован за четыре месяца, главным образом на Claude Code. До этого внутри Uber существовал рейтинг команд по использованию ИИ, так что результат едва ли удивителен.
Позже операционный директор Эндрю Макдональд признал в подкасте Rapid Response, что пока не удается установить связь между растущим расходом токенов и появлением полезных для пользователей функций. В июне Uber ввел лимит в $1500 в месяц на сотрудника.
В Amazon, по данным Financial Times, сотрудники создали неофициальный рейтинг Kirorank, отражавший активность на внутренней платформе Kiro. Его закрыли, когда выяснилось, что ради места в таблице люди поручают агентам бессмысленные задачи. Старший вице-президент Дейв Тредвелл попросил коллег не использовать ИИ ради самого ИИ. Теперь, как сообщается, Amazon следит за «нормализованными деплоями» — кодом, который действительно попал в продакшен.
Закон Гудхарта сформулировали для экономики, но в разработке он, кажется, действует еще нагляднее: любую поощряемую метрику здесь за пару недель научатся накручивать скриптом, а теперь еще и агентом, который сам этот скрипт напишет.
Смеяться легко, но других надежных приборов у финансиста все равно немного. Время на задачу без контрольной группы мало что объясняет, закрытые тикеты давно научились рисовать, а строки кода обесценились еще до появления нейросетей. Зато в ежемесячном счете провайдера есть вполне честная цифра, которая растет при любом раскладе.
За разработку по-прежнему платят, просто часть расходов переместилась из фонда оплаты труда в счет за облачные сервисы. А что именно компания получила за эту разницу, пока толком сказать никто не может.
Есть попытки оценить и обратную сторону. Например, CodeRabbit изучил 470 open-source-пулреквестов и обнаружил в работах, созданных при участии ИИ, в среднем 10,83 проблемы против 6,45 в полностью человеческих — примерно в 1,7 раза больше. Правда, сама CodeRabbit продает инструмент для ревью кода с помощью нейросетей, поэтому к этой цифре стоит относиться примерно как к отзыву о ресторане от владельца заведения напротив.
Где скепсис дает трещину
Самый соблазнительный вывод из этой истории таков: программисты подсели на игрушку, которая замедляет их работу. Для твита формулировка идеальная, но с фактами согласуется хуже. Сам отказ работать без инструмента — тоже данные, причем весьма весомые.
Отказываются опытные специалисты: медианный стаж участников нового этапа составляет около десяти лет. Они пережили не одну волну модных фреймворков и «революционных» IDE и без особых сожалений расставались с тем, что мешало делу. Когда такой разработчик говорит, что не станет писать код вручную за $50 в час, он фактически дает исследователям именно ту оценку, ради которой затевался эксперимент, — просто ее не уложить в таблицу с доверительными интервалами.
Честно говоря, я и сам, скорее всего, вежливо отказался бы от подобного предложения. И вряд ли смог бы объяснить это чем-то, кроме того, что вручную долго и скучно, а пальцы уже отвыкли набирать шаблонный код.
К тому же первый этап измерял работу Cursor с моделями начала 2025 года на задачах, в которых сами разработчики прекрасно ориентировались. С тех пор агенты научились запускать тесты, читать за раз половину репозитория и справляться с длительными задачами почти без присмотра. Оценивать их прежним способом — все равно что судить об экскаваторе по числу взмахов лопатой. Похоже, в METR это понимают лучше многих: иначе вряд ли назвали бы свежие оценки нижней границей.
При этом зависимость от инструмента никуда не исчезает, и цена у нее вполне конкретная. Сервис может однажды подорожать втрое, выйти из строя на полдня или стать недоступным в вашем регионе — привет тем, кто добирается до нейросетей через три VPN. И тогда команда, два года почти не писавшая код вручную, быстро обнаружит, что часть ее скорости была взята в аренду. А условия этой аренды поставщик может изменить в любой момент.
Редкий вид для контрольной группы
METR не отказался от самой идеи измерений и намерен подойти к ней сразу с нескольких сторон. В планах — короткие эксперименты с более высокой оплатой, заранее подготовленные задачи вместо выбранных участниками, наблюдение за реальным использованием инструментов по статистике и транскриптам, а также опросы, о смещении которых авторы предупреждают сами.
Еще один вариант — распределять случайным образом не задачи, а участников: одни будут работать с ИИ на протяжении всего эксперимента, другие — без него. Авторы признают, что такая схема устраняет перекос по задачам ценой возможного перекоса по людям, а ее статистическая мощность ниже.
Здесь особенно ясно видно, в какой точке мы оказались. Для подобного исследования придется найти опытных разработчиков, готовых выполнить целую серию задач без ИИ. С каждым кварталом их становится меньше, а сравнение с ними в итоге может рассказать скорее о различиях между двумя типами людей, чем о самом инструменте.
Поэтому индустрии еще долго придется отвечать на вопрос о влиянии ИИ косвенно: через бюджеты, сроки релизов и число ночных инцидентов в продакшене. Все эти показатели будут описывать уже сделанный выбор. Программисты проголосовали раньше, чем исследователи успели подсчитать бюллетени, и теперь пересчитывать их придется по счетам за токены.
З.Ы. Если захотите поучаствовать в следующем этапе, имейте в виду: за год почасовая ставка за ручное программирование в экспериментах METR снизилась втрое. Скорее всего, дело просто в бюджете исследователей, но совпадение с тем, как рынок сейчас оценивает написание кода вручную, получилось красноречивым.
Похожие статьи
 ESP32 для новичков: от логических микросхем до умных устройств
 Создатели правил игры: семь экономистов, изменивших мир
 ИИ воскрешает мёртвых: благо это или зло?
 Мои ИИ-агенты нашли неизвестное поселение майя
 Возможно, мы искали источник сознания не в той области мозга
 Объединяются ли на самом деле все три квантовых взаимодействия в единое?
 Учёные выяснили: кошки мяукают, требуя от хозяев порядка в своём мире
 Как стреляли по телевизорам: история светового пистолета