Прорывы в робототехническом ИИ не повлияют на вашу жизнь в ближайшей перспективе
Успехи искусственного интеллекта рисуют заманчивую перспективу: роботы, способные действовать в реальном мире так же свободно, как люди. Остаётся выяснить, хватит ли для этого тех же методов, что обеспечили недавний рывок в ИИ, или придётся искать принципиально иной путь
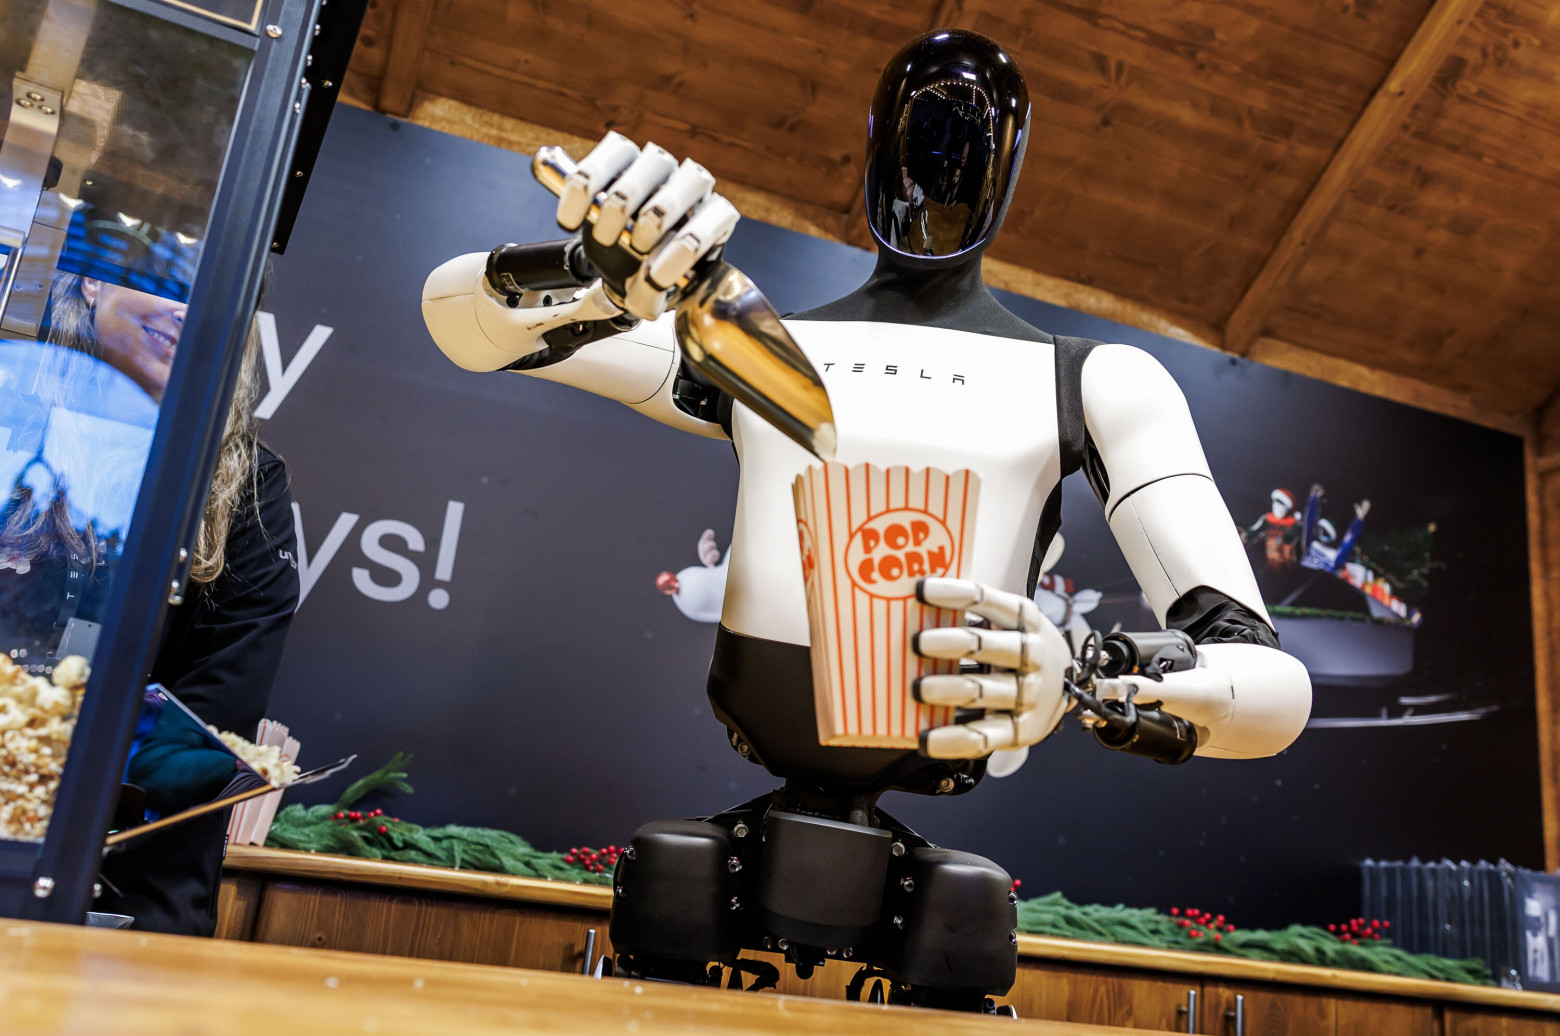
В сети регулярно мелькают ролики с человекоподобным роботом белого цвета, у которого чёрные голова и торс. Вы наверняка видели, как он танцует, раздаёт попкорн, отправляет мусор в урну, водит пылесосом или нажимает кнопку на микроволновке. А возможно, вам попадались кадры, где он валится на спину, пытаясь раздать бутылки с водой, или с трудом пробует выгладить рубашку.
Это Optimus от Tesla — гуманоидный робот с искусственным интеллектом. Глава компании Илон Маск уверен, что он станет «не просто самым успешным продуктом Tesla за всю её историю, но, вероятно, самым успешным продуктом вообще». По замыслу, сперва робот поселится на заводах, а потом придёт и в наши дома. В июле Маск пообещал акционерам, что со временем Optimus «обретёт человеческую, а затем и сверхчеловеческую ловкость». По его словам, такие машины смогут взять на себя почти любую человеческую работу, от перемещения листового металла до складывания белья, а стоить каждая будет всего 20 тысяч долларов. В январе на ежегодном форуме в швейцарском Давосе Маск предположил, что уже к концу 2027 года роботы могут появиться в свободной продаже.
Маск далеко не одинок в своём воодушевлении. Марк Андриссен, сооснователь и партнёр кремниевой венчурной компании Andreessen Horowitz, считает, что робототехника способна превратиться в «крупнейшую отрасль в истории планеты». В январе глава Nvidia Дженсен Хуанг заявил, что уже в нынешнем году гуманоиды сравняются с людьми по своим возможностям. А аналитики Morgan Stanley в своём прогнозе допускают, что к 2050 году число роботов, которые «выглядят и действуют как люди», подберётся к миллиарду, а объём рынка превысит пять триллионов долларов.
За подобными заявлениями во многом стоит убеждение, что технологии, породившие ChatGPT от OpenAI и Claude от Anthropic, помогут создать новое поколение роботов, которые будут копировать человеческие движения так же, как чат-боты копируют человеческую речь. Однако многие специалисты по робототехнике настроены скептически. Они считают, что сложность задачи занижена: ИИ, выросший на текстах и картинках, должен освоить бесконечное многообразие физической реальности. «Ни одна из этих компаний [создающих гуманоидов], ни одна, не представляет, как сделать роботов достаточно умными, чтобы от них был прок», — заявил на другой сессии январского форума в Давосе Ян Лекун, которого нередко называют одним из «крёстных отцов» искусственного интеллекта.
Эксперты также подчёркивают, что привычно отождествлять человекоподобных роботов, сконструированных по образу людей, с универсальными машинами, способными учиться и выполнять самые разные задания, — значит вводить публику в заблуждение. «Построить робота, который внешне напоминает человека, совсем несложно, — говорит Джонатан Хёрст, сооснователь и директор по робототехнике Agility Robotics, а также профессор робототехники Университета штата Орегон. — Куда труднее создать машину, которая так же, как человек, динамично двигается и действует в физическом мире».
Споры о том, увидим ли мы универсальных гуманоидов в обозримом будущем или до них ещё невообразимо далеко, и хватит ли для их развития нынешних форм ИИ, сегодня кипят в робототехнических лабораториях по всей стране. Шумиха вокруг сроков появления таких машин затмевает неспешный, но вполне реальный прогресс.
Около десяти лет назад череда прорывов запустила революцию генеративного ИИ и превратила давнюю мечту об искусственном интеллекте в действительность. Робототехники убеждены, что столь же масштабный переворот возможен и в их сфере. Он подарит машинам интуитивное понимание физического мира и плавность движений, которые так долго оставались недостижимыми. Расходятся специалисты лишь во мнениях о сроках. Пока робототехника продвигается шаг за шагом, главный вопрос остаётся прежним: достаточно ли методов и инструментов, обеспечивших успех ИИ, или нужен совершенно другой путь?
Роботы встречаются с передовым ИИ
Чтобы увидеть один из самых интеллектуальных роботизированных комплексов наших дней, стоит посмотреть, на что способна Google DeepMind с устройством ALOHA 2. Название расшифровывается как «Недорогая аппаратная система с открытым исходным кодом для дистанционного управления двумя руками» (A Low‑cost Open‑source Hardware System for Bimanual Teleoperation).
Среди робототехников давно идёт дискуссия о том, нужно ли универсальному роботу человеческое тело. Приверженцы этой идеи считают, что гуманоидная форма позволит машинам органично вписаться в мир, уже устроенный под людей, а их оппоненты полагают, что игра не стоит свеч. Создатели ALOHA 2 на стороне вторых. Внешне система выглядит скромно: пара механических рук, несколько захватов и две камеры. Но за этой простотой скрывается настоящая рабочая лошадка исследователей Google DeepMind: в своих лабораториях они испытывают на ней Gemini Robotics — самую совершенную систему ИИ для робототехники.
Под управлением Gemini Robotics ALOHA 2 становится куда более универсальным роботом: она справляется с множеством разных задач, опираясь на примеры, на которых её обучали. Если попросить её собрать ланч-бокс, то, как показывает видеозапись эксперимента, двумя клещевыми захватами робот аккуратно уложит ломтик белого хлеба в пакет Ziploc, закроет его, поместит гроздь винограда в контейнер Tupperware, плотно прижмёт крышку, бережно переложит всё в ланч-бокс и застегнёт молнию.
Обед, честно говоря, ничем не примечательный. Но сам факт, что робот способен его собрать, — ощутимый шаг вперёд по сравнению с тем, что было возможно ещё три года назад.
В основном этот прогресс обязан искусственному интеллекту и его влиянию на так называемые политики управления роботами (robot policies). Именно они определяют, как универсальный робот оценивает и осмысляет обстановку, планирует в ней свои движения и затем верно выполняет поставленную задачу.
ALOHA 2 — это, по сути, две механические руки на лабораторном столе, однако они служат испытательным стендом для передовых робототехнических моделей ИИ. Эти анимации построены на данных, записанных, когда человек дистанционно управлял роботизированными руками. Именно такие данные идут на обучение моделей Google DeepMind. Видео: Google DeepMind / Stanford University / Hoku Labs.
Раньше политики управления опирались на правила, которые инженеры разрабатывали и вручную вписывали в программное обеспечение робота. Тысячи строк кода регламентировали каждый миллиметр движений при выполнении сотен разнообразных задач. Однако последние несколько лет принесли важную перемену, которая во многом и объясняет оптимизм по поводу универсальных роботов: разработчики перестали прописывать политики управления в коде и доверили их передовым системам ИИ.
Первым шагом стали VLM — визуально-языковые модели. Они родственны большим языковым моделям, но обучаются не только на текстах, но и на изображениях. Покажите такой модели снимок пролитого кофе и спросите, чем можно устранить беспорядок, — и она поймёт, что подойдёт лежащая рядом тряпка. Такого мгновенного понимания контекста ещё пару лет назад, когда политики управления роботами жёстко задавались кодом, просто не существовало.
Следующим этапом стали визуально-языковые модели действий — VLA (vision‑language‑action models). Они позволяют роботам не только оценивать окружающую обстановку, но и действовать в ней. Для этого к модели добавляется ещё один компонент — команды движения. VLA обучаются на последовательностях изображений или видеозаписях выполнения конкретных задач, а также на сопутствующих данных о том, как при этом должна двигаться роботизированная рука. Обычно такие данные собирают с помощью дистанционного управления: человек при помощи контроллеров проводит робота через нужные действия.
Благодаря такому обучению ИИ постигает, как управлять движениями робота при выполнении той или иной задачи. Поставьте робота с VLA перед письменным столом и скажите «закрой ноутбук» или «смотай провод наушников». Он оглядится, найдёт нужный предмет, спланирует действия и приведёт в движение механические руки. По крайней мере, если ему уже доводилось видеть, как выполняется подобная задача.
Gemini Robotics — именно такая VLA-модель: её обучали на многочасовых демонстрациях, где люди выполняли огромное число разных действий. Поэтому она справляется с довольно непростыми заданиями: подхватывает стручки сахарного гороха кухонными щипцами, складывает оригами или собирает несложный обед. Это впечатляет, но есть серьёзное ограничение: если сейчас поручить роботу с VLA задачу, которой не было в обучающем наборе, он, скорее всего, потерпит неудачу.
«Если представить всё пространство возможных задач, по-настоящему универсальная политика управления должна уметь делать всё, что в нём находится, — говорит Эдвард Джонс, профессор робототехники Имперского колледжа Лондона. — Но сегодня Gemini Robotics способна лишь на „кое-что здесь и кое-что там“».
В погоне за настоящей универсальностью
Как научить роботов выполнять больше разных задач? Самый распространённый ответ вряд ли кого-то удивит: надо обучать их на большем объёме данных.
Логика проста: больше данных — больше примеров, больше примеров — шире универсальность. Google DeepMind, к примеру, стремится собрать «как можно больше данных», рассказывает Паннаг Санкети, ранее возглавлявший робототехническое направление компании, а теперь занимающийся собственным проектом в сфере робототехнического ИИ. Но откуда их взять? У больших языковых моделей было преимущество: целые океаны готовых текстов для обучения. Сопоставимого массива качественных демонстраций физических действий для обучения роботов не существует.
Восполнить этот пробел можно несколькими способами, и у каждого есть изъяны. Первый — нанять множество людей, которые будут создавать и собирать данные, дистанционно управляя роботами. Это дорого и долго. Второй — обучать VLA на видеозаписях, где люди выполняют различные действия. Но качество таких данных невысоко. Третий — выпустить роботов в реальный мир и использовать собранные ими данные для дальнейшего улучшения моделей ИИ. Беда в том, что за стенами лабораторий роботы пока недостаточно безопасны и надёжны. По мнению Санкети, наиболее вероятный путь вперёд — «многосторонний» подход, объединяющий данные из всех этих источников.
Однако убеждённость в том, что для решения проблемы хватит одних лишь обучающих данных, разделяют далеко не все. Хёрст из Agility называет её «фундаментально ошибочной предпосылкой».
Дело в том, что сложность реальных задач стремительно нарастает. Допустим, вы хотите сварить кофе. Переменных тут великое множество: двух абсолютно одинаковых кухонь не бывает; кофемашины устроены по-разному; для разных чашек нужен разный хват; с молотым кофе, горячей водой и молоком обращаться приходится совершенно по-разному. Даже такая простая задача требует понимания постоянно меняющегося набора возможностей. По мнению Хёрста, чтобы добиться универсальности с помощью VLA, потребуется «полное покрытие данными всего, что [робот] вообще когда-либо может делать». Иначе говоря, практически бесконечный массив обучающих данных.
Лекун и вовсе отвергает этот подход целиком. «Методы [ИИ], преуспевшие в работе с языком, не годятся для многомерных, непрерывных, зашумлённых данных», — заявил он в Давосе, имея в виду именно те данные, что повсеместно встречаются в робототехнике. «Нужно искать что-то другое».
Главный кандидат на роль этого «другого» — так называемая модель мира (world model). Это разновидность искусственного интеллекта, которая учится не столько на текстах, сколько на сочетании видео, трёхмерных сканов и показаний датчиков, и предназначена для прогнозирования последствий действий в реальном мире. Цель — создать модели с настолько точным внутренним представлением о реальности, чтобы они могли воспроизводить закономерности физического мира: как предметы движутся, сталкиваются, падают и деформируются. Если бы робототехники смогли обучать машины в симуляциях, достаточно точно передающих физику реального мира, разработка стала бы быстрее, дешевле и безопаснее, а потребность в испытаниях в реальных условиях сократилась бы. Но ещё более радикальным шагом стало бы то, что роботы с моделями мира смогли бы рассуждать об окружающей обстановке, а не просто реагировать на неё. Это позволило бы им предугадывать последствия своих действий ещё до того, как они будут совершены.
Новейшие модели ИИ Google DeepMind для роботов демонстрируют всё большую ловкость, хотя движения машин по-прежнему довольно медленны и непредсказуемы.
Над этой технологией трудятся такие компании, как Nvidia и Google, а инвесторы щедро вкладываются в многообещающие стартапы. World Labs, одним из основателей которой стала исследовательница ИИ из Стэнфордского университета Фей-Фей Ли, в феврале привлекла миллиард долларов, а в конце сентября была куплена компанией AMD за 8,2 миллиарда долларов. AMI Labs, сооснователем которой стал Лекун, ранее занимавший пост главного научного сотрудника Meta по ИИ, в марте тоже привлекла миллиард долларов. Впрочем, сами разработчики признают, что эта область находится лишь в самом начале пути. В конце прошлого года Ли назвала её «зарождающейся», добавив, что «фундаментальные подходы ещё только формируются». В июньской публикации на Substack она описала серьёзные трудности, с которыми сталкиваются исследователи. Пока модели мира — это перспективное направление исследований, а не готовая дорога к универсальным роботам. И всё же первые намёки на то, чего с их помощью можно добиться, уже появляются.
Один из таких намёков дал небольшой, но потенциально значимый прорыв, случившийся в апреле в одной из робототехнических лабораторий Сан-Франциско.
Прорыв?
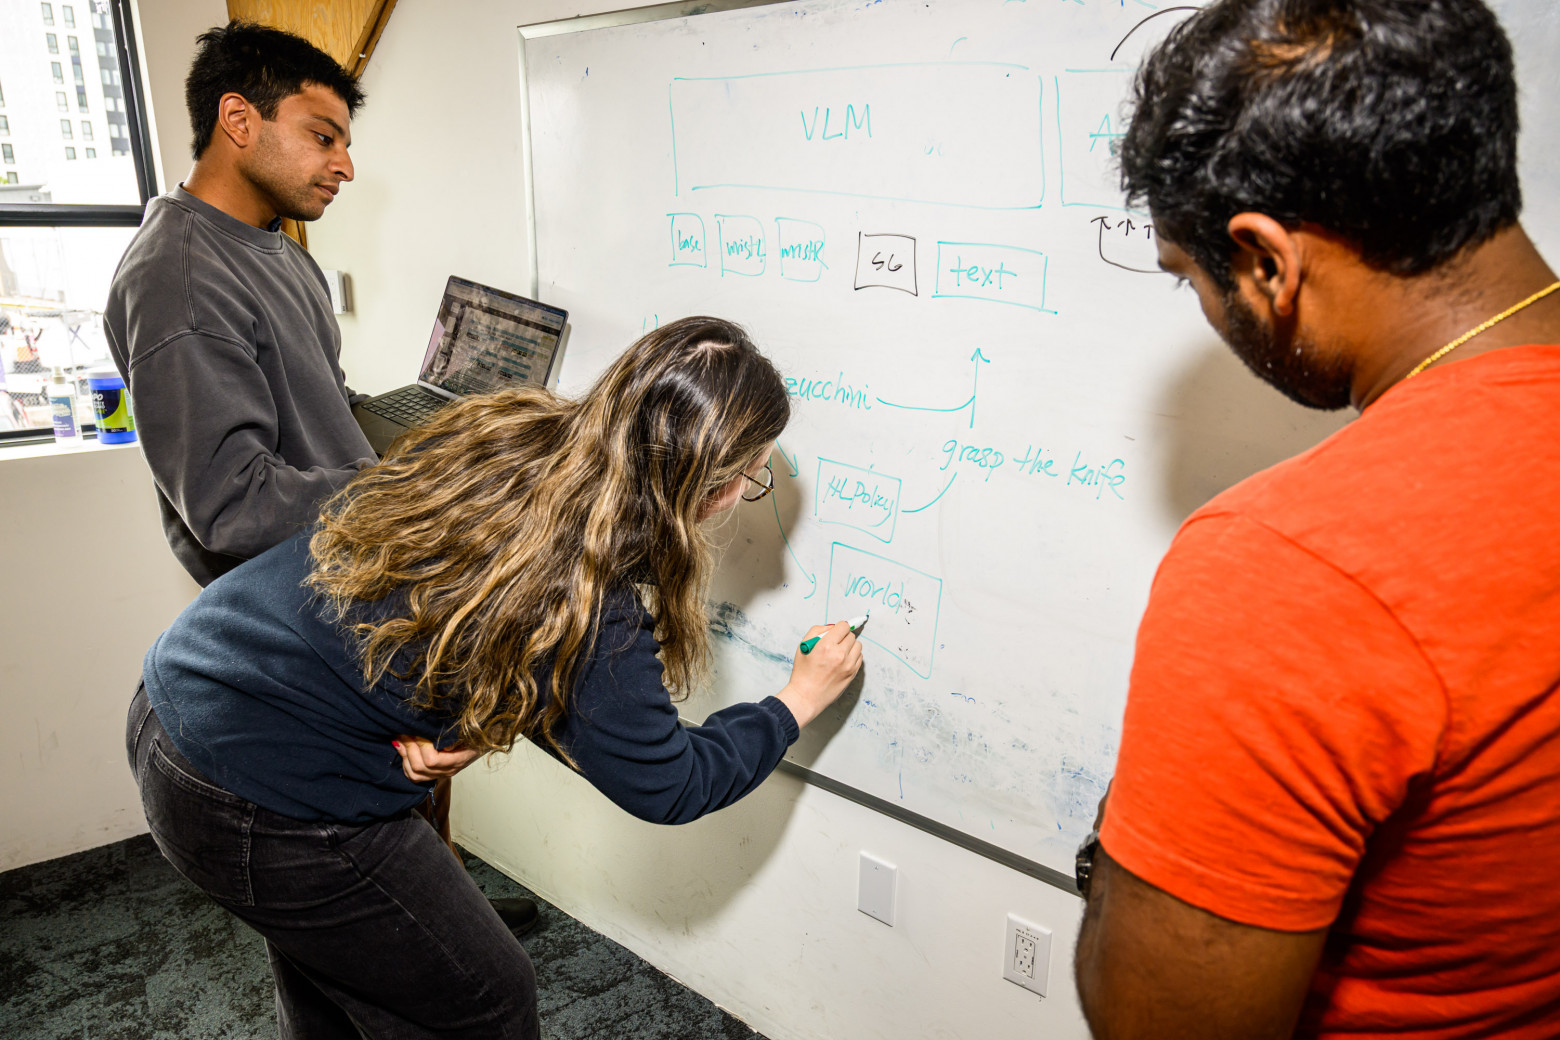
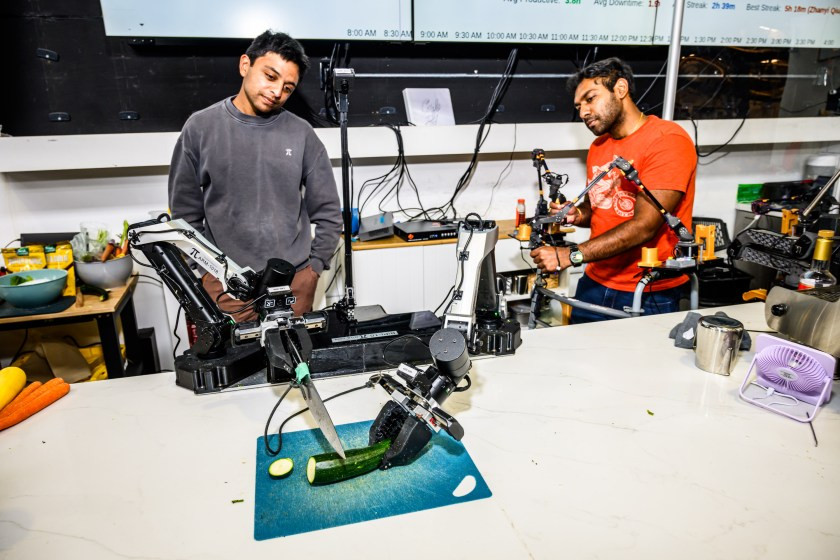
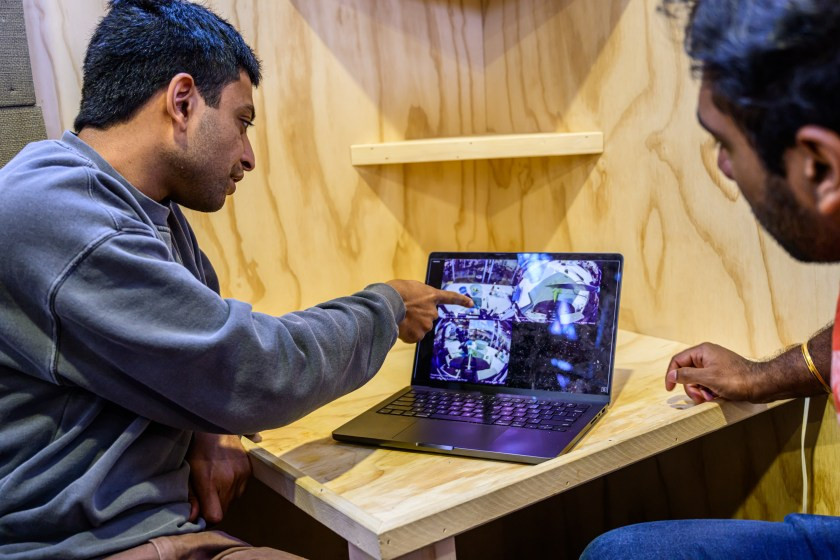
В самом сердце района Мишен в Сан-Франциско стартап Physical Intelligence, или PI (как число π — так компанию называют её сотрудники), работает над универсальным «мозгом», который в теории мог бы превратить любого робота в многофункциональную машину. При обучении робототехнических моделей ИИ компания использует принцип «в ход идёт всё, что есть под рукой», и недавно получила подсказку о том, на что способен роботизированный мозг, оснащённый моделью мира.
В 2024 году PI опубликовала подробности о своей первой универсальной робототехнической системе под названием π0. Это была VLA-модель, которую компания назвала «самой способной и ловкой универсальной политикой управления роботами на сегодняшний день». Сначала её обучали на собственном наборе данных, включавшем 10 тысяч часов демонстраций, выполненных людьми с помощью дистанционно управляемых роботов, а также на нескольких открытых робототехнических датасетах. Версия π0.5, вышедшая весной 2025 года, обучалась на более разнородных данных, включая размеченные изображения из интернета, и благодаря этому стала более универсальной. В осеннем обновлении 2025 года π0.6 в модель добавили обучение с подкреплением.
Каждое обновление заметно улучшало работу модели и расширяло её возможности: от неторопливого складывания белья до раскладывания вещей по местам в незнакомой обстановке и более уверенного выполнения таких задач, как сборка коробок. А в апреле 2026 года вышла π0.7, которая, судя по всему, подняла PI на совершенно новый уровень. В этой версии применяется менее мощная модель мира, генерирующая изображения промежуточных этапов, необходимых для выполнения задачи. Пока робот работает, эта «облегчённая» модель подсказывает ему, что делать дальше, передавая картинки следующих шагов.
 Источник
Похожие статьи
 Отладка детского мышления: как преодолеть когнитивные барьеры на уроках математики
 Что происходит с квартирами и ипотекой: подробный разбор
 Квантовые котики Шрёдингера: как я выращивал их на процессорах IBM
 Краткий справочник по великой науке кибернетике
 Как возник современный календарь? Часть 2: десятилетняя работа над реформой папы Григория XIII
 Мир под тёмным светилом: разбираем хоррор. Часть 1
 Запуск миссии JAXA за образцами с Фобоса — а заодно и с Марса
 Вероятностное мышление: почему одних частот недостаточно — интервью с Брендет Фителсон