
Прокачка Telegram-бота на локальной LLM: от простых чатов до мини-игр, генерации фото и выбора нейросетей
Хочу представить вашему вниманию кейс по разработке Telegram-бота, функционирующего на базе исключительно локальных нейросетей. В качестве текстового ядра задействована платформа Ollama, а за визуальный контент отвечает AUTOMATIC1111. Весь программный комплекс реализован на Python с использованием библиотеки python-telegram-bot.
Выбор в пользу Ollama был обусловлен её открытостью, бесплатным доступом к широкому спектру моделей и беспрепятственным развертыванием в локальной среде. В отличие от облачных сервисов вроде ChatGPT, здесь отсутствует зависимость от подписок и внешних API.
Технические характеристики моей рабочей станции: видеокарта RTX 3070 и 32 ГБ оперативной памяти. Поскольку проект хостится на домашнем ПК, бот доступен только во время работы системы.
Проект постоянно трансформируется. Отслеживать актуальные обновления и внедрение новых инструментов можно в моем Telegram-канале: https://t.me/rocet_0
Хронология разработки: от вызовов к решениям.
V1.0 — V1.1: Первые итерации и борьба с «галлюцинациями»
На начальном этапе архитектура была предельно простой: запрос пользователя транслировался напрямую в ответ модели. Первой пробой пера стала легковесная Mistral, однако она часто демонстрировала слабые когнитивные способности и склонность к ложным утверждениям. Функционал ограничивался базовыми командами /start и /help.
Вскоре я перешел на Qwen2.5:14b. Данная модель показала отличные результаты: высокую скорость обработки на моем «железе», глубокое понимание русского языка и более качественную логику рассуждений.
V1.2: Оптимизация ожидания и имитация печати
Длительное ожидание негативно сказывается на пользовательском опыте. Чтобы предотвратить «зависания» при сложных запросах, я установил лимит на время ожидания ответа от Ollama:
timeout=aiohttp.ClientTimeout(total=600)
Для повышения производительности сессия aiohttp инициализируется единожды при запуске бота и поддерживается в активном состоянии на протяжении всего сеанса.
session = context.application.bot_data['session']
Также была реализована визуальная обратная связь: метод send_action активирует статус «печатает…», а благодаря механизму стриминга ответ формируется постепенно, токен за токеном, прямо на глазах у пользователя.
На этом этапе возникла неожиданная сложность: модель часто использовала разметку LaTeX (например, Попытки решить проблему через системный промт не увенчались успехом — ИИ игнорировал инструкции. Пришлось внедрить функцию постобработки на базе регулярных выражений для очистки текста. В результате математические выкладки стали выглядеть презентабельно. Важное уточнение: В режиме стриминга процесс очистки мог приводить к тому, что текст сообщения не менялся между итерациями, провоцируя ошибку API Telegram. Я добавил условие: Ключевым обновлением стало внедрение истории диалогов. Без памяти бот не способен поддерживать осмысленную беседу. Для надежного хранения данных вместо нестабильной оперативной памяти я использовал SQLite. Теперь для каждого пользователя ( Также была решена проблема с отображением Markdown. Несмотря на то, что модель выделяла текст жирным, Telegram игнорировал разметку до момента явного указания Дополнительно в системный промт была добавлена директива отвечать только на русском языке, так как китайские модели иногда переключались на родной язык без видимых причин. Для удобства переключения между различными ИИ-движками я реализовал систему инлайн-кнопок. Каждая кнопка передает идентификатор модели в переменную В библиотеку были включены: llama3:8b, mistral:7b, deepseek-coder:6.7b, codellama:7b, qwen2.5:7b-instruct, phi3:mini и другие. Технический нюанс: Интерактивные элементы заработали корректно только после явного указания Для минимизации задержек при первом обращении к новой модели я внедрил этап «прогрева». Боту отправляется скрытый микро-запрос «Привет», что заставляет систему заранее загрузить веса модели в память видеокарты. Я структурировал каталог моделей, разбив их по категориям, и добавил визуальную индикацию текущей активной модели с помощью эмодзи «галочки». Для обнуления контекста была создана команда очистки истории: Поскольку процесс выгрузки одной модели и загрузки другой занимает время, я добавил информационное сообщение «Загружаю модель...», чтобы пользователь понимал статус операции. Для повышения отзывчивости системы было внедрено TTL-кеширование. Модели теперь остаются в памяти на определенный срок, что позволяет мгновенно обслуживать запросы разных пользователей, работающих с одним и тем же ИИ-ядром. Первым шагом к мультимодальности стала интеграция glm-ocr — модели, способной извлекать печатный текст из изображений. Теперь при получении фото бот автоматически направляет его на обработку визуальным энкодером. Параллельно была решена проблема оформления программного кода. Я разработал функцию, которая оборачивает блоки кода в HTML-теги " re.sub(pattern, repl, text, flags=re.DOTALL)await context.bot.send_chat_action(chat_id=chat_id, action='typing')
V1.2.1: Коррекция математических формул
\( ... \) или \frac), которую интерфейс Telegram не способен интерпретировать корректно.

# Удаление блоков математической разметки
text = re.sub(r'\\\[|\\\]|\\\(|\\\)', '', text)# Трансформация \frac{a}{b} в (a / b)
text = re.sub(r'\\frac\{(.*?)\}\{(.*?)\}', r'(\1 / \2)', text)# Конвертация корней \sqrt{a} → √(a)
text = re.sub(r'\\sqrt\{(.*?)\}', r'√(\1)', text)# Очистка команд \text{...}
text = re.sub(r'\\text\{(.*?)\}', r'\1', text)# Замена спецсимволов replacements = { r'\pm': '±', r'\times': '×', r'\cdot': '×', r'\div': '÷', r'\approx': '≈', r'\le': '≤', r'\ge': '≥', r'\neq': '≠', r'\quad': ' ', r'\,': '', r'\%': '%' }# Циклическая замена символов for latex, normal in replacements.items(): text = text.replace(latex, normal)# Обработка степеней
text = re.sub(r'\^\{(.*?)\}', r'^\1', text)# Удаление конструкций \left \right
text = re.sub(r'\\left|\\right', '', text)# Удаление прочих служебных команд
text = re.sub(r'\\[a-zA-Z]+', '', text)# Финальная очистка фигурных скобок
text = text.replace('{', '').replace('}', '')
if last_sent_text != new_text: message.edit_text(new_text).V1.3: Контекстная память и оформление Markdown
with sqlite3.connect('memory.db') as conn: cursor = conn.cursor() cursor.execute(""" CREATE TABLE IF NOT EXISTS messages ( id INTEGER PRIMARY KEY AUTOINCREMENT, chat_id INTEGER, role TEXT, content TEXT, timestamp REAL ) """)chat_id) формируется персонализированная цепочка сообщений.parse_mode="Markdown" в методе edit_text.
V1.5: Гибкий выбор нейросетевых моделей
current_model, которая затем подставляется в запрос к API Ollama.async with session.post(
OLLAMA_URL,
json={
"model": current_model,
allowed_updates=["message", "callback_query"] в настройках поллинга бота.V1.6: Мультимодальность, код и кэширование
cursor.execute("""
DELETE
FROM messages
WHERE chat_id = ?
""", (chat_id,))

photo = message.photo[-1]
file = await photo.get_file()
file_path = f"temp_{chat_id}.jpg"
await file.download_to_drive(file_path)
with open(file_path, 'rb') as f:
image_bytes = f.read()
image_base64 = base64.b64encode(image_bytes).decode('utf-8')<pre><code> для корректного отображения моноширинного шрифта в Telegram.pattern = r"(?:\w+)?\n(.*?)"
def repl(math):
code = math.group(1)
escaped = html.escape(code)
return f"{escaped}

Также появилась специализированная категория переводчиков, лидером которой стала TranslateGemma, обеспечивающая высокоточное лингвистическое преобразование фраз.
Чтобы гарантировать корректное форматирование при использовании HTML, я реализовал конвертер, который переводит Markdown-разметку (решетки для заголовков, звездочки для жирности) в соответствующие HTML-теги.
text = fix_latex(text)
text = re.sub(r'### (.+?)(?:\n|$)', r'\1\n', text)
text = re.sub(r'## (.+?)(?:\n|$)', r'\1\n', text)
text = re.sub(r'# (.+?)(?:\n|$)', r'\1\n', text)
text = re.sub(r'**(.+?)**', r'\1', text, flags=re.DOTALL)
text = re.sub(r'(?<!*)*(?!*)(.+?)(?<!*)*(?!*)', r'\1', text, flags=re.DOTALL)
text = re.sub(r'^- ', '• ', text, flags=re.MULTILINE)
V1.7: Работа с длинными сообщениями
С ростом «интеллекта» моделей увеличился и объем генерируемых текстов. Ответы начали выходить за пределы стандартного лимита Telegram в 4096 символов. Для решения этой проблемы был внедрен алгоритм автоматического дробления сообщений на части по 4000 знаков с сохранением целостности стриминга.

При разрыве текста разметка HTML часто оставалась незавершенной. Чтобы избежать искажения интерфейса, была написана функция автоматического закрытия тегов.
tags = ["b", "i", "pre", "code"]
for tag in tags:
opens = text.count(f"<{tag}>")
closes = text.count(f"</{tag}>")
if opens > closes:
    text += f"</{tag}>" * (opens - closes)
elif closes > opens:
    text = text.replace(f"</{tag}>", "", closes - opens)
V1.8: Геймификация — мини-игра «Детектив»
Для демонстрации творческого потенциала ИИ я добавил игру «Детектив». Нейросеть генерирует уникальный криминальный сюжет в формате JSON (улики, подозреваемые, мотивы), а игрок выступает в роли следователя.

Игрок располагает ограниченным количеством вопросов. В геймплей включены специальные способности: «Криминалист» открывает случайную улику, «Журналист» проводит допрос, а «Психолог» составляет портрет личности.
За генерацию сценариев отвечает qwen2.5:14b-instruct, что обеспечивает высокую вариативность сюжетов и логическую стройность расследований.
V1.8.1: Стабилизация и отказоустойчивость
Домашний хостинг сопряжен с рисками обрыва связи или сбоев ПО. Чтобы обеспечить непрерывную работу, я реализовал:
-
Детальное логирование для оперативной диагностики ошибок.
-
Механизм автоматического перезапуска при критическом падении процесса поллинга.
if name == "main":
     while True:
         try:
             logging.info("Инициализация...")
             asyncio.run(run_bot_polling(app))
         except Exception as e:
             logging.error(f"Сбой: {e}")
             time_module.sleep(5)
V2.0: Визуальное воображение
Финальным крупным обновлением стала интеграция AUTOMATIC1111 для генерации изображений. Доступны классические и современные модели: SDXL, Stable Diffusion 3 Medium, DreamShaper. Взаимодействие происходит через API WebUI.
payload = { "prompt": prompt, "steps": 25, "width": 1024, "height": 1024, "override_settings": {"sd_model_checkpoint": model_name}}

Пользователь отправляет команду /draw [описание], бот генерирует изображение и отправляет результат в чат.
Резюме:
Создание собственного Telegram-бота на базе локальных нейросетей — это не только технически осуществимый, но и крайне увлекательный процесс. Он не требует колоссальных затрат, если у вас уже есть производительный ПК, но при этом предоставляет полную свободу в реализации функций: от текстового ассистента до полноценной игровой платформы и генератора графики.
 Инсайдер раскрыл почти все характеристики будущего флагмана OnePlus 16
 Через три года нехватка специалистов по разработке ИИ-чипов в США может превысить 150 000 человек
 Китайский бренд проектирует смартфон с камерой на 200 Мп и вторым 1,72-дюймовым экраном
 Honor выпустила 2-литровую рабочую станцию на базе Nvidia RTX Spark
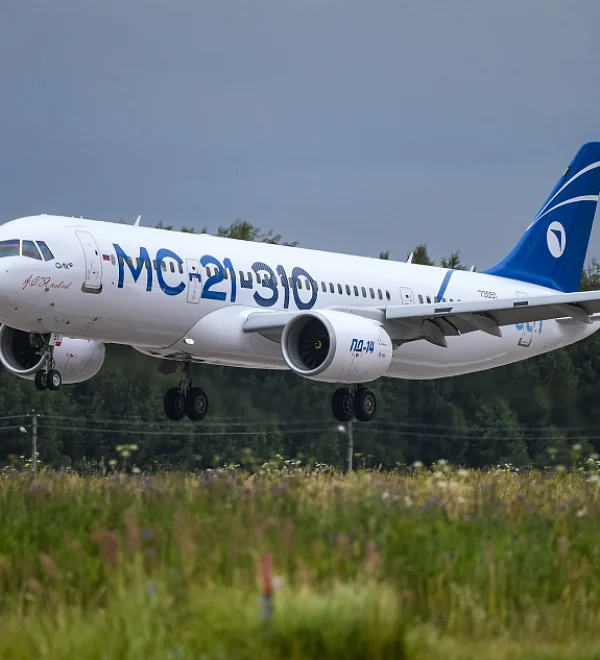 Российский конкурент Boeing и Airbus оценили в 7,5 млрд рублей с перспективой удешевления
 Anthropic засекретила новую биолабораторию
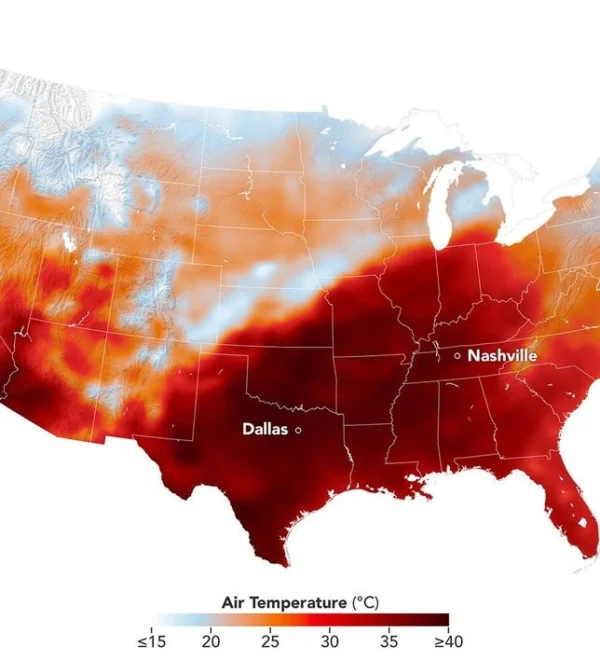 Осенняя жара: юг США зажат в тисках теплового купола при +38 °C
 К 2050 году ИИ-мусор заполнит 23 миллиона контейнеров: их цепочка опояшет Землю шесть раз