Почему нейросети усложняют простое и упрощают сложное — и при чём здесь Шерлок Холмс
Языковые модели научились рассуждать, прежде чем отвечать. Теперь перед разработчиками встал знакомый каждому вопрос: сколько времени стоит потратить на обдумывание конкретной задачи? Объяснить его помогут две метафоры.
В рассказе сэра Артура Конан Дойла «Союз рыжих» к Шерлоку Холмсу обращается владелец ссудной кассы Джабез Уилсон. Не успевает посетитель устроиться в кресле, как сыщик сообщает ему: тот нюхает табак, принадлежит к масонской ложе, прежде занимался физическим трудом, побывал в Китае и недавно много писал. Холмсу достаточно нескольких секунд, чтобы прочесть все это по рукам, манжетам и булавке гостя. Но история самого Уилсона требует иного подхода. «Это задача на три трубки, — говорит Холмс Ватсону, — и я попрошу вас минут пятьдесят со мной не разговаривать».
Конан Дойл показал, что его герой мыслит с разной скоростью. О молниеносной дедукции Холмса знают все, но для нашей темы важнее другая его способность: он заранее понимал, какую загадку можно разгадать с первого взгляда, а над какой придется просидеть три трубки.
Холмс был литературным героем, а Даниэль Канеман, нобелевский лауреат по экономике и автор книги «Думай медленно… решай быстро», годами изучал, как привычка полагаться на быстрое мышление подводит реальных людей. В книге он приводит задачу психолога Шейна Фредерика. Бита и мяч вместе стоят доллар и десять центов, причем бита на доллар дороже мяча. Сколько стоит мяч? Первый напрашивающийся ответ — десять центов — неверен: в таком случае бита стоила бы 1,10 доллара, а общая цена составила бы 1,20 доллара. Ошибку допустили более половины студентов Гарварда, MIT и Принстона, которым предложили задачу. Быстрое мышление, или Система 1 в терминологии Канемана, уверенно выдает ответ. Медленная Система 2 могла бы его перепроверить, но неохотно берется за работу — поэтому Канеман назвал ее ленивым контроллером.
Языковым моделям пришлось освоить оба навыка: холмсовскую быстроту наблюдения и медленную проверку по Канеману. А ошибаются они порой совсем как студенты в эксперименте Фредерика.
Как у нейросетей появилась Система 2
Первые языковые модели напоминали Систему 1 в чистом виде. Получив вопрос, они немедленно начинали выдавать ответ токен за токеном, не составляя черновик и не проверяя себя. Каждый токен требует вычислительных ресурсов и стоит денег. О том, как складывается эта стоимость, я подробнее писал в первой статье цикла.
В сентябре 2024 года OpenAI представила модель o1, которая перед ответом формирует длинную цепочку рассуждений: разбирает условие, рассматривает варианты и исправляет собственные ошибки. На отборочном экзамене Международной математической олимпиады предшествующая GPT-4o справилась с 13% задач, а o1 — с 83%. В январе 2025 года китайская DeepSeek опубликовала модель R1 с открытыми весами. Рассуждающие модели постепенно стали нормой: нейросети обзавелись собственной «Системой 2».
Однако вместе с новой способностью обнаружилась и проблема: модели рассуждали всегда — и над теоремой, и над простым вопросом о погоде.
Формулировка «думай медленно, решай быстро» принадлежит не Канеману, а российским издателям. Оригинальное название точнее: Thinking, Fast and Slow — «Мышление, быстрое и медленное». Из уважения к автору я сохраню обозначения «Система 1» и «Система 2», хотя речь пойдет об искусственном интеллекте. Канеман не случайно предпочел номера названиям: выражение «автоматическая система» длиннее и занимает больше места в кратковременной памяти.
Как модель убеждает себя отказаться от правильного ответа
В декабре 2024 года исследователи Tencent AI Lab опубликовали статью с выразительным названием «Do NOT Think That Much for 2+3=?». Они задавали рассуждающим моделям элементарные вопросы и измеряли затраты на ответы. Модель QwQ-32B-Preview правильно ответила на вопрос «сколько будет 2+3» за 39 токенов, но не остановилась: она решила пример еще двенадцатью способами и в итоге израсходовала 901 токен. В среднем модели нового поколения тратили почти в двадцать раз больше токенов, чем обычные, чтобы получить тот же результат.
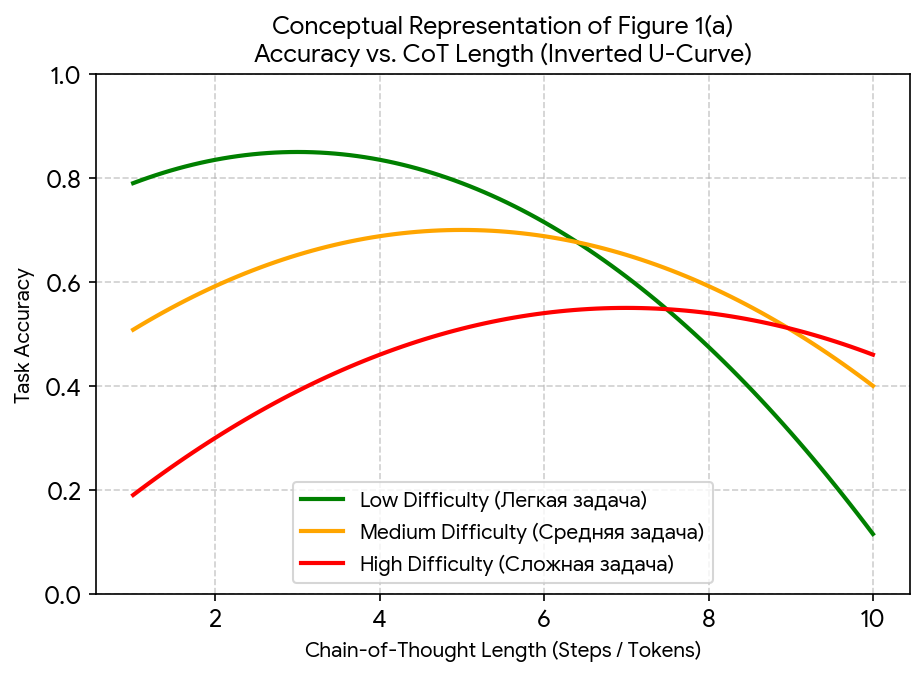
Дело не только в стоимости: избыточные размышления способны ухудшить и сам ответ. Исследователи из Meta и Еврейского университета в Иерусалиме сопоставили разные рассуждения одной модели над одним и тем же вопросом. Самое короткое оказывалось точнее самого длинного, причем разница достигала 34,5%. Другая работа, представленная на ICLR 2026, описала такую закономерность: точность повышается с увеличением длины рассуждения лишь до определенной точки, после чего начинает снижаться. График при этом напоминает перевернутую букву U.
Летом 2025 года исследователи Anthropic продемонстрировали, как чрезмерное обдумывание портит результат. Одна из задач начиналась так: «У вас есть яблоко и апельсин, но вы не знаете, какого они сорта». В условие добавили отвлекающую подробность — расчет вероятности того, что яблоко относится к сорту «ред делишес», а апельсин — к сорту «навел». Требовалось всего лишь посчитать фрукты. Чем дольше Claude Opus 4 и DeepSeek R1 размышляли, тем чаще пытались включить вероятность в подсчет и ошибались там, где справился бы первоклассник. Модели разных компаний сбивались каждая по-своему: Claude все глубже погружался в посторонние детали, а модели OpenAI подгоняли условие под знакомый шаблон и решали задачу, встречавшуюся им раньше.
Чем длиннее цепочка рассуждений, тем выше вероятность ошибиться на промежуточном этапе, иначе понять условие или усомниться в правильном ответе. Исследователи наблюдали случаи, когда модель сначала находила верное решение, а затем сама себя от него отговаривала.
Мяч стоимостью десять центов
У переобдумывания есть и противоположная проблема — недостаток размышлений. Она проявилась, когда разработчики попытались научить модели экономнее расходовать ресурсы на рассуждение. 9 февраля 2026 года Anthropic сделала адаптивное мышление режимом по умолчанию для Claude Opus 4.6. Модель получила возможность сама выбирать, стоит ли обдумывать очередной шаг и сколько времени этому уделить, а фиксированный бюджет токенов для рассуждений ушел в прошлое.
Весной программисты на Hacker News стали жаловаться, что Claude Code отвечает поверхностно. Он придумывал версию API Stripe, несуществующий хэш коммита и списки пакетов, отсутствующих в репозиториях. К обсуждению присоединился создатель Claude Code Борис Черни и изучил телеметрию проблемных сессий. У всех авторов жалоб был установлен высокий уровень усилия, так что настройки не объясняли происходящее. «Данные указывают, что адаптивное мышление недодает рассуждения на отдельных шагах», — написал он. Там, где модель выдумывала факты, она не расходовала на размышление ни одного токена. А когда рассуждала, отвечала правильно. В качестве временного решения Черни предложил отключить адаптивный режим и вернуться к фиксированному бюджету.
Это нейросетевая версия задачи про биту и мяч. Вопрос о версии API кажется несложным, Система 1 выдает правдоподобный ответ, а Система 2 остается в стороне: внутренний диспетчер решил, что проверка не нужна. Ленивый контроллер поступил примерно так же, как мышление студентов Гарварда и MIT.
Случай Claude Code согласуется и с другими наблюдениями. Исследователи, изучавшие самопроверку рассуждающих моделей, обнаружили у них зачатки способности оценивать сложность. Если модель замечает подвох, она иногда продолжает рассуждать уже в процессе ответа. Но калибровка нарушена в обе стороны: сложным вопросам уделяется слишком мало внимания, а простым — слишком много. Похоже, подобно человеку, модель оценивает сложность по внешнему виду задачи еще до того, как приступит к решению.
Почему модели сложно научиться выбирать
В робототехнике инженеры Nvidia обошли проблему выбора. Представленная в марте 2025 года модель для человекоподобных роботов Isaac GR00T N1 состоит из двух систем, названных по аналогии с концепцией Канемана. «Система 2», визуально-языковая модель, анализирует сцену, читает инструкцию вроде «убери чашку в шкаф» и обновляет план действий каждые сто миллисекунд. «Система 1» каждые восемь миллисекунд преобразует этот план в команды для моторов. Если чашка начнет выскальзывать, пальцы успеют перехватить ее еще до того, как медленная система пересмотрит план.
На SE7ENе эту архитектуру уже разбирали и обратили внимание на расхождение с концепцией Канемана. У человека Система 2 включается редко и с усилием, а пока она бездействует, Система 1 успевает ошибиться. У робота обе системы действуют сообща: медленной не нужно отдельное приглашение, она работает постоянно. Поэтому проблема биты и мяча ему не грозит.
С языковой моделью ситуация иная. Рассуждение тоже требует работы: пользователь ждет каждый токен и платит за него. Если постоянно держать Систему 2 включенной, человеку придется ждать и расходовать деньги даже на вопрос «сколько будет 2+3». Именно с такой ситуации индустрия и начинала. Поэтому решение о том, нужен ли черновик и насколько длинным он должен быть, приходится принимать до ответа. Систему, которая делает этот выбор, назовем диспетчером. В этом отношении гибридные модели ближе к человеку, чем роботы Nvidia, и ошибки у них тоже напоминают человеческие.
Научить модель выбирать подходящий режим непросто по двум причинам. Первую объяснил Цзюньян Линь, бывший руководитель команды Qwen в Alibaba. Быструю модель поощряют за прямоту, краткость и скорость, а рассуждающую — за подробное обдумывание. Поэтому обучающие данные для двух режимов существенно различаются. Если смешать их небрежно, результат, по словам Линя, окажется «посредственным в обоих направлениях». Его команда убедилась в этом на собственной модели; к этой истории я еще вернусь.
Вторая причина связана с самим процессом обучения. Модель учится выбирать режим методом проб и наград: правильный ответ поощряется, а ненужная длина штрафуется. Авторы метода Thinkless выяснили, что при стандартной схеме модель быстро «залипает» в одном режиме. Обнаружив, что тот в среднем приносит больше наград, она перестает экспериментировать с другим.
Кто определяет, нужно ли модели думать?
Возможны три подхода. Первый — переключателем управляет человек: он сам включает рассуждение и задает бюджет токенов. Второй — запрос читает программа-роутер и направляет его быстрой или рассуждающей модели. Третий — выбор делает сама модель, а в наиболее смелых исследованиях она меняет режим прямо в процессе рассуждения. О судьбе первых двух подходов в индустрии речь пойдет в следующем разделе. Третий пока остается предметом исследований.
Метод Thinkless, предложенный в 2025 году исследователями Национального университета Сингапура, обучает модель начинать ответ с одного из двух служебных слов: «коротко» или «думать». Сначала она подражает двум учителям — обычной и рассуждающей моделям. Затем ее дообучают с помощью наград. Именно на этом этапе авторы нашли способ избежать залипания: они отделили награду за выбор режима от награды за качество ответа. Благодаря этому единственное служебное слово в начале не терялось на фоне тысяч токенов рассуждения. На наборе алгебраических задач обученная модель включала рассуждение лишь в одном случае из четырех, расходовала в 2,6 раза меньше токенов и теряла менее процента точности.
Команда Университета Цинхуа в методе AdaptThink решила проблему залипания иначе. В процессе обучения модель принудительно отвечает без рассуждения на половине примеров, благодаря чему не забывает быстрый режим. Небольшая модель с 1,5 миллиарда параметров стала расходовать на 45–65% меньше токенов и даже немного повысила точность. Усилия она распределяла осмысленно: на простые вопросы почти всегда отвечала сразу, а по мере усложнения задач, вплоть до олимпиадных задач AIME, все чаще переходила к рассуждению.
Вопрос о распределении ресурсов возник и для моделей, работающих с изображениями. Картинка тоже преобразуется в токены, причем снимок высокого разрешения может потребовать их тысячи. В исследовании, опубликованном в октябре 2026 года, предложили небольшой модуль mmVB с 1,6 миллиона параметров. Когда модель получает сразу несколько изображений, модуль еще до начала основной работы определяет, сколько токенов выделить каждому с учетом заданного вопроса. В результате модель получает в девять раз меньше визуальных токенов, начинает отвечать в пять раз быстрее и сохраняет 94,4% точности.
Кто определяет, сколько модели думать?
За два года пять крупных компаний опробовали почти все возможные ответы: ручной переключатель, скрытый роутер, отдельные модели и гибридный режим по умолчанию. Некоторые успели изменить свое решение дважды. Проследить за этой эволюцией непросто.
Первой была Anthropic: в феврале 2025 года компания выпустила Claude 3.7 Sonnet — первую на рынке гибридную рассуждающую модель. Один и тот же Claude мог отвечать сразу или сначала рассуждать, а режим выбирал пользователь. Через API можно было установить и бюджет размышлений — до 128 тысяч токенов. Anthropic с самого начала рассматривала рассуждение как встроенную способность, поэтому не стала выпускать отдельный продукт, как это сделала OpenAI с o1. Год спустя выбор перешел к самой системе, и в Claude Opus 4.6 с адаптивным мышлением возникли описанные выше проблемы с недостаточным обдумыванием. Тем не менее Anthropic сохранила курс на гибридность. Начиная с Claude 4.7 API возвращает ошибку на запрос с заданным вручную бюджетом токенов, а у флагманов поколения 5.x мышление невозможно полностью отключить. Пользователю остается выбрать уровень усилия — от low до max. У Claude Sonnet 5.5 предусмотрен и компромиссный режим: перед ответом модель не размышляет, но рассуждает между вызовами инструментов.
Alibaba подхватила идею в апреле 2025 года. Qwen3 мог переключаться между режимами непосредственно в ходе диалога: для этого к реплике достаточно было добавить /think или /no_think. Команда построила четырехэтапный конвейер дообучения, включив в него отдельный этап объединения режимов. Но уже через три месяца она публично отказалась от гибридного подхода. В Qwen сообщили, что решили отказаться от гибридного мышления и обучать модели Instruct и Thinking отдельно ради максимального качества. Раздельные варианты показали заметно лучшие результаты, особенно без рассуждений, подтвердив диагноз Линя. В феврале 2026 года Qwen3.5 вновь вышел гибридным, теперь с мышлением по умолчанию. Отключить его можно параметром запроса, но прежние команды /think и /no_think больше не действуют. Команда официально не объясняла причины возврата. Возможно, разделение помогло отдельно решить проблемы с данными для каждого режима, после чего их удалось снова объединить.
OpenAI выбрала другой путь и разместила между пользователем и моделями невидимого диспетчера. Выпущенный в августе 2025 года GPT-5 компания представила как единую систему. Пользователь видел одну кнопку, а диспетчер в реальном времени определял, ответит ли быстрая модель или запрос достанется рассуждающей. В день запуска диспетчер дал сбой и направлял сложные запросы более простым моделям. Сэм Альтман признал, что из-за этого GPT-5 «казался намного глупее». Компании пришлось вернуть прежнюю GPT-4o, пообещать показывать отвечающую модель и добавить ручное включение рассуждений. От автоматического выбора OpenAI отказалась не сразу: в GPT-5.1 его назвали «адаптивным рассуждением». Однако к осени 2026 года режим Auto исчез из справки ChatGPT. Глубину мышления теперь задает ползунок с уровнями Instant, Medium, High и Extra High; на тарифах Plus и Pro режим Instant автоматически на более высокий уровень не переключается. Автоматика сохранилась для особых случаев — например, когда пользователь исчерпал лимит рассуждений.
DeepSeek двигалась от двух моделей к одной. В январе 2025 года рассуждающая R1 существовала отдельно от обычной модели, а разработчики обращались к ним под разными именами: deepseek-reasoner и deepseek-chat. В августе 2025 года V3.1 объединила оба режима. В DeepSeek V4 появилось три режима: Non-Think для быстрых ответов, Think High для обычных рассуждений и Think Max для максимально глубоких. В апреле 2026 года объединение коснулось и названий. Старые имена deepseek-chat и deepseek-reasoner стали указывать на одну модель V4-Flash — соответственно без мышления и с мышлением, а 24 июля 2026 года их вывели из обращения.
Google заняла наиболее жесткую позицию. Уже в Gemini 2.5 Pro мышление нельзя было выключить: минимальный бюджет составлял 128 токенов. Модель могла и сама выбирать глубину рассуждения — для этого параметру бюджета присваивали значение −1. В Gemini 3 бюджет токенов заменили несколькими уровнями мышления. По умолчанию модель использует высокий уровень и адаптируется к задаче. Младшим моделям Flash оставили близкий к нулю уровень minimal, а у Pro варианта «не думать» по-прежнему нет. Логика Google в этих настройках очевидна: флагман рассуждает всегда, меняется лишь глубина.
Кто принимает решение и кто за него платит
Компании стартовали с разных позиций, но, как показывает таблица ниже, к осени 2026 года пришли к похожей схеме. Чисто ручной переключатель и полностью скрытый роутер уступили место регулятору глубины. Пользователь выбирает уровень усилия, а модель в его пределах сама определяет, сколько думать над конкретным шагом. У флагманов Anthropic и Google возможности совсем отказаться от мышления больше нет, а Alibaba сделала его режимом по умолчанию.
|
Компания |
Начальный подход |
Ситуация к осени 2026 года |
Что контролирует пользователь |
|---|---|---|---|
|
Anthropic |
Ручное переключение и бюджет токенов (Claude 3.7, 2025) |
Мышление у флагманов нельзя выключить |
Уровень усилия |
|
Alibaba |
Гибридная модель с командами /think и /no_think (Qwen3, 2025) |
Сначала раздельные модели, затем возвращение к гибриду с мышлением по умолчанию (Qwen3.5) |
Включение мышления и бюджет |
|
OpenAI |
Скрытый роутер (GPT-5, 2025) |
Ползунок уровней и автоматический выбор в особых случаях |
Уровень мышления |
|
DeepSeek |
Две самостоятельные модели (V3 и R1) |
Одна модель с тремя режимами (V4) |
Выбор одного из трех режимов |
|
|
Бюджет токенов; мышление у Pro не отключается (Gemini 2.5) |
Отдельные уровни; Pro рассуждает всегда (Gemini 3) |
Уровень мышления |
Компании устанавливают уровни усилия не случайным образом. Борис Черни рассказывал, что по умолчанию Claude Code работал на уровне 85: команда сочла его лучшим компромиссом между качеством, задержкой и стоимостью для большинства пользователей. Тем, кому требовалось больше, Черни рекомендовал повысить уровень вручную. Согласно документации Anthropic, флагман Claude Opus 5.5 по умолчанию использует уровень medium, хотя для большинства других моделей стандартным остается high.
Экономика роутера еще нагляднее. После запуска GPT-5 наблюдатели отметили, что диспетчер, предпочитающий по умолчанию дешевый путь, помогает сохранять бесплатные тарифы и стабильные цены. Интересы сторон здесь расходятся: пользователь хочет, чтобы модель размышляла с запасом, а компания стремится избежать лишних расходов. Различия во взглядах ИИ-компаний и пользователей на ценовую политику я уже разбирал.
Похожий принцип Канеман обнаружил и у людей, назвав его законом наименьшего усилия. Если достичь цели можно несколькими способами, человек в конечном счете выбирает наименее затратный: для мозга усилие — это издержка, которую он учитывает. Проверить принцип можно простым опытом. Попросите спутника во время неторопливой прогулки умножить в уме 23 на 78 — скорее всего, он остановится. Мозгу не хватает ресурсов одновременно на ходьбу и счет, поэтому ради размышления он жертвует движением.
Канеман находил способ измерить эту издержку напрямую. Испытуемый слушал последовательность цифр и прибавлял к каждой по три, а камера фиксировала размер зрачка. На пике нагрузки зрачок расширялся примерно наполовину, а после решения задачи вновь сужался.
Система 2 ленива по той же причине: каждое ее включение связано с расходами. У языковых моделей эту цену можно увидеть и без камеры. Ее измеряют в токенах и включают в счет, а степень лени регулируют настройками.
Холмс отправляется на улицу
Холмс молча выкурил свои трубки, свернувшись в кресле и подтянув колени почти к носу. Затем он вскочил и предложил Ватсону прогуляться. На Сакс-Кобург-сквер, перед ссудной кассой Уилсона, сыщик несколько раз сильно ударил тростью по мостовой, потом постучал в дверь и спросил у помощника хозяина дорогу на Стрэнд. Вопрос послужил предлогом: Холмс хотел взглянуть на колени брюк помощника, протертые при рытье подземного хода. Время размышлений закончилось — настал черед проверить гипотезу на практике.
Языковые модели подошли к похожей развилке. Похоже, следующим важным этапом станет агентное мышление. Когда модель пользуется инструментами, пишет код и посещает сайты, ей приходится на ходу определять, когда пора завершить рассуждение и действовать, какой инструмент выбрать и как изменить план, если результат оказался неожиданным. Вопрос о том, сколько времени стоит думать, превращается в вопрос о том, когда нужно остановиться и приступить к делу. Индустрия только начинает искать на него ответ.
Холмс знал ответ и здесь: три трубки — и на улицу.
А какой уровень мышления модели вы выбираете по умолчанию?
Похожие статьи
 Растение не может спрятаться от солнца, поэтому изобрело феруловую кислоту
 Восстание машин откладывается: почему интеллект без собственных целей ещё не разум
 В языковую модель внедрили «мысль»: что выяснилось за год проверок и когда она её замечала
 Новый тип аккумуляторов набирает популярность благодаря способности сохранять сверхвысокую температуру
 Введение в глубокое обучение. Часть 3
 Искусственный интеллект как инструмент контроля: как государства, спецслужбы и мошенники управляют вашим сознанием
 Скирмионы как основа компьютера, работающего по принципу мозга
 Почему предлог «в» сбивает с толку калькуляторы и нарушает логику