
Основы глубинного обучения. Часть 4
Всем привет! Перед вами четвёртая статья из серии об основах глубокого обучения. В предыдущих трёх частях мы рассмотрели немало полезных для начинающих тем, поэтому советую вернуться к ним, если вы их пропустили.
На этот раз мы продолжим изучать нейронные сети для обработки естественного языка (NLP) и создадим модель, которая определяет пропущенное слово по окружающему контексту.
Что мы получили в предыдущей части?
В прошлой статье мы построили двухслойную нейронную сеть для классификации текстов и обучили её на отзывах о фильмах с Кинопоиска. Теперь подробнее рассмотрим роль отдельных нейронов в получившейся модели. Нейросеть стремится реализовать функцию, которая как можно точнее описывает связь между входными признаками и целевым значением. Иными словами, она обнаруживает корреляции между входными и выходными данными.
С исследовательской точки зрения интересно выяснить, какие закономерности языка модель смогла обнаружить, а какие остались для неё незаметными. Можно предположить, что в нашей задаче она должна хотя бы начать различать слова с положительной и отрицательной окраской: именно это помогает определить тональность отзыва. Чтобы сеть выявляла более разнообразные языковые закономерности, можно расширить датасет, усложнить архитектуру и/или поставить перед моделью более сложную задачу — например, предложить ей угадывать пропущенное слово.
До сих пор мы рассматривали работу нейросети в целом. Мы выяснили, что каждый нейрон, по сути, является частью большой функции, которую реализует сеть, и обсудили роль слоёв и функций активации в построении более сложных нелинейных зависимостей. Теперь перейдём к отдельным нейронам скрытого слоя.
Упрощённо можно сказать, что скрытые слои группируют данные предыдущего слоя в n групп. Степень активации каждого нейрона зависит от того, насколько входные данные соответствуют его группе. Такая группировка полезна, если помогает последующим слоям предсказать целевое значение и выявить нужную закономерность в данных.
На высоком уровне два объекта, например два отзыва о фильмах, похожи, если принадлежат многим общим группам: на практике их векторные представления будут близки. Аналогично два входных слова можно считать похожими, если близки их векторные представления, то есть веса связей с нейронами скрытого слоя. Это означает, что слова имеют примерно одинаковую степень сходства с каждой группой.
В нашей задаче слова, связанные со схожими метками — положительным или отрицательным отзывом, — будут иметь похожие веса связей со скрытыми нейронами. Сеть учится объединять такие слова посредством сходных скрытых нейронов, чтобы последний слой мог сделать верный прогноз. В более общем случае нейроны одного слоя могут выполнять схожие функции, если похожи веса их связей с предыдущим и/или следующим слоем.
Напишем функцию, которая возвращает 50 слов, наиболее похожих на заданное. Чтобы получить набор весов конкретного слова, достаточно выбрать соответствующую строку матрицы весов. Для сравнения векторных представлений я воспользуюсь евклидовым расстоянием между двумя точками.
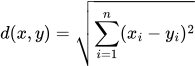
Реализация очень проста. В качестве оценки используем отрицательное расстояние: так мы сможем применить метод most_common() объекта Counter.
from collections import Counter
import math

def similar(target="плохой"):
    target_index = word2index[target]
    print(f"Векторное представление слова: {weights_1[target_index]}")
    scores = Counter()
    for word, index in word2index.items():
        raw_difference = weights_1[index] - weights_1[target_index]
        squared_difference = raw_difference*raw_difference
        scores[word] = -math.sqrt(np.sum(squared_difference))
    return scores.most_common(50)

print(similar())
Обучим модель из предыдущей части, чтобы воспользоваться её матрицами весов и посмотреть, как она сгруппировала слова. После вызова функции получаем следующий результат:
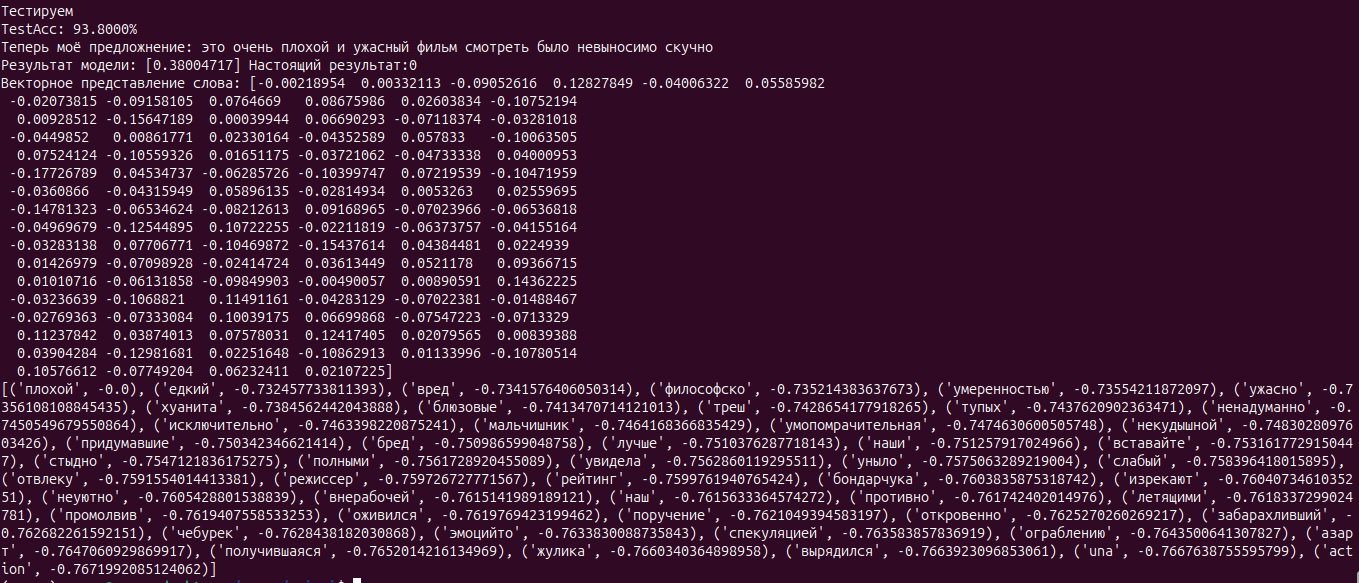
На первом месте ожидаемо оказалось само заданное слово: его вектор совпадает с исходным. За ним следуют слова, которые помогают определять метку примерно так же, как «плохой». Поскольку сеть выбирает между двумя метками, закономерно, что слова группируются с учётом положительной или отрицательной эмоциональной окраски.
Такую внутреннюю группировку слов скрытыми слоями, в ходе которой выявляются дополнительные языковые закономерности, называют обобщением корреляции. Сеть искала прямую связь между данными, но в качестве побочного эффекта освоила некоторые закономерности языка, помогающие ей правильно определять метку.
При этом нельзя утверждать, что модель научилась безошибочно разделять слова на плохие и хорошие или что отдельный нейрон скрытого слоя различает, например, грубые и нейтральные слова. На изображении выше видно, что такую группировку способен выполнять скрытый слой в целом, то есть все его нейроны совместно.
Среди слов, близких к слову «плохой», встречаются «едкий», «вред» и «треш». Это указывает на то, что сеть уловила не только тональность конкретных отзывов, но и более общие свойства слов. Однако в списке есть и «философско», «лучше» и «чебурек», которые едва ли можно назвать негативными — хотя тут у каждого своё мнение.
Этот результат ещё раз показывает: главная цель модели — найти корреляции, позволяющие сделать верный прогноз. Скрытые слои группируют слова по признакам, важным для выходной метки, а распознавание эмоциональной окраски остаётся побочным эффектом и потому не отличается абсолютной точностью.
Чтобы нейросеть освоила больше языковых нюансов, ей нужны входные и выходные данные, для работы с которыми требуется более глубокое понимание языка. Для этого мы создадим модель, способную подбирать пропущенное слово.
Нейросеть для поиска пропущенного слова
Я выбрал эту задачу, потому что для неё можно использовать те же отзывы о фильмах: достаточно убрать одно слово из фразы. Подойдут и другие тексты из интернета. Кроме того, точное предсказание недостающего слова требует понимания контекста; похожие задачи используются при обучении моделей семейства GPT и BERT.
Адаптируем сеть из предыдущей части к новой задаче. Вместо предсказания одной метки будем рассматривать фрагмент из пяти слов: опорное слово и до двух слов с каждой стороны. Опорное слово удалим и научим сеть определять его по оставшемуся контексту.
Для ускорения обучения применим отрицательное семплирование (negative sampling). Предсказание пропущенного слова связано с выбором из всего словаря, но на каждом шаге прямого распространения мы будем рассматривать лишь небольшую случайную выборку кандидатов. На практике этот подход показывает хорошие результаты.
Таким образом, вместо оценки каждого слова из словаря мы будем вычислять значения только для слов из выбранного подмножества.
Сначала, как и прежде, загрузим датасет Кинопоиска, удалим лишние символы и знаки препинания, получим список отзывов и разделим каждый из них на токены. В нашем случае токен соответствует слову. В результате список tokens будет содержать списки слов отдельных отзывов. В прошлый раз мы удаляли повторы, но теперь важно сохранить порядок слов и их соседство с опорным словом.
Создадим счётчик — объект, похожий на словарь и снабжённый удобными методами. Затем сформируем словарь vocab, расположив слова по возрастанию частоты, а также создадим словарь соответствий между словами-токенами и их идентификаторами.
После этого подготовим input_dataset: вместо списков слов отзывов он будет содержать списки их идентификаторов, которые позволяют обращаться к соответствующим строкам матрицы весов. Также создадим общий список слов из отзывов с повторениями — он понадобится для случайной выборки.
Зададим гиперпараметры. В скрытом слое будет 50 нейронов, а выходной слой будет соответствовать len(vocab) словам. Параметр negative определяет количество случайных отрицательных примеров. Первую матрицу весов заполним случайными числами от -0.1 до 0.1, вторую — нулями. Матрица выходного слоя может показаться транспонированной: для каждого из len(vocab) слов нужно по 50 весов, и мы заранее располагаем их в таком виде для удобства вычислений.
Создадим целевой вектор: его первый элемент равен единице, остальные пять — нулю. Модель всегда получает шесть вариантов: сначала правильное пропущенное слово, затем пять случайных отрицательных примеров.
Перейдём к обучению. Мы последовательно обработаем каждый отзыв и каждое слово в нём, так что со временем каждое слово станет опорным. В target_samples будут храниться идентификатор опорного слова и пять случайных отрицательных примеров. С помощью срезов получим идентификаторы соседних слов: до двух слева и до двух справа.
Выход layer_1 — это усреднённое векторное представление слов, окружающих опорное. Функция mean не просто складывает строки матрицы, но и делит результат на их количество. Это важно на границах отзыва: например, слева от опорного слова может ничего не оказаться, и тогда контекст будет состоять только из двух слов справа. Усреднение позволяет работать с контекстом разной длины.
В выходном слое вычислим взвешенную сумму и применим функцию активации. При этом значения рассчитываются не для всего словаря, а только для шести выбранных кандидатов.
Далее выполняем обратное распространение. Используем бинарную перекрёстную энтропию для оценки ошибки и sigmoid в выходном слое. В этом случае дельта равна разности между результатом и целевым значением. Мы получаем вектор из шести дельт — по одной для каждого рассмотренного слова. Дельта первого слоя вычисляется как взвешенная сумма дельт выходного слоя.
Затем обновляем веса. В первом слое вычитаем дельту, умноженную на коэффициент обучения, из строк, соответствующих входным словам. Дополнительно умножать на представления слов не нужно: в one-hot-векторе единица стоит только на выбранной позиции, а остальные позиции равны нулю.
Для выходного слоя вычитаем произведение дельты на выход первого слоя и коэффициент обучения. Для вычисления произведения снова используем np.outer.
import numpy as np
np.random.seed(1)
from datasets import load_dataset
import pandas as pd
import re, math, random
random.seed(1)
from collections import Counter

dataset = load_dataset("blinoff/kinopoisk")
df = pd.DataFrame(dataset["train"])

def clean(text):
    text = text.replace("\n", " ").replace("\xa0", " ").lower()
    text = re.sub(r"[^а-яa-z\sё]", "", text)
    text = re.sub(r"\s+", " ", text)
    return text.strip()

raw_reviews = list(map(clean, df["content"].tolist()))#список с отзывами
tokens = list(map(lambda x: x.split(" "), raw_reviews))

wordcnt = Counter()
for sent in tokens:
    for word in sent:
        wordcnt[word] -= 1
vocab = list(map(lambda x:x[0], wordcnt.most_common())) #от самого редкого слова до самого частого

word2index = {}
for i, word in enumerate(vocab):
    word2index[word] = i

concatenated = list()
input_dataset = list()
for sent in tokens:
    sent_indices = list()
    for word in sent:
        sent_indices.append(word2index[word])
        concatenated.append(word2index[word])
    input_dataset.append(sent_indices)
concatenated = np.array(concatenated)

random.shuffle(input_dataset) # перемешаем наши отзывы
alpha, iterations, hidden_size, window, negative = (0.05, 2, 50, 2, 5)

weights_1 = np.random.rand(len(vocab), hidden_size) * 0.2 - 0.1
weights_2 = np.zeros((len(vocab), hidden_size))

layer_2_target = np.zeros(negative+1)
layer_2_target[0] = 1

def similar(target="плохой"):
    target_index = word2index[target]
    scores = Counter()
    for word, index in word2index.items():
        raw_difference = weights_1[index] - weights_1[target_index]
        squared_difference = raw_difference*raw_difference
        scores[word] = -math.sqrt(np.sum(squared_difference))
    return scores.most_common(50)

def sigmoid(x):
    return 1/(1+np.exp(-x))

correct = 0
total = 0
for rev_i, review in enumerate(input_dataset*iterations):
    for target_i in range(len(review)):
        target_samples = [review[target_i]]+list(concatenated[(np.random.rand(negative)*len(concatenated)).astype('int')]) #выбираем одно истинное слово и 5 рандомных
        left_context = review[max(0, target_i-window):target_i] # слова слева от истинного слова, но не более размера скользящего окна
        right_context = review[target_i+1:min(len(review),target_i+window+1)] # слова справа
        if not left_context and not right_context: continue

        layer_1 = np.mean(weights_1[left_context+right_context], axis=0)
        layer_2 = sigmoid(layer_1.dot(weights_2[target_samples].T))
        layer_2_delta = layer_2 - layer_2_target
        layer_1_delta = np.dot(layer_2_delta, weights_2[target_samples])

        weights_1[left_context+right_context] -= alpha*layer_1_delta
        weights_2[target_samples] -= alpha*np.outer(layer_2_delta, layer_1)
        if np.argmax(layer_2) == 0: correct +=1
        total +=1

    if rev_i%250 == 0:
        print(f"Progress: {rev_i/float(len(input_dataset)*iterations):.4f} TrainAcc: {correct/total:.4f}")

print(similar())
В ходе обучения мы подсчитываем долю правильно угаданных слов. При желании можно дополнительно оценить модель на тестовой выборке. Я же для простоты вывожу точность непосредственно во время обучения.
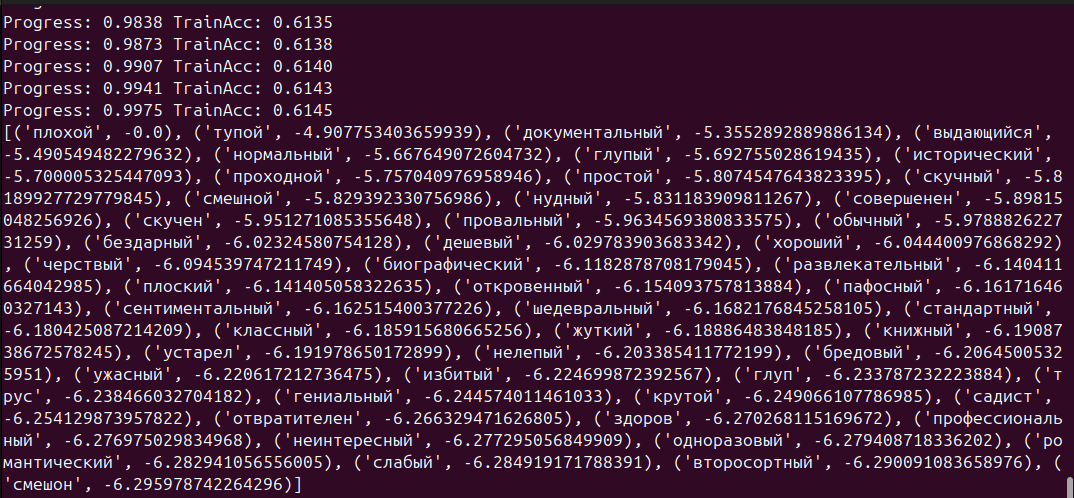
На скриншоте видно, что даже на небольшом датасете точность модели в процессе обучения превышает 61%. При оценке на тестовой выборке она может составить более 70%, что выглядит неплохим результатом для выбора среди предложенных кандидатов.
Здесь я снова вывел слова, которые модель считает похожими на «плохой». На этот раз целевые значения и, соответственно, ошибки были другими, а архитектура сети немного изменилась. В результате изменилась и группировка слов, а вместе с ней — смысл весов. Прежде сеть группировала слова преимущественно по эмоциональной окраске, а теперь — по их употреблению в схожем контексте. Например, эмбеддинги слов «плохой», «тупой» и «глупый» могут располагаться близко в векторном пространстве, а сеть может усвоить, что рядом с ними нередко встречается слово «фильм».
Итак, входные и выходные данные, способ измерения ошибки, архитектура и методы регуляризации влияют на обучение и на то, какие скрытые зависимости обнаружит сеть. Все эти решения вместе определяют постановку задачи обучения, в том числе используемую функцию потерь.
Словесные аналогии
У нейросетей, работающих с текстом, есть интересное свойство: поскольку слова представлены векторами, их можно складывать и вычитать, получая вектор, близкий к другому слову. Известный пример — «король − мужчина + женщина ≈ королева».
Напишем функцию для таких операций. В positive передадим слова, векторы которых нужно сложить («ужасный» и «хороший»), а в negative — слово, вектор которого нужно вычесть («плохой»).
Сначала вычислим длину векторного представления каждого слова. Это евклидова норма — обобщение теоремы Пифагора на многомерное пространство. Получив вектор длин, приведём его к размерности len(vocab) на 1; при суммировании также можно было бы воспользоваться keepdims. Затем разделим веса каждого слова на длину его вектора, чтобы нормировать все векторы до единичной длины.
Далее создадим нулевой вектор, прибавим к нему нормированные векторы слов из positive и вычтем векторы слов из negative. После этого найдём слова, ближайшие к полученному результату.
def analogy(positive=["ужасный", "хороший"], negative=["плохой"]):
    norms = np.sqrt(np.sum(weights_1*weights_1, axis=1)) #считаем длину вектора векторного представления каждого слова
    norms.resize(norms.shape[0], 1)
    normed_weights = weights_1/norms
    query_vect = np.zeros(len(weights_1[0]))
    for word in positive:
        query_vect += normed_weights[word2index[word]]
    for word in negative:
        query_vect -= normed_weights[word2index[word]]

    scores = Counter()
    for word, index in word2index.items():
        raw_difference = normed_weights[index] - query_vect
        squared_difference = raw_difference*raw_difference
        scores[word] = -math.sqrt(np.sum(squared_difference))
    return scores.most_common(10)

print(f"{similar()}\n\n")
print(f"{analogy()}\n")
В результате получаем вполне осмысленный список, в который входят «незабываемый», «замечательный», «удивительный» и «качественный». Можно интерпретировать это так: вычитание вектора слова «плохой» из вектора слова «ужасный» ослабило негативную составляющую, а добавление слова «хороший» сместило результат в область позитивной лексики.
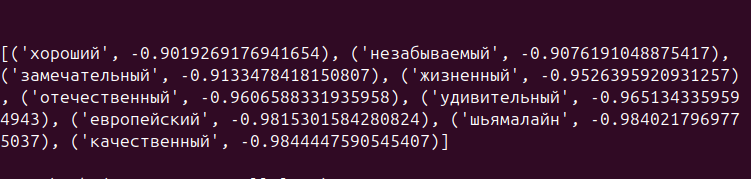
Первое место при этом заняло само слово «хороший», чей вектор участвовал в сложении. Появление в списке слов «отечественный» и «шьямалайн» может быть связано со спецификой датасета: в отзывах на Кинопоиске они встречаются в контекстах, связанных с фильмами.
На этом четвёртая часть завершается. Если у вас возникли вопросы или вы заметили опечатку, пишите в комментариях.
Похожие статьи
 Как мы воссоздали Обнинскую АЭС в браузере и с какими проблемами столкнулись
 Джозеф Нидэм об эволюции и термодинамике
 Проверить, ускоряет ли ИИ работу разработчиков, уже невозможно: без него они работать не соглашаются
 ESP32 для новичков: от логических микросхем до умных устройств
 Создатели правил игры: семь экономистов, изменивших мир
 ИИ воскрешает мёртвых: благо это или зло?
 Мои ИИ-агенты нашли неизвестное поселение майя
 Возможно, мы искали источник сознания не в той области мозга