Основы Deep Learning. Часть 2
Основные этапы работы свёрточной нейронной сети
Приветствую! Это вторая публикация в нашей серии материалов, посвященных фундаментальным основам глубокого обучения. В предыдущей части мы подробно разобрали концепции, крайне полезные для новичков, поэтому настоятельно советую освежить ее в памяти. Сегодня мы детально погрузимся в архитектуру свёрточных нейронных сетей.
Давайте подробно изучим свёрточные нейронные сети (CNN), которые представляют собой результат адаптации классической сетевой структуры под специфические особенности визуальных данных.
Что собой представляет свёрточная нейронная сеть?
Свёрточные сети изначально проектировались для эффективного распознавания образов. Ключевая идея этой архитектуры заключается в создании многоуровневой системы, где начальные слои отвечают за выделение локальных признаков, а последующие — за их интеграцию в более сложные абстракции высокого уровня.
При таком подходе базовая задача классификации образов сводится к обнаружению характерных паттернов, то есть умению фиксировать присутствие определенных визуальных элементов независимо от их точного местоположения на полотне.
Для обеспечения подобной пространственной инвариантности при детектировании признаков в CNN задействуются разделяемые веса (shared weights).
В контексте распознавания образов функционал отдельного нейрона можно трактовать как детектор конкретных визуальных особенностей.
К примеру, нейроны первого скрытого слоя получают на вход совокупность пиксельных интенсивностей и демонстрируют мощную активацию при обнаружении определенной закономерности — локального визуального элемента.
Тот факт, что поведение нейрона детерминировано его весами, означает следующее: два нейрона с идентичным набором весов реализуют абсолютно одинаковую функцию обнаружения признаков.
Если эти нейроны оперируют различными входными областями (рецептивными полями), в совокупности они функционируют как единый детектор для всего доступного пула данных, активируясь при появлении искомого признака хотя бы в одном из фрагментов.
Базовые операции в CNN
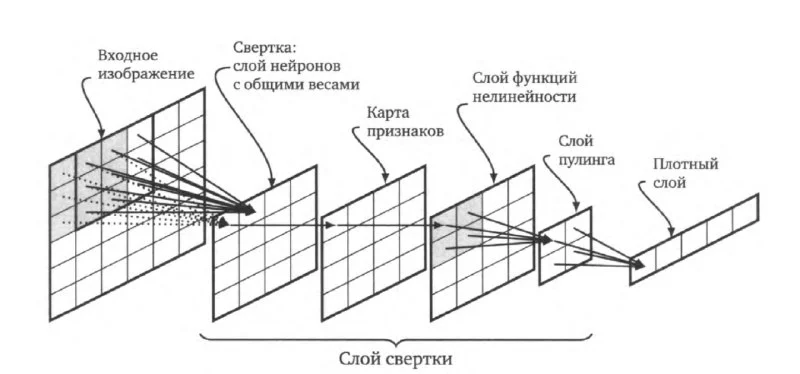
На представленной выше схеме отображены типичные стадии обработки информации, характерные для архитектуры CNN.
Матрица размером 6×6 слева символизирует входное изображение, поступающее в сеть. Справа от нее располагается матрица 4×4, отражающая слой нейронов, которые последовательно сканируют входные данные в поисках заданного локального признака. Каждый элемент соединен со своим рецептивным полем размером 3х3 и применяет к нему единую матрицу весов 3х3.
Здесь рецептивные поля пересекаются, поскольку шаг смещения (stride) равен единице — данный параметр задается разработчиком вручную.
Фактически здесь реализуется операция свёртки: мы циклично применяем идентичную весовую матрицу (ядро свёртки) к различным регионам входного массива. Результатом матричного скалярного умножения является скаляр, записываемый в соответствующую ячейку карты признаков (feature map).
Важно подчеркнуть, что сама по себе операция свёртки линейна и не включает функцию активации — нелинейность внедряется на следующих этапах.
Сразу после формирования карты признаков к ее значениям применяется нелинейная функция активации.
Операция пулинга (субдискретизации)
После того как свёрточный слой успешно выделил базовые паттерны (грани, углы, текстурные особенности), выполняется процедура пулинга.
Каковы функции пулинга?
-
Снижение пространственной размерности карты признаков.
-
Повышение устойчивости модели к незначительным смещениям и геометрическим искажениям.
-
Концентрация внимания на наиболее значимых характеристиках каждой области.
На практике мы разбиваем карту признаков на более мелкие суб-области (окна пулинга). Для каждого такого блока вычисляется либо максимальное значение (Max Pooling), либо среднее (Average Pooling), после чего результаты формируют новую, уменьшенную карту.
Традиционно комбинацию свёртки, функции активации и пулинга называют единым свёрточным слоем. Таких блоков в сети может быть множество, но в конечном итоге архитектура приводит нас к полносвязному (плотному) слою.
Каждый нейрон плотного слоя принимает на вход сигналы от всех элементов предыдущего уровня, именно этот финальный слой и вырабатывает окончательное решение модели.
Практическая реализация свёрточной сети
Процесс начинается с загрузки изображений цифр и соответствующих меток из датасета MNIST. Поскольку этот этап подробно разбирался ранее, останавливаться на нем подробно мы не будем.
Матрица labels хранит в каждой строке (где индекс соответствует номеру изображения) единицу в том столбце, который совпадает с целевым классом. Аналогичным образом структурирован массив test_labels.
Затем мы определяем вспомогательные функции и их производные. Метод np.sum выполняет суммирование вдоль первой оси (индексация с нуля) с сохранением размерности исходного тензора (благодаря флагу keepdims). Если на входе была двумерная таблица, функция просуммирует значения по столбцам и вернет массив формата (n,1), где каждая строка содержит накопительную сумму элементов.
Далее зададим ключевые гиперпараметры. Переменная num_kernels определяет количество независимых фильтров (наборов весов, которыми мы будем последовательно сканировать изображение — в данном случае их 16).
import numpy as np
from keras.datasets import mnist
np.random.seed(1)

(x_train, y_train),(x_test,y_test) = mnist.load_data()
images, labels = (x_train[0:1000].reshape(1000,28*28)/255, y_train[0:1000])
one_hot_labels = np.zeros((len(labels),10))
for i,j in enumerate(labels):
	one_hot_labels[i][j] = 1

labels = one_hot_labels
test_images = x_test.reshape(len(x_test),28*28)/255
test_labels = np.zeros((len(y_test),10))
for i,j in enumerate(y_test):
	test_labels[i][j] = 1

def tanh(x): return np.tanh(x)

def tanh2deriv(output): return 1 - output**2

def softmax(x):
	temp = np.exp(x)
	return temp/np.sum(temp, axis=1, keepdims=True)

alpha, iteration = 0.2, 300
batch_size = 128
pixels_per_image, num_labels = (784,10)

input_rows, input_cols = (28,28)
kernel_rows, kernel_cols = (3, 3)
num_kernels = 16 #количество не нейронов в слое, а количестве различных слоёв свёртки (фильтров)

hidden_size = ((input_rows - kernel_rows +1)*(input_cols - kernel_cols +1)) * num_kernels # кол-во нейронов в слое умножаем на кол-во слоёв свёртки
kernel_weight = 0.02*np.random.random((kernel_rows * kernel_cols, num_kernels)) - 0.01
weight_2 = 0.2*np.random.random((hidden_size,num_labels)) - 0.1
Дальше мы вычисляем hidden_size — совокупное число ядер, обрабатывающих картинку с учетом всех фильтров. Именно такой объем признаков поступит на вход каждому из 10 нейронов полносвязного слоя.
Инициализируем веса ядер случайными значениями в диапазоне от -0.01 до 0.01. В результате матрица kernel_weight будет содержать 9 строк (веса для каждого пикселя рецептивного поля 3х3) и 16 столбцов (отдельные фильтры). Напомню: при свёртке мы применяем один и тот же фильтр ко всем частям изображения, поэтому не нужно использовать разные столбцы весов для разных участков одной картинки — сначала мы полностью проходим изображение одним фильтром, затем следующим.
В завершение инициализируем весовую матрицу для полносвязного слоя размерностью (26*26*16, 10). Каждый нейрон этого слоя принимает активированные выходы от всех фильтров свёрточного слоя.
Функция нарезки изображения на рецептивные поля
Поскольку ядро обрабатывает не все изображение целиком, а лишь локальные фрагменты, напишем функцию для извлечения таких областей.
def get_image_section(layer, row_from, row_to, col_from, col_to):
	section = layer[:,row_from:row_to, col_from:col_to]
	return section.reshape(-1,1,row_to-row_from, col_to-col_from)
Здесь задействованы срезы, формирующие трехмерный тензор, где вдоль первой оси хранятся все изображения пакета с уменьшенными пространственными габаритами. Перед возвратом результата мы меняем форму массива. Аргумент -1 указывает Python самостоятельно вычислить размерность по данной оси (соответствующую размеру батча в 128 элементов), следом добавляется фиктивная ось единичной размерности, а в конце фиксируются размеры самого паттерна (3х3 пикселя).
Прямое распространение (Forward Pass)
Процесс стартует с основного цикла итераций, в рамках которого мы последовательно проходим по всему тренировочному датасету, параллельно отслеживая количество успешных предсказаний модели.
Внутри располагается второй цикл, обрабатывающий данные мини-батчами по 128 примеров.
Мы извлекаем 128 изображений и приводим их к пространственной сетке 28х28, получая тензор формата (128, 28, 28). С помощью ранее созданной функции нарезаем каждое изображение на рецептивные поля 3х3 и собираем их в единый список.
Стоит отметить, что на выходе мы получаем список из 26*26 тензоров (по количеству фрагментов в изображении). У каждого из них нулевая размерность равна 128 (индексы картинок в батче), первая равна 1 (служебный канал для последующей конкатенации), а вторая и третья содержат пиксели паттерна.
Теперь эти фрагменты необходимо объединить так, чтобы все паттерны шли упорядоченно: сначала для первой картинки, затем для второй и т.д. Эту задачу решает вызов np.concatenate(sects, axis=1). Метод склеивает тензоры из списка по первой оси, формируя единую структуру, где по нулевой оси лежат 128 изображений, по первой — 676 (26*26) паттернов каждого изображения, а по остальным — 9 пикселей.
Для удобства вычислений мы преобразуем размерность к виду (128 * 676, 9). Теперь строки соответствуют отдельным рецептивным полям (первые 676 относятся к первому изображению и так далее), а столбцы — пикселям.
Далее мы передаем подготовленные данные в свёрточный слой, умножая матрицу паттернов (128*676, 9) на веса ядер (9, 16), и применяем функцию активации tanh. Следом меняем форму тензора перед передачей в полносвязный слой, получая матрицу с 128 строками (картинки) и взвешенными суммами в столбцах. Для борьбы с переобучением внедряем регуляризацию Dropout.
for j in range(iteration):
	corrent_cnt = 0
	for i in range(int(len(images)/batch_size)):
		batch_start, batch_end = (i*batch_size, (i+1)*batch_size)
		layer_0 = images[batch_start: batch_end]
		layer_0 = layer_0.reshape(layer_0.shape[0],28,28)
		sects = list()
		for row_start in range(layer_0.shape[1] - kernel_rows +1):
			for col_start in range(layer_0.shape[2] - kernel_cols +1):
				sect = get_image_section(layer_0,row_start,row_start + kernel_rows, col_start, col_start+kernel_cols)
				sects.append(sect)
		expanded_input = np.concatenate(sects,axis=1)
		es = expanded_input.shape
		flattened_input = expanded_input.reshape(es[0]*es[1],-1) #получили матрицу 676*128 на 9 где строки номера отрезков картинок а столбцы пиксели и первые 676 относятся к первому изображению и тд
		kernel_output = flattened_input.dot(kernel_weight) #получили 676*batch_size на 16 где по строкам взвешанная сумма для конкретного поля а столбцы фильтр
		layer_1 = tanh(kernel_output.reshape(es[0],-1)) #сделали матрицу где строки 128 картинки а столбцы значения взвешенных сумм
		droupout = np.random.randint(2, size=layer_1.shape)
		layer_1 *= 2*droupout
		layer_2 = softmax(layer_1.dot(weight_2))

		for k in range(batch_size):
			labelset = labels[batch_start+k:batch_start+k+1]
			_inc = int(np.argmax(layer_2[k:k+1]) == np.argmax(labelset))
			corrent_cnt += _inc
На выходе первого слоя формируется матрица формата (128, 676*16).
Затем вычисляем отклик полносвязного слоя. Перемножаем выходы первого слоя layer_1 на веса second layer, получая матрицу (128, 10), где строки соответствуют изображениям, а столбцы — вероятностным оценкам классов (например, первый столбец показывает степень уверенности модели в том, что на картинке единица). Применяем функцию Softmax и подсчитываем количество успешных классификаций.
Обратное распространение ошибки (Backpropagation)
Начнем с вычисления градиента (дельты) для выходного слоя. Поскольку в качестве функции потерь используется перекрестная энтропия (cross-entropy), дельта выражается как разность предсказания и истинного значения (a — t). Как и ранее, для усреднения градиентов по батчу мы делим результат на размер пакета.
В результате получаем 128 векторов дельт для каждого из 10 нейронов. Далее рассчитываем дельту для первого слоя: это взвешенная сумма дельт последующего слоя, умноженная на транспонированную матрицу весов, и все это поэлементно умножается на производную активационной функции da/dz для свёрточного слоя.
Не забываем учесть маску Dropout и обновляем веса с помощью метода градиентного спуска. Для полносвязного слоя обновление весов представляет собой транспонированную матрицу выходов первого слоя, умноженную на дельту выхода.
Здесь мы транспонируем layer_1, поскольку на второй слой поступало 128 векторов размерности 26*26*16, что позволяет корректно перемножить выходы нейронов на дельты. В итоге получается матрица (26*26*16, 10), причем дельта автоматически оказывается усредненной за счет предварительного деления на размер батча.
Самая сложная часть — корректное распределение градиентов обратно по свёрточным ядрам, поскольку исходные пиксели были перемешаны в процессе нарезки на паттерны.
layer_2_delta = (layer_2 - labels[batch_start:batch_end])/batch_size
layer_1_delta = layer_2_delta.dot(weight_2.T)*tanh2deriv(layer_1)
layer_1_delta *= droupout

weight_2 -= alpha*np.dot(layer_1.T,layer_2_delta)
#l1d_reshape = layer1_delta.reshape(kernel_output.shape)
# es[0] - батч (128), es[1] - количество патчей (676)
l1d_reshape = layer_1_delta.reshape(es[0], es[1], num_kernels).reshape(-1,num_kernels)
k_update = flattened_input.T.dot(l1d_reshape)
kernel_weight += alpha*k_update
Тестирование модели после каждой эпохи обучения
Проведем валидацию созданной модели, не забыв деактивировать Dropout на этапе тестирования.
test_correct_cnt = 0
for i in range(len(test_images)):
	layer_0 = test_images[i:i+1]
	layer_0 = layer_0.reshape(layer_0.shape[0],28,28)
	sects = list()
	for row_start in range(layer_0.shape[1] - kernel_rows +1):
		for col_start in range(layer_0.shape[2] - kernel_cols +1):
			sect = get_image_section(layer_0,row_start,row_start + kernel_rows, col_start, col_start+kernel_cols)
			sects.append(sect)
	expanded_input = np.concatenate(sects, axis=1)
	es = expanded_input.shape
	flattened_input = expanded_input.reshape(es[0]*es[1],-1)
	kernel_output = flattened_input.dot(kernel_weight)
	layer_1 = tanh(kernel_output.reshape(es[0],-1))
	layer_2 = softmax(layer_1.dot(weight_2))
	test_correct_cnt += int(np.argmax(layer_2) == np.argmax(test_labels[i:i+1]))
print(f"I{j}: Test-acc: {test_correct_cnt/float(len(test_images))} Train-acc: {corrent_cnt/float(len(images))}")
В результате наша сеть преодолевает планку в 86% точности на тестовом датасете уже на 14-й итерации.
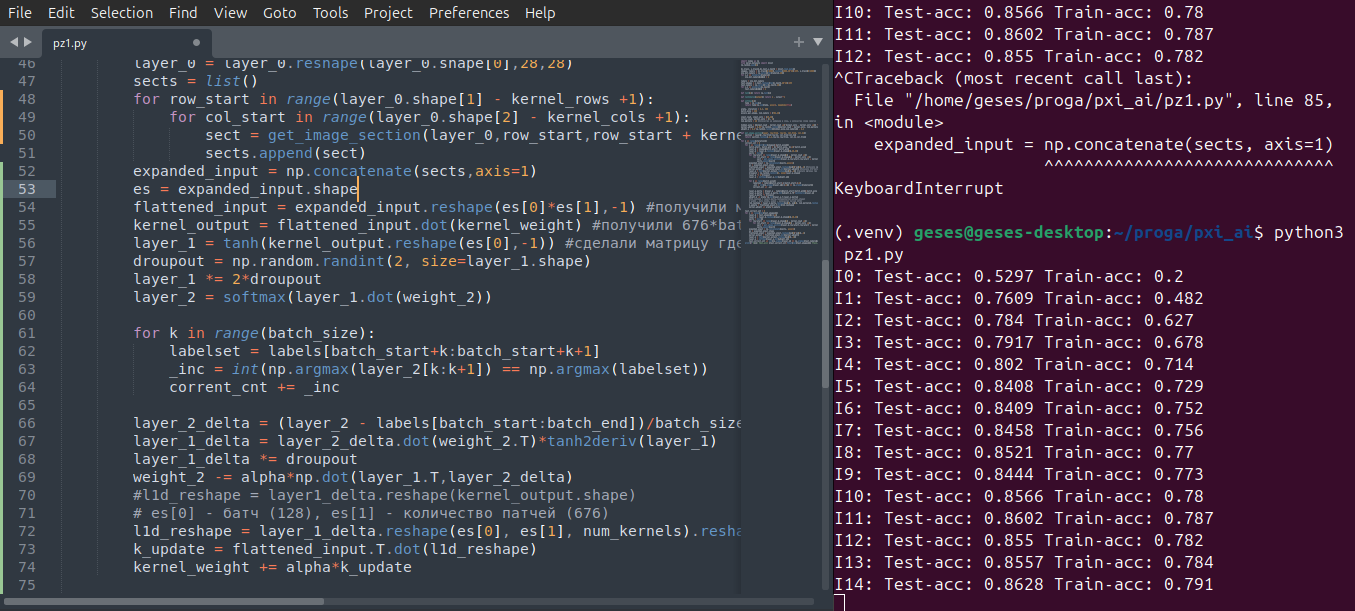
Стоит отметить, что данный код является учебным примером, производительность и структуру которого можно существенно оптимизировать. Например, валидацию и подсчет метрик вовсе не обязательно выполнять попроцедурно для каждого изображения. Используйте этот фундамент как трамплин для собственных экспериментов!
Делитесь в комментариях найденными неточностями и задавайте вопросы. Ждете ли вы выход третьей части?
Похожие статьи
 Технический дайджест Хабра: главное за октябрь 2026 года
 Сколько лет Хэллоуину?
 Космический малыш, оставшийся на Марсе
 Как я написал свою первую научную статью в LaTeX с помощью ИИ-агента всего за полдня
 Элитный суперстрат Cort G280 Select
 Заброшенные станции и тоннели метро
 Как детекторы искусственного интеллекта разрушают высшее образование
 Математика апокалипсиса: почему мы обречены на самоуничтожение и можно ли это предотвратить?