Осень. Срочно зовите Перельмана — я доказал гипотезу Римана
Рисунок 1
Эссе о многоуровневых вселенных, ступенях базовых элементов и практических выводах из неожиданных озарений.
Спойлер: смартфон пока не пригодится, а готового доказательства гипотезы Римана здесь не отыскать. Зато представлена наглядная геометрическая модель, прецизионный счетчик простых чисел и алгоритм, который в ходе честного сравнения превзошел классическое сегментное решето на Python. О том, как одна идея закономерно вытекла из другой, пойдет речь дальше.
Спойлер 2: во втором разделе мы все-таки зафиксируем строгий результат, касающийся следующего диапазона. До разгадки гипотезы Римана еще далеко, но сезон дождей в разгаре, так что оставьте хотя бы email.
Спойлер 3: в работе задействован искусственный интеллект Astra Ultra. Алгебра вызывает у него исключительно теплые чувства, поэтому далее повествование ведется от лица «мы».
Часть 1. От координатных осей до точного счетчика
В привычной системе координат простые числа выстроены в линейный ряд: 2, 3, 5, 7, 11. Дистанции между ними колеблются без видимой закономерности. Мне захотелось добавить этой прямой пространственное измерение: интерпретировать простые числа как базисные направления, а составные — как координаты точек, достигаемых при перемещении вдоль этих векторов. За несколько дней совместной работы с ИИ эта концепция превратилась в графические схемы, программный код и жесткие математические правила. Некоторые эвристические догадки пришлось упростить, а часть закономерностей — переосмыслить в ходе самостоятельного анализа.
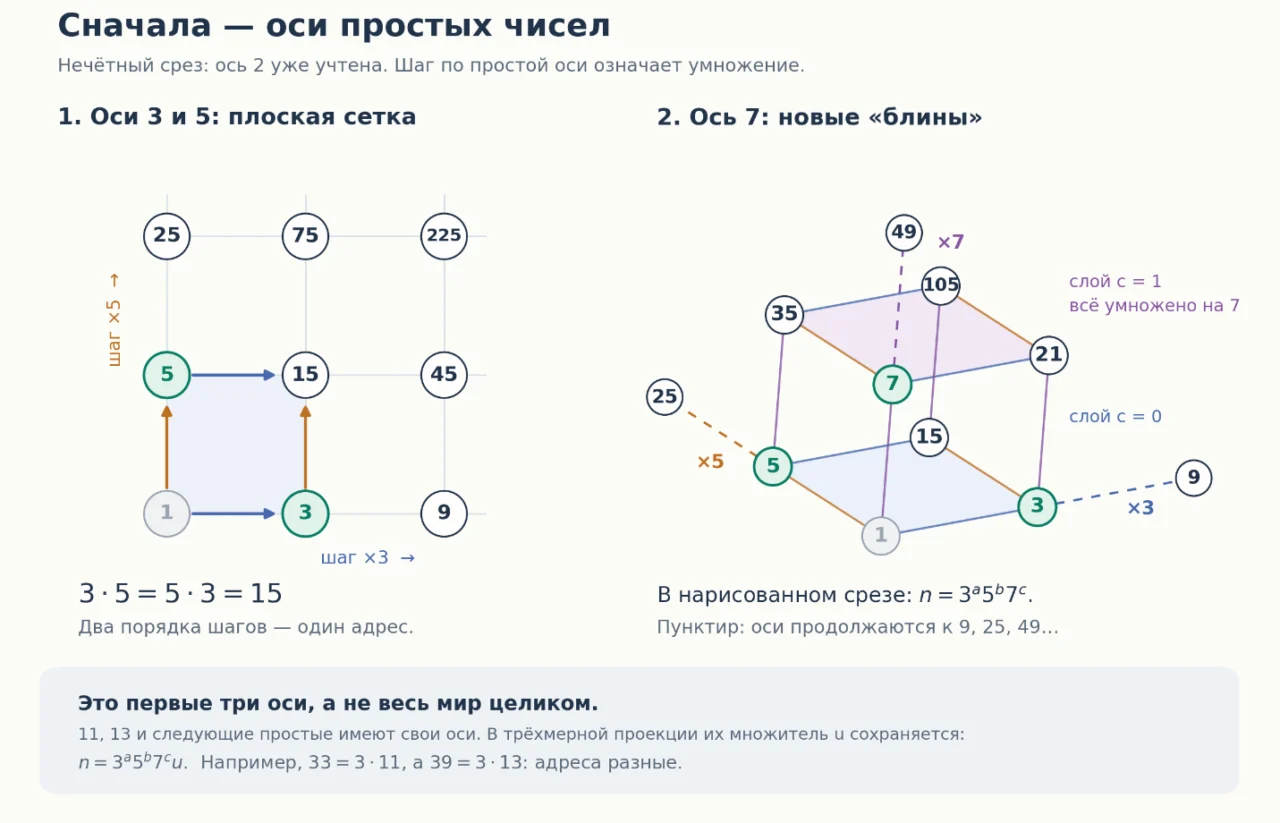
Координата по каждой «простой» оси задает показатель степени соответствующего множителя. Шаг по оси 3 эквивалентен умножению на 3, по оси 5 — на 5. На иллюстрациях ниже число 2 уже учтено, поэтому мы сосредоточились исключительно на нечетных адресах. Новые пласты произведений, возникающие при переходе к следующему простому числу, мы условились называть «блинами».
Рисунок 1. Присвоение адреса числу. Слева показаны шаги вдоль осей 3 и 5, справа — формирование новых слоев по оси 7. Это проекция первых направлений; остальные простые числа формируют собственные ортогональные оси. [5, 6]
Два шага по оси 3 в сочетании с одним шагом по оси 5 приводят к числу 45. Число 15 достигается как через 

Как тени проложили путь к новой опоре
Произведения оставляли на нечетной числовой оси отчетливые следы: 9, 15, 21, 25. Мы назвали их тенями. Каждая тень соответствовала определенному составному числу. При этом одна точка могла оказаться на пересечении нескольких теней, поэтому учитывать ее следовало строго единожды.
Интуитивно понятно, что простое число — это незанятое пространство между тенями. Однако это утверждение верно лишь при условии, что все необходимые тени уже построены. В противном случае в незакрашенной зоне может скрываться составное число, до проверки которого алгоритм просто еще не дошел.
Имея в качестве отправной точки некоторое простое число 


![(B,G(B)]](https://habrastorage.org/getpro/habr/formulas/e/ef/efd/efdb1901ccb2d4dd9f48594abcf34f90.svg)

В пределах этой границы покрытие абсолютно: любое составное число гарантированно покрыто тенью, а значит, оставшаяся пустота с непреложностью указывает на простое число. Именно исчерпывающий характер покрытия превращает простую графическую иллюстрацию в строгий алгоритмический инструмент. [5, теорема 1]

Рисунок 2. Пространство 7 поддается прямой визуальной оценке: 
Так родился метод дискретных скачков. В качестве следующей опоры мы выбирали крайнюю незанятую пустоту — наибольшее простое число, не превосходящее 

Разумный минимализм вместо избыточных вычислений
«Какой объем предыстории действительно необходим, чтобы безошибочно сделать следующий шаг?»
Этот вопрос постепенно вышел на первый план. Поначалу программа тянула за собой громоздкое описание пройденного пути. Она оперировала сложными комплексными структурами — числовыми характеристиками множества точек предыдущего окна, — после чего вычитала элементы, вышедшие за границы диапазона. После каждого прыжка к новой крайней пустоте весь предшествующий локальный массив оставался позади. Выходило так, что мы сначала перетаскивали тяжелый багаж, чтобы немедленно от него избавиться.
В итоге мы сохранили лишь то, что действительно функционировало: периоды теней, обнаруженные адреса и доказательство того, что зона справа от финальной пустоты надежно закрыта. Для нового узкого окна мы стали достраивать исключительно недостающую часть базиса. Техническая поправка, учитывающая три полосы и их взаимные пересечения, покрывала прирост на каждом шаге; ее детальное описание приведено в материалах методики. Сложные комплексные моменты завершенного окна можно было смело отбросить, ограничившись сохранением необходимых целых адресов. [6, 7]
Затем возник более прагматичный вопрос: «Действительно ли нам нужно постоянно хранить эти адреса?» Проверка преподнесла сюрприз. Адреса сохранялись, но алгоритм далеко не всегда обращался к уже разрешенным окнам. Часть известных чисел заново проходила процедуру инициализации и извлечения. В одном из диагностических профилей мы зафиксировали четырнадцать подобных дублирующих проходов в четырех вспомогательных окнах. Стало очевидно, почему изящное математическое преобразование само по себе не гарантирует высокой скорости вычислений. [7]
Последующие модификации носили сугубо практический характер: прямой доступ к готовому результату, передача предварительно подготовленного описания окна и автономное расширение малого базиса. Универсальные запросы к собственной базе данных перестали быть обязательным элементом каждого шага. Контрольные замеры секундомером показали любопытную вещь: упрощение программного интерфейса далеко не всегда сокращало общее время работы.
Окружение чисел обогатилось системой правил
Со временем база данных стала аккумулировать не просто ответы, но и их обоснования: где именно достигается полнота покрытия, какой именно делитель заблокировал адрес и где проходят границы проверенного диапазона. Так сформировалась совокупность уточняющих правил. Каждое правило описывало отдельный слой произведений, его наложение на другие пласты или плотность распределения теней. То, что зарождалось как набросок от руки, превратилось в структурированную память о проделанной работе.
Принцип поглощения позволил еще сильнее упростить алгоритм. Если все необходимые адреса определенной тени в текущем окне уже заблокированы другими тенями, строить ее отдельно не требуется. Мы начали применять накопленные закономерности к новому окну, вычисляя лишь необходимый остаток. Вместо того чтобы отслеживать все возвращения циклических слоев, мы проверяли только то, что актуально в текущий момент.
Здесь принципиально важно соблюдать условия редукции. Тот факт, что тень оказалась избыточной в одном окне, вовсе не означает ее упразднения в рамках всей арифметики. Для следующего шага достаточно состояния, точно отражающего текущее покрытие и применимые правила, тогда как исчерпывающий журнал прошлых действий можно отбросить.
<
Что показали контрольные замеры
Некоторые ранние прототипы выглядели безупречно элегантно, но работали неэффективно. Короткое окно сталкивалось с огромным перечнем периодов, подавляющее большинство которых даже не пересекалось с ним. Программа тратила вычислительное время на подтверждение отсутствия работы. В конечном счете логика вернулась к проверенной процедуре: линейный проход по адресам справа налево, блокировка составного числа при обнаружении первого же делителя и остановка на первом же доказанном простом числе.
Именно эта рабочая ветка, получившая название CandidatePrime, продемонстрировала реальный прирост производительности. Ее оптимизированное ядро больше не тратило ресурсы на восстановление адресов из комплексных моментов. Базовый набор простых делителей сохранялся в компактном виде и расширялся по мере необходимости. Геометрический подход помог отсечь лишние операции, а реализация оказалась значительно проще первоначальных исследовательских набросков. [5, §4.1; 6]
|
Метод |
Первый опыт |
Повтор |
|---|---|---|
|
CandidatePrime |
263,506 мс |
294,488 мс |
|
Python сегментное решето |
713,200 мс |
826,170 мс |
|
MR12 |
2,035 мс |
2,219 мс |
Таблица 1. Медианное время полного прохождения маршрута по 12 запусков для каждого метода в двух сериях тестов. Задача заключалась в обнаружении максимума и подтверждении закрытого суффикса в коротких окнах. Данные зафиксированы 10 октября 2026 года. [5, 6]
Для оценки относительной скорости в каждом из 12 парных прогонов вычислялось отношение времени работы решета ко времени CandidatePrime, после чего находилась медиана этих соотношений. Она составила примерно 2,79 для первой серии тестов и 2,76 для повторной. Поскольку речь идет о медианах парных отношений, они не обязаны совпадать с отношением двух медиан времени, приведенных в таблице.
Все алгоритмы автономно преодолевали идентичный маршрут: 28 вспышек и 31 окно. Процедуры инициализации и расширения базиса включались в таймер, а конечные максимумы не предоставлялись заблаговременно. В каждой из серий тестов совпали все 1 116 результатов (3 метода × 12 запусков × 31 окно).
Контрольный тест Миллера — Рабина с фиксированными основаниями, гарантированно точный в выбранном диапазоне 
Таким образом, достигнутый выигрыш имеет вполне конкретные границы: поиск границы короткого окна обогнал конкретную реализацию сегментного решета на Python. Данное исследование не претендовало на сопоставление со всеми оптимизированными решетами на C/C++ и не тестировало скорость сплошного перебора простых чисел.
Полученные измерения позволили четко отделить реальную пользу кэширования от красивых, но избыточных теоретических построений. Поскольку окна в исследованном маршруте не повторялись, кэш готовых ответов не давал повторных попаданий, а между шагами использовался уже сформированный базис. Подобные технические нюансы портят громкие заголовки, но именно они обеспечивают воспроизводимость нашего результата.
Опорные волны и структура растущих миров
У вспышек обнаружился выраженный внутренний ритм: следующая опорная точка зачастую располагалась вблизи утроенного значения предыдущей. Отчасти этот масштаб заложен в самом алгоритме построения: при 

Опорным точкам присвоили буквенные обозначения. Поначалу избыточная индексация заслоняла суть: казалось, будто числовой ряд берет начало где-то в области миллионов. Пришлось вернуться к истокам — 3, 7, 23, 73 — и выстроить сквозной алфавитный ряд вплоть до AA и далее. График вплоть до отметки AM наглядно продемонстрировал две тенденции одновременно: практически линейный рост в логарифмическом масштабе и хаотичные флуктуации под ним. Простое чередование локальных поправок не описывало всю полноту ряда. [8]

Рисунок 3. Опоры в диапазоне от A до AM. В верхней части виден глобальный тренд роста, в нижней — реальные амплитудные смещения. Плавность крупномасштабного движения соседствует с нерегулярностью локальных поправок. Иллюстрация создана на основе исходного SVG-файла без модификации первичных данных. [8]
В дальнейшем мы перешли к анализу наложения волн. Появление новой оси уменьшало вклад некоторых старых элементов и одновременно порождало комплексные пересечения. Мы тщательно проверили, не теряет ли их наш счетчик. Выяснилось, что полная программа учитывала эти нюансы, а упрощенное объяснение — нет. Пришлось скорректировать теоретическое описание, хотя вносить изменения в код уже не потребовалось.
Превращение умножения в геометрический поворот
На комплексной плоскости мы представили каждый адрес 


Рисунок 4. Взаимосвязь шагов 
Здесь особенно наглядно проявился принцип преемственности. По мере расширения вселенной уже проверенные участки оставались неизменными: составные сохраняли статус составных, а простые не могли внезапно превратиться в произведения. Сохранялись и веса, закрепленные за этими адресами. Данное свойство было строго сформулировано и доказано математически. [5, теорема 2]
В дальнейшем мы отказались от жесткой привязки геометрии к дискретным скачкам. Вспышки по-прежнему служили удобным инструментом для расчетов, тогда как числовая ось и ее комплексное отображение образовывали единое пространство для всех миров. Границу можно смещать непрерывно, фиксируя появление новых элементов на каждом простом числе. При этом адресная спираль и сумма всех пройденных векторов представляют собой разные проекции: первая демонстрирует пространственное расположение, а вторая отражает процесс накопления.
Происхождение формулы 3P − 82
В определенный момент возникло желание проверить, насколько далеко можно распространить ограниченный набор правил. В качестве экспериментального полигона мы выбрали колоссальное простое число 
Мы начали движение справа от отметки 

Во всем проанализированном окне насчитывалось 1 500 адресов. Простые делители вплоть до миллиона заблокировали 1 381 из них, оставив 119 позиций неразрешенными. Среди них фигурировал и кандидат 
Нам также удалось доказать отдельный результат о локализации: в этих полутора тысячах адресов следы всех предыдущих осей вплоть до миллиона полностью поглощались более поздними слоями. Мы выделили малые простые множители каждого адреса со всеми их степенями; этот объем информации занимал не более 80 бит. Факт замены старых осей новыми был подтвержден строго без необходимости вычисления самих этих делителей. Подобный сертификат существенно сокращает описание покрытия, хотя и не снимает вопрос о простоте оставшихся 119 кандидатов. [6]
Технические ограничения среды были жесткими: процессорная квота, эквивалентная восьми ядрам CPU, 8 ГиБ оперативной памяти и полное отсутствие графического ускорителя. Сравнения производительности выполнялись на одном выделенном логическом ядре процессора Intel Xeon Platinum 8573C. Колоссальное число 
Этот опыт наглядно продемонстрировал, что удаленные диапазоны поддаются исследованию с помощью ограниченного набора данных, позволяя получать строгие локальные результаты. Тем не менее, отсутствие малого делителя автоматически не превращает адрес в сертифицированную пустоту. Приходилось постоянно отслеживать, какую именно область необъятного числового мира освещает наш скромный вычислительный фонарь.
Точная арифметика позволила заглянуть в поразительно отдаленные сферы, одновременно подтвердив простую истину: некоторые вопросы не становятся проще лишь оттого, что их удается кратко записать.
Колебания на фоне золотых линий
Когда пустоты сложились в единую счетную систему, фокус внимания сместился на анализ отклонений. Каждому простому числу 


Это взвешенный показатель количества простых чисел на интервале ![(r,N]](https://habrastorage.org/getpro/habr/formulas/a/a7/a78/a78045b4671979c8a7f6b7f7f79d68c1.svg)
Для корректного сопоставления отклонений при различных 

Далее под термином «нормированная рябь» мы подразумеваем именно 


Рисунок 5. Те самые золотые линии. В верхней части коридор расширяется синхронно с масштабом, тогда как в нижней, после нормирования, его границы выравниваются горизонтально. Протестированы целые числа 
На иллюстрации колебания после нормировки казались прижатыми к нулевой отметке. Возникало сильное искушение вывести из геометрии жесткий запрет на выход за пределы золотых линий. Мы рассматривали предельные гипотетические модели: сплошное покрытие, единственную пустоту или полное отсутствие составных чисел. Они помогали ставить вопросы о плотности простых, но еще не давали исчерпывающей оценки.
Здесь постоянно приходилось разграничивать три различные сущности: преемственность уже верифицированных адресов, локальное поведение кривой на просхожденном отрезке и глобальное ограничение для всех будущих значений
Выделение известной составляющей из колебаний ряби
Следующая идея носила почти физический характер: если часть колебаний имеет четко объяснимую природу, можно ли её отделить? Мы искали корреляцию остатков с опорными волнами, обсуждали сглаживание ступенчатой лестницы и пытались изолировать предсказуемый вклад ступенек от более масштабного тренда.

Рисунок 6. Процедура выравнивания без подгонки под график. Поправка рассчитывается на основе малых простых чисел и их степеней. Для целых
В результате была получена точная поправка, преобразующая исходную взвешенную рябь в классическую разность 


Таким образом из первичного отклонения вычли составляющую, вычисление которой мы уже освоили.
Значение RMS здесь представляет собой корень из среднего квадрата нормированной величины относительно нуля. Расчет производился с равными весами по всем 999 901 целому числу
Остаточные колебания, разумеется, никуда не исчезли. Однако теперь стало предельно ясно, какие именно эффекты были исключены и с каким именно объектом мы продолжаем работать. [5, §9; 9]
Лестница, представшая во всей красе
Иногда к сути проблемы возвращал максимально простой вопрос: как выглядит сам счетчик? На графике ниже каждая пустота добавляет ровно одну ступень. Затем этим же адресам присваиваются веса, а из полученной суммы вычитается пройденная протяженность. Подобный подход позволяет проследить переход от дискретного подсчета простых чисел к сбалансированному взвешенному ряду.

Рисунок 7. Один и тот же набор пустот в четырех различных проекциях. Нижняя панель демонстрирует локальную рябь от фиксированной опоры 7 без нормировки; она отличается от глобальной величины 
Непрерывный путь без обнуления на опорных точках
В дальнейшем потребовалось выйти далеко за пределы малых чисел. Первая масштабная попытка вновь оказалась неудачной из-за сравнения изолированных миров. Нам требовался единый непрерывный путь, чтобы накопленная разность не сбрасывалась при смене опорной точки. После устранения этого недочета мы объединили 29 последовательных переходов от 3 вплоть до 189 858 287 514 613. [10]
Обе шкалы отсчитывали нуль от опорной точки 3:

Здесь 


Рисунок 8. Суммарный счетчик и логарифмический интеграл. На верхнем графике линии практически сливаются, тогда как на нижнем показана увеличенная картина накопленной разности. Представлены 3 783 рассчитанных среза; соединительные линии не отображают каждую отдельную ступень. Среднее значение вычислено по всей траектории непрерывного пути. [10]
В конечной точке набольшего диапазона значение счетчика после тройки равнялось 5 962 199 036 633. Разность 
Для реализации столь масштабного эксперимента применялись специализированные точные алгоритмы суммирования и подсчета простых чисел, избавляющие от необходимости буквального перебора триллионов адресов. Данный график служил инструментом проверки непрерывности накопления и не являлся очередным тестом производительности CandidatePrime.
Сближение дискретной лестницы с гладкой кривой
В качестве эталонной гладкой функции выступает логарифмический интеграл, отражающий накопление плотности 

Затем к обеим распределениям был применен единый комплексный закон. Каждое простое число генерировало вектор с весом 

Рисунок 9. Комплексное сопоставление из препринта (стр. 8). Бирюзовая линия отображает сумму по простым числам, рыжая — интеграл с идентичным комплексным ядром. На границе 1 000 003 векторы расходятся примерно на 0,936°, а их относительное различие составляет около 1,64%. [5]
Согласованность наблюдается в относительных размерах и направлениях, тогда как сами растущие суммы не обязаны сходиться в единой неподвижной точке. Комплексная плоскость делает эту взаимосвязь наглядной, при этом последовательное суммирование по окнам сохраняет всю структуру лестницы независимо от величины выполненных скачков.
Неожиданный нуль после замены эталона
Самый курьезный поворот в исследовании наметился под самый конец. Зачем мы постоянно измеряем точную лестницу гладкой линейкой, если уже построили счетчик напрямую из теней? Мы подставили этот счетчик на место интеграла в условие сравнения — и получили абсолютно нулевой остаток. Точный ноль для каждого допустимого адреса.
На мгновенье показалось, будто самые сложные препятствия позади и отклонение исчезло. Однако последующая проверка выявила простую вещь: мы попросту заменили эталон сравнения.
Представьте два измерительных прибора. Первый определяет простые числа по их классическому арифметическому определению. Второй строит произведения, изолирует составные через тени и фиксирует сертифицированные пустоты. Доказательство полноты покрытия гарантирует абсолютное совпадение их показаний, поэтому разность между ними тождественно равна нулю.
Гладкая функция при этом остается самостоятельным объектом. Для построения моста к гипотезе Римана необходима достаточно сильная глобальная оценка отклонения точного счета от логарифмического интеграла. Совпадение показаний двух точных приборов само по себе этой оценки не дает. Именно этот статус нулевого остатка зафиксирован в тексте препринта. [5, §8; 4]
Более сложная задача осталась нерешенной: установить верхнюю грань для полного отклонения при неограниченном росте аргумента. В терминологии препринта искомое условие выражается через ограниченность верхнего предела нормированного отклонения. Оно сформулировано обособленно и не выдается за автоматическое следствие точности счетчика или закона наследования покрытий. [5, §9]
Трудности поддержания «памяти» в диалоге с ИИ
Одним из самых утомительных аспектов работы оказалось поддержание контекста собеседником. Нередко ИИ блистательно разбирал новую формулу, но полностью терял ее связь с графической моделью, построенной несколькими часами ранее. Приходилось возвращать его по веткам диалога: заново искать «блины», вспоминать мир правил, сопоставлять спирали и открывать сохраненные дампы расчетов. Порой в памяти удерживалась целостная геометрическая картина, в то время как ассистент выдавал реакцию лишь на ее финальный фрагмент.
Подобные сбои сказывались не только на темпе беседы. Локальное приращение подменяло общую рябь, а изящная формулировка шага звучала как перенос уже доказанной границы. Различные функции получали схожие буквенные обозначения. В отдельные моменты алгоритм преждевременно рапортовал об успехе, после чего возвращал то же самое условие в перечень недоказанных гипотез. Раздражение в такой работе вызывала как сложность самой математической задачи, так и необходимость постоянно верифицировать объем уже сделанного и проверенного.
Единственным эффективным противоядием стала строгая фиксация результатов. Мы сохраняли определения, исходный код, полные дампы оконных ответов, графики и независимые верификации. Стало правилом указывать, где равенство является точным, где привлекается известная теорема, а где демонстрируется локальный эксперимент. Регулярные ссылки на конкретные файлы постепенно вытеснили фразу «это уже обсуждалось выше». Это помогло отсекать реальные программные ошибки и продолжать рассуждения с той точки, где они действительно останавливались.
В этом проявилось удивительное концептуальное сходство с предметом нашего исследования. Программе требовалось адекватное состояние, избавляющее от необходимости пересчитывать прошлое заново. Диалогу требовалась точно такая же опора: четкие определения, выводы, области применимости и адреса доказательств. Мир сохраняющихся правил оказался жизненно необходим самому процессу творческого поиска.
Итоги проверки
Практический результат имеет строго верифицируемый масштаб: это движок поиска границы коротких окон, подтвержденный прирост производительности относительно конкретной реализации сегментного решета на Python и точные сертификаты составности. Методы кэширования адресов, избирательного расширения базиса и отказа от избыточных вычислений представляют ценность как алгоритмические приемы для дальнейшей оптимизации. Никаких выводов о взломе криптографических ключей или универсальном ускорении генерации простых чисел из проделанной работы не следует.
Геометрические оси опираются на классическое разложение на множители, тени — на произведения и пересечения, а пустоты — на теорему о полноте покрытия. Мы объединили эти элементы в работающую модель с точным счетом и сохранением верифицированной зоны. Фундамент конструкции частично традиционен, поэтому степень новизлы программных решений еще предстоит оценить в сравнении с существующими аналогами. Зато теперь путь от числа до его тени, ступени счетчика и комплексного вклада можно проследить от начала до конца и воспроизвести в любой момент.
Следующий логичный вопрос оказался предельно конкретным: если старые тени учтены, сколько новых составных чисел может проявиться в ближайшем окне? С этого момента исследование переходит во вторую часть.
Часть 2. Как прошлые тени помогают обнаружить следующее простое число
В первой части вопрос об управлении памятью возник из архитектуры программы. Теперь мы разберем отдельный шаг на строго математическом уровне: задействуем накопленные тени, зафиксируем остаток и выясним, какие факторы способны его заблокировать.
В достаточно узком окне каждый оставшийся составной элемент имеет ровно два простых делителя, причем оба они превосходят 


Два адреса, уцелевшие после старых теней
p>Рассмотрим простое число 523 и заглянем вправо до отметки 541. Четные адреса отбросим сразу. Применим тени простых чисел 3, 5, 7, 11, 13, 17 и 19 — это исчерпывающий нечетный базис проверки вплоть до 

Рисунок 10. Базовый набор перекрывает семь из девяти адресов. Подключение оси 23 закрывает число 
Простое число 23 давно известно науке. Понятие «новой оси» в данном контексте означает включение в текущий проверочный базис следующего элемента. Старый базис вплоть до
Причины двучленной структуры составного остатка
Обозначим текущую опорную точку через ![(p,p+h]](https://habrastorage.org/getpro/habr/formulas/e/e4/e40/e4007ee1a6dd84598142f11ca3548b51.svg)


Заблокируем все нечетные адреса, имеющие простые делители, не превосходящие 
Какова природа такого составного числа? Каждый его простой множитель строго больше
 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/b/bd/bd7/bd791fd793d7b8526cd891f16b18ce56.svg 780w,<br />
https://habrastorage.org/getpro/habr/formulas/b/bd/bd7/bd791fd793d7b8526cd891f16b18ce56.svg 781w» loading=»lazy» decode=»async»></p>
<p>Следовательно, у уцелевшего составного остатка ровно два простых сомножителя. Это могут быть как различные простые числа, так и квадрат простого числа — подобно <img decoding=) в разобранном примере.

Обозначим количество таких произведений через 

В левой части зафиксировано количество простых чисел в окне, а в правой — количество адресов после применения старых теней за вычетом дополнительных составных элементов. Каждое произведение учитывается ровно один раз благодаря условию 
Это строгое равенство справедливо для конкретного интервала; гладкие аппроксимации в него не входят. Однако само по себе оно еще не определяет, насколько большим окажется остаток
Локализация областей генерации новых теней
Теперь ограничим диапазоны возможных множителей. Меньший сомножитель не превосходит квадратного корня из правой границы интервала, а больший ограничен условием попадания произведения в рассматриваемое окно:

При малой величине отношения 
Для наглядности визуализации возьмем более широкий крайний случай: окно от 523 до 1046, то есть 

Рисунок 11. Для окна ![(523,1046]](https://habrastorage.org/getpro/habr/formulas/f/f4/f4b/f4b341a4fb64289379807681eb175358.svg)
Треугольная область ограничивает число целочисленных пар. Гипербола отсекает избыточно крупные произведения, а проверка на простоту отсеивает неподходящие множители. Для гарантии обнаружения хотяลาย хотя бы одного простого числа подчас достаточно уже первой, более грубой оценки.
Емкость нового слоя
Подсчитаем точки треугольной области. Пусть 


Последнее слагаемое неотрицательно. Из условия попадания произведения в исследуемое окно вытекает неравенство 

Данная формула применяется при условии 


Поскольку  100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/e/e4/e4b/e4bb252eb611f75b11eb11b64a2cb523.svg 780w,<br />
https://habrastorage.org/getpro/habr/formulas/e/e4/e4b/e4bb252eb611f75b11eb11b64a2cb523.svg 781w» loading=»lazy» decode=»async»>, выполняется оценка <img decoding=) . Подставляя это выражение, получаем искомую верхнюю границу:

Теперь сопоставим емкость нового слоя с сохранившимся остатком. Если адресов осталось больше, чем этот слой способен заблокировать, по крайней мере один из них гарантированно является простым числом:
>T_p(h)%5Cquad%5CLongrightarrow%5Cquad%20p_%7B%5Cmathrm%7Bnext%7D%7D-p%5Cle%20h.» alt=»V_p(h)>T_p(h)\quad\Longrightarrow\quad p_{\mathrm{next}}-p\le h.» width=»292″ height=»19″ data-width=»36.502″ data-height=»2.347″ data-vertical-align=»-0.608″ style=»width: 36.502ex; height: 2.347ex; vertical-align: -0.608ex» sizes=»(max-width: 780px) 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/c/c6/c69/c692ae02a58026ca9e390d2e1032a5d0.svg 780w,<br />
https://habrastorage.org/getpro/habr/formulas/c/c6/c69/c692ae02a58026ca9e390d2e1032a5d0.svg 781w» loading=»lazy» decode=»async»></p>
<p>В окне вплоть до 539 после действия старых теней оставался лишь один адрес: <img decoding=) и


Те же адреса на комплексной спирали
Здесь вновь вступает в силу комплексная спираль из первой части. Перейдем к логарифмам множителей относительно 


В этих координатах область под гиперболой превращается в идеальный треугольник. Каждая подходящая пара сомножителей по-прежнему однозначно соотносится с конкретным адресом 

Рисунок 12. Окно ![(523,541]](https://habrastorage.org/getpro/habr/formulas/4/45/453/4531bf075c1aae038d2a565df5f7f263.svg)


Зафиксируем параметр 
 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/e/e6/e64/e647edd3b71de1dfee66e0f60c131a13.svg 780w,<br />
https://habrastorage.org/getpro/habr/formulas/e/e6/e64/e647edd3b71de1dfee66e0f60c131a13.svg 781w» loading=»lazy» decode=»async»>. Операция умножения трансформируется в поворот и масштабирование; модуль <img decoding=) строго монотонно убывает, обеспечивая надежную различимость адресов. При стремлении отношения

Спираль наглядно иллюстрирует пространственное распределение адресов, тогда как доказанный комбинаторный подсчет определяет предельное число дополнительных блокировок. Это две взаимодополняющие проекции одних и тех же чисел. Для практических вычислений мы по-прежнему храним целые адреса: геометрическая визуализация на комплексной плоскости не заменяет алгоритмическую память.
Значение для последующих шагов
Практический смысл полученных выводов формулируется без привлечения комплексного анализа. Программа применяет старый базис к новому окну и фиксирует остаток ![(\sqrt p,\sqrt{p+h}]](https://habrastorage.org/getpro/habr/formulas/4/4f/4fc/4fcf08d846230667533bd45379588228.svg)

Сохраненное состояние позволяет многократно использовать готовые правила и точные ответы для ранее просчитанных окон без необходимости восстановления первичных миров рождения этих правил. Тем не менее, для нового интервала все равно требуется вычислить точный остаток — либо через прямое покрытие, либо посредством корректного переноса известного результата. Если параллельно сохранять и сами выжившие адреса, сертификат существования простого числа можно напрямую связать с конкретными кандидатами.
Особый интерес представляет интервал длины 


По мере роста опорной точки число дополнительных блокировок ограничивается величиной порядка 

Для получения общей гарантии максимального расстояния до следующего простого числа потребовалось бы доказать, что единый выбор константы
>%5Cfrac%7Bc%5E2%7D%7B16%7D%5Cln%5E2p+%5Cfrac%20c2%5Cln%20p+1.» alt=»V_p(h)>\frac{c^2}{16}\ln^2p+\frac c2\ln p+1.» width=»231″ height=»40″ data-width=»28.86″ data-height=»5.018″ data-vertical-align=»-1.943″ style=»width: 28.86ex; height: 5.018ex; vertical-align: -1.943ex» sizes=»(max-width: 780px) 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/d/d8/d8b/d8bd70afaaed92822348e15023886a72.svg 780w,<br />
https://habrastorage.org/getpro/habr/formulas/d/d8/d8b/d8bd70afaaed92822348e15023886a72.svg 781w» loading=»lazy» decode=»async»></p>
<p>Подобной универсальной нижней оценки для <img decoding=) в настоящий момент не существует. Нами доказаны структура остатка и верхняя граница дополнительных блокировок, а условие
 100vw, 50vw» srcset=»https://habrastorage.org/getpro/habr/formulas/f/ff/ffe/ffe3a906f4fa52c908a657705c630b7c.svg 780w,<br />
https://habrastorage.org/getpro/habr/formulas/f/ff/ffe/ffe3a906f4fa52c908a657705c630b7c.svg 781w» loading=»lazy» decode=»async»> предоставляет верифицируемый сертификат для каждого отдельного окна. Для вывода общей теоремы обо всех последующих простых числах требуется строгое доказательство неизменного наличия необходимого запаса свободных адресов.</p>
<p>Связь с гипотезой Римана носит односторонний характер: из справедливости RH вытекает ограничение на промежутки между простыми в масштабе <img decoding=) . [2] Наш безусловный результат описывает дополнительные блокировки ровно на этом масштабном уровне. Из этой взаимосвязи нельзя автоматически заключить, что доказательство оценки промежутков само по себе приведет к доказательству гипотезы Римана.
Верификация и результаты расчетов
Полученные формулы были протестированы с помощью специализированной программы на 548 простых опорных точках в диапазоне от 5 до 3989. Для каждой опоры исследовались интервалы вплоть до
Старый остаток программа определяла через проверку делимости, тогда как количество простых чисел независимо извлекалось из решета Эратосфена. Дополнительные составные элементы вычислялись отдельным перебором пар простых чисел. Во всех контрольных точках значения полностью совпали; границы через неюные пары под гиперболой и упрощенная треугольная оценка также выполнялись безупречно. Операции с целыми частями и краевые эффекты контролировались средствами целочисленной арифметики.
Эта серия тестов подтверждает корректность реализации формул на конечной выборке. Общее доказательство структуры остатка и верхней границы приведено выше. Сравнение производительности с традиционными решетами в данном эксперименте не проводилось, поскольку полноценный бенчмарк должен включать извлечение остатка 
Предложенная конструкция имеет классических предшественников. В методах Мейсселя — Лемера на этапе частичного просеивания выделяется поправка 

Отрадно осознавать, что этот результат вернул нас к первоначальной геометрии, придав ей дополнительную зримую осязаемость. Прежде мы рассуждали абстрактно: тени перекрываются, история сжимается, новый мир наследует правила. Теперь в рамках одного конкретного шага мы можем явно указать остаток, обвести область формирования дополнительных теней и рассчитать ее емкость.
Вся миниатюрная драма укладывается в промежуток между 523 и 541. Старые тени оставили два адреса. Новый слой мог забрать один — и заблокировал 529. Остался 541. За этой лаконичной графической схемой скрывается закономерность, которую можно доказать, воплотить в коде и проверить на практике, чтобы с уверенностью сделать следующий шаг.
Источники, данные и происхождение иллюстраций
Математическая литература
[1] J. C. Lagarias, V. S. Miller, A. M. Odlyzko. Computing π(x): The Meissel–Lehmer Method. Mathematics of Computation, 44, № 170 (1985), с. 537–560. Разложение частичного решета и член P₂: § 2, формулы (2.1)–(2.3). Во второй части статьи используется для сопоставления тождества V − J с классическим подходом. DOI: 10.1090/S0025-5718-1985-0777285-5 · Авторская версия (PDF)
[2] A. W. Dudek. On the Riemann Hypothesis and the Difference Between Primes. arXiv:1402.6417, версия 2, 20 мая 2014 г. Условная оценка интервалов между простыми в масштабе √p ln p в предположении гипотезы Римана; связь обсуждается во второй части. arXiv:1402.6417v2
[3] NIST Digital Library of Mathematical Functions. § 27.2, формула 27.2.3. Теорема о распределении простых чисел: π(x) ∼ x / ln x. В первой части применяется для согласования доминирующего порядка точного счетчика и логарифмического интеграла. DLMF, формула 27.2.3
[4] NIST Digital Library of Mathematical Functions. § 27.12, формула 27.12.7. Критерий гипотезы Римана через отклонение π(x) от li(x). На этот критерий опирается дискуссия о нулевом остатке в первой части. DLMF, формула 27.12.7
Теория и программное обеспечение
[5] Вадим. Простые числа в растущих мирах. Точный счетчик, логарифмическая асимптотика и комплексное представление. Препринт, версия 0.1, 12 октября 2026 г., 10 с. Файл prime_worlds_preprint_ru.pdf. Теоремы 1–3: покрытие, преемственность, счетчик; § 4.1: бенчмарк алгоритмов; § 5 и теорема 4: асимптотика; § 8: статус замены интеграла; § 9: рябь и условие глобальной оценки. Рисунок 9 соответствует рисунку 3 препринта (стр. 8).
[6] Вадим. Многомерные пространства, тени и миры вспышек: воспроизводимый исследовательский пакет. Версия 1.0.0, 10 октября 2026 г. Теоретическая база, оптимизированное ядро, бенчмарки, эксперимент с 3P − 82 и спецификация ресурсов: README.md; docs/FAST_ENGINE.md; data/benchmark_original.json; data/benchmark_rerun.json; data/record_original.json; data/resources.json. Рисунки 1–2 — авторские иллюстрации из пакета world_birth_explainer_2026_10_11: 01_prime_axes_and_layers.png и 02_shadows_and_next_flash.png. Репозиторий на GitHub
[7] Архивы оптимизации. THEORY_RU.txt и REFINEMENT_RULES_RU.txt; «Анализ времени и повторного восстановления адресов» — flash_timing_findings_ru.txt; «Обновленные результаты прямого доступа» — UPDATED_RESEARCH_RU.txt; RUN_ABSORPTION_RU.txt. Первоисточники фрагментов первой части, посвященных повторному извлечению адресов, прямому доступу, правилам уточнения и подготовке остатка.
Численные данные и иллюстрации
[8] Опорные волны и преемственность. Рисунки 3–4: cycle_probe_work/visual_qa/chart-736.svg; spiral_inheritance_2026_10_11/01_inherited_shadows_on_spiral.png. Проверка смешанных вкладов: q_spiral_visuals_20261012/mixed_counter_comparison.json. 29 миров от 3 до 113, 16 514 послойных проверок; расхождений в работе счетчика не выявлено.
[9] Рябь и нормализация. Рисунки 5–6: ripple_visual_work/03_ripple_bound.png; ripple_straightening_work/ripple_known_correction.png. Исходные данные: ripple_straightening_work/straightening_values.json. Проверка на целых N от 100 до 1 000 000; пятикратное уменьшение (в 5,11 раза) относится к RMS нормированной ряби на указанном интервале.
[10] Счетчик и масштабный расчет. Рисунки 7–8: counter_steps_20261012/counter_world_7.png; large_counter_20261012/cumulative_counter_overview.png. В том же каталоге large_counter_20261012: cumulative_counter_results.json и cumulative_independent_check.json. Конечная граница — 189 858 287 514 613; 29 переходов, 30 опорных точек, 3 783 визуализированных среза. Значение счетчика после 3: H = π − 2. Интегральное среднее отклонение вычислено по всей траектории.
[11] Верификация и иллюстрации ко второй части. Каталог habr_next_axis_addendum_20261012/output: скрипт verify_next_axis.py; параметры и описание выборки — verification.json. Команда запуска: python verify_next_axis.py —max-prime 4000. Протестированы 548 простых опорных точек от 5 до 3989 и 124 603 отдельных среза. Рисунки 10–12: 01_coverage_523.png, 02_triangle_budget.png, 03_log_spiral.png в папке habr_next_axis_addendum_20261012/figures (доступны также в формате SVG). Графики построены строго по аналитическим формулам и целочисленным координатам.
Примечания об иллюстрациях и материалах
Первая часть описывает этапы разработки в период с 7 по 12 октября 2026 года. Иллюстрации 1–9 заимствованы из сохраненных рабочих дампов. Для второй части подготовлен автономный скрипт проверки, лог результатов и графики 10–12 [11]. Концепция, формулировки задач и руководство — Вадим. Искусственный интеллект привлекался для программирования, расчетов, синтаксического контроля формул и редакционной подготовки текста.
В тексте разграничиваются три типа визуальных представлений: адресная спираль, интегрированная комплексная сумма и графики отклонений. Их внешнее сходство облегчает поиск аналогий, однако лишь строгие определения и верифицированные тождества подтверждают реальное наличие математических связей.
Похожие статьи
 Обнаружен мозговой переключатель сна: как редкие нейроны управляют засыпанием
 Семь из девяти планетарных границ уже пройдено: человечество на краю экологической катастрофы
 Как устроены межбанковские переводы: заглядываем под капот системы
 Как получить 360 сертификатов по искусственному интеллекту за один день с помощью ChatGPT
 Путь физика Ли Смолина: черные дыры, петлевая квантовая гравитация и остров Эпштейна
 Пол Хэрнаки. «Дальнобойщики». Предисловие, пролог, главы 1–4
 Ночная разработка стоимостью в потерянную тетрадь
 Почему генетические алгоритмы не смогли заменить инженера