Облачная архитектура на автопилоте: как автоматизация строит и меняет инфраструктуру
Приветствие от команды K2 Cloud
Данный материал, посвященный аппаратному обеспечению и автоматизации нашей инфраструктуры в дата-центрах, готовился задолго до инцидента, с которым недавно столкнулись коллеги из Яндекса. Мы искренне сочувствуем специалистам и всем, кого затронула эта ситуация, и надеемся на скорейшую стабилизацию их рабочих процессов. Наша команда готова оказать содействие в резервировании ваших мощностей в приоритетном порядке: Яндекс согласовал с рядом провайдеров ускоренное развертывание ресурсов, и K2 Cloud входит в их число.
Направьте заявку с промокодом CloudBro, и мы обработаем ее вне очереди.
Здравствуйте, SE7EN! Меня зовут Антон Бушный, я возглавляю группу инженеров инфраструктуры в K2 Cloud. В этой публикации мы поговорим об «железе» — теме, которой незаслуженно уделяют мало внимания. Любое программное обеспечение, микросервис или кластер Kubernetes базируется на физической инфраструктуре. Мы обсудим принципы проектирования масштабных систем на макроуровне, избегая детального сравнения конкретных серверных линеек и бенчмарков.
Материал разделен на две части. Первая освещает аппаратную часть и специфику взаимодействия с ней инженеров. Вторая посвящена автоматизации процессов управления инфраструктурой. За прошедшие годы мы накопили ценный опыт в обоих направлениях и готовы поделиться лучшими практиками.
О нас и предпосылках для рассказа
K2 Cloud представляет собой облачного провайдера из топ-10 профильных платформ РФ. Наше облачное решение разработано собственными силами преимущественно на Python, с активным применением Open Source технологий, включая OVN для виртуализации сетей.
На текущий момент инфраструктура развернута в четырех московских ЦОДах и одном петербургском. Кроме того, мы осуществляем техническую поддержку нескольких частных инсталляций нашей платформы на стороне заказчиков.
Главная особенность нашей среды — высокая динамика. Нам постоянно приходится адаптироваться под запросы клиентов, поэтому оборудование регулярно монтируется, демонтируется, мигрирует между дата-центрами или перераспределяется. Действовать приходится оперативно в условиях жестких дедлайнов, иногда срываемых по самым неожиданным причинам.
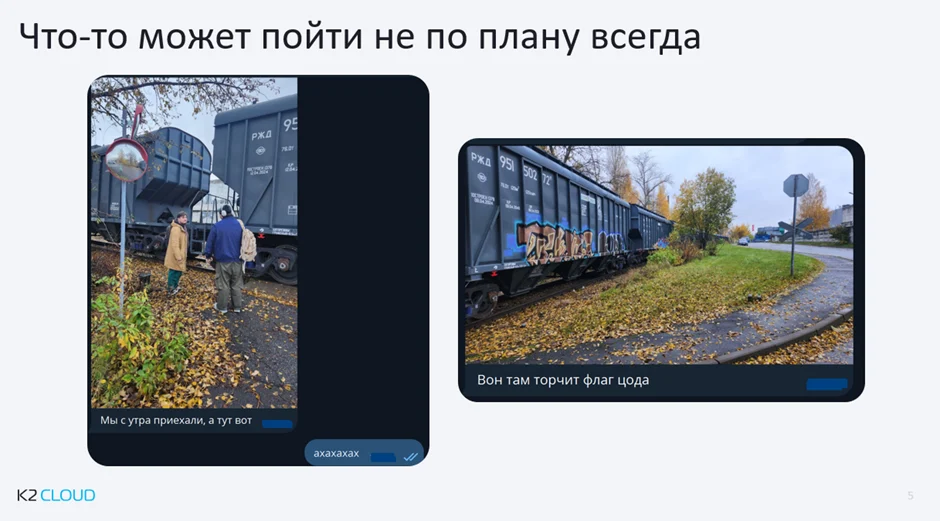
Так, во время доставки крупной партии серверов в один из ЦОДов наши инженеры столкнулись с тем, что подъездной путь оказался заблокирован железнодорожным составом.

Сотрудники смогли преодолеть препятствие пешком через вагоны, но грузовик с оборудованием остался заблокирован. Монтаж пришлось отложить более чем на сутки в ожидании маневровых работ 🙂
Истоки: хаос в стойках образца 2018–2019 годов
Вернемся в 2018–2019 годы. Масштабы нашего облака тогда были скромнее. Эксплуатация была разделена по узким специализациям: каждый инженер отвечал за свой участок и управлял им автономно, без должной координации с коллегами. Итогом становилась стихийно сформированная инфраструктура.
При запуске новой стойки силами одного сотрудника все выглядело аккуратно и профессионально, как на этом снимке:

Спустя пару месяцев по мере интеграции новых сервисов ситуация менялась:

Здесь структура еще просматривалась, но зарождение беспорядка было очевидно. Проходило полгода — и каждая стойка неизбежно превращалась в это:

Первопричина крылась в поверхностном планировании, а порой и в его отсутствии. Вторым фактором выступала переусложненная сетевая архитектура.
Мы эксплуатировали две независимые сети — Ethernet и InfiniBand, объединяемые коммутаторами на уровне ядра. Каждая стойка содержала свитчи обоих типов. Высокоскоростной InfiniBand обслуживал СХД, виртуальные сети и миграцию ВМ, в то время как Ethernet обеспечивал управленческий трафик и межсервисное взаимодействие.

Теоретически схема выглядела надежной: пара стоек комплектовалась дублирующими свитчами Ethernet и InfiniBand для обеспечения отказоустойчивости. Однако на практике размещение коммутаторов в верхних фронтальных зонах стоек приводило к скоплению кабельных жгутов вокруг них и масштабным межстоечным соединениям.
Как следствие, верхние крышки стоек обрастали пучками проводов (правое фото), а фронтальный вид оставлял желать лучшего. Помимо эстетики, это влекло за собой вполне осязаемые проблемы:
-
Повышенная аварийность при обслуживании. Любые манипуляции с конкретным сервером рискули задеть соседние линки из-за плотности монтажа.
-
Диспропорция заполнения. Нижнее пространство плотно забивалось серверами, тогда как верх простаивал из-за компактности коммутаторов.
-
Неравномерность энергопотребления со смещением нагрузки на нижние юниты.
-
Демотивация персонала. Инженерам было тяжело работать в таких условиях. Проблема затрагивала и разработчиков: новые сотрудники, рассчитывавшие исключительно на развитие софта в Kubernetes, сталкивались с необходимостью ручного подбора серверного железа и накопителей, что вызывало определенное сопротивление.
Долгое время мы мирились с этим, считая издержки неизбежной спецификой облачной индустрии.
Переломный момент наступил на рубеже 2019–2020 годов, накануне пандемии. Нашу компанию накрыл кризисный период, сопровождавшийся целой цепью технологических сбоев.

Во-первых, из-за каскадных перегрузок по питанию произошло отключение целых стоек, причем в одном из случаев оплавился вводной разъем PDU, спровоцировав задымление.
Во-вторых, начались сбои в сетевой подсистеме и хранилищах. Пул InfiniBand морально устарел: апдейты ОС приводили к багам драйверов, очереди пакетов зависали, и вернуть хост в строй удавалось лишь полным рестатом. Обновление сети требовало тотального одновременного отключения, что было неприемлемо.
Наконец, системы хранения данных оказались «отказоустойчивыми» лишь на бумаге: при выходе из строя одного контроллера резервный узел не выдерживал пиковой нагрузки и падал вместе с ним, полностью блокируя доступ к информации.
Курс на трансформацию
Очевидность предельных нагрузок потребовала радикальных и быстрых перемен.
Первым шагом стало создание единого центра ответственности за аппаратную часть. Мы осознали необходимость профильного подразделения, аккумулирующего все задачи по «железу», которые ранее были распылены по разным отделам (мониторинг, тестирование оборудования и т.д.). Новая модель взаимодействия представлена на схеме:

Отныне смежные команды решали инфраструктурные вопросы через специализированную группу, выросшую из пары энтузиастов в полноценный департамент. Новообразованная команда сформулировала стратегические цели.
Базовые принципы
Перед инженерами поставили следующие задачи:
● унификация серверных и стоечных подключений;
● сокращение внешних кабельных линий путем разворота коммутаторов тыльной стороной;
● балансировка энергопотребления внутри стоек для исключения перегрузок;
● оптимизация свободного пространства с целью минимизации арендуемых юнитов.
Смежные подразделения также скорректировали планы:
● сетевые инженеры вынесли ядро в отдельные стойки, полностью отказавшись от InfiniBand в пользу Ethernet и внедрив новую архитектуру;
● команда СХД отказалась от монолитных систем в пользу распределенных платформ, дублирующих данные на независимых узлах (в 2-3 экземплярах), что исключило риск потери доступа при отказе отдельного сервера.
Итогом стали новые стандарты, на внедрение которых ушло два с половиной года. Кратко рассмотрим их суть.
Типизация стоек

Облачные стойки (CloudRacks) — основной стандарт для размещения рабочих мощностей.
Сетевые стойки — содержат ядро сети и точки интеграции с внешними каналами (Интернет, выделенные линии связи клиентов, оборудование заказчиков в ЦОДе). Обязательное условие — четное количество таких стоек на дата-центр для обеспечения полного резервирования.
Для частных инсталляций с дефицитом пространства были разработаны комбинированные стойки: нижний сегмент собирается по стандарту CloudRack, верхний отводится под сеть. Это компромисс между жесткими требованиями и экономией места.
Архитектура стандартной облачной стойки приведена ниже.

Цели стандарта:
-
Заполнение каждого юнита, централизованное размещение свитчей.
-
Масштабируемость: пропорциональное распределение компонентов позволяет развернуть минимально необходимую инсталляцию даже из одной стойки.
-
Строго регламентированная схема подключения питания к PDU.

Параметры разрабатывались на базе замеров реального энергопотребления гипервизоров и узлов СХД. Внедрение интеллектуальных PDU с онлайн-мониторингом, интегрированных в Zabbix и DCIM, позволило инженерам ЦОДа контролировать нагрузку в режиме реального времени до начала любых работ.
Сетевая архитектура была переведена на классический паттерн leaf-spine:

Каждая стойка оборудуется парой leaf-коммутаторов продуктивного трафика и одним управленческим (mgmt leaf), завязанными на spine-узлы в сетевых стойках. Выход в внешний контур обеспечивают border leaf.
Отказ единичного mgmt-свитча не критичен — он лишает нас лишь телеметрии и админ-доступа, не затрагивая пользовательские сервисы.

Исторически мы использовали половинные шасси Mellanox (два независимых свитча в юните — «левый» и «правый»). При переходе на новые закупки применяются стандартные полноразмерные устройства.
Количество исходящих линков сократилось до шести: два медных под менеджмент и четыре оптических 100G (по два на каждый spine). Оптика защищена органайзерами, крыши стоек освобождены от кабельного хаоса.
Коммутаторы монтируются портами назад, что потребовало особого внимания к воздушным потокам:

Штатно охлаждение идет со стороны портов. Нам требовался реверсивный продув (забор с тыла, выброс на порты), доступный как опция при заказе.

Самостоятельная замена вентиляторов вендорами не одобряется, поэтому новое оборудование закупалось сразу в нужной конфигурации.
Схема подключения серверов также унифицирована до четырех линков: два продуктивных в разные leaf (с поддержкой VLAN для дополнительных сетей), один медный для BMC и резервный Cluster Backup.
Выделение Cluster Backup страховало нас от выхода из строя единственной сетевой карты — даже при сбое основных интерфейсов администратор сохраняет SSH-доступ к хосту. Порты жестко закреплены за юнитами, что исключает сложные кабельные планы — заявка сводится к стандартной формулировке.

Конфигурация сети описывается через Puppet (включая форк OpenVox) в репозитории Hiera, фрагмент которого показан ниже вместе с автоматической настройкой портов на коммутаторах под управлением Cumulus Linux или Ansible.

Ручная настройка портов полностью исключена.

Пример реального вида коммутации в стойках:

Автоматизация: от нового сервера до работающего гипервизора
Процесс ввода оборудования в эксплуатацию состоит из этапов:
-
выбор монтажной позиции;
-
генерация системных конфигов;
-
аппаратная подготовка;
-
установка ОС;
-
регистрация в облаке;
-
валидация.
Шаг 1. Позиционирование
Для инвентаризации используется DCIM-система OpenDCIM с JSON API.

Мы написали Python-клиент для терминала, позволяющий инженеру оценивать конфигурацию стоек на лету.

Специальная утилита анализирует свободные юниты в соответствии со стандартами роли сервера.

Для автовыгрузки данных в DCIM мы создали два Puppet-скрипта. Полевой персонал информируется системой автоматически.

Шаг 2. Конфигурация
Задействуются внутренний DNS, Puppet и Ansible.

От сложной CI/CD автоматизации мы осознанно ушли в пользу локальных скриптов на рабочих станциях инженеров.

Сотрудник генерирует изменения для репозитория, проверяет их и отправляет пулл-реквест на review. Это минимизирует человеческий фактор и удовлетворяет требованиям информационной безопасности.
Шаг 3. Аппаратная подготовка
Включает обновление прошивок, настройку BIOS/BMC (отключение энергосбережения для максимальной производительности), сборку RAID и активацию PXE.
Унификацию разнородных вендорских интерфейсов (например, iDRAC) мы решили через универсальный протокол RedFish API.

Поддерживается подавляющее большинство платформ, за исключением решений с проблемной или отсутствующей реализацией стандарта.

Пример запросов к RedFish API (PATCH для настройки PXE и POST для перезагрузки):

Нейросети эффективно генерируют такие запросы под разные BMC.
Разработанная мультивендорная утилита сократила время подготовки узла с часа до 15 минут, причем параллельный запуск позволяет обрабатывать партии серверов за тот же интервал.

Нюанс RedFish — непредсказуемая асинхронность. Длительность операций (например, обновления BIOS) варьируется, поэтому код дополнен таймерами опросного типа для мониторинга готовности BMC.
Шаг 4. Развертывание ОС
Используется связка Cobbler и dnsmasq (DHCP), управляемая модулями Puppet через парсинг Hiera.

Автоматизация установки базируется на kickstart-файлах Anaconda, передаваемых по HTTP.

На выходе получается готовый к работе узел с размеченными дисками, предустановленными пакетами, агентом Puppet и настроенными ключами доступа.
Шаг 5. Регистрация в облаке
Выполняется платформенным инструментом bootstrap, способным выполнять радикальные действия (перезагрузку хостов и ожидание их возврата в сеть), недоступные для Puppet.
Шаг 6. Валидация
Python-утилита c2check запускает комплекс безопасных тестов в зависимости от роли сервера и ОС, выводя отчет в виде матрицы статусов ok / not ok.
В планах — объединить разрозненные инструменты в единый суперсервис с интерфейсом быстрого управления.
Заключение
Инвестиции в стандартизацию и автоматизацию инфраструктуры полностью оправдали себя при масштабировании бизнеса, запуске региональных зон и расширении дата-центров.
Проектирование надежной архитектуры на старте обходится значительно дешевле ликвидации кризисных последствий под нагрузкой. Надеемся, наш опыт окажется полезным для ваших проектов, а если потребуется расширение ресурсов — добро пожаловать в K2 Cloud!
Похожие статьи
 Сборка домашнего сервера для локальных LLM на недорогих GPU NVIDIA CMP 50HX
 Минцифры обязало внедрить российский шифр «Кузнечик» во все 5G-смартфоны
 Лунная ракета SLS готовится к тестам перед миссией Artemis III
 Названа цена Honor Win 2: ультимативный игровой смартфон 2026 года с экраном 185 Гц и батареей на 10 100 мА·ч
 Когда эстетика серверной стойки начинает мешать её работе
 OnePlus совершит прорыв: новый смартфон на Snapdragon 8 Elite Gen 5 сравняется по мощности с моделями на Snapdragon 8 Elite Extreme Gen 6
 Кюрасао подключили к спутниковому интернету Starlink
 Китайский рынок мобильных процессоров: Xiaomi обошла Samsung