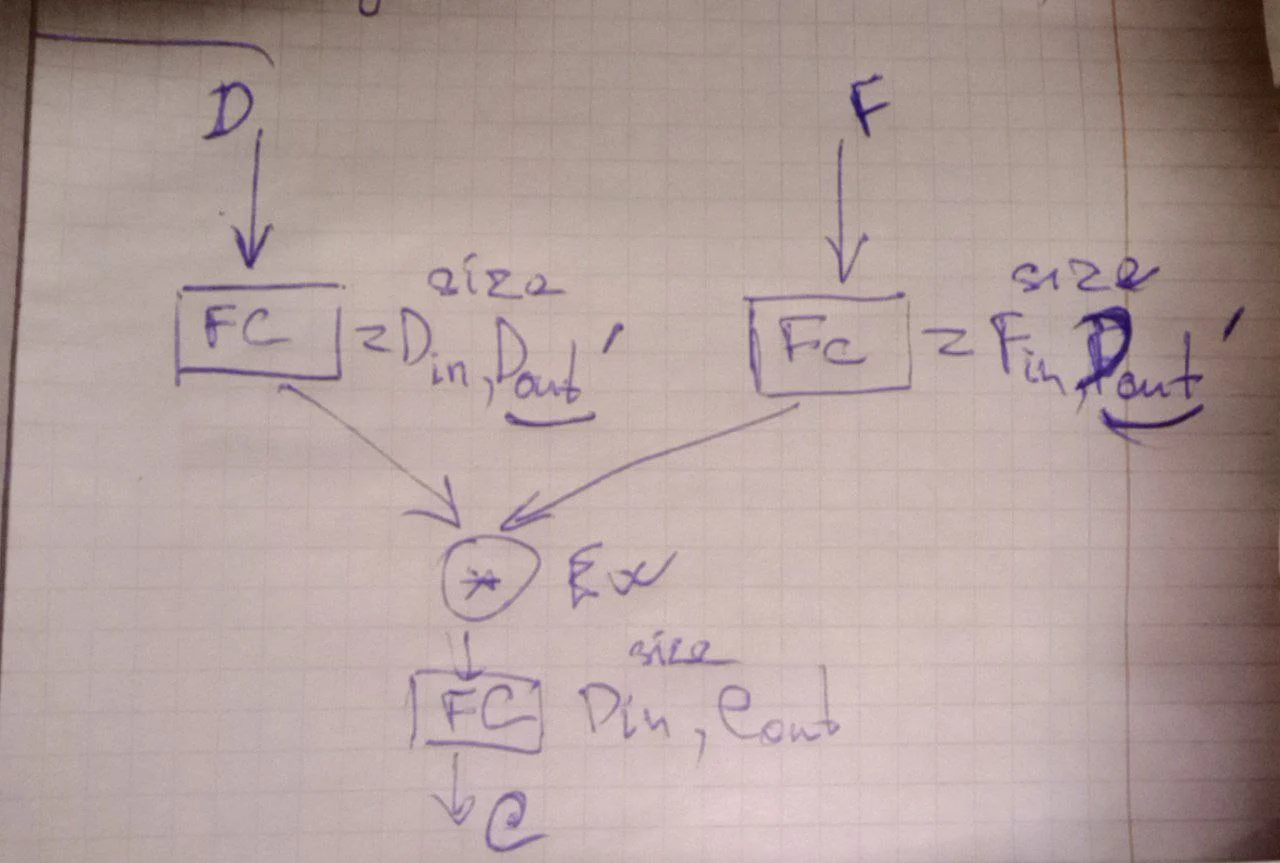
Ночная разработка стоимостью в потерянную тетрадь
Тот самый набросок из тетради с опечаткой в размерах горлышка
Стоял глубокий вечер. Раскалывалась голова, простуда сковала дыхание, а ртутный столбик термометра неумолимо полз вверх. Что остается делать в том предаварийном состоянии, когда кажется, что за левым плечом уже маячит костлявая с косой?
Пожалуй, ничего выдающегося. Поэтому я решил заняться банальной рутиной — разгрести завалы бумаг на рабочем столе, ведь порядок наводить временами всё же необходимо. Вдруг мой взгляд зацепился за пожелтевшую тетрадь, выглядывавшую из-за шкафа.
Аккуратно раскрыв её, я уставился на старый набросок. Родился он вскоре после ухода NVIDIA из России, где я трудился ведущим инженером, в основном проектируя фреймворки для нейросетей (уезжать я тогда не стал). Эскиз отражал поиски универсального способа извлечения заветных свёрточных ядер в обход громоздких китайских теорем — метода, применимого для конфигураций абсолютно любой формы, в том числе и тех, что не поддаются аналитическому разрешению.
Концепция выглядела элементарно: почему бы не вычислять матрицы Винограда через градиентный спуск?
Я незамедлительно озадачил локальную нейросеть: не изобрел ли кто-нибудь аналогичный велосипед за прошедшие годы? Успокаивающее гудение дросселей на ветеранах V100 возвестило о старте расчетов, а ритмичное подмигивание портов коммутатора подтверждало, что искусственный интеллект приступил к изысканиям.
Поисковик выдал парочку ссылок на AlphaTensor от DeepMind и несколько академических трудов, имеющих весьма отдаленное отношение к искомой «серебряной пуле». Но главное — ни в одном из источников не обнаружилось двух критически важных составляющих: открытого исходного кода и универсальности метода, способного генерировать точные алгоритмы для ЛЮБЫХ типов свёртки (с произвольными параметрами Stride, Dilation и асимметрией), сохраняя при этом минимальное число операций умножения, как это гениально делал Шмуэль Виноград.
Интеллектуальный гештальт, висевший в воздухе долгие годы, требовал немедленного закрытия….
Признаюсь честно: моя стихия — это C++, CUDA и HDL (VHDL/SystemVerilog). Без крайней необходимости я стараюсь избегать других инструментов. Однако в тот вечер снизойти до уровня Python казалось вполне простительным — поддерживать жесткую дисциплину разработки у меня просто не было физических сил.
Поэтому я попросту попросил языковую модель сгенерировать скелет нейросети на основе чертежа из блокнота. С этой задачей модель справилась играючи, ведь архитектура задумывалась предельно лаконичной.
Два полносвязных слоя (fc_D и fc_F) преобразуют исходные данные D и ядро F в промежуточное латентное «горлышко» (inter_dim), где происходит их поэлементное перемножение. Третий полносвязный слой (fc_C) декодирует полученное представление в целевую размерность выхода.
class WinogradFromSketch(nn.Module):
    def __init__(self, in_shape, out_shape, kernel_shape, inter_dim):
        super().__init__()
        self.fc_D = nn.Linear(math.prod(in_shape), inter_dim, bias=False)
        self.fc_F = nn.Linear(math.prod(kernel_shape), inter_dim, bias=False)
        self.fc_C = nn.Linear(inter_dim, math.prod(out_shape), bias=False)

    def forward(self, D, F_tensor):
        out_D = self.fc_D(D.view(B, -1))
        out_F = self.fc_F(F_tensor.view(B, -1))
        return self.fc_C(out_D * out_F).view(B, 1, *out_shape)
Затем я развернул базовый цикл обучения. В роли эталона и генератора обучающих примеров выступала стандартная свёртка (F.conv1d, F.conv2d или F.conv3d), которую требовалось подвергнуть компрессии. Генерируя случайные батчи из нормального распределения для D и F и вычисляя для них эталонные результаты, мы получаем идеальный, бесконечный и абсолютно чистый датасет.
Чтобы принудить сеть обнулять избыточные связи внутри матриц (добиваясь той самой виноградовской разреженности), я добавил к функции потерь L1-регуляризацию совместно с легким прунингом, опирающимся на теоретический минимум дробей:

Запустив оптимизатор Adam для простейшей 1D-свертки, я нажал кнопку Run и стоически приготовился к неминуемому краху…
И в этот момент на дисплее проступила кристально чистая, гармоничная матрица! Моя первая реакция: «Да ладно?!» — точно такая же была у моего университетского напарника, когда написанные мной сотни строк на ассемблере заработали безупречно с первой же попытки.
--- Matrix fc_D (data) (shape: (4, 4)) ---
Zero percentage (< 0.08333333333333333): 37.5%
[[  0.00   0.76   0.98   0.00]
 [  0.00   0.89  -0.70   0.00]
 [  0.66   0.33  -0.66   0.00]
 [  0.00   0.63   0.31  -0.62]]

--- Matrix fc_F (kernel) (shape: (4, 3)) ---
Zero percentage (< 0.08333333333333333): 33.3%
[[  0.48   0.62   0.80]
 [  0.84  -0.65   0.51]
 [  1.24   0.00   0.00]
 [  0.00   0.00  -1.18]]

--- Matrix fc_C (output) (shape: (2, 4)) ---
Zero percentage (< 0.08333333333333333): 25.0%
[[  0.80  -1.06   1.22   0.00]
 [  1.02   0.83   0.00   1.36]]
Мрачный вечер определенно перестал быть таковым. А тень в углу комнаты, кажется, молча сняла лыжи, отставила косу и придвинулась ближе к монитору...
Естественно, сразу возник зуд замахнуться на пространства побольше. Алгоритм демонстрировал сходимость, но делал это вальяжно. Обучению явно не хватало ускоряющего импульса. Где его искать? Разумеется, среди тех самых «сложных» кейсов, которые хуже всего укладываются в текущие математические рамки — то есть на тех псевдослучайных примерах, где модель допускает наибольшую погрешность.
Идея созрела моментально: организуем специальный накопитель (HardExampleBuffer) для таких «тяжелых» кейсов и периодически устраиваем для сети принудительный тренинг на них. Эффект превзошел ожидания — скорость сходимости подскочила на порядок!
class HardExampleBuffer:
    def __init__(self, capacity=1024 * 8):
        self.capacity = capacity
        self.D_buffer = None
        self.F_buffer = None

    def add_examples(self, D, F_tensor, errors, top_k=32):
        # Отбираем самые "тяжелые" примеры с максимальным MSE
        _, top_idx = torch.topk(errors, k=min(top_k, D.size(0)))
        # ... и дообучаем модель на этом буфере каждые пару шагов
Несмотря на изрядно отяжелевшую от температуры голову, высвободившийся за счет Python и временного отказа от строгих догм ресурс мышления подсказал наличие еще одной проблемы — коэффициентов, превышающих единицу по модулю ( ).
Первые две матрицы ( и
 ) в классических построениях Винограда не оперируют крупными значениями — они ограничены диапазоном
 , состоя из элементов вроде
 . Соответственно, весь корень зла таится в выходной матрице
 и на финальном этапе свёртки. Решение напрашивалось само собой — внедрить масштабные множители (scale), предоставив градиентному спуску полную свободу действий.
Однако здесь кроется критически важный нюанс: резко задирать коэффициент scale для весов результирующей матрицы категорически возбраняется...
Если форсировать масштабирование с первых итераций, склонная к поиску легких путей нейросеть мгновенно отыщет «грязное» непрерывное решение. Она продемонстрирует прекрасные показатели точности, но окажется абсолютно бесполезной с точки зрения структурной плотности — о нулях в матрицах можно будет забыть.
Следовательно, модель необходимо сначала поморить голодом, погрузив в локальный минимум разреженных конфигураций. Для этого мы удерживаем веса на строгом ограничении ( ), а затем плавно и аккуратно наращиваем его от единицы до расчетного максимума по мере продвижения тренировочного процесса!
# S-образный сглаженный разгон scale в процессе обучения
new_scale = get_current_scale(step, steps, float(winograd_scale))

if new_scale != model.scale:
    with torch.no_grad():
        # Инвариантный пересчет весов, чтобы MSE не скакал при росте scale
        model.fc_C.weight.mul_(model.scale / new_scale)
    model.scale = new_scale
В результате веса выходной матрицы также начали успешно кристаллизоваться в разреженные структуры. Казалось бы, успех налицо, и метод уже несёт вполне осязаемую пользу для аппроксимированных вычислений. Но нам-то требовалось нечто большее — абсолютные, безупречные аналитические формулы в рациональных числах, пригодные для жесткого хардверного проектирования!
И тут в памяти всплыл один трюк. Когда-то давно я задействовал метод наименьших квадратов (МНК) при сопоставлении сигналов в алгоритмах фрактального кодирования. Возникла мысль: а что если взять полученные неидеальные матрицы и попытаться состыковать их с эталонной функцией свёртки средствами символьной математики?
# --- Ядро аналитического сольвера (SymPy + МНК) ---
def prove_winograd_exact(model, target_sym, monomials, max_denom=36):
    WD_float, WF_float = model.fc_D.weight.numpy(), model.fc_F.weight.numpy()

    # 1. Перебираем знаменатели q и квантуем WD и WF к дробям Q
    for q in range(1, max_denom + 1):
        WD_exact = snap_to_sympy_rationals(WD_float, limit_denom=q)
        WF_exact = snap_to_sympy_rationals(WF_float, limit_denom=q)

        # 2. Аналитически находим идеальную WC через МНК (Least Squares)
        M_num = build_monomial_matrix(WD_exact, WF_exact, monomials)
        WC_num, *_ = np.linalg.lstsq(M_num, Target_num.T, rcond=None)
        WC_exact = snap_to_sympy_rationals(WC_num.T, limit_denom=max_denom)

        # 3. Символьная верификация в кольце полиномов SymPy
        M_sym = sp.Matrix(build_symbolic_monomials(WD_exact, WF_exact))
        residual = sp.expand(sp.Matrix(WC_exact) * M_sym.T - target_sym)

        # 4. Если остаток матриц строго равен нулю — алгоритм найден!
        if residual == sp.zeros(*residual.shape):
            print(f"[УСПЕХ] Точное тождество доказано при q = {q} (ошибка = 0)!")
            return WD_exact, WF_exact, WC_exact, True

    return None, None, None, False
Проведя серию манипуляций с этой задумкой под утро, я запустил скрипт — и вновь сорвался на возглас: «Да ну нафиг!». Передо мной красовалась стопроцентная копия оригинальных матриц Винограда!
--- Symbolic Matrix fc_D (data) (shape: 4x4) ---
[       0        1        1        0 ]
[       0        1       -1        0 ]
[       1        0       -1        0 ]
[       0        1        0       -1 ]
Zero percentage: 50.0%

--- Symbolic Matrix fc_F (kernel) (shape: 4x3) ---
[       1        1        1 ]
[       1       -1        1 ]
[       1        0        0 ]
[       0        0       -1 ]
Zero percentage: 33.3%

--- Symbolic Matrix fc_C (output) (shape: 2x4) ---
[     1/2     -1/2        1        0 ]
[     1/2      1/2        0        1 ]
Заварив очередную, уже сбитую со счёту чашку чая, я принялся прогонять конфигурации свёрток, для которых доселе не существовало известных алгоритмов Винограда. И методика заработала со страшной силой!
=================================================================
 Experiment Parameters (Winograd Algorithm Mining)
=================================================================
  Device                    : cuda
  Data Type (dtype)         : torch.float32
  Input Shape (in_shape)    : (5, 5) (25 elems)
  Kernel Shape (kernel)     : (3, 3) (9 elems)
  Output Shape (out_shape)  : (2, 2) (4 elems)
  Stride & Dilation         : stride=(2, 2), dilation=(1, 1)
  -------------------------------------------------------------
  Naive Multiplications     : 36
  Winograd Multiplications  : 25
  FLOPs Reduction           : +30.6%
  -------------------------------------------------------------
  Total Steps               : 100000
  Batch Size                : 2048
  Initial LR / L1 Lambda    : 0.001 / 0.00015
  Pruning Threshold         : 0.000868
  Max Denominator (q_max)   : 576
  Target Scale (max scale)  : 36
=================================================================

step       1/100000 | lr: 1.00e-03 | scale:  1.00 | mse: 8.838e+00 | l1 sum: 112.77
step   10000/100000 | lr: 9.76e-04 | scale:  1.00 | mse: 4.320e-06 | l1 sum: 171.90
step   20000/100000 | lr: 9.05e-04 | scale:  1.71 | mse: 1.602e-06 | l1 sum: 102.98
step   30000/100000 | lr: 7.94e-04 | scale:  7.04 | mse: 7.585e-06 | l1 sum: 66.34
step   40000/100000 | lr: 6.55e-04 | scale: 16.01 | mse: 3.799e-07 | l1 sum: 52.72
step   50000/100000 | lr: 5.01e-04 | scale: 25.77 | mse: 1.839e-07 | l1 sum: 45.42
step   60000/100000 | lr: 3.46e-04 | scale: 33.22 | mse: 7.071e-05 | l1 sum: 41.33
step   70000/100000 | lr: 2.07e-04 | scale: 36.00 | mse: 4.990e-07 | l1 sum: 38.97
step   80000/100000 | lr: 9.64e-05 | scale: 36.00 | mse: 1.407e-05 | l1 sum: 37.74
step   90000/100000 | lr: 2.54e-05 | scale: 36.00 | mse: 7.816e-08 | l1 sum: 36.77

!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
 [SUCCESS]: Early stopping triggered at step 97000/100000!
 Exact Winograd algorithm proved via SymPy (Residual = 0)!
!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!
Что ж, судя по всему, мне удалось сберечь для мировой энергетики немало гигаватт-часов. Снова — по аналогии с теми классическими и оптимизированными свёртками, что навечно осели в закрытых недрах кодовой базы NVIDIA. Но сегодня всё иначе.
Пока я оформлял исходный код в публичный репозиторий под лицензией MIT, кто-то в полумраке продолжал ритмично стучать по клавишам, бормоча что-то себе под нос. Наконец, залив проект по адресу https://github.com/MaxAkaAltmer/apex_winograd, я со спокойной душой лег спать...

Похожие статьи
 Почему генетические алгоритмы не смогли заменить инженера
 Симулятор города для робота-курьера: Arduino Uno, физика и уступающие дорогу пешеходы
 Кибератаки на дата-центры Яндекса: масштабы ущерба, влияние на бизнес и прогнозы для инвесторов
 Рекурсивное самоулучшение: как искусственный интеллект управляет своей эволюцией
 На поиски причины отсутствия √7 ушло две тысячи лет
 От модема до спутника в рюкзаке: эволюция интернета с 1990-х до 2026 года
 Морской отдых и отит: клинический случай из практики отоларинголога
 Деньги вместо совести: как влиять на непослушных ИИ-агентов