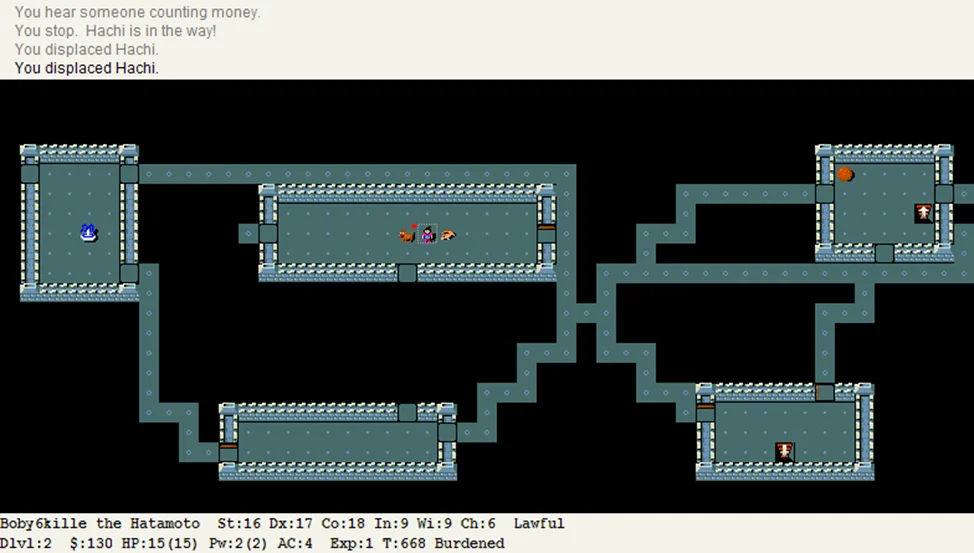
NetHackers: открытое сообщество разработчиков ИИ для стабильного прохождения NetHack
Визуальный стиль — настоящий некстген по стандартам 1987 года, но очевидно, что графика тут на втором плане. Хайкорные игроки вообще запускают игру в ASCII-режиме.
Привет, SE7EN! Меня зовут Влад Куренков, я возглавляю исследовательскую группу «Адаптивные агенты» в институте AIRI. Сегодня я хочу предложить вам заняться распределенной наукой. Давайте разберем суть инициативы.
Существует культовая компьютерная игра NetHack — пошаговый «рогалик» 1987 года выпуска, который искусственный интеллект до сих пор так и не смог одолеть. У протагонича всего одна попытка на всю игру, возможность сохранений отсутствует, подземелья генерируются заново каждый раз, а подсказки со стороны полностью отсутствуют. Если вы ошиблись, последствия настигнут вас в момент, когда исправить уже ничего нельзя. Ровно в те же ловушки попадают современные ИИ-агенты, генерирующие код: блестяще справляясь с локальными задачами, они с трудом удерживают общую стратегию на длинной дистанции. Именно поэтому NetHack выступает превосходным полигоном для тестирования таких агентов.
Именно с этой целью я инициировал открытое комьюнити разработчиков систем ИИ-планирования, объединившихся ради победы над NetHack. Разумеется, сама по себе игра — лишь предлог. Куда важнее методология ее прохождения, которая в итоге должна стать общественным достоянием. Если вы проектируете ИИ-агентов, исследуете методы планирования или создаете игровых ботов, присоединяйтесь к нашему движению.
Ниже я подробно презентую проект NetHackers и наше профессиональное сообщество.
Что представляет собой NetHack
Как упоминалось ранее, NetHack представляет собой пошаговую roguelike-RPG с видом сверху и лаконичной графикой. На старте мы определяемся с полом, расой, мировоззрением и классом персонажа, после чего оказываемся в подземелье. Цель — преодолеть около пятидесяти процедурно сгенерированных уровней, участвуя в сражениях, торгуя, утоляя голод, заполучив Амулет Йендора и выбравшись через финальные пять планов бытия. Успешное завершение этого пути в игре именуется вознесением (ascension).
NetHack удерживает статус старейшей игры, получающей регулярные обновления — свежий патч вышел в мае. К слову, пионером в освещении этой игры в рунете стал именно SE7EN в далеком 2009 году, когда появились первые публикации.
Кроме того, это один из древнейших проектов, до сих пор не покорившихся искусственному интеллекту (если не брать в расчет недавний прецедент с Astra, о котором позже). Факторов несколько: процедурная генерация подавляющего большинства уровней, недостаток информации, гигантские сессии на десятки тысяч шагов, где любое неверное решение в самом начале способно полностью уничтожить прохождение.
Все это пугающе напоминает реальную жизнь со всеми ее вызовами, что и превращает NetHack в эталонный бенчмарк для ИИ-агентов, в особенности специализирующихся на написании кода. Но одного сложного теста мало — необходима правильная координация усилий. Именно поэтому родилось объединение NetHackers, призванное синхронизировать попытки, стандартизировать проверки и обеспечить абсолютную прозрачность результатов.
Организация командного взаимодействия
Вообразите сотню энтузиастов, увлекшихся NetHack и на протяжении месяца пилящих собственных ботов в изоляции. Без системного подхода мы получим сто изолированных репозиториев и сто разрозненных историй успеха: кто-то тестировал алгоритм на единственном персонаже, кто-то настраивал его под конкретные подземелья, а кто-то хвастается локальным рекордом. Даже при наличии гениальных идей в таком хаосе невозможно отследить реальный прогресс и понять отправную точку для новичка. Нам потребовалась структура, где достижения каждого участника служат фундаментом для остальных.
Поэтому мы зафиксировали несколько базовых принципов.
Во-первых, все боты используют единый интерфейс взаимодействия: программа получает срез игрового состояния и отдает управляющее действие. Что скрывается «под капотом» — комплекс эвристических правил, сгенерированный агентом код или оригинальная архитектура — исключительно ваш выбор. Мы не навязываем конкретный метод разработки, нам важно лишь то, чтобы боты запускались по общим регламентам.
Во-вторых, система тестирования разделена на 73 стартовых класса. Для каждого из них выделено 15 общедоступных подземелий, идентичных для всех участников. Это создает отличный полигон: можно непрерывно модифицировать код, прогонять тесты и наблюдать эффект на стандартизированной базе. Поскольку открытые карты известны заранее, триумфа на них недостаточно. Заявленную программу мы дополнительно проверяем на 15 скрытых подземельях для того же класса. Эта проверка отвечает на главный вопрос: действительно ли алгоритм стал умнее или он просто подогнался под публичный набор тестов?
Столь высокая осторожность оправдана, поскольку соблазн переобучения здесь невероятно велик. Заметив частые проигрыши в определенной ситуации, вы вносите правку и радуетесь красивым метрикам. Однако выясняется, что это исправление выручает лишь в знакомом месте, тогда как в остальных партиях пользы ноль. Мы убедились в этом на практике: оптимизации, блестяще работавшие на открытых картах, в новых условиях теряли всякую эффективность. Не каждая цифра отражает реальное понимание задачи.
В-третьих, каждый результат неразрывно связан с конкретным коммитом открытого репозитория. Заявления в духе «мой бот прокачался» не имеют ценности — исследователям необходим точный исходный код, прошедший верификацию. Только так можно воспроизвести достижение, проанализировать его и развить дальше. Веб-ресурс выступает хранилищем метрик и ссылок на авторские репозитории, не претендуя на роль единственного носителя накопленного опыта. Ценность представляют и неудачные попытки: детальный разбор гибели бота и отличий от предыдущей версии убережет последователей от топтания на месте.
В-четвертых, у нас отсутствует концепция единственного пьедестала. Любой локальный прорыв за конкретного персонажа или преодоление ранее не покорявшегося рубежа — это уже весомый вклад. Значимый апгрейд не обязан мгновенно вытягивать средние показатели по всем 73 классам. Зачастую эффективнее привить программе одно новое умение, а уже затем думать над масштабированием. На сайте проекта можно отслеживать промежуточные вехи и достижения по конкретным героям, а не зацикливаться на бинарном исходе «победа/поражение».
Базовое решение
Мы стартуем не с чистого листа. Наш бейзлайн — AutoAscend, мощный символьный бот, триумфатор турнира NetHack Challenge 2021 года. Он прекрасно ориентируется в механиках, исследует локации, ведет бои и справляется со множеством игровых коллизий. Вместе с тем его кодовая база содержит массу зон для оптимизации. Это идеальная отправная точка: достаточно мощная для глубоких прохождений и одновременно несовершенная, чтобы находить зоны роста без необходимости писать весь игровой движок с нуля.
Методология поиска улучшений остается на ваше усмотрение. Хотите вручную править эвристики — пожалуйста. Предпочитаете поручить кодинг-агенту анализ логов смерти, генерацию патчей, прогон тестов и самоисправление — отличный подход. Задумали построить автономный цикл генерации и отбора гипотез — это перспективная исследовательская задача. В любом случае сообщество оценивает итоговую программу, а не увлекательные рассказы о том, как она создавалась.
Важно подчеркнуть: речь не идет о волонтерском распределении вычислительных мощностей вроде фонового просчета чужих партий. Дефицитный ресурс здесь — это качественные идеи и их практическая реализация. Более того, код, присланный сторонним разработчиком или автономным агентом, нельзя слепо запускать на рабочей машине. Во время валидации мы изолируем программы в контейнерах с жесткими лимитами по сети, памяти и CPU, жестко привязывая результат к публичной версии исходников. Разумеется, это не отменяет базовой гигиены безопасности при использовании чужих наработок в качестве базы.
С чего начать новичку на практике? Загляните в таблицу лидеров, изучите успехи стартовых персонажей и выберите понятную зону ответственности. Совсем не обязательно замахиваться на абсолютную победу. Устранение конкретной причины гибели, бережное обращение с инвентарем или прокачка слабо поддерживаемого остальными персонажа — уже весомый вклад. Особенно если прирост подтвердится на закрытых бенчмарках.
Текущие результаты
Давайте сразу договоримся о терминах. Для отдельной сессии триумф — это вознесение. Однако для нашей глобальной цели единичного прохождения недостаточно: мы ищем систему, способную стабильно побеждать на рандомизированных картах при различных вводных. Подобных результатов пока не добился никто. Это не значит, что машины никогда не побеждали в NetHack, и здесь стоит сделать важную оговорку.
Исторически бот BotHack трижды завершал игру на устаревшем релизе 3.4.3, используя уязвимость, которую разработчики позже устранили. А в сентябре 2026 года появился другой примечательный прецедент: языковой агент GPT-6 Astra с третьей попытки привел к победе валькирию-дворфа на публичном сервере. Агент самостоятельно генерировал вспомогательные скрипты и принимал решения, однако эксперимент проводился под ручным контролем, а созданный инструментарий сам по себе не является автономным игроком, способным демонстрировать стабильную серию побед на новых картах. Достижение потрясающее, но это принципиально иной класс результатов.

Наша командная оценка завязана на NetHack 3.6.6 в среде NLE. На этой итерации ни один из представленных на платформе подходов еще не дошел до финального вознесения. Поэтому для сопоставления частичных успехов мы внедрили шкалу прогресса, отражающую прохождение ключевых этапов, а не условный «процент побед». Последнее различие критически важно. Заявление о 17% прогресса вовсе не означает, что программа выигрывает 17 матчей из 100.
Анализ опубликованных ориентиров разрушает привычные иллюзии о триумфальном шествии ИИ в играх. Тот же AutoAscend застрял на отметке 7,8% прогресса; за масштабную серию из 109 545 партий он ни разу не добрался до логова Медузы. Простое подражание действиям этого бота также не принесло быстрых дивидендов: показатели имитационного обучения вышли на плато ниже уровня учителя.
В сентябре наметился качественный сдвиг в области обучения с подкреплением: новые модели продемонстрировали 11,78% и 16,98% прогресса (для специализированной на глубине версии). Это первые показатели в нашем сводном рейтинге, превзошедшие бейзлайн AutoAscend, причем отдельные запуски успешно добирались до Замка. Языковые модели в режиме прямых сессий также демонстрируют частичные успехи — для одной из конфигураций зафиксирован результат в 13,2%. Здесь также стоит упомянуть инициативу BALROG, где LLM играют в NetHack в реальном времени в режиме онлайн без написания вспомогательного кода.
На момент подготовки материала рекорд нашего лидерборда составляет 32% (что вчетверо превосходит показатели AutoAscend). Данный скрипт удерживает первенство по среднему уровню прогресса среди всех персонажей.

Суммируя итоги: за полторы недели с момента старта NetHackers нашему коллективу хакеров и кодинг-агентов удалось создать алгоритмы, способные периодически добираться (и погибать) до финального уровня на публичных картах (и крайне редко на закрытых). Тем не менее, полноценной и стабильной победы в наших условиях пока не одержал никто. Мы видим, что нейросети уперлись в определенное плато, а значит, индустрии требуются свежие идеи. Мы в поиске единомышленников — возможно, именно ваш алгоритм сдвинет дело с мертвой точки.
Текущая ситуация гораздо увлекательнее линейных историй о победе какой-то одной концепции. Рукописные эвристики обеспечивают надежный базис с прозрачными багами, которые легко точечно исправлять. Обучение с подкреплением открыло новые горизонты частичного прогресса, но до финиша еще далеко. LLM-агент однажды доказал принципиальную возможность победы, однако речи о воспроизводимом автономном решении пока не идет. Нам требуется не столько закрыть соревнование, сколько синтезировать сильные стороны разных парадигм и научиться валидировать устойчивость изменений от партии к партии.
Поэтому по мере эволюции сообщества я рекомендую обращать внимание не только на абсолютные пиковые цифры в таблице. Анализируйте, у каких классов наметился прогресс, какие архаичные ошибки удалось ликвидировать, подтверждаются ли улучшения на закрытых симуляциях и можно ли использовать чужой код в качестве плацдарма для следующего рывка. Если через полгода мы зафиксируем множество таких верифицированных ступенек, это станет колоссальным прорывом — даже в отсутствие официального вознесения в рамках нашего протокола.
Размышления об открытости и закрытости
Для создания бота допустимо задействовать мощные коммерческие модели. Я не собираюсь отрицать существование проприетарного ИИ или утверждать, будто участие в открытой науке требует от него отказа. Доступ к передовому инструменту вполне может быть платным и оставаться в частных руках. Вопрос в другом: что останется в сухом остатке после завершения работы — особенно если завтра аннулируют подписку, изменятся правила или появится более совершенная архитектура?
Допустим, нейросеть помогла вам выявить уязвимость в алгоритме поиска пути и переписать проблемный фрагмент. Сама модель, с которой вы вели диалог, может остаться недоступной для остальных. Но исправленный код, логи проверок и история коммитов остаются открытыми. Их можно изучать независимо от вашей подписки и повторных запросов к модели. В этом и заключается истинный смысл open source — не просто декларация благих намерений, а перенос ценности из арендованного черного ящика в общее пространство для дальнейших исследований.
Впрочем, простой публикацией репозитория дело не исчерпывается. Сотня разрозненных проектов не превращается в коллективную науку автоматически. Необходимы единые стандарты валидации, точная привязка версий программ, история эволюции кода и прозрачная атрибуция вклада каждого участника. Иначе даже открытые наработки останутся изолированными демонстрациями. Мне искренне хочется, чтобы удачный промежуточный патч ценился наравне с эффектным финальным роликом — особенно если именно он лег в основу следующего прорыва.
Разумеется, возникает резонный вопрос: зачем делиться находкой, если конкурент мгновенно воспользуется ею и обойдет вас? Универсального рецепта здесь нет. Мы привязываем позиции в рейтинге к открытым версиям кода, демонстрируем успехи по разным классам и вехам. Более того, мы недавно обновили интерфейс сайта, внедрив метрики импакта каждого разработчика, отображение ключевых прорывов и свежих апдейтов. В перспективе мы планируем разыгрывать призы среди участников — следите за анонсами в нашем телеграм-канале.
Сработает ли подобная мотивация в живом комьюнити, покажет время. Это тоже часть масштабного эксперимента — уже не над нейросетевым агентом, а над тем, как люди организуют совместные научные изыскания.
Мне близок подход проекта Fishtest, где улучшения для шахматного движка Stockfish проходят массовую верификацию тысячами партий. Не потому, что NetHack тождественен шахматам — они кардинально разные, — а потому, что там любая мелкая правка получает шанс войти в глобальный релиз на основе объективных тестов, а не красивых описаний автора. Именно этот принцип мы стремимся воплотить здесь.
Вполне возможно, что со временем закрытая лабораторная система успешно одолеет NetHack. Это заслуживает уважения. Но если на выходе мы услышим лишь победный рапорт «мы справились», будущим исследователям не на что будет оперезить в своей работе. Меня гораздо больше привлекает альтернативный сценарий: функционирующий и доступный для запуска код, детальная летопись ошибок и универсальный метод, применимый к другим комплексным задачам. Даже если лавры абсолютного победителя достанутся кому-то другому, ценность совместного открытого труда не обесценится.
У проекта NetHackers есть четкий финишный ориентир: программа, способная стабильно проходить NetHack на любых картах за разных персонажей, превосходя по уровню сильнейших людей-игроков (серии из 61+ успешных прохождений подряд). Однако сообщество не обязано существовать вечно, чтобы приносить пользу. Если оно завершит свой цикл, мне бы хотелось, чтобы после него остались верифицируемые алгоритмы, база побед и поражений, а главное — привычка отличать разовый удачный запуск от работающей методологии. Игра по-прежнему не покорилась машинам в наших условиях, а значит, впереди масса исследовательской работы, требующая свежих идей, качественного кода и здорового упрямства.
Похожие статьи
 Сборы на краудфандинге настольной игры The Lord of the Rings: The King’s Gambit превысили 147 миллионов рублей
 Крах иллюзий: история о несбывшихся надеждах на цивилизацию
 Инсайдер перечислил главные изменения, которые Microsoft внесла по просьбам игроков
 Хидео Кодзима критически высказался о DLSS 5 и заявил, что ИИ не понимает авторского замысла
 Авторы Wuthering Waves нашли необычный способ решения проблемы с нехваткой места на диске
 Xbox не получила эксклюзивные права на облачный стриминг GTA VI, а ПК останется без облачной версии игры
 Энтузиаст собрал миниатюрный аркадный автомат с управлением зубочисткой
 Обзор игры Silent Hill Townfall с рекомендацией воздержаться от прохождения