Нейросеть озвучила всю GTA V на русском: как создать 220 часов речи и не вызвать подозрений у санитаров
Всем привет! Всё началось с видео о нейро-GTA V: к игровым прохожим подключают нейросеть, после чего с ними можно общаться и взаимодействовать. Затея отправиться в приключение со случайным бездомным меня зацепила, и я принялся искать русскую нейроозвучку. Хотелось погрузиться в игру заново и слушать диалоги, а не пробегать глазами по субтитрам, как в первый раз. Тем более я уже примерно представлял, как подключить нейросеть, говорящую по-русски.
Нашёлся, однако, только неполный вариант: довольно неровный и почти одноголосый. Я оценил объём работы и стоимость генерации, пересчитал всё ещё дважды и решил: а почему бы не попробовать? Записал тестовое видео и спросил в своём канале, стоит ли вообще за это браться. А тут ещё и выход GTA VI назначили на 19 ноября 2026 года — наверняка многие захотят перед этим вернуться к пятой части. В общем, я начал.
Меня зовут Илья. Я блогер, основатель ArtGeneration.me и большой поклонник нейросетей. Классическим разработчиком себя не назову: скорее я продакт с двадцатилетним опытом. Поэтому код писал мой инструмент Claude Code, а я формулировал задачи и проверял результат.
В этой статье расскажу, как Rockstar хранит звук и как определить, кто и что произносит в каждом из 260 тысяч файлов. Какие модели помогли распознать речь, разделить голоса на мужские и женские и синтезировать русский текст. А ещё — как уложить озвучку в катсцены, почему игра вылетала, как вернуть звук с помощью мода и сколько всё это стоило.
Небольшой дисклеймер, чтобы избежать споров в комментариях. Нейроозвучка ни в коем случае не превосходит оригинал или работу профессиональной студии. Нейросетям не сравниться с актёрами, и я даже не пытался устроить такое соревнование. Основной вариант здесь — закадровый перевод: русский голос звучит поверх приглушённого оригинала, так что актёров Rockstar по-прежнему слышно.
Что получилось в результате:
-
250 364 русские реплики: сюжет, катсцены, прохожие, радио, реклама, новости, рация, объявления, телевизор и дополнения. С учётом переделок синтезировано почти 219 часов речи
-
два варианта озвучки на выбор: закадр и дубляж
-
около 60 долларов на синтез — агенты Claude работали в рамках подписки — и десять дней работы, из которых почти неделю компьютер занимался распознаванием речи
-
после этого я сам прошёл весь сюжет с новой озвучкой: около 30 часов и море удовольствия. Собственно, ради этого всё и затевалось
Вот как закадровый вариант звучит в игре:
Если захотите попробовать сразу, озвучку сюжета можно скачать с PlayGround. Подробности установки — ближе к концу статьи.
❯ Сколько речи в GTA V
С этого вопроса начинается расчёт бюджета, но готового ответа в интернете я не нашёл. В докладе Rockstar на GDC 2014 упоминаются почти 160 тысяч реплик, а фанатская карта на Nexus содержит 156 тысяч клипов. Мне же нужна была общая продолжительность: стоимость синтеза зависит примерно от длины аудио. Такую цифру нигде не приводили.
Пришлось считать самостоятельно. На помощь пришёл CodeWalker — открытый инструмент для моддеров GTA V, позволяющий изучать игровой мир, файлы и архивы. Исходный код доступен на GitHub, а готовая сборка с поддержкой Enhanced есть только в Discord автора, поэтому я взял исходники. Ядро CodeWalker можно подключить как библиотеку, и Claude Code написал на его основе небольшую программу на C#. Она обходит все архивы игры и заносит в таблицу содержимое каждого звукового контейнера. Для этого не требуется ничего распознавать: в заголовке звукового потока — отдельной реплики или фрагмента аудио — указаны число отсчётов и их количество в секунду. Остаётся разделить одно на другое. Получилось больше 260 тысяч потоков. Для игры 2013 года совсем неплохо.
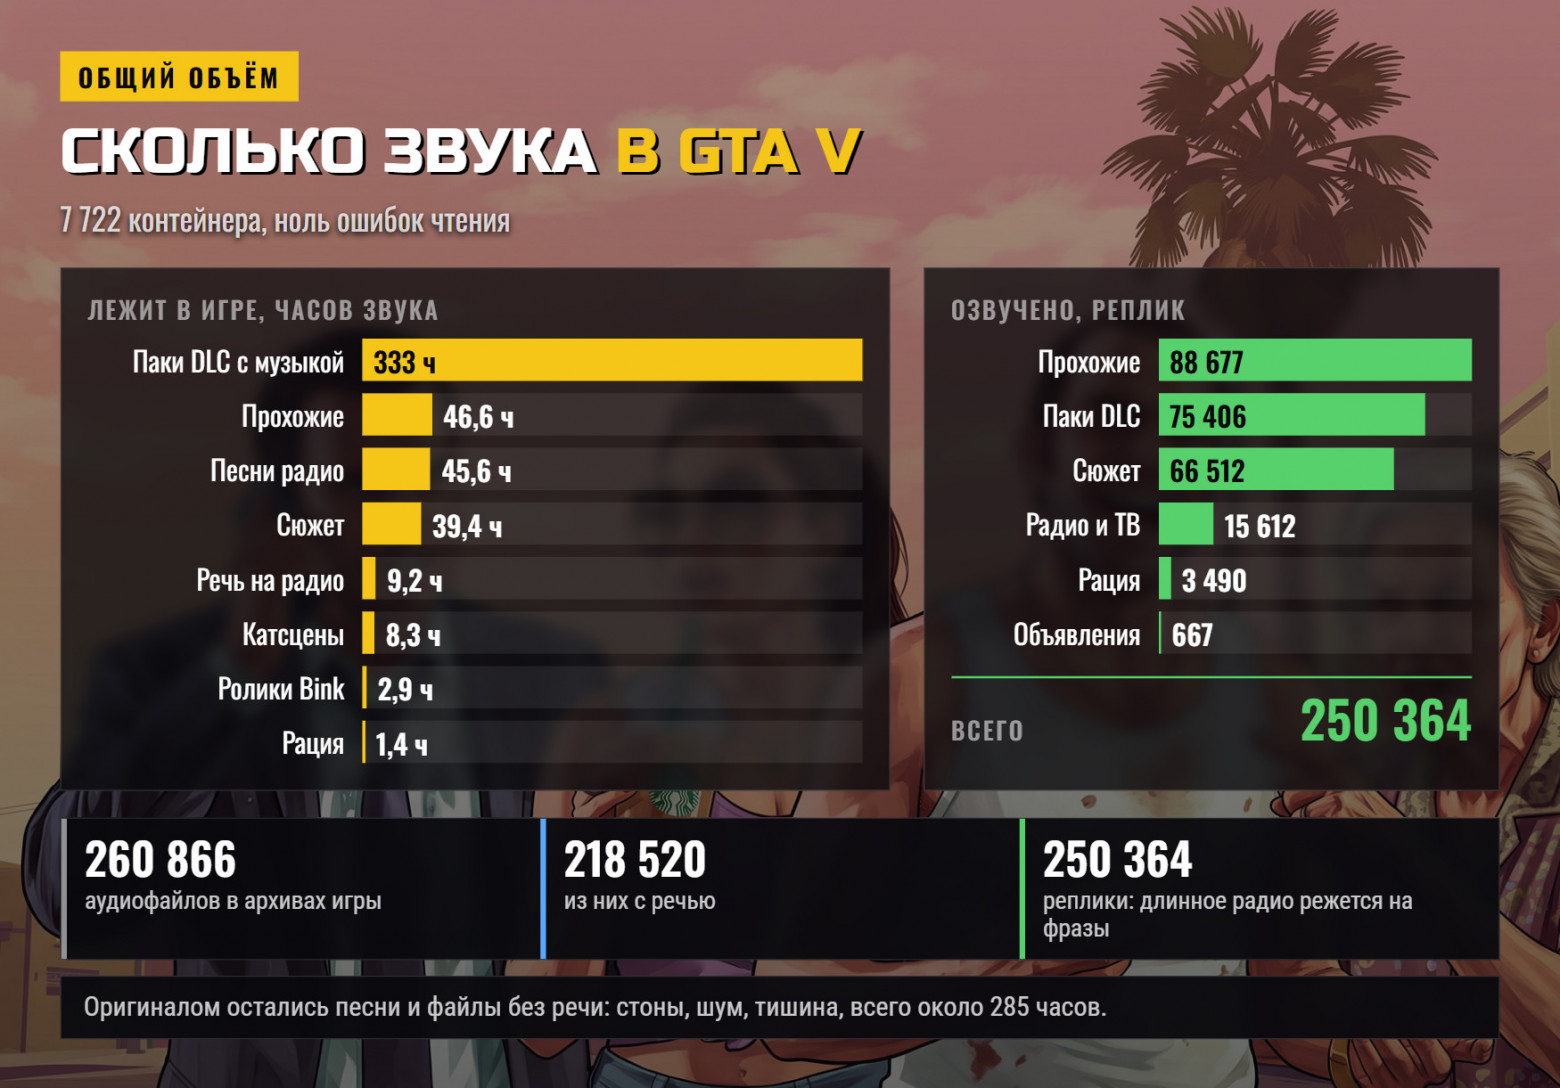
На сюжет и прохожих приходится 150 тысяч реплик — это согласуется с докладом Rockstar. Верхняя строка выглядит ошибкой, но это не она. Позже эта цифра ещё напомнит о себе.
Хорошая новость: в игре есть официальные русские субтитры с теми же ключами, что и у английских. Перевод достойный: сленг и ненормативная лексика на месте, ничего не стали сглаживать. Плохая новость — субтитрами покрыто не всё. У прохожих, радио и рации их нет вовсе, а в самом сюжете без них остаются около 11 тысяч реплик: беседы с друзьями, поездки на такси, разговоры в оружейном магазине. Там речь сначала пришлось распознать, а затем перевести.
С выбором голосового движка я определился не сразу. Пробовал разные варианты — у меня даже есть целая Speech Studio, в которую встроены лучшие из них. Проблема оказалась в ресурсах: даже самой быстрой модели потребовались бы недели, чтобы сгенерировать такой объём на моём компьютере, а качество от этого не стало бы выше.
Разумеется, я испытал и движки с клонированием голоса. Результат разочаровал — и не потому, что голоса были непохожи. Как раз похожи. Подвела актёрская подача: даже лучшие модели с эмоциями, например Fish Audio Drama 3, то переигрывали не к месту, то вставляли задумчивые паузы там, где они совсем не нужны. В итоге я решил не бороться с этим и выбрал просто хорошую TTS-модель, которая не пытается имитировать настоящую актёрскую игру и перекрывать её.
Выбор пал на Gemini 3.8 Flash-Lite TTS в пакетном режиме Google: около 27 центов за час готовой речи. При таком тарифе бюджет получился почти смешным — 45–60 долларов с запасом на переделки. Перевести всю игру дешевле, чем купить её копию. С 1 января 2027 года Google повышает этот тариф вдвое, примерно до 54 центов за час, так что подобные проекты выгоднее делать до конца года.
❯ Как устроено хранение звука у Rockstar
Игровой звук находится в файлах AWC — это собственный формат контейнеров Rockstar, внутри которых лежат аудиопотоки. Полной документации нет: вики GTAMods не описывает версию AWC из GTA V, а остальные сведения разбросаны по исходникам vgmstream и CodeWalker и закрытым форумам. Пришлось изучать сами файлы. Оказалось, что каждая реплика устроена как матрёшка.
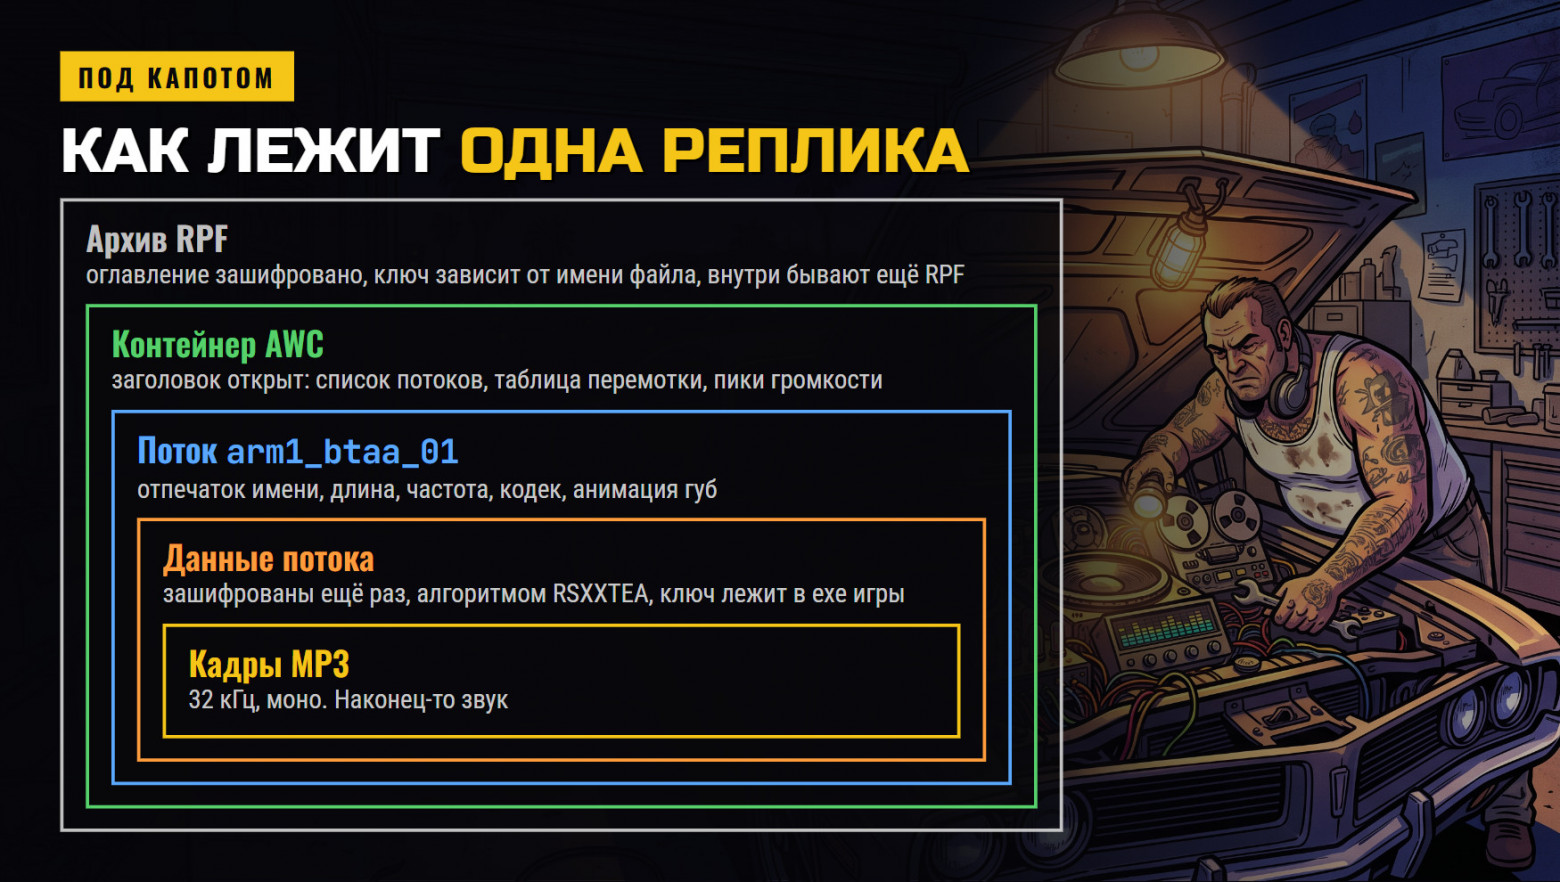
С архивами RPF помог CodeWalker. Таблицы, необходимые для расшифровки оглавления, находятся прямо в GTA5_Enhanced.exe, и инструмент умеет их извлекать. Основные данные лежат в x64\audio\sfx: там 57 архивов-банков. Пакеты обновлений расположены отдельно, в update\x64\dlcpacks. Ключ привязан к имени, поэтому переименованная копия архива уже не читается. Рядом находится кэш оглавлений rpf.cache размером 16 МБ, из-за которого просто подменить архив не получится.
Заголовок AWC, к счастью, открыт. Кодек на схеме — это способ сжатия звука. Неожиданностью стала анимация губ, лежащая рядом с аудио. Позже она пригодится.
Со вторым слоем шифрования пришлось повозиться. На него указывает флаг в заголовке, но CodeWalker проверяет не тот флаг и падает на файлах Enhanced. Верный нашёлся в исходниках декодера vgmstream, хотя сам он такие файлы не открывает. Рабочую последовательность я подсмотрел в открытом проекте gta5_voice: расшифровать данные на месте, сбросить флаг и только после этого декодировать.
В старой версии игры речь хранилась в ADPCM — простом старом кодеке со слабым сжатием, а в Enhanced используется MP3. Если записывать ADPCM, архивы заметно увеличиваются: у меня они стали вдвое больше. При этом CodeWalker не умеет записывать MP3 в AWC. Запомните этот момент — позже он обернётся вылетами.
К тому же каждая часть игры устроена по-своему:
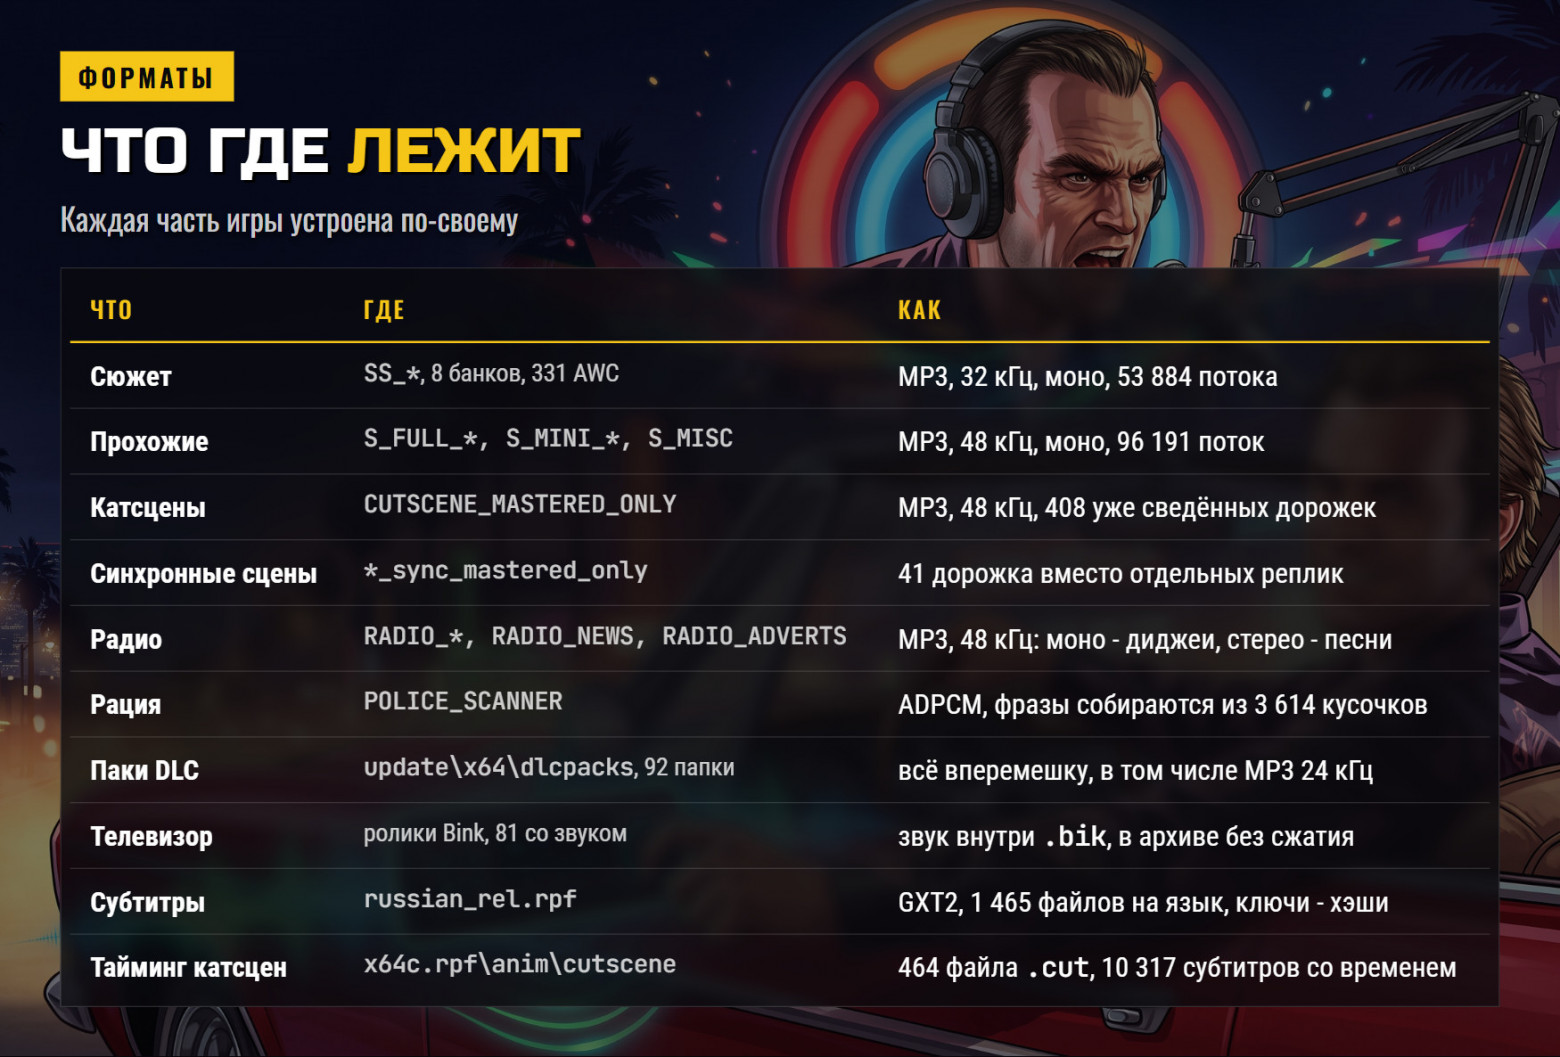
Пока я во всём этом разбирался, обнаружились особенности, которые впоследствии определили работу со звуком.
Голосовой канал катсцены содержит не только голос. Вместе с речью там записаны двери и выстрелы, поэтому полностью заменять его нельзя — исчезнут звуки сцены. Боковые каналы иногда дублируют голос, а иногда содержат музыку и эффекты.
Реплики с пометкой «по телефону» хранятся в чистом виде: эффект добавляет сам движок. Но у некоторых реплик без каких-либо флагов звук рации или мегафона уже встроен в файл. Рация срезает низкие и высокие частоты, поэтому для каждого оригинала приходится измерять оставшийся диапазон и повторять обработку на русском звуке.
В данных диалога предусмотрено поле громкости, но сам файл оно не изменяет — это инструкция для движка. Пиковый уровень у реплик почти одинаков, зато средняя громкость сильно различается. Поэтому я подгоняю каждую русскую фразу под оригинал, чтобы шёпот оставался шёпотом, а крик — криком.
У некоторых реплик из пакетов частота в заголовке отличается от частоты кадров MP3. Игра ориентируется на заголовок. Если довериться кадрам, речь зазвучит на треть быстрее, а наркобарон Эль Рубио из GTA Online запищит на частоте 400 Гц.
❯ Как определить, кто и что произносит
Извлечь звук недостаточно. Нужно связать каждый поток с субтитром и персонажем, но нигде в игре не написано: «файл arm1_btaa_01 — это Ламар, и он произносит такую-то фразу».
Из декомпилированных скриптов я извлёк обработчик диалогов и разобрался в схеме. Миссия вызывает разговор по корню, то есть его названию, например LM2_TAKE. Из корня формируются ключи: LM2_TAKE_1 — субтитр первой строки, LM2_TAKE_1A — соответствующий аудиофайл.
Условный пример на русском: пусть разговор называется УГОН — это корень. Субтитр первой реплики хранится под ключом УГОН_1, а имя звукового файла — под ключом УГОН_1А. Для второй реплики это будут УГОН_2 и УГОН_2А, и так далее до конца диалога. Зная название разговора, можно пройти по всем строкам и получить пары текста и аудиофайла.
Оставалось найти все корни. Поиск строк в коде миссий охватил 62% потоков, после чего застопорился: часть корней скрипты собирают на лету.
А дальше случилось то, что мне понравилось больше всего. Ключ в файле субтитров — не имя, а его отпечаток, или хэш: короткое число, вычисленное из текста по формуле. Просто восстановить имя по нему нельзя. Формула называется joaat (Jenkins one-at-a-time), и движок Rockstar применяет её повсюду. Самого имени у меня нет. Но joaat обрабатывает буквы по одной, а в конце выполняет финальное перемешивание, которое можно обратить. Берём отпечаток субтитра, отменяем финальное преобразование, добавляем букву A, снова перемешиваем — и получаем отпечаток аудиофайла той же строки. Знать имя не требуется. Красиво же! Например, LM2_TAKE_1 даёт 99A52B58, а из этого числа получается 30D659F0, то есть LM2_TAKE_1A. Таким образом удалось связать 75% сюжетных потоков.
С определением говорящего получилось ещё интереснее. Нумерация в сценариях не сквозная. Возьмём «Франклин и Ламар» — первую миссию после пролога. Герои работают на автосалон Симеона, забирают у должника две неоплаченные машины, гоняют по городу и уходят от полиции. В игровых файлах миссия называется Armenian 1, и номер ноль в ней обозначает не Майкла, а Франклина. Зато в каждом речевом потоке хранится та самая анимация губ, а внутри неё — путь вида …/SCRIPTED_SPEECH/<банк>/<ПЕРСОНАЖ>/…/<метка>.clip. Игра сама указывает, кому принадлежат губы. Так удалось определить говорящего почти для всех сюжетных потоков, кроме одного.
В катсценах такой подсказки нет. Там я брал имена говорящих из расшифровок на вики и сверял голоса с репликами известных персонажей с помощью модели WeSpeaker.
❯ Как вернуть звук в игру и почему это именно мод
Главный риск проекта заключался в том, получится ли вообще поместить звук обратно. Возможных подходов было три.
Первый — изменять игровые архивы напрямую. На вид это самый простой путь, но Enhanced его не принимает и выдаёт ERR_STR_MISSING - Corrupt game data. Я восстановил оригиналы из резервных копий и больше к этому варианту не возвращался.
Второй — распространять готовые архивы Rockstar. Это означало бы раздавать 10 ГБ чужих файлов, чего мне не хотелось ни из-за размера, ни из принципа.
Третий — разместить рядом с игрой папку mods, повторяющую её структуру, например mods\x64\audio\sfx\SS_NP.rpf. Загрузчик будет подсовывать игре эти файлы вместо оригинальных. Оригиналы остаются нетронутыми, обновления игры и проверка файлов не ломают мод, а для удаления достаточно убрать одну папку. В качестве загрузчика используется открытый RageOpenV вместе с Ultimate ASI Loader. OpenIV официально не поддерживает Enhanced, а OpenRPF закрыт и на моей версии игры не проверялся. RageOpenV также обходит тот самый rpf.cache.
Архив в mods собирается следующим образом: берётся игровой архив, в нём заменяются только необходимые звуковые контейнеры AWC, а всё остальное сохраняется байт в байт. Поэтому установщику достаточно содержать новый звук: архивы он соберёт на компьютере игрока из его собственных файлов. Чужие файлы я не распространяю.
Для этого Claude Code написал поверх CodeWalker утилиту gta-patch. Она берёт игровой контейнер и заменяет в нём потоки русским звуком. Сначала утилита записывала ADPCM — так быстрее всего удалось проверить, работает ли подмена в принципе. В итоге она стала создавать файл один в один по устройству как у Rockstar. Почему это важно, расскажу в разделе о вылетах.
❯ Конвейер и модели: что я выбрал и почему
Правило было одно: в облаке работают только синтез и агенты Claude, всё остальное выполняется локально на RTX 4090. Конвейер, или харнес — набор программ и правил, в рамках которых действует агент, — я назвал Game Dub. Выглядит он так:
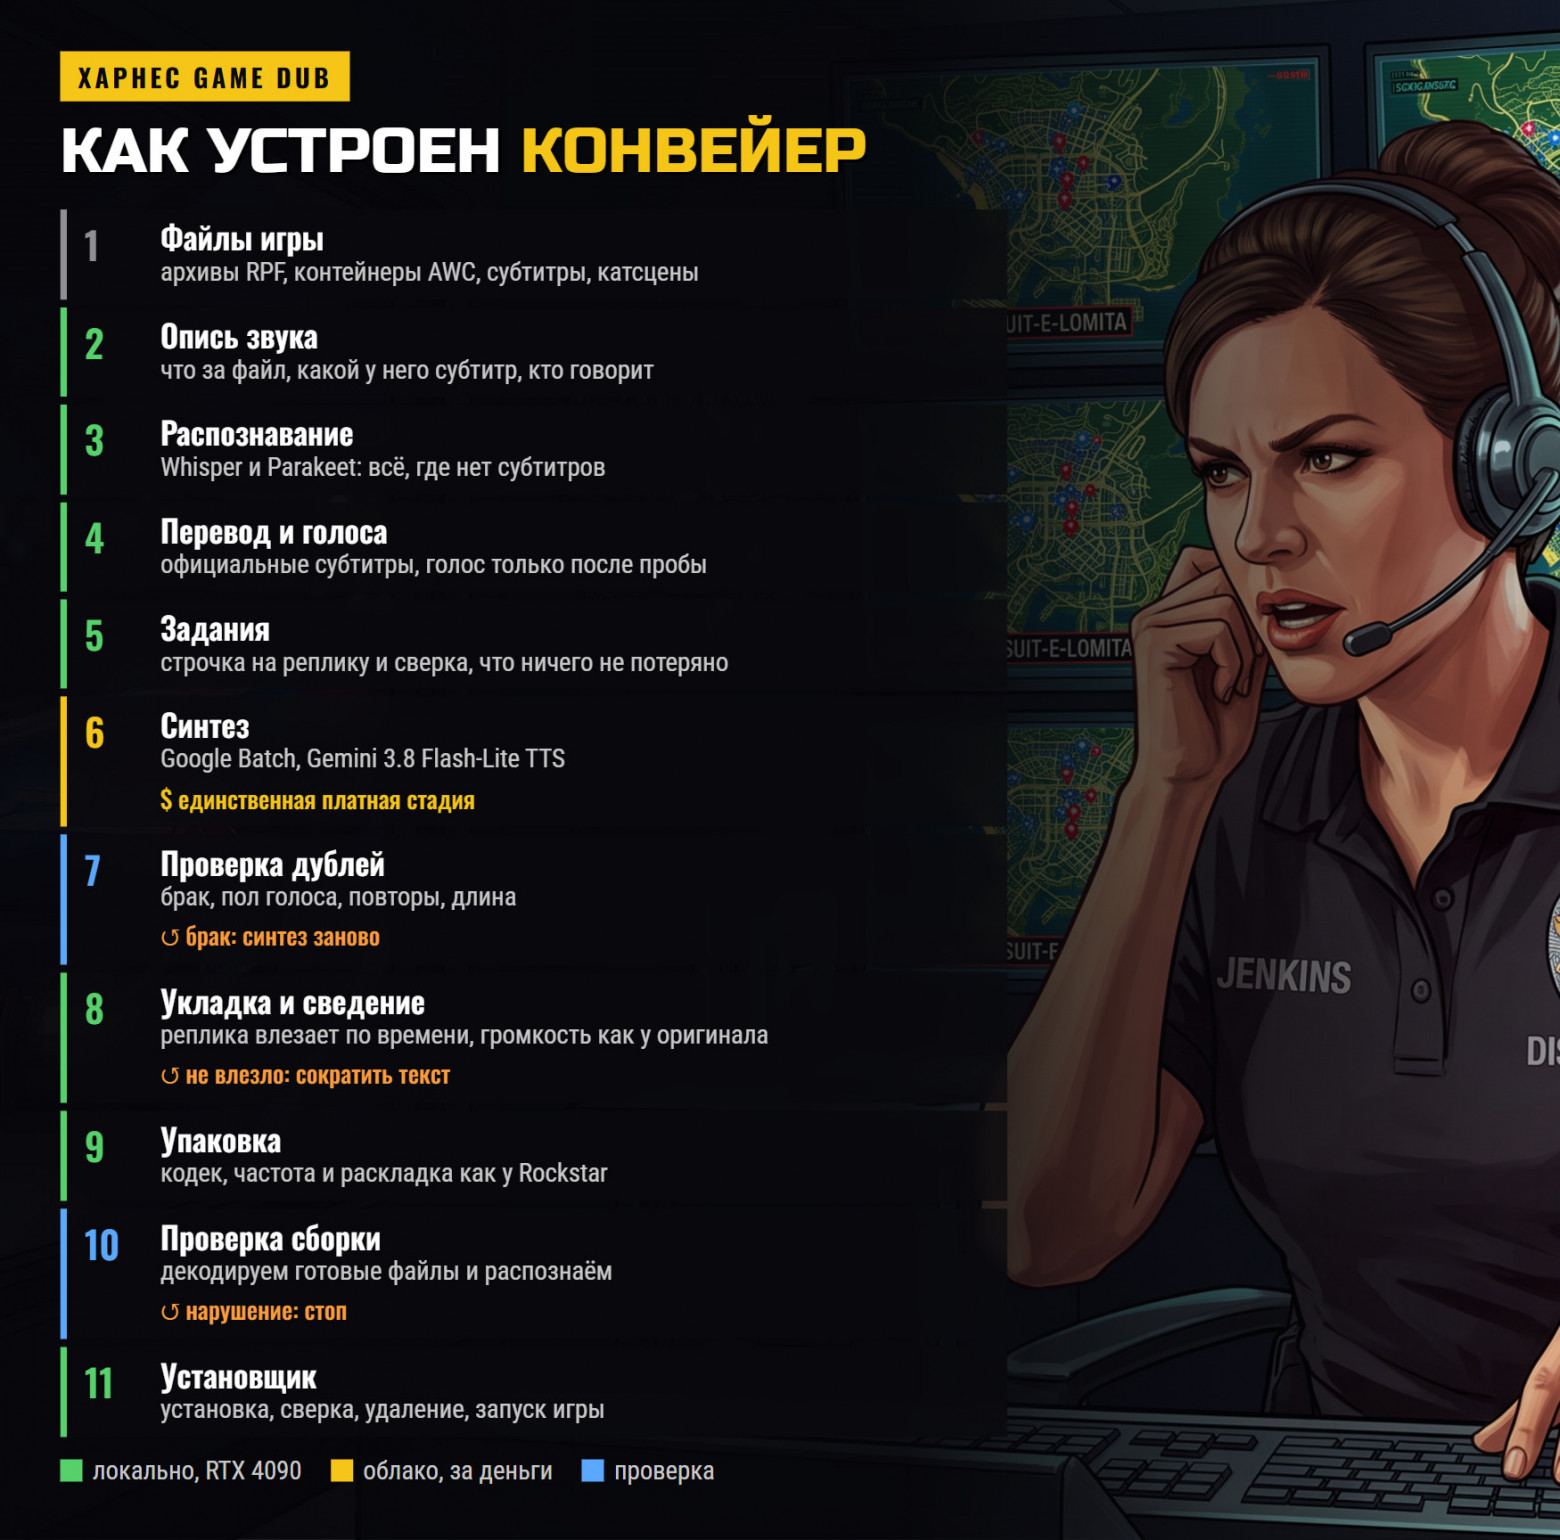
Модели я отбирал на основании практических тестов:
|
Задача |
Модель |
Почему выбрана |
Недостатки |
|---|---|---|---|
|
Синтез |
Gemini 3.8 Flash-Lite TTS |
на слух лучше Flash, Qwen, MAI, Grok, MiniMax, Fish и Seed; в пакетном режиме вдвое дешевле |
пол в каталоге голосов указан не всегда верно |
|
Распознавание |
Whisper large-v3 |
работает локально, выдаёт таймкоды слов, справляется с длинной речью |
придумывает слова на участках тишины |
|
Второе мнение |
около пяти дублей в секунду; замечает повторы, которые Whisper объединяет |
не распознаёт короткие фрагменты |
|
|
Отделение голоса |
bs_roformer, модель voc_fv6 |
обрабатывает 16 секунд аудио за полсекунды |
принимает крики толпы за голос |
|
Пол голоса |
77 правильных определений из 80 на известных персонажах |
до этого я измерял высоту тона, но алгоритм цеплялся за гармонику и записал Майкла в женщины |
|
|
Определение говорящего |
WeSpeaker |
сравнивает голос с репликами известных персонажей |
может ошибаться на протяжении целых сцен, поэтому нужна проверка |
Распознавание, отделение голоса и проверка синтеза взяты из моей Dub Studio, копия которой находится прямо в проекте. Там, где готовых решений не было, Claude Code писал собственные программы. Одни занимаются сведением: вычитают английский голос, сжимают русский компрессором и приводят его громкость к оригиналу. Другая объединяет короткие реплики в фрагменты до 27 секунд: по отдельности Whisper распознаёт их плохо, а при склейке пустых результатов становится почти вчетверо меньше. Ещё одна вырезает лишнее слово из готового дубля, чтобы не платить за повторный синтез. Последняя проверяет, что ни один игровой файл не потерян.
Всё написано на Rust, скриптах и C#, без Python: мои студии давно используют этот стек, и возвращать Python в сборки мне не хочется.
На вход синтезатора каждая реплика поступает в таком виде:
{"character":"LAMAR","key":"arm1_btaa_01","model":"gemini-3.8-flash-lite-tts","text":"Да, надо как следует вкалывать, чтобы гонять на такой тачке."}
Поля «голос» здесь нет: оно берётся из карточки персонажа, о которой расскажу ниже.
Whisper нужен везде, где отсутствуют субтитры. За время работы я узнал о нём немало нового. На стонах и плаче он выдаёт чужие титры вроде «Субтитры сделал DimaTorzok». На радиомиксах зацикливается и пишет «A little pause… and we are back» поверх настоящей речи. А английские фразы корейских бандитов записывает хангылем: «커버미!» — это, если что, «Cover me!».
Галлюцинации Whisper настолько типичны, что для них существуют готовые списки: из работы университета AGH, представленной на ICASSP 2025, и из NVIDIA NeMo. Я взял их за основу и добавил выдумки, характерные для этой игры.
Первый этап вообще обходится без нейросетей — это обычная эвристика. Скрипт читает текст и помечает фразу, если она целиком совпадает с записью из списка, повторяется подряд или встречается в одном файле не меньше трёх раз; если в ней пять и более слов, а уникальных среди них не более 40%; либо если попалось слово длиннее 25 букв. Но пометка ещё не означает удаление. Соответствующий фрагмент аудио вырезается и отправляется второй модели — Parakeet, устроенной иначе. Для одного звука получаются два текста, которые можно сопоставить. Если Parakeet услышал хотя бы треть тех же слов, это речь. Не услышал ничего — вероятно, выдумка, и озвучивать её не нужно. Услышал больше Whisper — беру его вариант. Просто удалять всё из списка нельзя. Например, «Thank you» — типичная галлюцинация Whisper, и в наборе реплик умирающего прохожего это, скорее всего, ошибка. Но в наборе, где прохожий кого-то благодарит, фраза настоящая. Поэтому окончательное решение принимает не список, а вторая модель.
Там, где субтитров нет, переводом занимается Claude Code, и результат приходится вычитывать. «I’m cold» может означать «я пас», а не «мне холодно»; мат модель стремится смягчить; женщины обращаются к игроку словами «ты врезалась»; а крики записываются капсом, который модель озвучки читает по буквам. Параллельные агенты-помощники справлялись хуже, поэтому в итоге перевод выполнял один агент с учётом соседних реплик. Ещё фильтр Google отказывался озвучивать фразы, где рядом с темой секса встречалось слово «малышка»: он связывал его с несовершеннолетними, хотя в GTA так могут называть машину.
В игре больше тысячи говорящих. Я никого не клонирую: голоса берутся из библиотеки Google, причём у каждого персонажа один голос на всю игру. Сначала нужно определить, мужчина это или женщина. Для этого реплики каждого говорящего анализирует ECAPA-TDNN — модель, которая оценивает вероятность того, что голос женский. Для главных героев пол и возраст берутся из вики: эти сведения важнее результата модели.
Затем нужно проверить сами голоса Google. В каталоге указано поле пола, но оно бывает неверным: голос с пометкой «male» может звучать как женский. Поэтому каждый голос сначала испытывается на трёх репликах — это стоит копейки — и используется только тогда, когда две модели согласны с его полом. Однажды я отложил эту проверку, и первый большой пакет принёс сотни дублей с голосами не того пола. После синтеза проверка повторяется: пол готового дубля сравнивается с полом персонажа, а несовпадения отправляются на разбор.
Следующий вопрос — подача, то есть манера произношения. Gemini поддерживает описание стиля вроде «в ужасе, голос дрожит» и теги наподобие
Синтез выполнялся через Batch — пакетный режим Google: отправляешь реплики пачкой, результат приходит не сразу, зато обходится вдвое дешевле. Очередь ограничена примерно семью тысячами реплик на модель одновременно, поэтому сюжет нужно подавать порциями. Кроме того, при обрыве связи SDK автоматически повторял создание пакета, а для Google каждый повтор означал новый пакет. При плохом VPN можно было случайно оплатить весь сюжет дважды. Автоматические повторы я отключил.
Ошибки синтеза редки, но эффектны: например, реплика «Кто это?» продолжительностью 210 секунд. Такой брак выявляет собственный детектор, тоже без нейросетей — только математический анализ звука. Он сопоставляет длительность с текстом: больше 0,4 секунды на символ означает, что дубль затянулся, меньше 0,045 — что он оборвался. По количеству слогов и обычному темпу голоса детектор рассчитывает ожидаемую длину. Если результат в 1,3 раза длиннее, возможен повтор. Сам повтор ищется сравнением аудио с ним же: дважды произнесённая фраза проявляется полосой на карте похожести. Перегрузка определяется по нескольким подряд значениям сигнала у потолка, свист — по резкому пику в спектре длинной реплики. Дополнительно проверяются шум в паузах и слишком длинные паузы внутри фразы. Весь сюжет детектор обходит за четыре секунды.
Подозрительные дубли повторно распознаются обеими моделями. Whisper объединяет повторы, Parakeet их замечает. Если хотя бы одна из моделей услышала лишнее слово, реплика отправляется на новый синтез.
❯ Катсцены и ночь со щелчками
Моя любимая история этого проекта. Хотя «любимая» — громко сказано: до сих пор вспоминаю с дрожью. Для дубляжа катсцены нужно убрать английский голос, сохранив двери и выстрелы. Схема выглядит так:
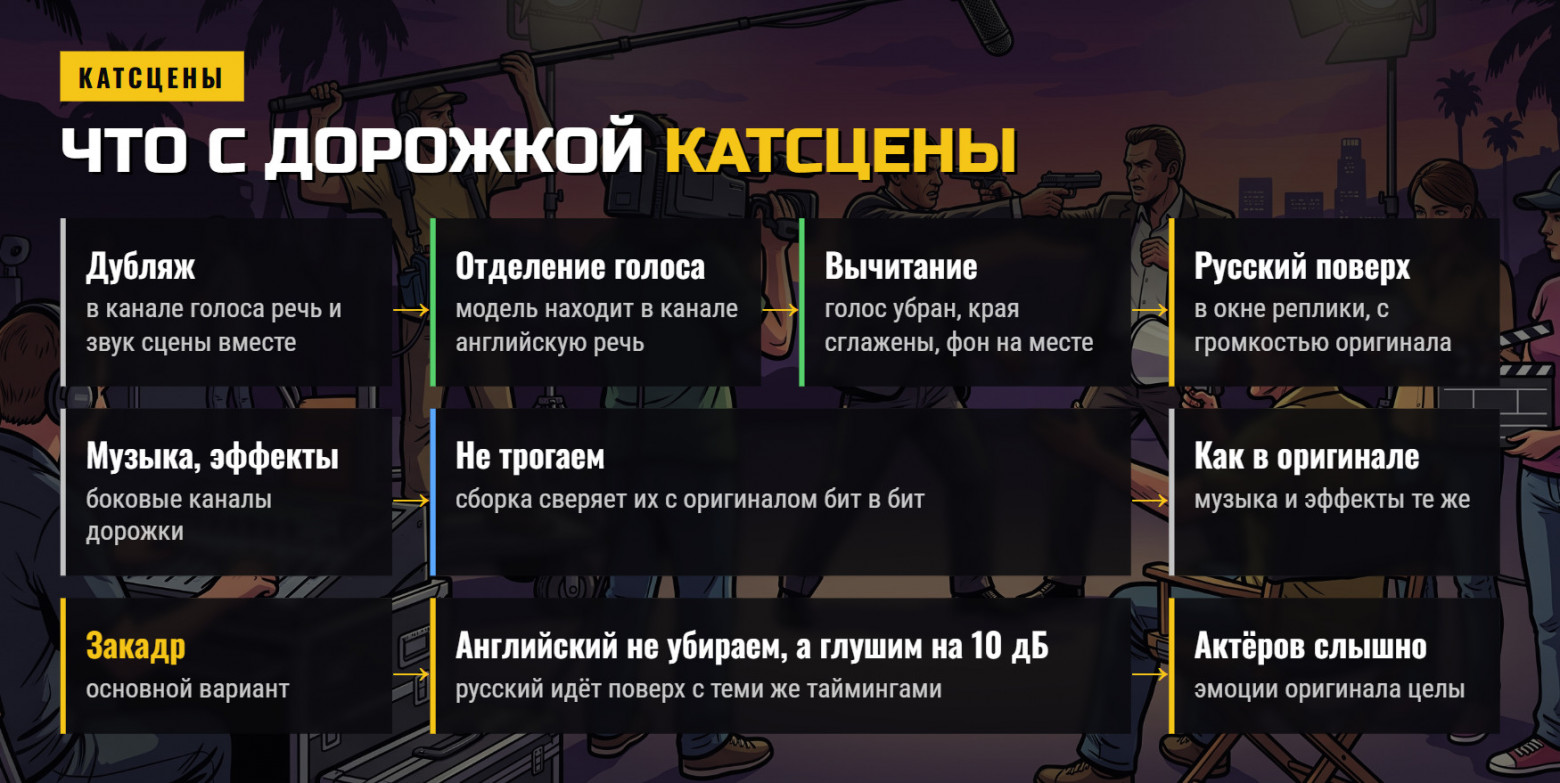
Но до неё ещё нужно было добраться. Отделение голоса по всем каналам убирало фон, а обработка только в окнах реплик вызывала щелчки на границах фраз. К утру я перепробовал десять вариантов сведения, и почти в каждом что-нибудь щёлкало. На границах находились всплески, вокруг которых строились гипотезы. Потом я применил тот же измеритель к случайным участкам дорожки и обнаружил почти столько же всплесков. Иными словами, измеритель реагировал на обычный фон.
Утром причина наконец нашлась — и заключалась она вовсе не в катсценах. Я сделал то, с чего следовало начать: извлёк из mods собранный архив с репликами пролога, декодировал их и сравнил с исходниками. Совпало всё, кроме самого конца каждой реплики — последних 40–180 сэмплов. Сэмпл — это одно значение звуковой волны, а в секунде их десятки тысяч. На этих участках сигнал упирался в потолок: громче записать его уже было невозможно.
Кодер ADPCM в CodeWalker выделял буфер, не учитывая четырёхбайтовые заголовки блоков. Конец реплики не кодировался, но в заголовке сохранялось полное число сэмплов. Игра исправно доигрывала недостающий фрагмент чужими байтами из соседних частей архива. Семь миллисекунд мусора на максимальной громкости в конце каждой русской реплики. Именно эти хвосты сопровождали все мои ночные поиски щелчков.
С тех пор у меня два правила: проверять нужно готовый файл, который воспроизводит игра, а любой измеритель сначала испытывать на случайных участках.
Отдельной задачей стала громкость. Пролог заговорил по-русски, и первая претензия оказалась простой: в оригинале герои кричат, а у тебя шепчут. Самодельный измеритель показывал разницу в 0,3 дБ, но по EBU R128 — телевизионному стандарту, учитывающему человеческое восприятие громкости, — русская дорожка была заметно тише. Оригиналы Rockstar сильно сжаты по динамике, а синтезированная речь звучит спокойно. Теперь на каждую реплику ставится компрессор, громкость подгоняется под оригинал с небольшим запасом, а сборка автоматически проверяет результат.
Закадр изначально задумывался как дополнительная опция, но стал основным вариантом. Английский приглушён так, как это обычно делают русские студии закадрового перевода: актёров слышно, а русский текст легко разобрать. Я послушал результат и написал, что закадр получился очень хорошим. С тех пор именно его и рекомендую. Вот закадр и дубляж на одних и тех же фрагментах:
Для раций и громкоговорителей частоты и эхо подстраиваются под оригинал каждой фразы. Иначе русский голос звучит чисто, словно человек стоит рядом, хотя по сюжету он говорит через рацию.
❯ Укладка: как вместить русский текст в английский хронометраж
Русский текст заметно длиннее английского. Для прохожих это не проблема: их фразы звучат независимо от сцены, и игра просто воспроизводит файл до конца. В катсценах всё привязано ко времени, поэтому реплика должна закончиться до начала следующей. После синтеза сюжета в отведённый интервал не помещалась примерно треть фраз катсцен.
Поэтому система проверяет каждую реплику и не собирает результат, если одна фраза накладывается на следующую. Исключение сделано для восьми реплик, которые и в оригинале звучат внахлёст, например когда участники ток-шоу перебивают друг друга.
Сначала удаляется тишина по краям, затем звук ускоряется, но не более чем в 1,15 раза. Если этого недостаточно, текст сокращается и синтезируется заново. Сокращать тоже нужно аккуратно. Сначала я просто обрезал слова, но результат мне не понравился: фраза получалась рваной. Больше так делать не буду. Для радио Claude Code предложил заменить «Не унывайте только из-за того, что стареете» на «Не грустите, что стареете». Так теряются юмор и смысл — лучше уж ускорить. Поэтому для радио допустимое ускорение увеличено до 2,0: ведущие и в оригинале тараторят. Короткие выкрики ускоряются сильнее, поскольку Gemini не умеет произносить их ещё короче.
Последней поддалась реплика «Ни Тезис, ни Антитезис» из побочной истории о секте. Она превратилась в «Ни теза, ни антитеза» и уложилась во время с восемнадцатой попытки.
❯ Вылеты: слоты памяти и таблица перемотки
При проверке пролога всё работало. Затем я собрал всю игру, установил озвучку, сел играть — и начались вылеты. В журналах Windows и загрузчика модов ничего полезного не оказалось, поэтому причины пришлось искать по одной. Общим было следующее: устройство моих файлов отличалось от файлов Rockstar, а игра рассчитана именно на оригинальную структуру.
Первая причина — размер. Для некоторых звуков, например переговоров полицейских по рации, игра заранее выделяет слот памяти фиксированного объёма. Оригинальные фразы в него помещаются, а мои были записаны с частотой 48 кГц и превышали размер слота в два с половиной раза. Я перекодировал их в 16 кГц, как у Rockstar, и проблема исчезла.
Вторая причина — формат. Здесь снова всплыл MP3, который CodeWalker не умеет записывать. Реплики радиодиджеев у Rockstar хранятся в MP3, а у меня были в ADPCM и занимали вдвое больше места. Claude Code разобрал формат Rockstar и научил утилиту записывать MP3, а проверка начала сравнивать каждый поток с оригиналом ещё до запуска игры. Заодно обнаружились уличные объявления с частотой 48 кГц вместо исходных 12–24 кГц — их я тоже исправил. Но игра всё равно вылетала.
Тогда я предложил изучить дампы. При вылете игра сохраняет снимок памяти в папку CrashLogs. Claude Code разобрал его и выяснил, что сбой происходит при поиске нужной позиции в таблице перемотки. Эта таблица служит оглавлением аудиопотока: она показывает, с какого места файла начинается тот или иной момент звука. Она необходима, потому что радио в GTA включается не сначала, а с середины — будто станция играла всё это время, — и игра перематывает поток.
Третья причина — порядок данных в файле. У Rockstar все служебные таблицы располагаются перед звуком, а моя утилита записывала таблицу перемотки после него. Игра держит в памяти только заголовок файла, поэтому до таблицы не добиралась, читала мусор вместо адреса и падала. Теперь расположение данных в каждом файле автоматически сравнивается с оригиналом. После этого вылеты прекратились.
Почти. Уже в финальной сборке я переключил телевизионный канал, и игра снова упала: ролики оказались в архиве сжатыми, тогда как у Rockstar они хранятся без сжатия. Теперь с оригиналом сверяется и способ хранения каждого файла.
❯ Как я едва не упустил 333 часа звука
Всё было собрано, я играл и нарезал запись для публикации, когда вдруг задумался: почему реклама на радио звучит по-английски? А потом заметил, что и телевизор не переведён.
В отчёте о покрытии обнаружилась строка: 333 часа звука из пакетов обновлений — «вне объёма: GTA Online / музыка DLC».
Я никогда не принимал такого решения: с первого дня задача состояла в озвучивании всей речи игры. Это правило Claude Code самостоятельно вписал в код проверки, даже не открыв пакеты. Проверка честно показывала 100%, потому что учитывала только оставшийся в объёме материал. Между тем в пакетах находятся эфиры и радиостанции, которые звучат и в сюжетном режиме. К тому моменту я уже опубликовал сообщения о том, что озвучена вся игра. Пришлось их удалить.
Аналогичным образом выпала часть звуков, помеченных как «не речь» без какого-либо распознавания. Позже среди них нашлись сцена пыток из сюжетной миссии и объявления в аэропорту.
После этого первым пунктом в правилах стало требование: любое решение «не брать» или «пропустить» принимается только с моего согласия, а сверка проводится по полному списку игровых файлов.
Пакеты я пропустил через тот же конвейер. Примерно для 40% нашёлся официальный русский текст, остальное пришлось распознавать.
Телевизор в игре состоит из видеороликов формата Bink: передач, мультфильмов и рекламы. Звук вставляется официальной утилитой RAD без перекодирования; кадры тестового ролика совпали с оригиналом. Для передач тоже имеются официальные русские субтитры.
Иностранная речь. В игре много испанского, китайского и корейского. Сначала я оставлял её в оригинале, а потом решил попробовать русский с акцентом. Лучший результат дало сочетание акцента прямо в тексте и описания подачи — это единственное исключение из правила пустой подачи: «дэлаешь», «пендехо», «мадре миа». Песни я не изменял.
❯ Расходы и неожиданный счёт
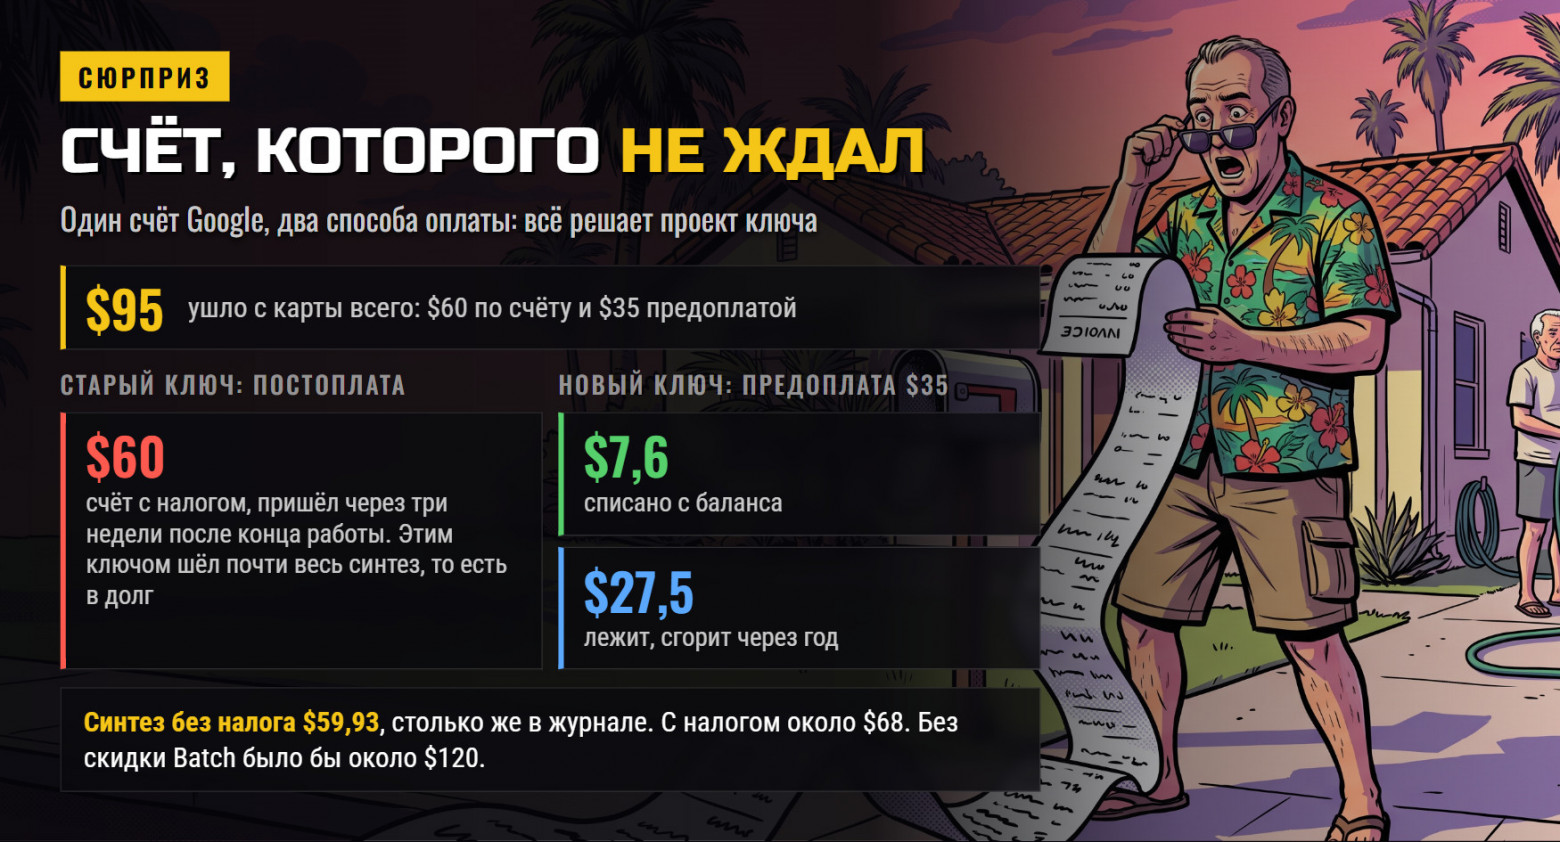
Итоги по журналу пакетных заданий:
|
Раздел |
Дублей |
Часов речи |
Долларов |
|---|---|---|---|
|
Сюжет и побочные задания |
106 066 |
100,8 |
27,59 |
|
Прохожие и герои |
118 699 |
81,1 |
22,22 |
|
Радио и рация |
17 584 |
18,4 |
5,03 |
|
Пакеты, длинные потоки и ролики |
20 497 |
18,5 |
5,08 |
|
Итого |
262 846 |
218,7 |
59,93 |
Дублей больше, чем реплик в готовом выпуске, потому что таблица включает все переделки. Получается около 27 центов за час синтезированной речи.
А теперь о сюрпризе. Ближе к завершению старый ключ упёрся в «monthly spending cap». Я внёс около 35 долларов предоплаты, создал новый ключ и успокоился: всё оплачено. Работа закончилась, я прошёл игру. А через три недели Google выставил дополнительный счёт на 60 долларов. Я совершенно не понял, за что: ведь у меня была предоплата.
Начал разбираться. Оказалось, в одном платёжном аккаунте Google могут одновременно существовать два способа оплаты — предоплата и постоплата. Какой именно используется, зависит от проекта, в котором создан ключ. Почти весь синтез выполнялся старым ключом из проекта с постоплатой, то есть в долг. А внесённая предоплата осталась почти нетронутой.
Данные журнала сошлись со счётом. Лишние проекты я отвязал от платёжного аккаунта, и теперь Gemini оплачивается только из предоплаты. Когда баланс закончится, запросы остановятся, зато неожиданных счетов не будет. Совет: перед платным запуском проверяйте не только баланс, но и способ оплаты проекта, к которому относится ключ.
❯ Дисковое пространство, время и оборудование
Сама игра занимает 96 ГБ, а в разобранном виде проекту требовалось порядка 300–500 ГБ: распакованный звук, отделённые голоса, все версии дублей и пробные сборки. Во время работы мне ежедневно приходилось удалять примерно по 500 ГБ временных файлов — места не хватало. Одна оценка укладки радио занимала около 4 ГБ; 22 таких запуска за день полностью забили диск, и сборка остановилась на середине.
Готовые архивы всей озвучки вместе с неизменёнными данными Rockstar внутри занимают около 69 ГБ. Всё, что не отправлялось в облако, обрабатывала одна видеокарта RTX 4090: распознавала речь, отделяла голос от фона, определяла пол и говорящих, проверяла готовые дубли. Судя по временным отметкам файлов, она отработала не менее 60 часов.
❯ А потом я наконец прошёл игру
Когда всё было готово, я сел и полностью прошёл сюжет. На это ушло около 30 часов, и это были прекрасные 30 часов. При первом знакомстве с пятой частью мне приходилось читать субтитры на ходу. Теперь я еду по Лос-Сантосу и слушаю, о чём спорят Майкл, Франклин и Тревор, а заодно — что говорят прохожие и ведущие радио. Получилось что-то вроде переводов времён Фаргуса: узнаваемо, иногда смешно, иногда с неподходящей интонацией. Но играть с такой озвучкой мне гораздо приятнее, чем без неё, особенно когда перевод полный и без цензуры. И да, она по-прежнему не лучше оригинала и не претендует на это.
❯ О недостатках без прикрас
Раз уж я начал с дисклеймера, им стоит и закончить — хотя кто-нибудь всё равно напишет об этом в комментариях. Актёрской игры здесь нет: синтез говорит ровно, крики звучат тише, чем у актёров Rockstar, и исправить это можно только другим синтезом. Губы живут отдельно от речи: артикуляция остаётся английской, а местами голос ускорен или текст сокращён.
Ошибки перевода неизбежны. Для прохожих и радио официальных субтитров нет, поэтому используется цепочка из распознавания и нейроперевода, а вручную проверить 250 тысяч реплик невозможно. Голоса повторяются: сотни второстепенных персонажей делят ограниченный набор, поэтому иногда разные прохожие говорят одним голосом. Возможны и вылеты. Все известные причины я устранил, сам прошёл игру и больше с ними не сталкивался, но проверить каждое место и каждую ситуацию невозможно.
Кроме того, в GTA Online с этой озвучкой поиграть не получится. Античит BattlEye блокирует загрузчик модов — игроки присылают мне соответствующие логи. Без загрузчика не работает и озвучка. Решения этой проблемы у меня пока нет. При этом онлайн тоже переведён, так что, возможно, вы вместе со своим агентом сумеете что-нибудь придумать.
❯ Установка
Мне хотелось, чтобы озвучка устанавливалась как обычная программа: скачал, трижды нажал «Далее» — и играешь. Файлы получились большими, а NSIS с ограничением в 2 ГБ не подошёл. Поэтому установщик создан на Inno Setup.
Понадобится GTA V Enhanced — версия с файлом GTA5_Enhanced.exe. Legacy не подойдёт. Зато работает версия с торрентов: я проверял на Grand.Theft.Auto.V.Enhanced-InsaneRamZes.
Скачайте с PlayGround архив с закадром или дубляжом — он занимает около 2 ГБ. Распакуйте архив и запустите установщик. Загрузчики модов уже включены, отдельно устанавливать их не нужно. Во время установки на диске с игрой потребуется около 7 ГБ свободного места, после установки озвучка займёт примерно 5 ГБ.
Одновременно можно установить только один вариант. Чтобы его сменить, сначала удалите предыдущий. Я рекомендую закадр. Удалить озвучку можно через параметры Windows: в списке приложений она называется «Нейроозвучка GTA V». После удаления игра останется в исходном состоянии.
❯ Что дальше
Если бы я начинал заново, первым делом настроил бы сверку формата файлов с оригиналом и проверку объёма по полному списку игровых файлов. Именно на этом ушло больше всего нервов.
Удалять игру не хочется — её мир затягивает. Думаю собрать собственный сюжетный пак: перенести дополнения из онлайна, добавить фанатские миссии и сразу всё локализовать. Посмотрим, удастся ли заставить это работать вместе.
Расскажите в комментариях, какую игру вам хотелось бы услышать на русском. А если установите озвучку, поделитесь находками: где она звучит забавно или не попадает в интонацию. Живому игроку такие места заметить проще, чем любой автоматической проверке.
Скачать озвучку сюжета — закадр или дубляж — можно на PlayGround. Больше о нейросетях и моих проектах — на YouTube и в Телеграме.
Всех обнял! Удачных поездок по Лос-Сантосу.
Похожие статьи
 PlayStation готовит масштабную рекламную кампанию Until Dawn 2 — игра оказалась крайне жестокой
 Rockstar не доверяла секреты GTA V даже исполнителям главных ролей
 Phantom Blade Zero начиналась как скромная инди-игра, а теперь её авторы покоряют индустрию
 За пять дней на Xbox выйдут 29 игр, в том числе неожиданные новинки
 Final Fantasy Resonance не возглавила японский чарт, уступив неожиданной игре
 Показали геймплей Smalland 2 — будущего серьёзного конкурента Grounded 2
 Nintendo незаметно внесла изменения в Switch 2, благодаря которым консоль стало намного проще ремонтировать
 Sony пытается остановить очередной взлом PS5 с помощью новой прошивки