Нейросеть на списанном железе: как Bonsai 2 27B уступила Qwen3 8B
В моем распоряжении были старая майнинговая NVIDIA P104-100 2017 года с 8 ГБ видеопамяти, почтенный i7-3770 2012 года, поддерживающий лишь AVX, ровно 15,5 ГБ оперативной памяти, NVMe-накопитель и HDD. Последний я взял специально, чтобы измерить мучительно долгий запуск. Для работы нейросетей такой набор, конечно, не обязателен, но если уж собирать домашний стенд, то подходить к делу стоит основательно. Больше всего меня беспокоили телефоны.
Мы были где-то на окраине пустыни технологического прогресса, когда железо начало плавиться… Впрочем, в действительности все оказалось куда прозаичнее.
Для проекта мне требовалась локальная модель: без облака и на компьютере, который уже стоит под столом. Так я наткнулся на Bonsai 2 27B. Разработчики обещали разместить модель класса 27B в 8 ГБ памяти старой видеокарты. Запустить ее удалось, однако в практических задачах обычная Qwen3 8B, которая помещается в те же 8 ГБ без форков и патчей, показала сопоставимые результаты, а порой работала быстрее и стабильнее. Разберемся, есть ли смысл выбирать Bonsai, когда рядом доступна 8B.
Что представляет собой Bonsai?
Компания PrismML выпустила Bonsai 27B в середине июля и сразу назвала ее первой моделью такого размера, способной работать на iPhone. Два месяца спустя, 17 сентября, появилась Bonsai 2 27B с троичными весами. Новинку быстро заметили в профильных сообществах.
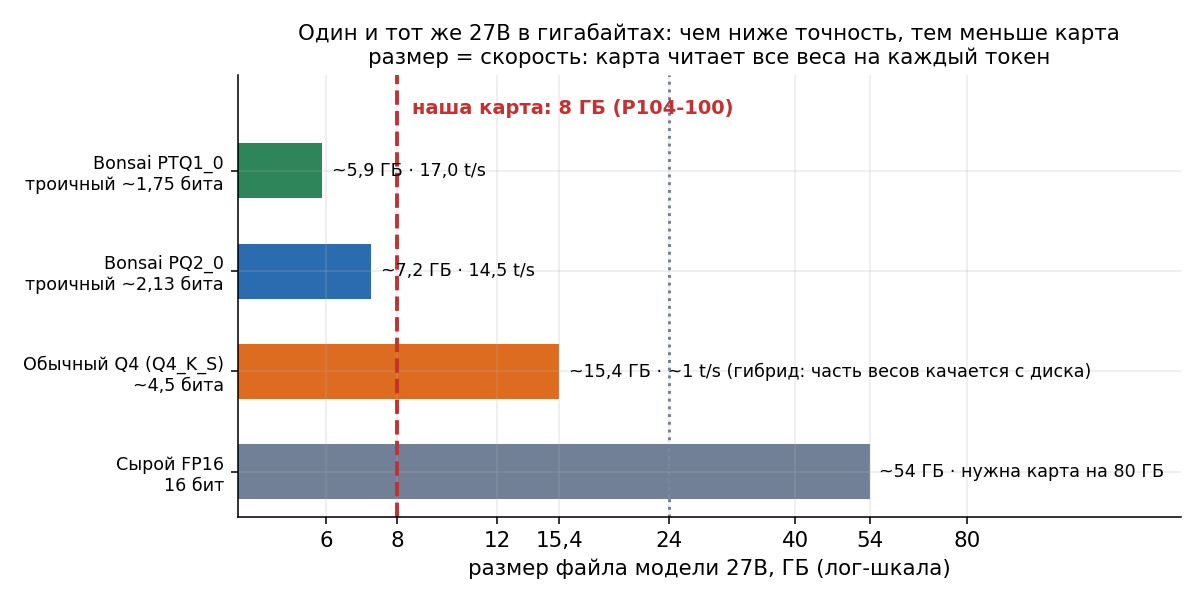
Обещания выглядели впечатляюще. Модель с 27 млрд параметров сжали в девять раз: вместо 54 ГБ она стала занимать 5,9 ГБ. По словам разработчиков, качество почти не изменилось и составило 98,2% от исходного. А июльскую версию на Hugging Face к тому времени скачали около 5 млн раз.
В основе Bonsai 2 27B лежит Qwen3.8-27B, лицензия — Apache 2.0. Заявленная длина контекста составляет 262K токенов. Механизм внимания гибридный: примерно три четверти его слоев линейные. При работе с длинным текстом они обходятся дешевле, поскольку их затраты растут пропорционально длине контекста, тогда как у полного внимания — пропорционально ее квадрату.
Ключевая особенность модели — размер файла, которого удалось добиться благодаря троичным весам. В обычной модели вес хранится как 16-битное число, здесь же возможны только три значения: −1, 0 и +1. Разработчики обещают и вычислительное преимущество: умножение на такие значения можно заменить сложением и изменением знака. Это существенно снижает нагрузку на процессор.
Сравнение размеров в гигабайтах выглядит так:
|
Формат |
Бит на вес |
Размер 27B |
Под какую карту |
|
FP16 |
16 |
~54 ГБ |
80 ГБ |
|
Q4 |
~4,5 |
~15,4 ГБ |
24 ГБ |
|
PQ2_0 (троичный) |
~2,13 |
~7,2 ГБ |
8 ГБ |
|
PTQ1_0 (троичный) |
~1,75 |
~5,9 ГБ |
8 ГБ |
На старых видеокартах размер влияет и на быстродействие. Для генерации каждого токена карте приходится считывать все веса, поэтому ограничением чаще становится пропускная способность памяти, а не вычислительная мощность.
Для чего нужны два формата? По сведениям PrismML, PTQ1_0 быстрее работает на игровых картах уровня RTX 4090, а PQ2_0 лучше подходит серверным H100, A100 и Blackwell.
Старое оборудование и необходимый форк PrismML
Проверять обещания я решил на доступном железе: майнинговой видеокарте 2017 года и двух недорогих смартфонах.
|
Компонент |
Конфигурация |
|
GPU |
NVIDIA P104-100 — Pascal 2017 года, 8 ГБ VRAM, бывшая майнинговая карта |
|
CPU |
i7-3770 (4 ядра, 2012 год, без поддержки AVX2) |
|
RAM |
15,5 ГБ |
|
Диски |
NVMe (912 МБ/с) и HDD (78 МБ/с) — HDD использовался специально для измерения времени запуска |
|
Телефоны |
TECNO Pouvoir 4 — Helio A22, 2,9 ГБ, Android 10, 32-бит; TECNO Pova 5 — Helio G99, 8 ГБ, Android 14, 64-бит |
Для измерения скорости я использовал утилиту llama-bench из llama.cpp. Одновременно каждые полсекунды собирал через nvidia-smi данные о температуре видеокарты, потребляемой мощности и использовании памяти. Смартфоны подключал и контролировал через adb.
Первая сложность возникла еще на компьютере: стандартные llama.cpp и Ollama не распознают троичный GGUF. Веса модели хранятся в тензорах PQ2_0 и PTQ1_0, которые поддерживает только форк PrismML. При попытке прочитать такой файл обычная Ollama версии 0.40.6 сообщает об ошибке. С тех пор Ollama обновлялась, а часть форматов Bonsai вошла в официальный llama.cpp, однако быстрые троичные тензоры PQ2_0 по-прежнему поддерживаются только форком.
Для измерений я запускал модель напрямую в готовой сборке PrismML с поддержкой CUDA 12.4: так проще и быстрее. При желании троичную Bonsai можно заставить работать и со стандартной Ollama, но для этого потребуются ручные изменения. Нужно пропатчить Go-парсер GGUF, иначе Ollama не рассчитает размер тензоров, и заменить штатный бинарник llama-server сборкой из форка PrismML. После этого ollama create и ollama run будут работать с 27B без потери скорости: генерация идет так же, как в самом форке. Практическая ценность решения невелика: первое же обновление Ollama затрет все изменения.
Ollama хотя бы явно сообщает об ошибке, если не может разобрать файл. Со стандартным llama.cpp ситуация неприятнее: он ничего не предупреждает. Старый формат Q2_0 из той же серии загружается без замечаний, но затем модель выдает бессмысленный текст.
Причина кроется в механизме сжатия. Перед квантованием веса «поворачивают», умножая на матрицу Адамара. Это сглаживает редкие выбросы, которые особенно плохо переносят сжатие. При работе модели входные данные, или активации, необходимо поворачивать аналогичным образом, иначе они окажутся с весами в разных системах координат. Стандартный llama.cpp этого не делает. Разработчики прямо предупреждают об этом на странице модели на Hugging Face.
Скорость Bonsai на видеокарте
В сравнении участвовали пять моделей. Все, кроме эталонной, занимали не более 8 ГБ:
|
Модель |
Формат |
Бит на вес |
Размер |
Роль |
|
Bonsai 2 27B PTQ1_0 |
троичный |
1,75 |
5,95 ГБ |
главный участник |
|
Bonsai 2 27B PQ2_0 |
троичный |
2,13 |
7,21 ГБ |
та же модель, чуть больше |
|
Qwen3 8B Q4_K_M |
обычный 4-битный |
~4,5 |
4,7 ГБ |
8B, тоже помещается в 8 ГБ |
|
Qwen3.8 27B UD-IQ2_XXS |
обычный 2-битный |
~2 |
7,27 ГБ |
соперник сопоставимого размера |
|
Qwen3.8 27B UD-Q4_K_S |
обычный 4-битный |
~4,5 |
15,4 ГБ |
почти несжатый эталон (через mmap) |
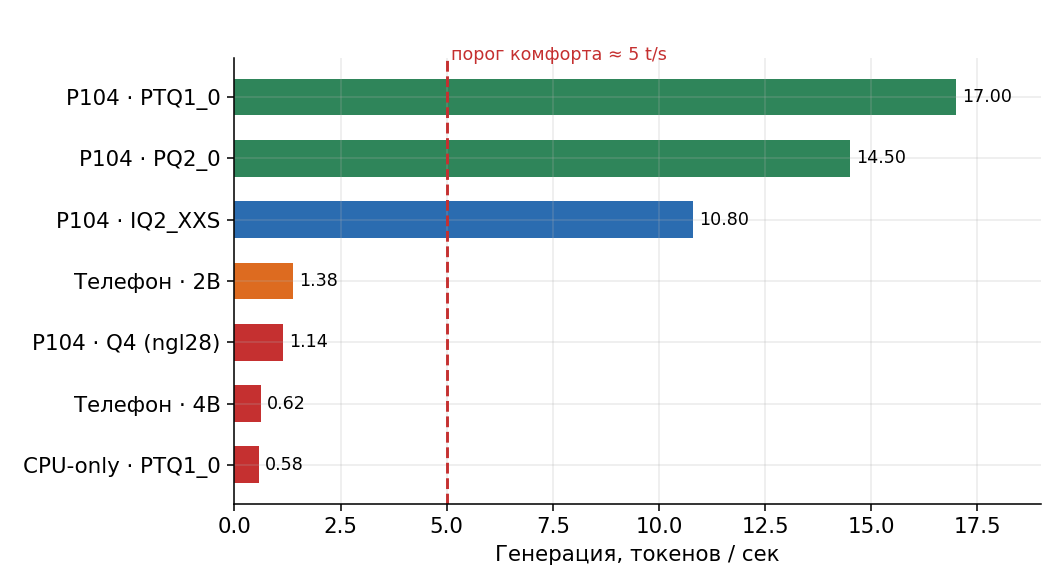
Эталонной Q4_K_S на этом стенде не хватает памяти: ее 15,4 ГБ не помещаются ни в VRAM, ни в свободной оперативной памяти. При использовании mmap, когда веса по мере необходимости подгружаются с диска, модель выдает около 1 t/s. Я пробовал передать видеокарте 28 слоев, а остальные оставить процессору. Результат был почти таким же — 1,14 t/s.
В следующей таблице приведены две скорости. Первая показывает, как быстро модель обрабатывает полученный запрос, вторая — с какой скоростью генерирует ответ. Обе измеряются в токенах в секунду (t/s).
|
Модель |
Размер |
Чтение промпта, t/s |
Генерация, t/s |
Пик видеопамяти |
|
Bonsai PTQ1_0 |
5,95 ГБ |
93,8 |
17 |
6,98 ГБ |
|
Bonsai PQ2_0 |
7,21 ГБ |
97,7 |
14,5 |
7,81 ГБ |
|
Qwen UD-IQ2_XXS (обычный 2-бит) |
7,27 ГБ |
15,7 |
10,8 |
7,89 ГБ |
Последняя строка преподнесла сюрприз. Обычная двухбитная IQ2_XXS на Pascal обрабатывает промпт в шесть раз медленнее, а генерирует текст в 1,6 раза медленнее, хотя файлы моделей имеют близкий размер. Здесь важнее вычислительные ядра, написанные для конкретного формата, тогда как число бит на вес отступает на второй план. IQ2_XXS тоже сильно сжата, поэтому таблица фактически сравнивает два способа сжатия одной и той же Qwen 27B. Несжатую версию на этой карте запустить невозможно.
Для ориентира: по данным PrismML, на RTX 4090 модель достигает 81–91 t/s. Майнинговая карта 2017 года обеспечивает примерно пятую часть этой скорости.
По длине контекста предел карты составляет 16K токенов. При 16 384 занято 97% видеопамяти — 7967 МБ из 8191. При 32 768 модель уже не запускается. Таким образом, заявленные 262K на карте с 8 ГБ остаются теоретическим максимумом. На картах с 12–16 ГБ после загрузки 5,9 ГБ весов остается гораздо больше места для кэша контекста, поэтому длинные окна там, вероятно, достижимы. Проверить это на моем стенде нельзя.
Я попробовал запустить модель и без видеокарты, не рассчитывая на чудеса. Старый i7-3770 без AVX2 показал 0,6 t/s — почти в тридцать раз меньше, чем видеокарта.
Пока модель полностью размещается в видеопамяти, накопитель влияет лишь на время запуска. С NVMe она загрузилась за 25 секунд, с HDD — за 87. В дальнейшем разница почти исчезает: 16,5 и 17,0 t/s соответственно. Получается, SSD избавляет примерно от лишней минуты ожидания перед стартом. Впрочем, при частых перезапусках и эта минута начинает мешать.
Как долго телефон генерирует один токен
Июльскую Bonsai 27B компания PrismML представляла как «первую модель класса 27B для запуска на телефоне». Правда, речь шла об iPhone с 12 ГБ памяти, из которых модели выделяют около шести, и однобитной версии размером 4 ГБ. У меня условия отличались: троичная Bonsai 2 на 5,9 ГБ и два обычных Android-смартфона. На первом модель вообще не запустилась, а на втором заработала, выдавая примерно один токен за 20 секунд.
TECNO Pouvoir 4: только небольшие модели
Первый смартфон оказался полностью 32-битным. Запустить на нем 27B нельзя сразу по двум причинам. Во-первых, Android-сборка форка доступна только для arm64, поэтому попытка запуска завершается ошибкой:
/system/bin/sh: ./llama-bench: not executable: 64-bit ELF fileВторая причина фундаментальнее. Даже собрав рантайм для armv7, нельзя заставить 32-битный процесс работать с файлом на 5,9 ГБ: адресное пространство жестко ограничено 4 ГБ.
Младшие модели семейства в память Pouvoir 4 помещаются, но рантайм для armv7 пришлось собирать вручную из исходного кода форка. Основных препятствий было три:
-
Хост-инструмент llama-ui-embed. Он жестко привязан к MSVC и отказывался компилироваться другими средствами.
-
Библиотека libc++fs.a. В Android NDK r21e ее не оказалось, поэтому необходимые компоненты пришлось извлекать из исходников libc++ и собирать самостоятельно.
-
Флаги оптимизации. По умолчанию релизная сборка использовала -Oz, оптимизацию по размеру кода и компактные Thumb-инструкции. После ручного переключения на -O3 и обычный набор ARM-инструкций скорость выросла на 13–17%.
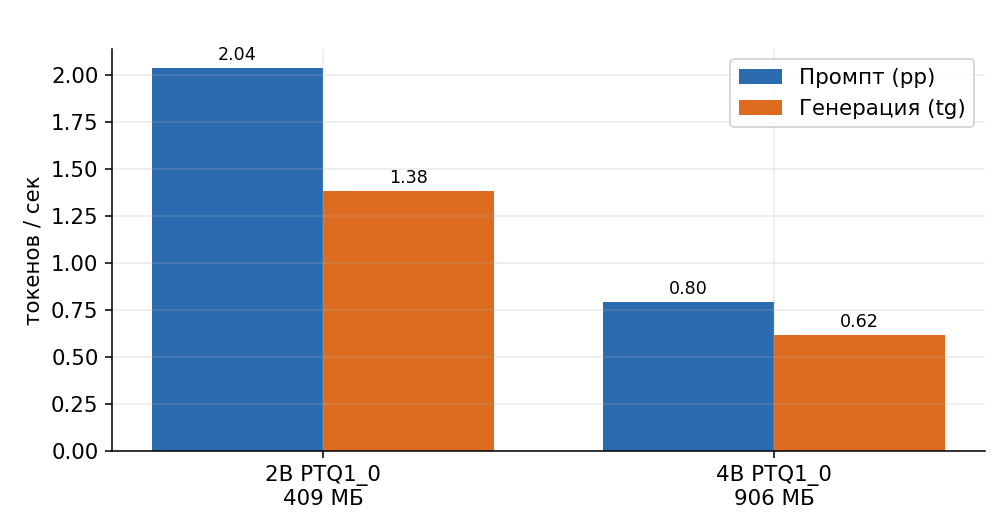
Готовые бинарники llama-cli и llama-bench я отправил на смартфон обычной командой adb push, рядом разместил libomp.so и загрузил две младшие модели: 2B размером 409 МБ и 4B размером 906 МБ. Обе дают осмысленные ответы и хорошо понимают русский язык. Однако стандартный контекст версии 4B полностью занимал доступные процессу 2,9 ГБ оперативной памяти, поэтому запустить ее удалось лишь с сокращенным контекстом и флагом -c 512.
|
Модель |
Файл |
Промпт, t/s |
Генерация, t/s |
|---|---|---|---|
|
Bonsai 2 2B PTQ1_0 |
409 МБ |
2,04 (pp128) |
1,38 (tg64) |
|
Bonsai 2 2B (-Oz/Thumb) |
409 МБ |
1,80 |
1,19 |
|
Bonsai 2 4B PTQ1_0 |
906 МБ |
0,79 (pp64) |
0,62 (tg32) |
|
27B PTQ1_0 |
5,95 ГБ |
невозможно |
невозможно (32-бит + ОЗУ) |
TECNO Pova 5: 27B работает, но крайне медленно
С 64-битным TECNO Pova 5 и его 8 ГБ памяти проблем оказалось меньше. Я собрал чистый рантайм для aarch64 по инструкции из репозитория форка, скопировал на телефон те же файлы 27B, что использовал на ПК, и модель запустилась. Из шести контрольных вопросов — умножение, ловушка про овец, короткий код, вопрос с ложной посылкой, проверка фактов и творческое задание — она правильно решила пять.
Творческое задание не удалось только версии PTQ1_0: PQ2_0 с ним справилась. Еще один ответ поначалу обрывался, но причина была не в модели, а в ограничении длины. С параметром -n 64 ответ стал полным и правильным.
Результаты измерения скорости:
|
Модель |
Размер |
Промпт, t/s |
Генерация, t/s |
|---|---|---|---|
|
Bonsai 2 27B PTQ1_0 |
5,95 ГБ |
0,59 |
0,05 |
|
Bonsai 2 27B PQ2_0 |
7,21 ГБ |
0,67 |
0,04 |
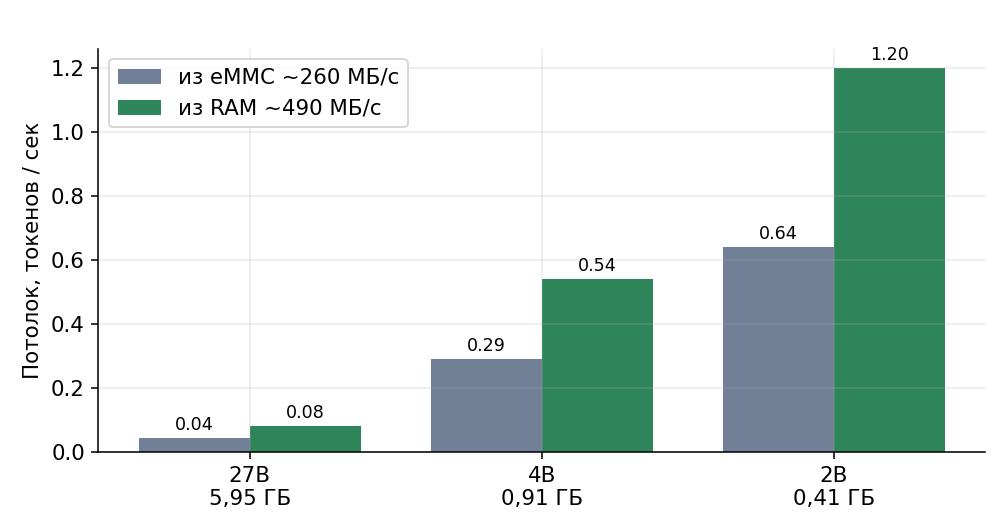
Android сам использует значительную часть памяти: из 8 ГБ приложению достается около 3–4. Файл размером 5,95 ГБ туда целиком не помещается, поэтому для каждого токена телефон снова считывает веса из флеш-памяти со скоростью примерно 260 МБ/с.
Оценить это несложно: при такой скорости чтение файла занимает около 23 секунд, а измерение показало 20 секунд на токен. Почти все время уходит на ожидание флеш-памяти. Pouvoir 4 ограничен разрядностью, Pova 5 — объемом ОЗУ. От видеокарты последний отстает примерно в 340 раз. Точнее оценить нельзя: значение 0,05 t/s уже округлено.
Pova 5 — смартфон среднего класса. На флагманском устройстве с 12–16 ГБ ОЗУ, где веса целиком помещаются в память, скорость, вероятно, будет иной. Но во время тестирования проверить это было не на чем.
По моему опыту, для запуска 27B на телефоне нужны 64-битная система и как минимум 8 ГБ оперативной памяти. Модель заработает и станет отвечать осмысленно, но при 0,05 t/s вести с ней диалог практически невозможно. На бюджетных 32-битных устройствах вроде Pouvoir 4 она не запустится вовсе: там остаются варианты 2B и 4B со скоростью от 0,6 до 2 t/s.
На коротких заданиях 27B и 8B отличаются всего на один балл
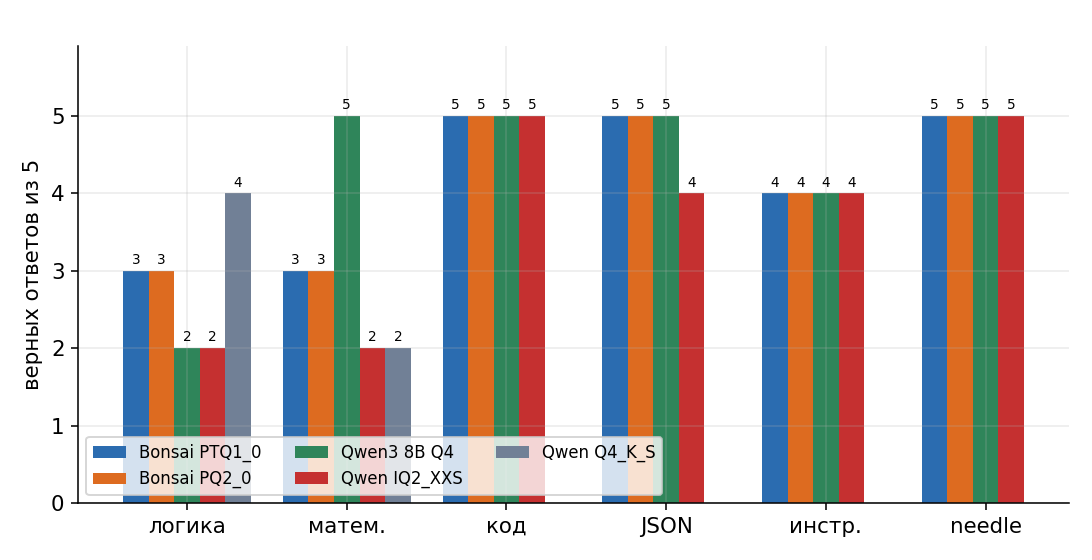
Шести вопросов для полноценного сравнения недостаточно, поэтому я подготовил 40 коротких заданий: по пять в каждой из восьми категорий. В набор вошли логические ловушки, многошаговая арифметика, код для проверки юнит-тестами, JSON по заданной схеме и упражнения на точное соблюдение инструкции — например, вывести ровно N пунктов или обойтись без определенной буквы. Еще три категории проверяли поиск информации в контексте длиной от 1 до 8K токенов, фактические знания и качество русского текста. Поиск в контексте — это тест «иголка в стоге сена» (needle in a haystack), в котором среди длинного текста прячут факт и просят модель его найти.
Все модели работали в одинаковых условиях: температура 0, сид 42, контекст 8192 токена, режим рассуждения отключен, по одному прогону на задание. Способ проверки зависел от категории. Код я проверял тестами, JSON — парсером, математические ответы — сверкой чисел. Знания и качество русского текста оценивал вслепую по заранее составленной шкале и лишь затем узнавал, какой модели принадлежит ответ.
Эталонную Q4_K_S из-за скорости около 1 t/s я проверил только на логике и математике.
|
Категория |
Bonsai PTQ1_0 |
Bonsai PQ2_0 |
Qwen3 8B |
Qwen IQ2_XXS |
Эталон Q4_K_S |
|
Логика |
3/5 |
3/5 |
2/5 |
2/5 |
4/5 |
|
Математика |
3/5 |
3/5 |
5/5 |
2/5 |
2/5 |
|
Код |
5/5 |
5/5 |
5/5 |
5/5 |
— |
|
JSON |
5/5 |
5/5 |
5/5 |
4/5 |
— |
|
Поиск в контексте |
5/5 |
5/5 |
5/5 |
5/5 |
— |
|
Знания |
5/5 |
5/5 |
5/5 |
5/5 |
— |
|
Русский текст |
5/5 |
5/5 |
5/5 |
5/5 |
— |
На коротком наборе получилась почти ничья: Bonsai набрала 35 баллов из 40, 8B — 36. Показательнее сравнение по отдельным категориям. Все модели справились с кодом и поиском факта в тексте, а также без ошибок прошли слепую оценку знаний и русского языка. Единственный сбой вне логики и математики допустила IQ2_XXS: в одном задании на JSON она вернула пустой ответ.
Основные различия проявились в логике и математике. По логике лидирует эталон с результатом 4 из 5, обе Bonsai набрали по 3, а 8B и IQ2_XXS — по 2. В математике 8B решила все пять задач, обе Bonsai — по три, IQ2_XXS и эталон — по две. За эти десять заданий эталон и обе Bonsai получили по 6 баллов, 8B — 7, IQ2_XXS — 4.
PrismML утверждала, что Bonsai сохранит 98,2% качества исходной модели. На логике и математике троичная версия набрала столько же баллов, сколько почти несжатый эталон, поэтому мой небольшой эксперимент этому утверждению не противоречит.
Ответы PTQ1_0 и PQ2_0 побайтово совпали в 35 из 40 заданий. В остальных пяти требовался свободный ответ, и отличались лишь формулировки. PQ2_0 занимает на гигабайт больше, но в этом наборе дополнительный объем преимуществ не принес.
Режим рассуждения меняет результаты по математике
Когда рассуждение отключено, троичные модели отвечают одним числом и ошибаются в задачах, требующих промежуточных вычислений. Я повторил те же пять заданий с включенным рассуждением. PTQ1_0 решила все пять вместо трех, а эталон Q4_K_S — все пять вместо двух. На рассуждение PTQ1_0 израсходовала 63 токена, а эталон — 400. Пяти задач недостаточно для надежного вывода, но, похоже, отказ от промежуточных шагов ухудшает результаты по математике не только у троичной модели. При этом эталону требуется около 145 секунд на задание, а PTQ1_0 — 21: скорость генерации составляет 1,2 и 15 t/s соответственно.
Победу 8B в математике нельзя считать вполне честной. Я отключил рассуждение у всех участников и явно потребовал в промпте выводить только итоговое число. Остальные модели выполнили инструкцию, но допустили ошибки. А 8B проигнорировала ограничение и расписала вычисления:
Сколько будет 144 / 12 + 17 * 3? Ответь только числом.
144 / 12 = 12
17 * 3 = 51
12 + 51 = 63
Ответ: 63
Иными словами, 8B самостоятельно применила рассуждение, которое я отключил для всех, — этим и объясняется ее результат 5 из 5 по математике.
Три задания вызвали затруднения у всех участников: задача про яблоки, где из 12 яблок половину отдали, а из трети оставшихся сварили компот; выражение 144/12+17*3 при требовании дать прямой ответ; и предложение о зиме без буквы «о».
Разницу между методами сжатия хорошо иллюстрирует известная загадка о фермере и овцах. У фермера было 17 овец, и все, кроме девяти, убежали. Сколько осталось? Подвох подталкивает вычесть 9 из 17, хотя нужное число уже названо в условии.
IQ2_XXS во всех 15 прогонах — пяти при температуре 0 и десяти при 0,7 — отвечала «8», то есть называла число убежавших овец. Обе Bonsai и эталон Q4_K_S всякий раз давали ответ «9». Все четыре варианта основаны на одной и той же Qwen 27B, поэтому ошибку IQ2_XXS приходится связывать со способом сжатия. Впрочем, Q4 тоже не свободна от потерь. В первой серии из шести вопросов эталон один раз ошибся: на просьбу «придумай одно короткое предложение про кота и дождь» модель написала фразу о коте, забыв про дождь. На более сложных заданиях 27B также не превзошла 8B.
Короткие вопросы не слишком хорошо раскрывают возможные преимущества большой модели, поэтому я подготовил второй набор из 20 более сложных заданий. Выбирал такие, в которых 27B должна была бы обойти 8B: иначе домашний запуск большой модели теряет смысл. В набор вошли редкие факты, многошаговые логические задачи, сказки и поиск скрытой информации в русских текстах длиной 8K и 16K токенов. Проверку прошли три модели:
|
Модель |
Знания |
Контекст 8K |
Авто-итог |
t/s |
Контекст 16K |
|---|---|---|---|---|---|
|
Qwen3 8B |
5/5 |
5/5 |
8/10 |
31,9 |
ок |
|
Bonsai PTQ1_0 |
5/5 |
5/5 |
7/10 |
16,8 |
ок |
|
Qwen IQ2_XXS |
4/5 |
4/5 |
6/10 |
10,7 |
таймаут |
Как ни досадно, заметного преимущества большой 27B перед более быстрой «малышкой» 8B обнаружить не удалось.
По отдельным направлениям результаты выглядят так:
-
Эрудиция и память. В заданиях на редкие факты и поиск «иголки в стоге сена» в контексте до 8K различий между 8B и 27B не оказалось.
-
Сложная логика. При включенном рассуждении модели показывают почти одинаковые результаты.
-
Длинный контекст (16K). Именно здесь возникла проблема у одной из 27B. IQ2_XXS занимает больше места, чем PTQ1_0, и вместе с кэшем на 16K не поместилась в 8 ГБ. Модель полчаса считывала веса с диска, после чего завершилась по таймауту. 8B и PTQ1_0 обработали такой контекст и дали ответы.
-
Креативность. Модели сочиняли сказки в заданном стиле, в том числе по мотивам «Репки», «Колобка» и «Теремка». Я оценивал тексты вручную и вслепую. Обе 27B получили по 19 баллов из 25, а 8B немного отстала с 18 баллами. Максимальную оценку не получила ни одна: все модели теряли персонажей и нарушали связность сюжета. При этом 27B писали более длинные тексты, а их сюжеты, на мой взгляд, были интереснее. Но пять сказок на модель — слишком маленькая выборка для выводов.
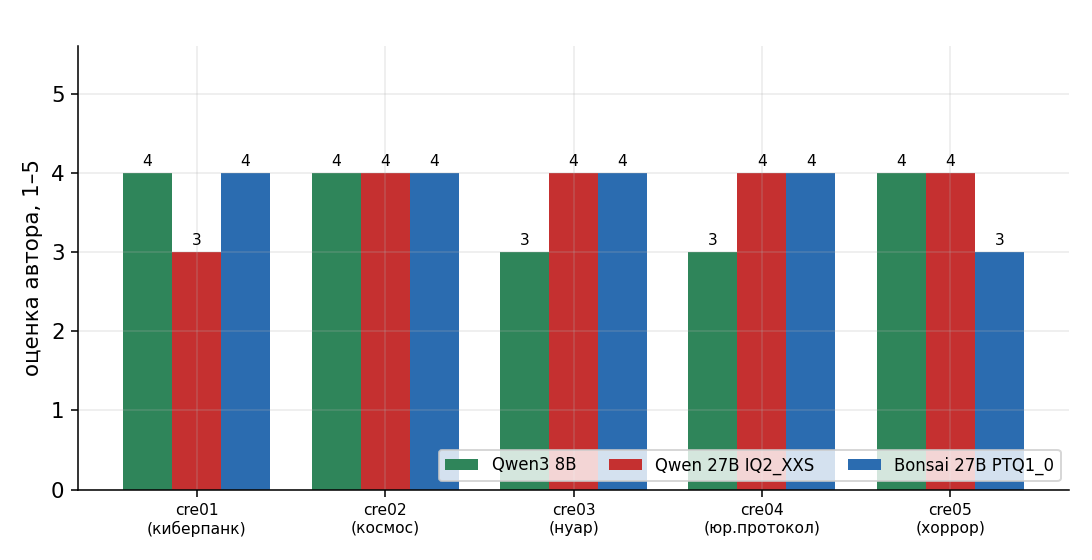
На прохождение испытаний 8B потребовалось 7,2 минуты, PTQ1_0 — 11,1 минуты, IQ2_XXS — 54,8 минуты.
Обе модели одинаково хорошо читают изображения
Bonsai 2 также поддерживает работу с изображениями. Для этого предусмотрен отдельный визуальный модуль размером 0,6 ГБ, который я тоже проверил.
В тест вошло 11 изображений, преимущественно непростых: русская поговорка, строка на шести языках, английский текст на зашумленном фоне, надписи под углом, мелкий шрифт, вывеска с категорией и рукописный текст на доске. Все изображения обрабатывались через llama-mtmd-cli — утилиту llama.cpp для мультимодальных моделей.
Модель распознала все изображения. На каждое уходило около 35 секунд, хотя само изображение обрабатывалось примерно за две секунды, а остальное время занимало рассуждение. Не обошлось и без ограничений памяти: изображение формата 4:3 при контексте 8192 токена не поместилось в 8 ГБ, что привело к ошибке CUDA OOM. Контекст пришлось уменьшить до 4096.
Для сравнения я использовал мультимодальную Qwen3-VL 8B в формате Q4_K_M. Она также прочитала все 11 изображений, затрачивая на каждое от 2,2 до 3,3 секунды.
Различия обнаружились при использовании памяти. Визуальный модуль Qwen3-VL — файл mmproj — занимает 1,16 ГБ, и на карте с 8 ГБ его работа была на грани возможного. В нескольких прогонах он полностью заполнял видеопамять, обработка переходила на процессор, а кодирование одного изображения занимало 3–5 минут. Модуль Bonsai размером 0,6 ГБ проходил этот этап стабильно, без подобных задержек.
Размер все же не определяет результат
Главное обещание PrismML оказалось выполнено. Модель класса 27B работает на майнинговой карте с 8 ГБ и выдает 17 t/s — более чем втрое выше условного порога в 5 t/s, достаточного для комфортного диалога. На телефоне она тоже запускается, но ответа в несколько абзацев придется ждать больше часа.
А вот превзойти обычную 8B большой модели не удалось. На коротких заданиях 8B опередила ее на один балл из сорока, а в сложном наборе — на один ответ: 8 из 10 против 7. В распознавании изображений ничья: Qwen3-VL 8B тоже прочитала все 11 картинок. При этом 8B почти вдвое быстрее — 31,9 t/s против 16,8 — и устанавливается в обычную Ollama без патчей. Для общения на русском, простой арифметики, кода и JSON ее возможностей вполне достаточно.
Впрочем, у Bonsai есть свои преимущества. Ее визуальный модуль примерно вдвое меньше и на карте с 8 ГБ ни разу не переносил обработку на процессор, тогда как Qwen3-VL из-за этого задерживалась на 3–5 минут. В задачах с подвохом Bonsai ошибалась реже 8B и ни разу не попалась на загадку про овец. Правда, таких задач было всего пять, поэтому даже одна случайная ошибка заметно меняет результат.
Троичное сжатие само по себе работает: 27B действительно поместилась в 8 ГБ, а Bonsai обрабатывает промпт в шесть раз быстрее IQ2_XXS с файлом сопоставимого размера. Но пользоваться этим пока не слишком удобно. Новые троичные файлы стандартный llama.cpp не открывает, а старый Q2_0 загружает без предупреждений, после чего модель выдает бессмыслицу. Без форка PrismML не обойтись. Ollama можно пропатчить, но изменения сохранятся лишь до очередного обновления. Поэтому для карты с 8 ГБ я пока предпочел бы обычную 8B.
За рамками проверки остались видеокарты с 12–16 ГБ и флагманские смартфоны, способные целиком разместить в памяти веса и кэш контекста. Возможно, на них 27B проявит себя лучше, но такого оборудования у меня не было.
Похожие статьи
 Представлен Sharp Aquos Sense11 с экраном 240 Гц, защитой от горячей воды и шестью годами обновлений Android
 One UI 9.5 добавит смартфонам Samsung новые возможности управления SIM-картами
 HP запустила продажи рабочей станции ZGX Fury G1n с 748 ГБ памяти за 132 000 долларов
 Redmi Note 18 5G станет новым монстром автономности благодаря батарее на 8888 мА·ч
 iPhone 20 Pro оснастят новой камерой
 GTA VI ждали 13 лет: игра принесла создателям почти $1,5 млрд ещё до релиза
 Разработчик создал портативный дисковод для 3,5-дюймовых дискет с передачей файлов по Wi-Fi
 [Перевод] Цвета в режиме Wii на Wii U искажались 13 лет из-за двух опечаток в прошивке