Не ИИ обесценил сеньоров — это сделали ваши собеседования
Новичок с LLM и эксперт
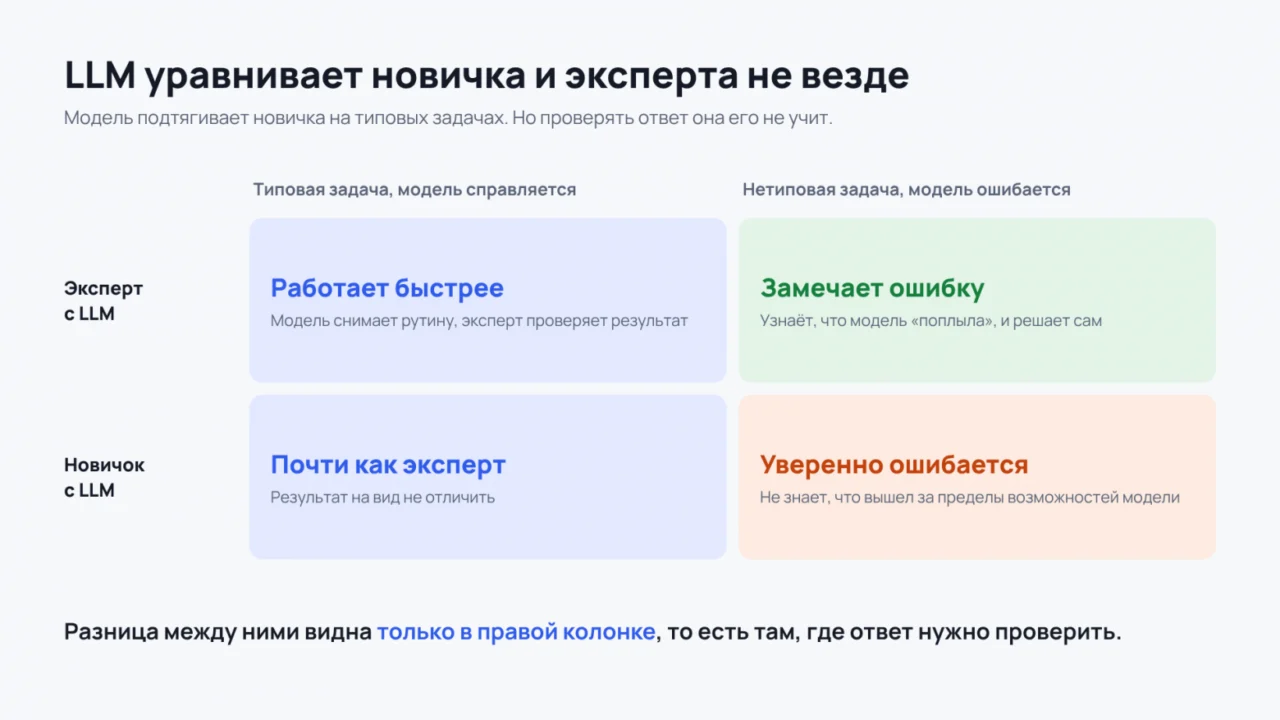
Один из главных вопросов ИТ-рынка в 2026 году звучит так: если начинающий специалист с ИИ решает задачи почти с той же скоростью, что и сеньор, а аналитик без опыта получает от модели готовый SQL-запрос и аккуратный дашборд, то зачем платить за опыт? Основания для такого вопроса вполне весомы. В исследовании с участием 5 172 сотрудников поддержки ИИ-ассистент повысил производительность в среднем на 15%. При этом менее опытные сотрудники стали работать быстрее и качественнее, а наиболее опытные немного прибавили в скорости при небольшом снижении качества. В эксперименте с 453 специалистами, готовившими профессиональные тексты, время выполнения сократилось на 40%, качество выросло на 18%, а различия между работниками уменьшились. Иными словами, в типовых задачах LLM помогает менее опытным приблизиться к сильным специалистам.
Но что, если вывод «LLM уравняла новичка и эксперта» объясняется не свойствами модели, а способом их сравнения? Возможно, сам процесс найма в ИТ устроен так, что вооружённый LLM кандидат без опыта способен без труда обойти сеньора в борьбе за вакансию.
Что такое экспертиза
LLM сближает результаты новичка и опытного специалиста не во всех случаях, а в определённых условиях: при решении типовых задач, доступных модели, и там, где результат не требует проверки человеком. За пределами этой области разница сохраняется, а иногда и увеличивается. Почему так происходит? Когнитивная психология предложила ответ задолго до появления LLM. Экспертиза — это прежде всего содержимое долговременной памяти. Эксперта отличает от новичка не более вместительная рабочая память, а опыт решения похожих задач и накопленные схемы действий. Новичку приходится выстраивать решение поэтапно, опираясь на ограниченные ресурсы рабочей памяти. Накопленные знания — главный, а возможно, и единственный изменяемый источник различий между людьми.
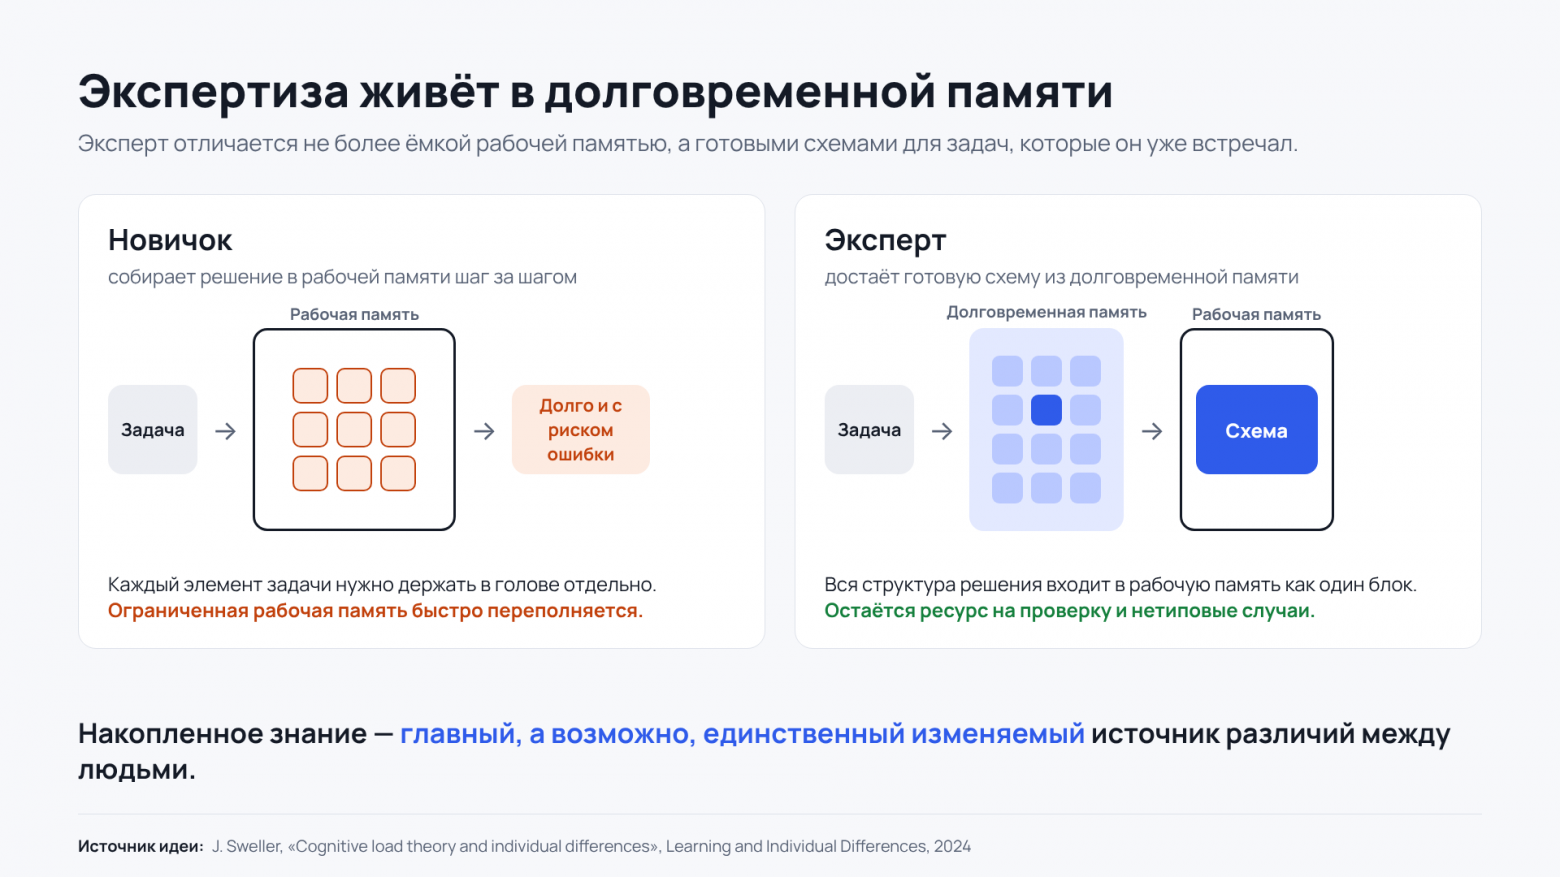
Эти схемы проявляются в трёх наблюдаемых признаках. Во-первых, эксперт распознаёт осмысленные конфигурации: шахматист с первого взгляда запоминает позицию из реальной партии, но не случайное расположение фигур. Аналогичный эффект обнаружили и у программистов. Во-вторых, эксперт классифицирует задачи по их глубинной структуре, тогда как новичок ориентируется на внешние признаки: опытные физики объединяли задачи по закону, необходимому для решения, а студенты — по объектам, упомянутым в условии. В-третьих, эксперт сразу видит первый шаг решения. Метод оценки, основанный на этом признаке, показывал корреляцию с полным тестом знаний до 0,92 и сокращал время проверки в 2,5–4,9 раза.
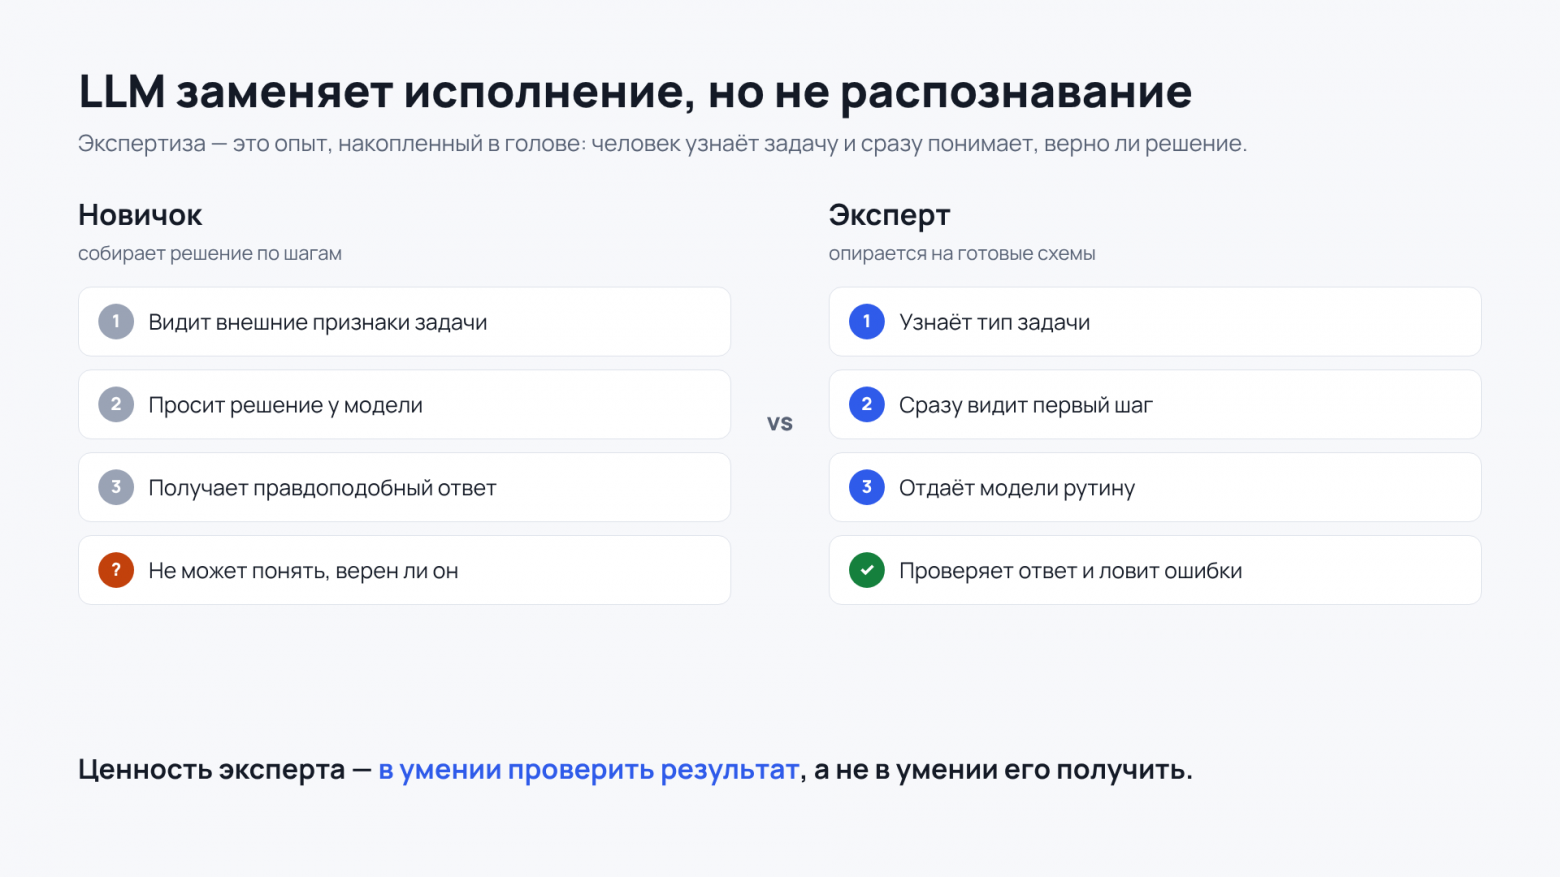
Отсюда становится понятно, почему LLM не заменяет экспертизу. Все три признака связаны со способностью распознать задачу и оценить правильность её решения. Именно эти навыки необходимы, чтобы проверить ответ модели и заметить, что задача оказалась за пределами её возможностей. Модель создаёт текст и код, но схемы для их оценки находятся в голове человека — либо их там нет. Иначе говоря, LLM берёт на себя исполнение, тогда как основа экспертизы — распознавание.
Найм как уравнитель
Рассмотрим типичный процесс найма:
-
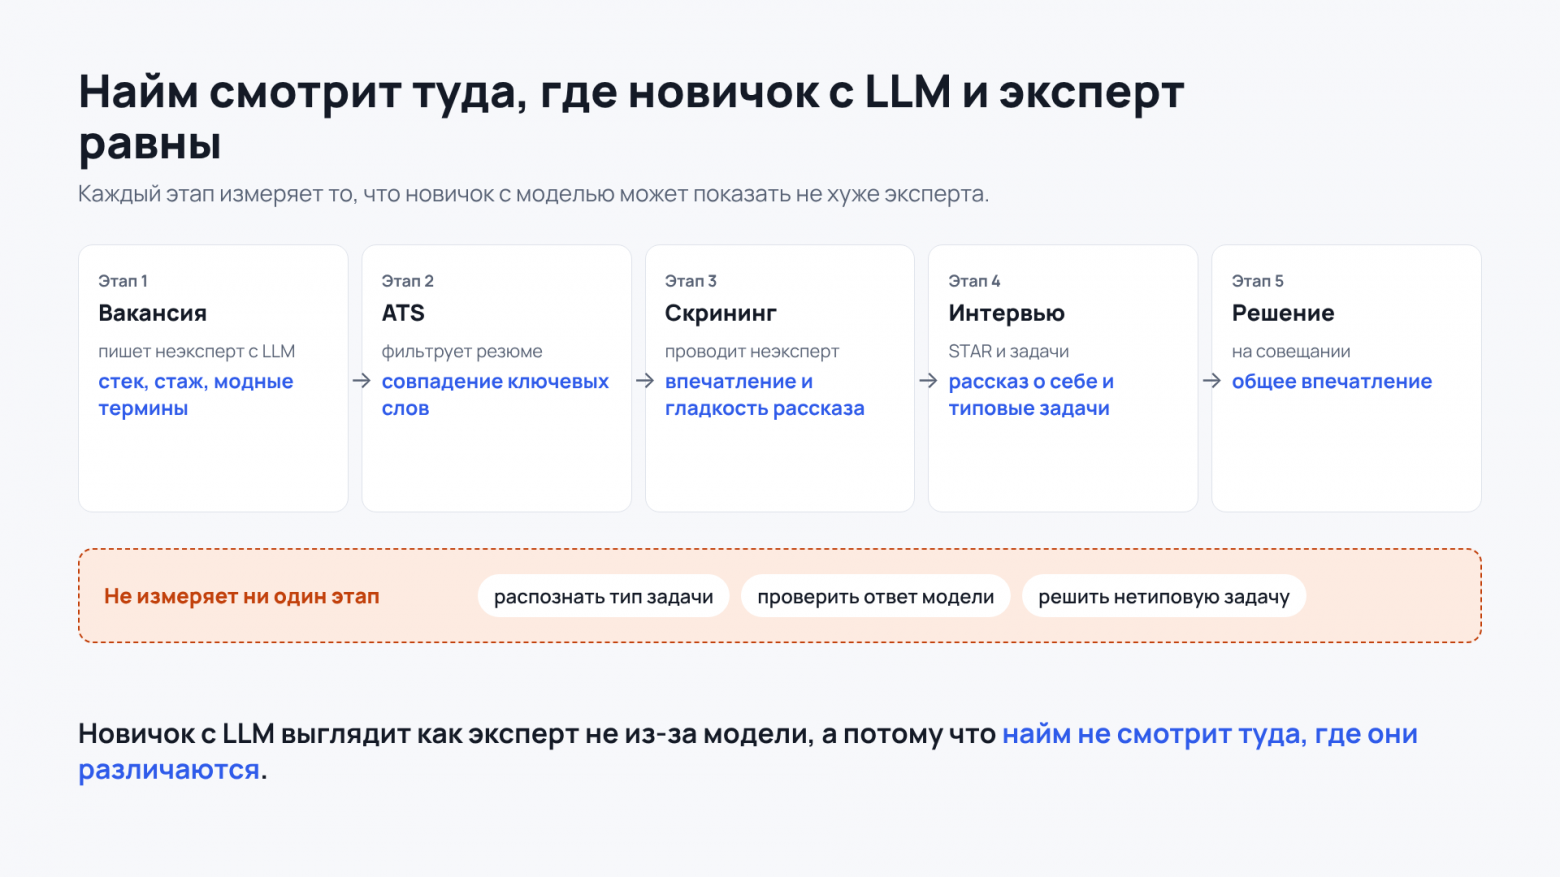
описание вакансии готовят с помощью LLM, нередко поручая это человеку, незнакомому с предметной областью;
-
резюме подстраивают под системы автоматического отбора (ATS), которые отсеивают кандидатов по совпадению ключевых слов;
-
первичный скрининг проводит неэксперт: выясняет ожидания кандидата, причину ухода и рассказывает о компании;
-
далее следуют общие интервью в формате STAR;
-
затем проходят технические интервью, которые проверяют лишь небольшую часть экспертизы соискателя.
Разберём, что именно оценивается на каждом из этих этапов.
Вакансия и ATS. Схемы, необходимые для работы, определяются характером задач, с которыми предстоит столкнуться специалисту. Если описание вакансии составляет человек, не знакомый с этими задачами, роль описывается через внешние признаки: стек технологий, стаж и актуальные термины. Это та же классификация по поверхностным характеристикам, к которой прибегает новичок, только теперь — со стороны работодателя. Затем ATS сопоставляет ключевые слова в резюме и вакансии: поверхность сравнивается с поверхностью. Подстроить резюме под нужные формулировки способны и эксперт, и начинающий специалист.
Скрининг. Человек без предметной экспертизы может не отличить содержательный ответ от поверхностного и даже не заметить этого. В экспериментах с неструктурированными интервью участники составляли уверенное мнение о собеседнике, даже когда тот отвечал случайным образом. При этом само интервью ухудшало прогноз по сравнению с оценкой только по объективным данным. Уверенность в собственном суждении вообще слабо связана с его точностью: надёжная интуиция формируется лишь в стабильной среде при многократном получении обратной связи. На этом этапе убедительность рассказа может значить больше, чем накопленные схемы.
Интервью. Формат STAR с вопросами о прошлом поведении сам по себе не является слабым инструментом: в метаанализе его валидность при использовании шкал с описанием уровней ответов достигала 0,63. Однако кандидат сам выбирает, о чём рассказать, поэтому без таких шкал интервью во многом оценивает способность хорошо излагать мысли.
Технические задачи. Алгоритмические задания, system design и live coding привносят дополнительный фактор: на результат влияет тревога из-за наблюдения. Кроме того, такие задания обычно типовые, а значит, с высокой вероятностью находятся в пределах возможностей модели. Поэтому при использовании LLM на собеседовании, разрешённом или нет, результаты новичка и сеньора могут оказаться одинаковыми.
Возникает неприятный замкнутый круг. На каждом этапе оцениваются либо внешние признаки, либо впечатление, либо результат решения типовой задачи. Именно здесь новичок с LLM и опытный специалист наиболее похожи. При этом ни один этап не измеряет распознавание, проверку и работу за пределами возможностей модели. В итоге новичок с LLM и эксперт выглядят одинаково не потому, что модель действительно их уравняла, а потому, что найм сосредоточен только на тех аспектах, где они равны.
Здесь необходима честная оговорка. Если работа и в самом деле почти полностью состоит из типовых задач, доступных модели, опыт в такой роли действительно теряет часть ценности, и процесс найма здесь ни при чём. Впрочем, даже для написания CRUD и перекраски кнопок работодатели почему-то всегда стремились найти прирождённого инженера.
Цена уравнивания
Если процесс отбора не позволяет отличить новичка с LLM от эксперта, выбор более дешёвого кандидата кажется рациональным. Но у такого решения есть два вида последствий.
Первое — непосредственные ошибки. Новичок, нанятый на работу, где необходимо проверять результаты, будет ошибаться в ситуациях, выходящих за пределы возможностей модели, и может этого не заметить. Такой вывод следует из исследований задач за границей возможностей модели и иллюзии компетентности, хотя прямых измерений подобных ошибок найма пока нет.
Второе — нарушение процесса подготовки специалистов. Экспертами становятся бывшие новички. Ещё в 1983 году Лизанна Бейнбридж описала «иронию автоматизации» в промышленности: автоматика лишает оператора практики, благодаря которой формируется навык, необходимый для её контроля и вмешательства при ошибках. Применительно к LLM это аналогия, но достаточно прямая. Новичок, работающий только оператором модели, не формирует собственные схемы.
Экономисты рассматривают автоматизацию не просто как замену профессий, а как перераспределение задач: технология вытесняет человеческий труд из одних областей и создаёт новые, где он вновь востребован. Если при найме людей оценивают только по задачам, уже переданным модели, тех, кто способен решать остальные, будут систематически недооценивать.
Круг замыкается: найм не замечает экспертизу, рынок не готов за неё платить, новички становятся операторами моделей — и настоящей экспертизы действительно становится меньше.
Как адаптировать найм
Хорошая новость состоит в том, что психология отбора персонала располагает проверенными инструментами, а теория экспертизы помогает определить, на что их направить. Ниже приведены изменения, сгруппированные по степени изученности.
Адаптации с устойчивой доказательной базой.
Анализ работы вместо набора ключевых слов. Вакансию составляют на основе перечня задач, подготовленного экспертом: 5–10 типичных ситуаций с указанием того, как каждая соотносится с возможностями модели. Задачу выполняет LLM; задачу выполняет LLM, а человек проверяет результат; задача находится за пределами возможностей модели.
Структурированное интервью со шкалами. Структурированное интервью считается одним из лучших методов отбора, поскольку точнее других предсказывает будущую эффективность сотрудника.
Почему это работает:
-
Единые вопросы для всех. Ответы кандидатов можно сопоставлять друг с другом, а не оценивать в зависимости от настроения интервьюера.
-
Вопросы основаны на анализе работы. Кандидатов спрашивают о том, что действительно потребуется им на должности.
-
Шкалы с описанием уровней ответов. Благодаря им оценки разных интервьюеров меньше расходятся.
-
Меньше влияния личного впечатления. На неструктурированном интервью люди уверенно интерпретируют даже случайные ответы, что ухудшает прогноз. Структура помогает ограничить этот эффект.
Рабочие пробы на основе реальных задач. Рабочая проба, или work sample, воспроизводит часть будущей работы: кандидат выполняет задание, а не рассказывает, как он это сделал бы. Связь результатов пробы с последующей эффективностью умеренная, но стабильная. Задание можно составить по перечню задач соответствующей роли.
За счёт чего работает метод:
-
Оценивается поведение при выполнении реальной рабочей задачи, а не самоописание кандидата или произведённое им впечатление.
-
С точки зрения теории экспертизы проба непосредственно затрагивает схемы предметной области, а не способность о них рассказывать.
Однако у метода есть ограничения:
-
Рабочая проба отчасти связана с общими способностями. Её корреляция с тестами общих когнитивных способностей составляет 0,32. Иными словами, она измеряет не только экспертизу.
-
Проба охватывает лишь те схемы, которые задействованы в задании. Узкое задание даёт ограниченный срез, поэтому его стоит формировать на основе реальных задач роли.
-
Домашнее задание кандидат может выполнить с помощью LLM (привет любителям типовых тестовых заданий в пределах возможностей модели). В таком случае оно перестаёт различать новичка с моделью и эксперта.
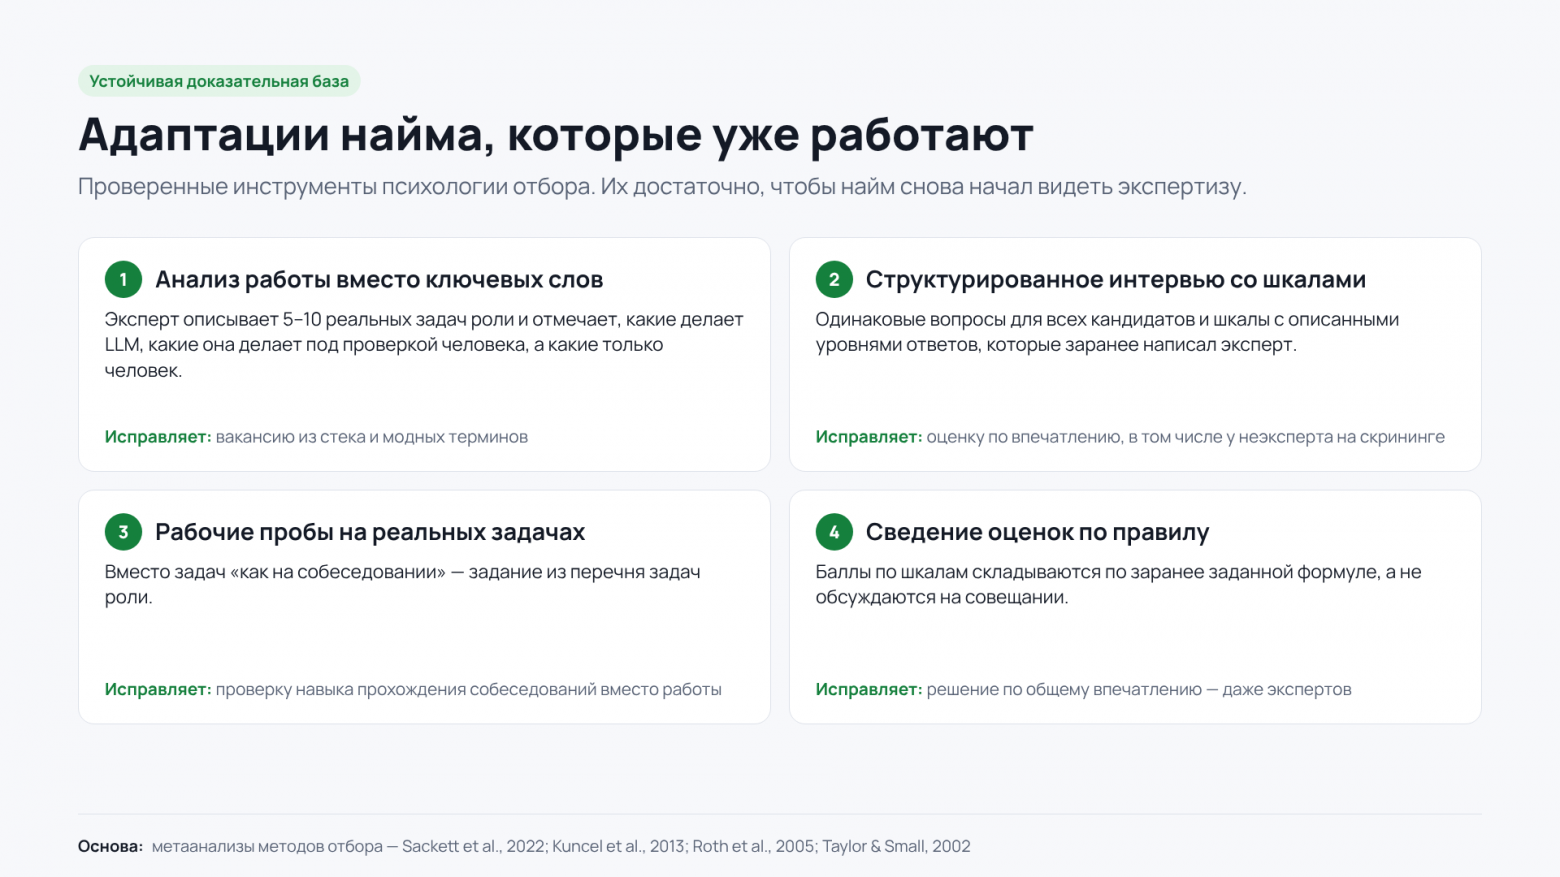
Адаптации, обоснованные теоретически, но пока не проверенные в найме.
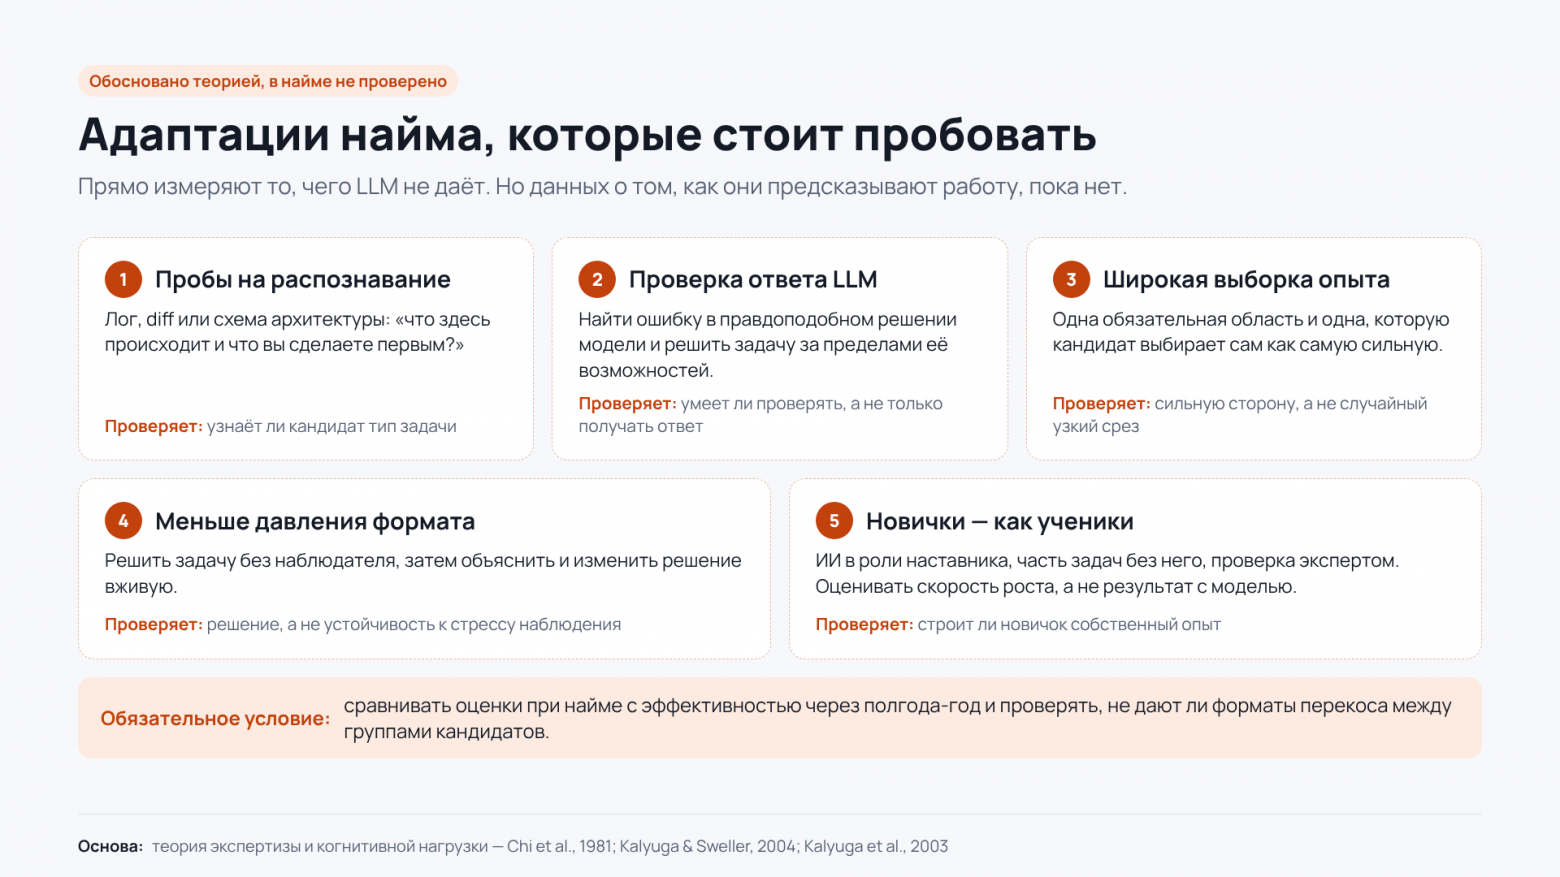
Пробы на распознавание. Это короткие задания на определение «первого шага»: кандидату показывают фрагмент лога, diff или архитектурную схему и спрашивают: «Что здесь происходит и что вы сделаете в первую очередь?» Ответы сверяют с ключом, подготовленным экспертом. Другой вариант — предложить рассортировать 6–8 кратких описаний проблем и объяснить выбор, как в исследованиях экспертной классификации задач. В обучении метод показывает хорошие результаты, однако для ИТ-найма его валидность не подтверждена.
Пробы на проверку ответа LLM. В рабочую пробу можно включить поиск ошибки в правдоподобном решении, созданном моделью, и задачу, выходящую за пределы её возможностей. Это напрямую проверяет навыки, отличающие эксперта от новичка с моделью, но данных о валидности подобных проб пока нет.
Более широкий охват схем. Можно проверить одну обязательную область и ещё одну, которую кандидат сам считает своей сильной стороной. Это уменьшит риск оценить специалиста по слишком узкому или не самому показательному срезу. А объяснение либо изменение решения вживую поможет убедиться, что кандидат действительно работал над ним самостоятельно.
Снижение дополнительной нагрузки от формата. Если на результат live coding влияет тревога из-за наблюдения, формат стоит изменить: например, предложить решить задачу без наблюдателя, а затем обсудить решение.
Стоимость этих изменений важно обозначить заранее. На каждом этапе потребуется время экспертов: от составления списка задач до разработки шкал и оценки проб. Однако альтернатива — найм, не способный распознать экспертизу, — в конечном счёте обходится дороже.
Заключение
Получившаяся картина выглядит так. LLM действительно уменьшает разрыв между новичком и опытным специалистом, но только при создании результата для типовых задач, с которыми модель справляется. Экспертиза же включает схемы распознавания, необходимые для проверки ответа и выявления ситуаций за пределами возможностей модели. Обычный процесс найма оценивает внешние признаки, впечатление и выполнение типовых задач — именно те аспекты, в которых новичок с LLM и эксперт похожи. Поэтому их уравнивает не столько модель, сколько сам процесс найма.
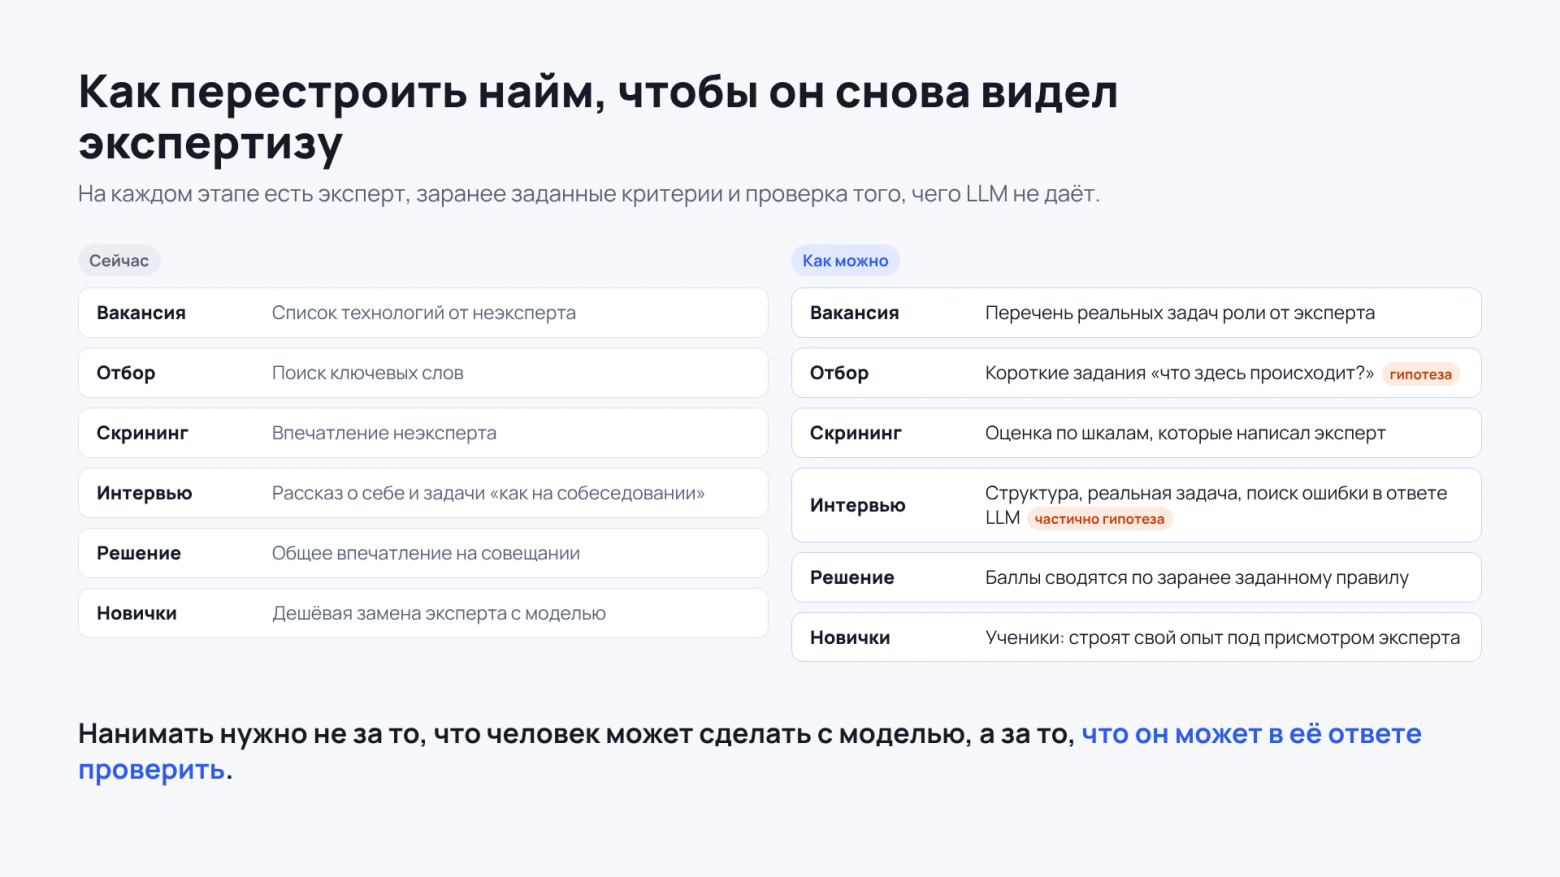
Из этого следуют три вывода. Первый: утверждение «LLM обесценила опыт» во многом отражает недостатки измерения, а не свойства технологии. Второй: психология отбора располагает инструментами с устойчивой доказательной базой — анализом работы, структурированными интервью со шкалами, рабочими пробами и механическим объединением оценок. Их достаточно, чтобы найм вновь начал замечать экспертизу. Третий: задания на распознавание и проверку ответа LLM позволяют наиболее прямо оценить то, чего модель не даёт, однако их ещё предстоит валидировать.
Для компаний практический вывод таков: пока найм не различает новичка с моделью и эксперта, сегодняшняя экономия на опыте обернётся завтрашней нехваткой тех, кто способен проверять результаты. Для специалистов вывод не менее конкретен: ценность растёт благодаря умению распознавать и проверять, а не просто быстрее остальных получать ответ.
Статья подготовлена при участии Claude Code (Anthropic). Автор подобрал и изучил исследования, сформулировал основную мысль и написал черновик. Claude Code проверил материал на ошибки, отредактировал текст и создал инфографику.
Что почитать
Экспертиза и схемы
-
Chase W. G., Simon H. A. Perception in chess // Cognitive Psychology. 1973. Vol. 4, No. 1. P. 55–81 — классическое исследование распознавания позиций: эксперт запоминает осмысленные конфигурации, но не случайные.
-
Chi M. T. H., Feltovich P. J., Glaser R. Categorization and Representation of Physics Problems by Experts and Novices // Cognitive Science. 1981. Vol. 5, No. 2. P. 121–152 — эксперты группируют задачи по принципам их решения, а новички — по внешним характеристикам.
-
McKeithen K. B., Reitman J. S., Rueter H. H., Hirtle S. C. Knowledge organization and skill differences in computer programmers // Cognitive Psychology. 1981. Vol. 13, No. 3. P. 307–325 — исследование распознавания и организации знаний у программистов.
-
Sweller J. Cognitive load theory and individual differences // Learning and Individual Differences. 2024. Vol. 110. Article 102423 — экспертиза как содержимое долговременной памяти и основной изменяемый источник индивидуальных различий.
-
Kalyuga S., Sweller J. Measuring Knowledge to Optimize Cognitive Load Factors During Instruction // Journal of Educational Psychology. 2004. Vol. 96, No. 3. P. 558–568 — метод «первого шага»: корреляция с полным тестом до 0,92 и сокращение времени проверки в 2,5–4,9 раза.
-
Kalyuga S., Ayres P., Chandler P., Sweller J. The Expertise Reversal Effect // Educational Psychologist. 2003. Vol. 38, No. 1. P. 23–31 — почему помощь, полезная начинающему, может мешать опытному специалисту.
ИИ, производительность и проверка
-
Brynjolfsson E., Li D., Raymond L. Generative AI at Work // The Quarterly Journal of Economics. 2025. Vol. 140, No. 2. P. 889–942 — исследование 5 172 сотрудников поддержки: средний прирост на 15%, наибольшая польза для менее опытных работников.
-
Noy S., Zhang W. Experimental evidence on the productivity effects of generative artificial intelligence // Science. 2023. Vol. 381, No. 6654. P. 187–192 — эксперимент с 453 специалистами: время сократилось на 40%, качество выросло на 18%, различия между работниками уменьшились.
-
Dell’Acqua F., McFowland E., Mollick E., et al. Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality // Organization Science. 2026. Vol. 37, No. 2. P. 403–423 — исследование 758 консультантов: повышение результатов в пределах возможностей модели и снижение доли верных решений на 19% за их пределами.
-
Prather J., Reeves B. N., Leinonen J., et al. The Widening Gap: The Benefits and Harms of Generative AI for Novice Programmers // Proceedings of ICER 2024. P. 469–486 — как генеративный ИИ помогает сильным новичкам работать быстрее и формирует иллюзию компетентности у менее подготовленных.
-
Goddard K., Roudsari A., Wyatt J. C. Automation bias: a systematic review of frequency, effect mediators, and mitigators // Journal of the American Medical Informatics Association. 2012. Vol. 19, No. 1. P. 121–127 — факторы чрезмерного доверия автоматизированным системам и способы его уменьшить.
-
Lee H.-P., Sarkar A., Tankelevitch L., et al. The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers // Proceedings of CHI 2025. P. 1–22 — связь доверия к ИИ с менее активным критическим мышлением.
Валидность методов отбора
-
Sackett P. R., Zhang C., Berry C. M., Lievens F. Revisiting meta-analytic estimates of validity in personnel selection: Addressing systematic overcorrection for restriction of range // Journal of Applied Psychology. 2022. Vol. 107, No. 11. P. 2040–2068 — пересмотр оценок валидности: структурированное интервью занимает первое место, новые оценки ниже прежних на 0,10–0,20.
-
Roth P. L., Bobko P., McFarland L. A. A meta-analysis of work sample test validity: Updating and integrating some classic literature // Personnel Psychology. 2005. Vol. 58, No. 4. P. 1009–1037 — валидность рабочих проб составляет 0,26 без поправок и 0,33 с поправкой.
-
Kuncel N. R., Klieger D. M., Connelly B. S., Ones D. S. Mechanical versus clinical data combination in selection and admissions decisions: A meta-analysis // Journal of Applied Psychology. 2013. Vol. 98, No. 6. P. 1060–1072 — механическое объединение оценок даёт более точный прогноз, чем целостное суждение, в том числе экспертное.
Интервью и суждение интервьюера
-
Levashina J., Hartwell C. J., Morgeson F. P., Campion M. A. The Structured Employment Interview: Narrative and Quantitative Review of the Research Literature // Personnel Psychology. 2014. Vol. 67, No. 1. P. 241–293 — обзор компонентов структурированного интервью и исследований каждого из них.
-
Taylor P. J., Small B. Asking applicants what they would do versus what they did do: A meta-analytic comparison of situational and past behaviour employment interview questions // Journal of Occupational and Organizational Psychology. 2002. Vol. 75, No. 3. P. 277–294 — валидность вопросов о прошлом поведении составляет 0,63, согласованность оценщиков при использовании шкал — 0,77–0,79.
-
Dana J., Dawes R., Peterson N. Belief in the unstructured interview: The persistence of an illusion // Judgment and Decision Making. 2013. Vol. 8, No. 5. P. 512–520 — формирование уверенного впечатления на основе случайных ответов и снижение точности прогноза после неструктурированного интервью.
-
Kahneman D., Klein G. Conditions for intuitive expertise: A failure to disagree // American Psychologist. 2009. Vol. 64, No. 6. P. 515–526 — условия надёжной интуиции и причины, по которым субъективная уверенность не гарантирует точности.
-
Behroozi M., Shirolkar S., Barik T., Parnin C. Does stress impact technical interview performance? // Proceedings of ESEC/FSE 2020. P. 481–492 — влияние тревоги из-за наблюдения на результаты технического интервью у доски.
Автоматизация, обучение и труд
-
Bastani H., Bastani O., Sungu A., et al. Generative AI without guardrails can harm learning: Evidence from high school mathematics // Proceedings of the National Academy of Sciences. 2025. Vol. 122, No. 26. Article e2422633122 — прирост на 48% и 127% при доступе к ИИ, снижение на 17% после его отключения и роль защитных подсказок.
-
Bainbridge L. Ironies of automation // Automatica. 1983. Vol. 19, No. 6. P. 775–779 — автоматизация лишает оператора практики, необходимой для контроля над ней.
-
Acemoglu D., Restrepo P. Automation and New Tasks: How Technology Displaces and Reinstates Labor // Journal of Economic Perspectives. 2019. Vol. 33, No. 2. P. 3–30 — автоматизация как перераспределение задач, при котором человеческий труд одновременно вытесняется и получает новые области применения.
Похожие статьи
 Учёные выяснили причину минутных пульсаций энергосетей по всему миру
 Как дискуссия о безопасности ИИ переросла в спор об открытом исходном коде
 Почему швы первого бюстгальтера для бега были снаружи: история трёх женщин и двух суспензориев
 ИИ освоил понимание ДНК и создание белков по текстовому описанию
 Большое тихоокеанское мусорное пятно изменяет окраску океана
 Насколько сложно взломать второй фактор MFA?
 Как не путаться в синусе, косинусе и тангенсе
 Девяностые: последняя эпоха будущего