
Команда Яндекса сообщила о новом достижении проекта по развитию нейросетей, распознающих текст. Разработчики научили фирменные нейросети расшифровывать архивные записи со сложной дореволюционной орфографией.
Пользователи могут протестировать технологию в действии в сервисе «Поиск по архивам». В рамках проекта доступно более чем 2,5 миллионам страниц исторических документов XVIII — начала XX веков с текстовой расшифровкой, включая метрические книги, исповедные ведомости и ревизские сказки с результатами переписи населения.
Как отмечают разработчики, сервис «Поиск по архивам» пригодится историкам, социологам, демографам, генеалогам и простым пользователям, которые ищут сведения о своей семье.
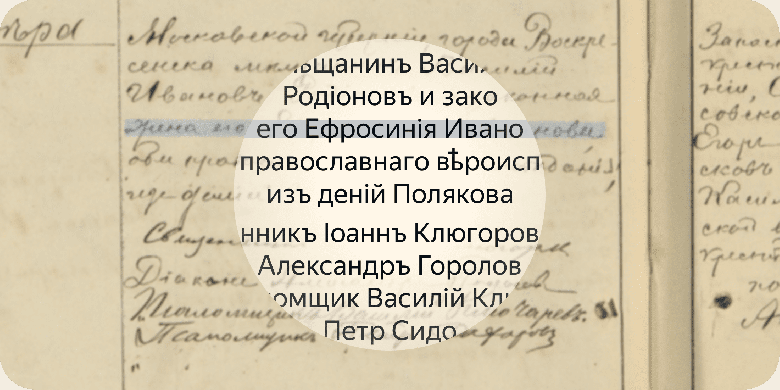
Новый алгоритм оптического распознавания учитывает особенности почерка и структуру архивных документов, а также справляется с символами и буквами, опознаёт больше не использующимися в русском языке. Нейросеть прошла обучение на сотнях тысяч рукописных строк из реальных текстов XVIII–XIX веков и десятков миллионов сгенерированных примеров.
Руководитель «Поиска Яндекса» Елена Бубнова рассказала:
Для расшифровки одной страницы архивного рукописного текста профессионалу может потребоваться до получаса времени. Наш сервис справляется с этим за несколько секунд. В перспективе технологию можно использовать и для решения других задач в продуктах Яндекса.
 OpenIDE 2026.2 обновила DB-клиент, а версия Pro получила ИИ-агентов
 Анонсирован первый в мире ATX-блок питания с сертификатом 80 Plus 230V Ruby
 Donut Lab создала первую в мире серийную твердотельную батарею для авто с литием и натрием
 Смартфон Xiaomi 18 Pro в «галактическом» синем цвете: вызов для Galaxy
 Как действовать после утечки данных: рекомендации главы «РуБэкап»
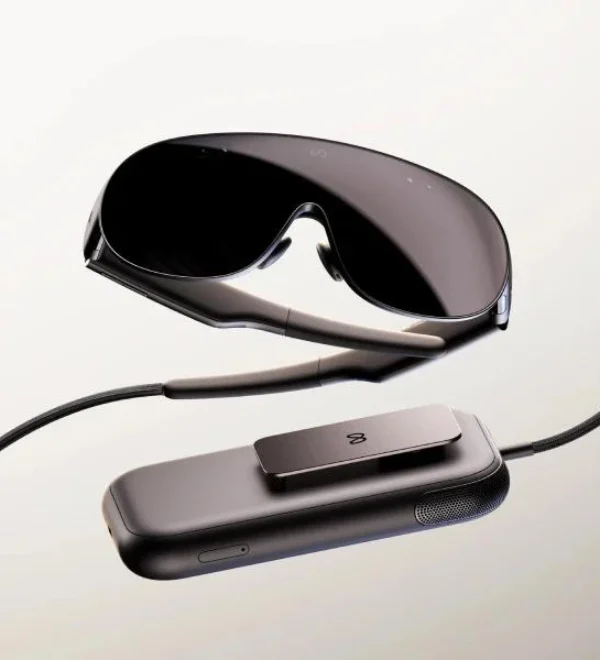 Представлены Meta* VR Glasses — первые 100-граммовые VR-очки с сертификацией IMAX Enhanced
 Huawei nova 16s доступны для предзаказа в «М.Видео» от 44 999 рублей
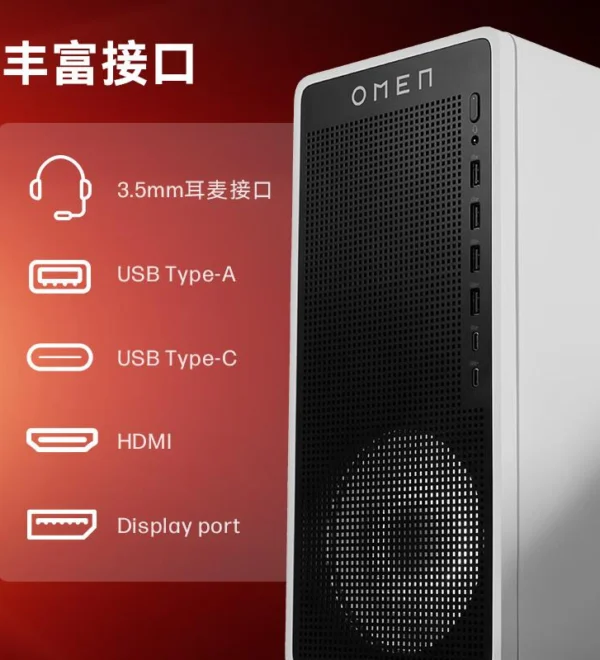 HP представила белый игровой компьютер за $1200 с процессором Core Ultra 5 и видеокартой RTX 5060