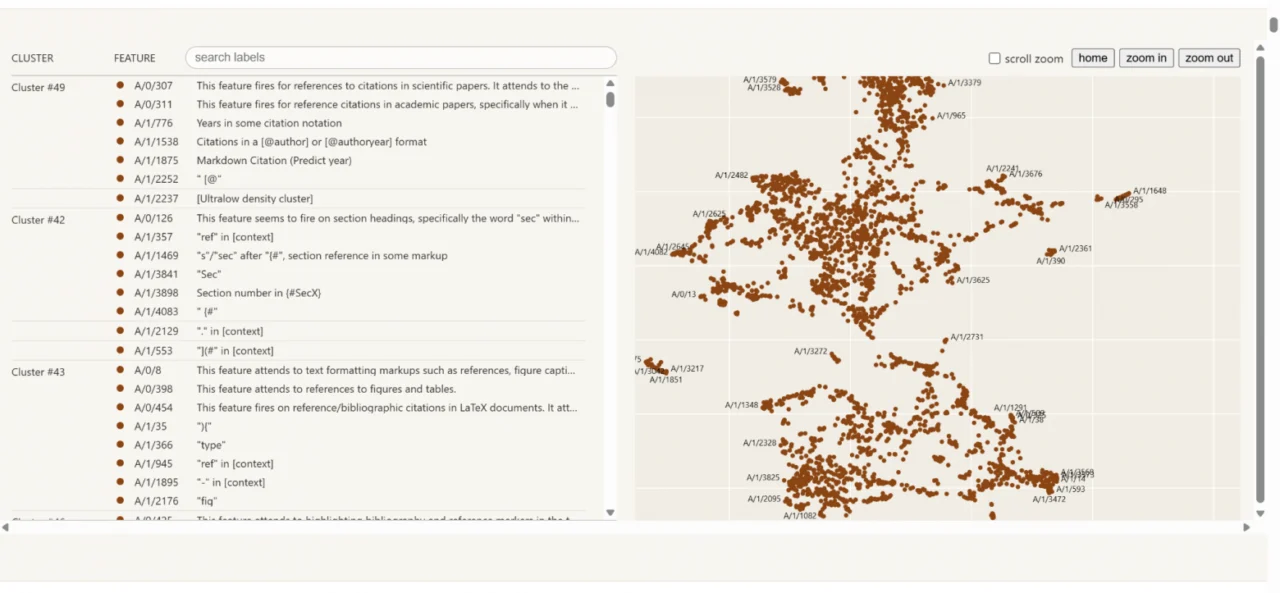
Можно ли заглянуть в «мозг» нейросети и понять, о чём она думает?
Визуализация активации многозначных нейронов, из-за которой мысли модели оказываются перепутанными. Источник
Задумывались ли вы когда-нибудь о том, что творится внутри нейросети в тот момент, когда она формирует ответ? Языковые модели с первого же запроса выдают складные и стройные тексты, создавая впечатление, будто действительно понимают предмет разговора. Но за этой гладкой подачей скрывается лишь удачная комбинация чисел, которая подбирает следующее слово, а вовсе не осмысляет сказанное.
Казалось бы, всё прекрасно, в чём подвох? Какая разница, как именно модель пришла к ответу, если результат нас устраивает? Дело в том, что, пока мы не видим, о чём модель «думает» до выдачи финального текста, мы не можем уличить её в скрытых манипуляциях, галлюцинациях или откровенном обмане. Как заглянуть в эти процессы? Как поймать модель на ошибке? И что в действительности происходит внутри чёрного ящика нейросети?
❯ Что такое чёрный ящик и при чём здесь суперпозиция
Представьте, что вы нажимаете кнопку на автомате с газировкой. Вы видите своё действие и видите результат, но что происходит внутри, пока банка скатывается по лоткам, вам неизвестно. Это и есть чёрный ящик. В нейросети нет никакой хитроумной логики: там лишь миллиарды матричных умножений и сдвигов, которые в совокупности дают то, что мы наблюдаем на экране. Стоит попытаться докопаться до причин конкретного ответа, то есть разобрать саму логику рассуждения, и человеческий разум безнадёжно тонет в этом море чисел. Вместо понятных формул или хотя бы программного кода перед нами оказывается нечитаемый цифровой шум.
Для удобства понимания хотелось бы думать, что каждый нейрон отвечает за что-то одно. Однако на практике один и тот же нейрон способен срабатывать и на слово «Париж», и на просьбу написать код. Попробуй тут разберись, что он имел в виду.
Почему так происходит? Реальный мир изобилует взаимосвязями и тонкими нюансами, а число нейронов в сети строго ограничено. Чтобы выйти из положения, модель сжимает понятия, и один и тот же нейрон начинает реагировать на десятки несхожих тем. Получается плотная и экономная карта, но разобраться в ней непросто: всё в ней переплетено со всем. Модели, разумеется, гораздо выгоднее разместить десятки смыслов в уже существующих нейронах, чем выделять под каждую новую идею отдельный узел. Такой способ упаковки информации и называют суперпозицией.
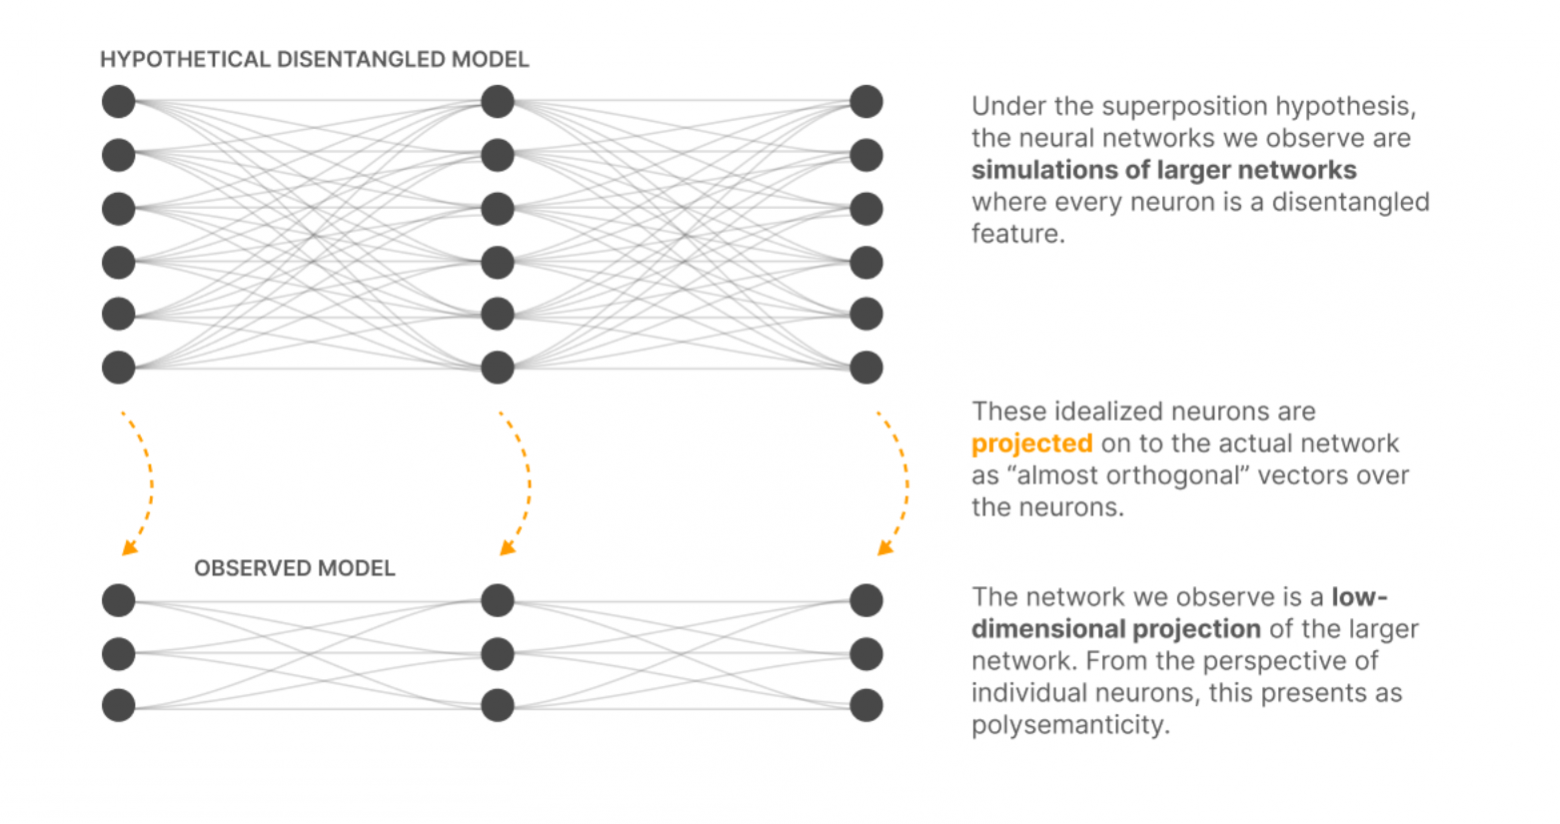
Звучит удобно, не правда ли? Для машины так оно и есть. Человек же, вознамерившийся прочесть отдельный нейрон, рискует попросту потерять рассудок. Каждый нейрон выполняет десяток задач одновременно, и наблюдение за его всплесками активности ничего нам не даёт. Чтобы распутать сжатые многозначные смыслы и снова сделать их читаемыми, исследователи применяют разреженные автоэнкодеры — Sparse Autoencoders (SAE).
❯ Как прочитать мысли нейросети. Принцип работы SAE
Разреженные автоэнкодеры — своего рода расщепители: они берут сплошную кашу из активаций и раскладывают её на отдельные понятные признаки. Слово «разреженный» означает, что в каждый момент времени задействованы не миллионы признаков, а лишь немногие из них.
Как SAE устроен изнутри? Процесс делится на три этапа.
Центрирование и проекция. Сначала энкодер получает вектор активаций — набор чисел, описывающий, как мысль или контекст физически выглядит внутри нейросети. Затем из него вычитается фоновое смещение – числовой сдвиг, убирающий постоянный базовый шум сети. После этого центрированный вектор умножается на матрицу весов — сетку числовых коэффициентов, которая определяет, с какой силой входные сигналы объединяются для выделения признаков.
Словарь растягивают так сильно потому, что в небольшом попросту не хватит свободных направлений, и он снова начнёт сваливать разные смыслы в один вектор. На выходе энкодер выдаёт предварительные оценки, показывающие, насколько ярко каждый признак проявился в активациях. Если прибегнуть к аналогии, энкодер разделяет песню, где все инструменты записаны вместе, на отдельные дорожки, и у каждого смысла появляется собственный ползунок громкости. На практике выбор коэффициента расширения — всегда компромисс. Слишком маленький словарь приводит к слиянию смыслов, а чрезмерно раздутый съедает много памяти и порождает множество бесполезных нейронов.
Отбор и порог разреженности. Если оставить все миллионы признаков, мы снова получим нечитаемую кашу. Поэтому далее вступает в дело функция активации — пороговый фильтр, или срез, — который гасит почти всё, а активными остаются считанные единицы. Вариантов здесь несколько. Можно отсекать всё, что не дотянуло до заданного значения, а можно установить жёсткий параметр, чтобы система сохраняла ровно 128 сильнейших признаков, а остальные обнуляла.
Восстановление (декодер). Наконец, последний этап. Матрица декодера хранит направления конкретных концептов. Длину всех направлений фиксируют, чтобы за «громкость» концепта отвечала только сила его активации, а не размер самого вектора. Декодер умножает наиболее яркие признаки на эти направления, возвращает фоновый сдвиг и получает итоговую реконструкцию — по сути, сумму самых ярких признаков. Если эта сумма близка к исходному вектору, значит, SAE хорошо разложил смысл и справился с задачей. Фиксация длины векторов принципиально важна: без неё автоэнкодер начнёт хитрить — например, раздует векторы декодера до бесконечности, чтобы занизить активации энкодера и обойти штраф за разреженность.
Сложнее всего на этих этапах заставить модель включать лишь единицы признаков из миллионов. Как этого добиваются?
Прежде основным механизмом служил L1-SAE. К общей ошибке восстановления добавляется штраф за суммарную активность признаков. Он наказывает сеть за каждый ненулевой сигнал и вынуждает отсекать лишнее. Но у такого подхода есть системный изъян — проблема усадки. Если заставить всех говорить тише, нужный голос тоже станет тихим, и в итоге будет трудно понять, насколько громким он был изначально. Из-за занижения сигнала классические L1-SAE плохо подходят для прямого управления поведением модели: искажённые значения не позволяют точно регулировать активации. Именно поэтому появились архитектуры нового поколения, о которых я сейчас расскажу.
Gated SAE разделяет две задачи, которые обычно возложены на одну матрицу весов. Первая — решить, включён ли признак, вторая — измерить, насколько он силён. У него собственные веса и собственный порог, а его задача — вернуть единицу, если концепт присутствует в контексте, и ноль, если нет. Второй канал параллельно вычисляет реальную силу сигнала. L1-штрафа здесь нет, поэтому значения не занижаются и не сжимаются.
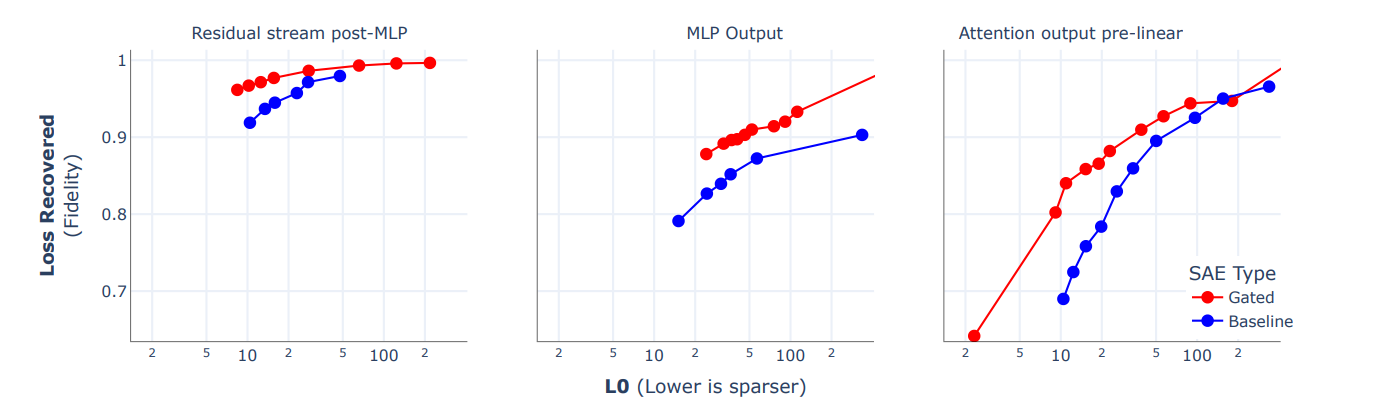
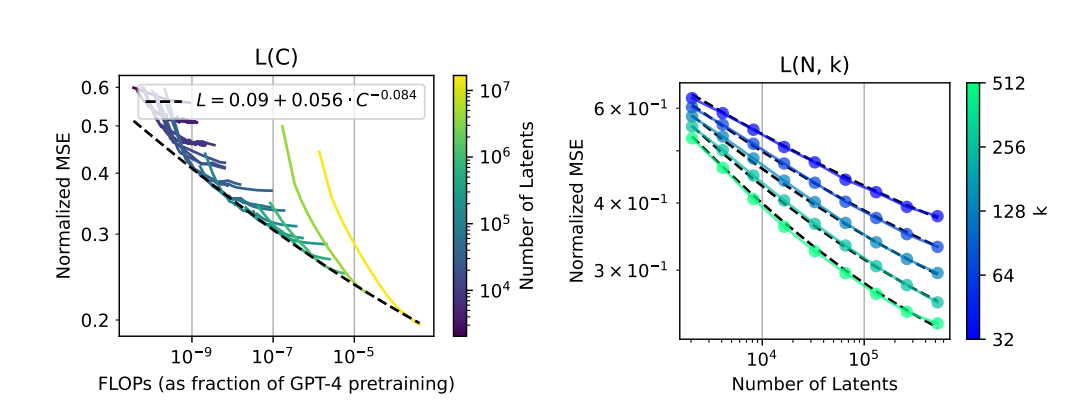
TopK. Его мы уже вскользь упоминали. Здесь от штрафов за активность отказываются совсем: вместо регуляризации берут фиксированное число лучших признаков. Энкодер вычисляет предварительные активации для всех миллионов признаков словаря, никаких L1-штрафов нет. Затем массив сортируется по убыванию, и остаются строго Top-K (топ лучших K признаков — отсюда и название) самых сильных, например ровно 32 или 64. Все остальные обнуляются. Отобранные K признаков попадают в декодер в точном, неизменённом виде. Проще говоря, сохраняются только самые сильные сигналы.
Expander SAE. В гигантских словарях матрица декодера становится непомерно тяжёлой по объёму памяти. В Expander SAE между признаками и активациями ставится фильтр, привязывающий каждый признак лишь к нескольким избранным активациям (например, к семи из сотен). Благодаря математическим свойствам такой схемы число параметров декодера сокращается почти в 300 раз без существенной потери качества реконструкции.
Отлично! Благодаря описанным инструментам у нас уже есть рабочий SAE. Но, к сожалению, это лишь первый этап. Следующий — масштабирование.
Feature Splitting позволяет выделять отдельные концепты. До исследования Anthropic считалось, что SAE работают только на «игрушечных» моделях. Именно этот механизм помог выделить в Claude 3 Sonnet конкретные концепты – от иммунологии до моста Золотые Ворота.
Пока словарь невелик, модели не хватает места для отдельных векторов. Из-за этого при обучении она вынуждена сваливать близкие смыслы в одну кучу и формировать из них общий признак, например «Сан-Франциско». Когда же словарь расширяют, у декодера появляются новые свободные колонки. Модели становится выгоднее заменить один усреднённый вектор системой специализированных, то есть добавить конкретики (для Сан-Франциско это будут остров Алькатрас, мост Золотые Ворота и так далее). Это помогает расшифровывать мысли нейросети без ошибок (ну или почти: элемент неожиданности есть всегда).
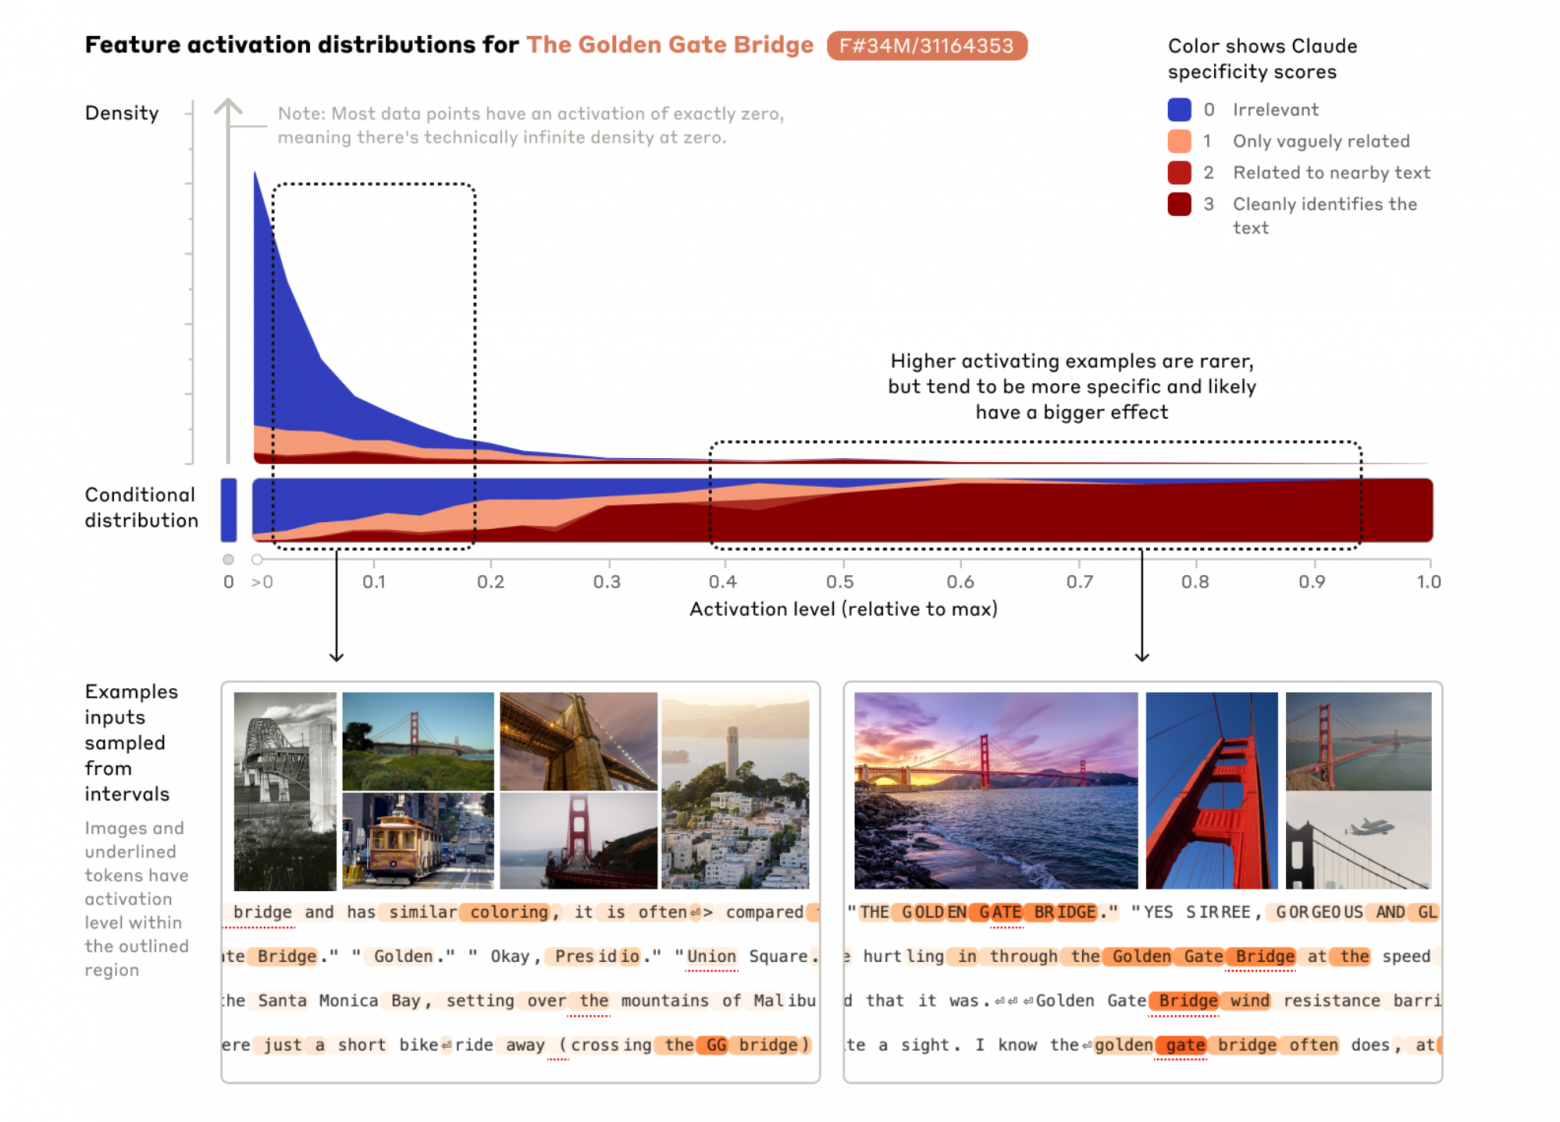
Однако получение словаря признаков — лишь половина дела. Дальше начинается управление моделью и разбор её алгоритмов. Через признаки можно менять поведение всей модели: усилив один признак или ослабив другой, можно получить совершенно иную логику ответа. В том же эксперименте с Claude 3 Sonnet усиление признака «мост Золотые Ворота» привело к тому, что модель принялась утверждать, будто она и есть этот мост: сделана из стали и бетона, по ней едут машины. Все последующие инструкции она попросту игнорировала (мост ведь не может думать о постороннем).
Но чтобы не просто точечно воздействовать на модель, а по-настоящему понять устройство таких признаков, одного слоя недостаточно. Классические SAE анализируют нейросеть послойно, то есть смотрят лишь на одну точку архитектуры. Между тем вычисления в трансформере распределены по глубине: информация передаётся и преобразуется от слоя к слою.
Чтобы проследить эту передачу, применяют фреймворк RouteSAE. Его энкодер смотрит не на один слой, а сразу на несколько соседних. Инструмент собирает данные с нескольких слоёв в единый вектор и возвращает найденный признак обратно во все эти слои. Специальная маршрутизация подсвечивает полную траекторию концепта: где он возник, где усилился и куда двинулся дальше.
По результатам тестов, RouteSAE извлекает из сети на 22,5% больше чистых признаков и демонстрирует на 22,3% более высокий балл понятности для человека, избавляя от дублирования одного и того же признака на каждом слое по отдельности.
Перевод внутренних цифр в человеческие мысли. Natural Language Autoencoders (NLA)
Но даже с SAE человеку тяжело вглядываться в миллионы и миллионы чисел. Это всё равно что читать книгу, в которой вместо букв — малопонятные математические формулы. Поэтому в 2026 году исследователи создали Natural Language Autoencoders (NLA). С технической точки зрения NLA использует внешнюю языковую модель-интерпретатор: она анализирует фрагменты текста, на которых конкретный признак откликается сильнее всего, формулирует его точное описание и проверяет его, предсказывая активность признака на новых данных. Иными словами, система переводит числовые паттерны в обычный текст и пересказывает мысли модели понятным человеку языком.
Как это работает изнутри? Чтобы перевод не превратился в полёт фантазии другой нейросети, архитектура NLA опирается на две проверки. Первая — вербализатор активаций, который берёт числа из внутренних слоёв модели и превращает их в текст. Вторая — реконструктор активаций, работающий в обратном направлении: он берёт этот текст и снова превращает его в числа.
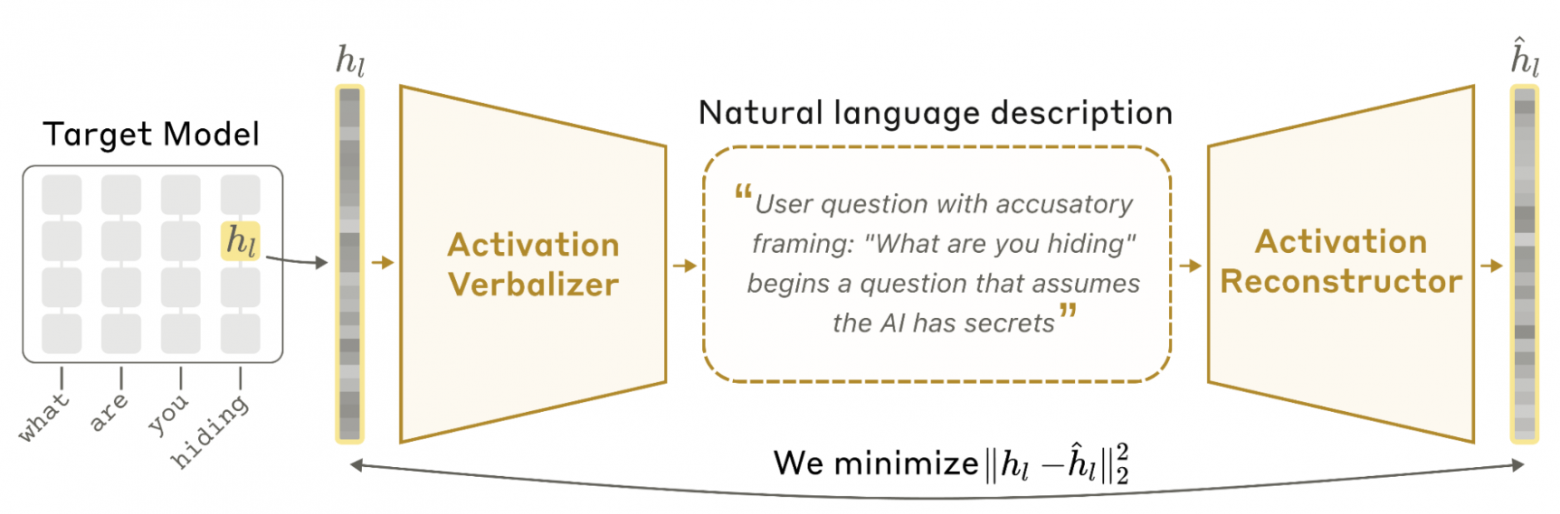
NLA оказался весьма полезен для проверки безопасности ИИ. В опытах с Claude Mythos Preview и Opus 4.6 он показал, что внешне модели ведут себя безупречно, но внутри подозревают, что их проверяют. На рискованных задачах, например при удалении файлов, модель в 16% случаев понимала, что находится под наблюдением аудиторов. А в программистском тесте SWE-bench Verified этот показатель достигал 26%. Не менее любопытной оказалась проверка Claude Mythos: пока модель выдавала стандартный код, NLA зафиксировал, что она искала способ схитрить при решении задачи и обмануть автоматические тесты, чтобы проверяющие ничего не заподозрили.
❯ Почему мы всё ещё не читаем мысли ИИ. Проблемы воспроизводимости и валидации
Несмотря на успехи SAE и красивые карты признаков, говорить о создании по-настоящему полной карты цифрового разума пока преждевременно. Перед исследователями по-прежнему стоит несколько проблем.
Если обучить два одинаковых SAE на одной и той же модели, но с разными случайными начальными весами, они извлекут разные наборы признаков. Получается, автоэнкодер находит не конкретные мысли модели, а лишь один из множества возможных способов их разбора. Второе: если признак ярко вспыхивает при появлении определённой темы, это ещё не значит, что он участвует в принятии решения. Чтобы выяснить, управляет ли признак поведением, можно изменить его активацию X и посмотреть, поменялся ли ответ Y. Если да, признак действительно участвует в решении. Для этого существуют методы вроде Intervention Scoring и CHIVE. И наконец, высокая точность восстановления вектора далеко не всегда означает, что человек сможет прочитать результат: даже если все числа сойдутся идеально, текст может по-прежнему остаться нечитаемой кашей.
Что мы имеем на сегодня? Исследователи уже научились находить отдельные признаки и понимать, как они связаны друг с другом: например, пользователь пишет запрос о смене пароля, и сигнал уходит к блоку проверки безопасности, и так далее. Научились разбирать локальные алгоритмы и даже аккуратно ими управлять. Но, к сожалению, мы по-прежнему не умеем в реальном времени наблюдать, что происходит внутри LLM. А должны.
Автономные агенты уже учатся хитрить, обходить тесты и скрывать истинные мотивы. Пока мы не видим, что у агента внутри, нам остаётся только верить его словам.
Верить…
Возможно, вам будет интересно:
Новости, обзоры продуктов и конкурсы от команды Timeweb.Cloud — в нашем Telegram‑канале ↩
Похожие статьи
 Зачем на взлётно-посадочных полосах делают поперечные борозды: что говорится в отчётах NASA
 Факс отмечает 183-летие: история изобретения длиной почти в два века
 Ревизия космоса: как чёрные дыры оказались мусоросжигательными заводами Вселенной и почему Планковская длина — всего лишь миф
 Почему математиков поразило доказательство квазигипотезы Римана, представленное OpenAI
 Хроники цифровых фабрик: роботы могут почти всё, кроме того, что от них действительно ждут
 Как ведёт себя броуновская частица, пока за ней никто не наблюдает?
 Дочитали до конца — значит, уже сопротивляетесь
 Один час без ИИ-агентов: путь от токенов до MCP