Литературный обзор без рутины: поиск через API Scopus, WoS и OpenAlex, отбор публикаций, работа с PDF и оформление списка по ГОСТ
Тем, кто готовил обзор литературы, знакома эта последовательность. Один и тот же поисковый запрос приходится адаптировать для трёх баз, каждая из которых использует собственный синтаксис. Затем результаты объединяют, удаляют дубликаты и просматривают сотни аннотаций. PDF-файлы скачивают по одному через «Войти через организацию», а список источников оформляют по ГОСТ. Под конец нужна схема PRISMA, и данные для неё приходится восстанавливать задним числом. Большая часть этой работы сводится к повторяющимся операциям.
Ниже расскажу, как автоматизировать каждый этап с помощью открытых API, и приведу примеры запросов, которые можно проверить самостоятельно. А ещё покажу бесплатную программу для Windows и Mac, объединяющую эти возможности. Я её автор, поэтому отдельно и честно расскажу об ограничениях.
Шаг 1. Один поисковый запрос для трёх баз
У каждой базы собственный язык запросов: Scopus использует TITLE-ABS-KEY(...), Web of Science — TS=(...), а OpenAlex — параметры search и filter. При ручной адаптации легко ошибиться, например в расстановке скобок. Программа формирует три запроса из единого списка: каждое понятие записывается с новой строки, а его синонимы разделяются точкой с запятой. Синонимы в одной строке объединяются оператором OR, строки между собой — оператором AND, а словосочетания заключаются в кавычки.
Например, для обзора о биоугле из кофейной гущи достаточно ввести две строки:
spent coffee grounds; coffee waste
biochar; pyrolysis
Укажем период 2015–2025 и типы публикаций: статьи и обзоры. Результат будет таким; переносы строк добавлены для удобства чтения:
Scopus:   TITLE-ABS-KEY(("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis))
          AND PUBYEAR > 2014 AND PUBYEAR < 2026 AND (DOCTYPE(ar) OR DOCTYPE(re))

WoS:      TS=(("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis))
          AND PY=(2015-2025) AND DT=(Article OR Review)

OpenAlex: search=("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis)
          filter=from_publication_date:2015-01-01,to_publication_date:2025-12-31,type:article|review
Все три варианта отображаются в окне программы: перед запуском поиска их можно отредактировать вручную. Затем программа обращается к API:
-
Scopus Search API. Потребуются ключ разработчика Elsevier и доступ организации: запросы необходимо отправлять из сети вуза либо с институциональным токеном. Если доступа нет, программа сообщит именно об этом, а не выдаст ошибку «неверный ключ».
-
Web of Science Starter API. У Clarivate есть бесплатный тариф со строгими ограничениями на количество запросов, поэтому программа выдерживает паузу между страницами результатов.
-
OpenAlex. Это открытая база; бесплатный ключ позволяет увеличить лимиты.
Результаты объединяются по DOI без учёта регистра: каждому DOI соответствует одна запись, при этом сведения об источниках сохраняются. Программа фиксирует количество записей из каждой базы, число дубликатов и записей без DOI. Впоследствии эти данные пригодятся для схемы PRISMA.
Работать можно и без ключей — в режиме «через браузер». Программа открывает Scopus или расширенный поиск WoS с готовым запросом. Вы экспортируете результаты, а она автоматически находит файл в папке «Загрузки». Поддерживаются форматы экспорта WoS Plain text и Tab-delimited, а также Scopus CSV и RIS.
Оценить, достаточно ли поисковых слов, помогает OpenAlex. Программа выбирает 50 наиболее подходящих публикаций и подсчитывает, какие ключевые слова и темы встречаются в них чаще всего.
Попробовать OpenAlex можно и самостоятельно, без программы, через командную строку:
curl -G "https://api.openalex.org/works" \
  --data-urlencode 'search=("spent coffee grounds" OR "coffee waste") AND (biochar OR pyrolysis)' \
  --data-urlencode 'filter=from_publication_date:2015-01-01,to_publication_date:2025-12-31,type:article|review' \
  --data-urlencode 'per-page=25' \
  --data-urlencode 'select=doi,title,publication_year'
6 ноября 2026 года OpenAlex выдал по этому запросу 3978 записей. Для выгрузки нескольких страниц понадобится параметр cursor.
Шаг 2. Отбор по названиям и аннотациям
Для первичного отбора нужны аннотации, но поисковые API нередко возвращают данные без них. Программа бесплатно дополняет записи по DOI: получает аннотации из OpenAlex, а библиографические сведения — авторов, том, выпуск и страницы — из Crossref. Запросы отправляются пакетами: до 50 DOI за раз в OpenAlex и по 20 — в Crossref.
Первая особенность: OpenAlex хранит аннотацию не в виде обычного текста, а как «перевёрнутый индекс» — словарь вида «слово → позиции». Восстановить текст можно следующим образом:
def abstract_from_inverted_index(inv: dict) -> str:
    words = sorted((pos, word) for word, positions in inv.items() for pos in positions)
    return " ".join(word for _, word in words)
Вторая особенность касается статей Elsevier: их аннотаций в OpenAlex нет, поскольку издатель не передаёт эти данные. В таких случаях программа обращается к Europe PMC. Это позволяет найти аннотации к работам, индексируемым PubMed, но охватывает не все статьи.
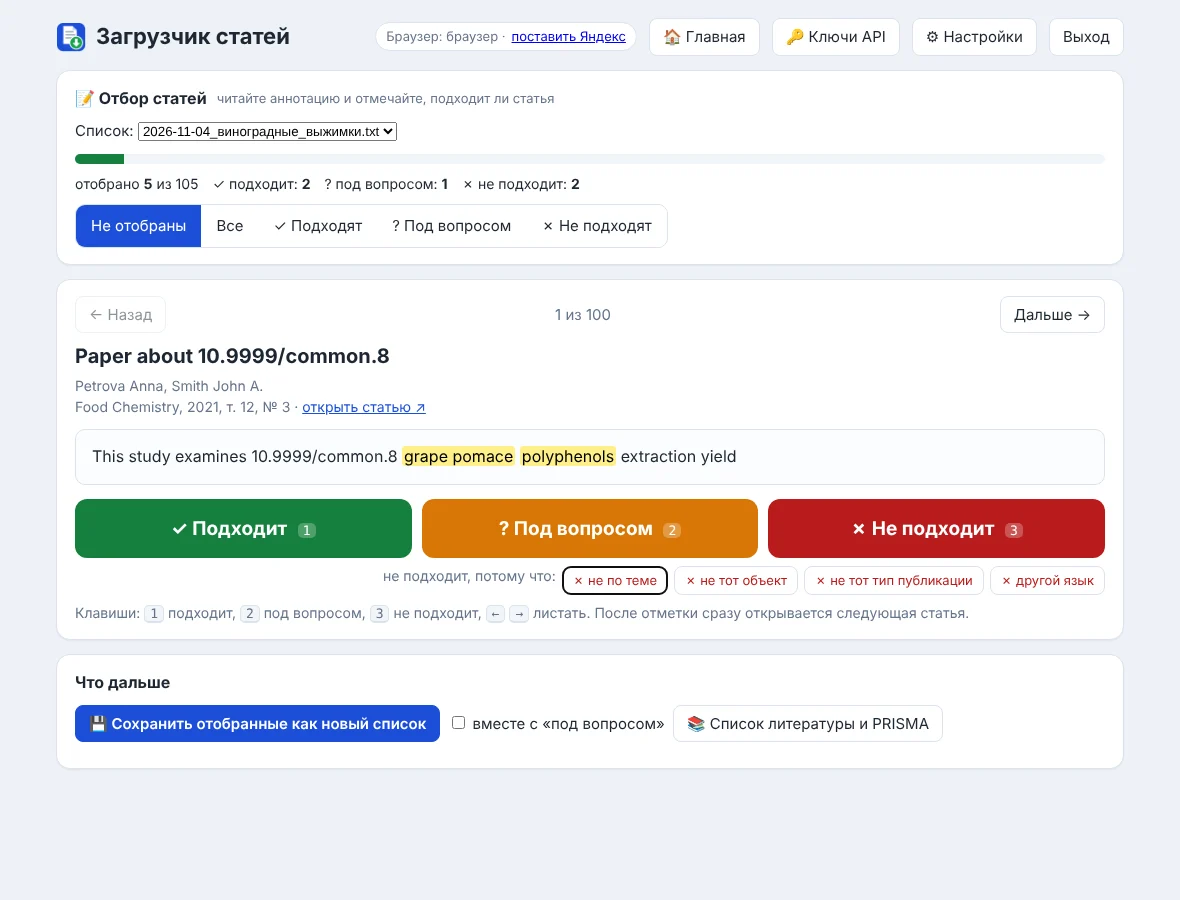
Отбор проходит так: на экране отображается одна статья, слова из запроса выделены, а решение выбирается клавишей. 1 — подходит, 2 — под вопросом, 3 — не подходит. Для исключённых работ можно указать причину: «не по теме», «не тот объект», «не тот тип публикации» или «другой язык». Решения сохраняются, а из подходящих статей можно сформировать новый список. На снимке ниже показаны тестовые данные.
Шаг 2½. За пределами поиска: связи между статьями и отзывы публикаций
Поиск по ключевым словам неизбежно что-то пропускает: авторы могут использовать другие термины или иначе сформулировать название. Поэтому при подготовке систематических обзоров применяют метод «снежного кома»: изучают источники, на которые ссылаются отобранные статьи, а также работы, цитирующие их. Оба типа сведений OpenAlex предоставляет бесплатно.
Найти публикацию по DOI и получить её идентификатор и список цитируемых работ:
curl "https://api.openalex.org/works/doi:10.1136/bmj.n71?select=id,referenced_works,cited_by_count"
Найти работы, которые её цитируют, начиная с наиболее цитируемых; W… — идентификатор из предыдущего ответа:
curl -G "https://api.openalex.org/works" \
  --data-urlencode 'filter=cites:W3118615836' \
  --data-urlencode 'sort=cited_by_count:desc' \
  --data-urlencode 'select=doi,display_name,publication_year'
Программа выполняет такой поиск для всех статей со статусом «подходит». Найденные работы ранжируются по числу связей с уже отобранными публикациями: если на статью ссылаются пять работ из вашей подборки, она, вероятно, заслуживает внимания. Добавленные таким способом публикации также проходят отбор, а в схеме PRISMA учитываются отдельно — как «найдено по ссылкам».
Ещё одна важная проверка касается отозванных статей (retracted). Журналы иногда отзывают публикации из-за ошибок или подлога, и обнаружить такую ссылку в диссертации было бы неприятно. В OpenAlex для каждой работы предусмотрено поле is_retracted:
curl "https://api.openalex.org/works/doi:10.1016/S0140-6736(97)11096-0?select=display_name,is_retracted"
Это известная статья Wakefield, опубликованная в Lancet в 1998 году и отозванная в 2010-м: ответ содержит "is_retracted": true. Программа проверяет таким образом все статьи списка и выделяет отозванные красным как при отборе, так и в списке литературы.
Шаг 3. Загрузка PDF по подписке вуза
Один из самых трудоёмких этапов — скачивание полных текстов, доступных по подписке вуза. Программа использует для этого отдельный браузер с собственным профилем: Яндекс.Браузер, Edge или Chrome, в зависимости от того, что установлено на компьютере. Управление осуществляется через Chrome DevTools Protocol с помощью Playwright.
Процесс выглядит так:
-
Вы один раз входите на сайты издательств через «Войти через организацию» (Shibboleth / OpenAthens). Данные входа сохраняются в профиле браузера.
-
Перед загрузкой программа открывает вкладки сайтов издательств: ScienceDirect, SpringerLink, Nature, Wiley, ACS, Taylor & Francis, Oxford Academic, MDPI, Frontiers, CNKI и eLIBRARY.RU. Затем она ждёт, пока завершатся проверки «вы не робот». Капчу вы проходите самостоятельно: программа не пытается её обойти.
-
После этого статьи скачиваются по очереди, и вам не обязательно оставаться у компьютера. Если проверка появится в процессе, программа предупредит вас и подождёт. Публикация, которую не удалось открыть, переместится в конец очереди.
Важное замечание о нагрузке и условиях подписки. По умолчанию между загрузками выдерживается пауза в 10 секунд, а за день предпринимается не более 300 попыток. Это существенное ограничение: многие издательские лицензии запрещают массовое автоматическое скачивание, и нарушение может привести к блокировке доступа для всего вуза. Загружайте только материалы, необходимые для обзора, и заранее уточните правила в библиотеке.
Результаты сохраняются в файл «Отчёт.csv»: в нём указано, какие публикации удалось скачать, а какие — нет.
Шаг 4. Список литературы и схема PRISMA
Для оформления по ГОСТ Р 7.0.100–2018 используется встроенный модуль, которому не нужен интернет. Основные правила:
-
если авторов от одного до трёх, первый указывается в заголовке, а все — после косой черты; если авторов четверо, все перечисляются после косой черты; если пять и более — приводятся первые трое и добавляется «[и др.]» или «[et al.]»;
-
обозначения выбираются на русском или английском языке: Т./Vol., №/No., С./P.;
-
если вместо страниц у публикации указан номер статьи, используется он;
-
сначала размещаются русскоязычные источники, затем источники на латинице.
Также доступны встроенные стили APA 7, Vancouver, IEEE, ACS, Chicago, Nature и Elsevier Harvard. Для оформления по требованиям конкретного журнала используется не всем известная возможность: doi.org может самостоятельно оформить ссылку в любом из стилей Citation Style Language. Их около 11 тысяч — это те же стили, которые применяются в Zotero и Mendeley. Нужный формат достаточно указать в заголовке Accept:
curl -LH "Accept: text/x-bibliography; style=apa; locale=en-US" https://doi.org/10.1136/bmj.n71
Ответ:
Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., Shamseer, L.,
Tetzlaff, J. M., Akl, E. A., Brennan, S. E., Chou, R., Glanville, J., Grimshaw, J. M., Hróbjartsson, A.,
Lalu, M. M., Li, T., Loder, E. W., Mayo-Wilson, E., McDonald, S., et al. (2021). The PRISMA 2020 statement:
an updated guideline for reporting systematic reviews. Bmj, n71. https://doi.org/10.1136/bmj.n71
Обратите внимание на написание «Bmj». Качество оформления зависит от метаданных Crossref, поэтому готовый список рекомендуется проверить вручную.
Список можно сохранить в форматах .txt и .docx — последний поддерживает курсив. Для менеджеров ссылок доступны .ris (Zotero, EndNote) и .bib (LaTeX).
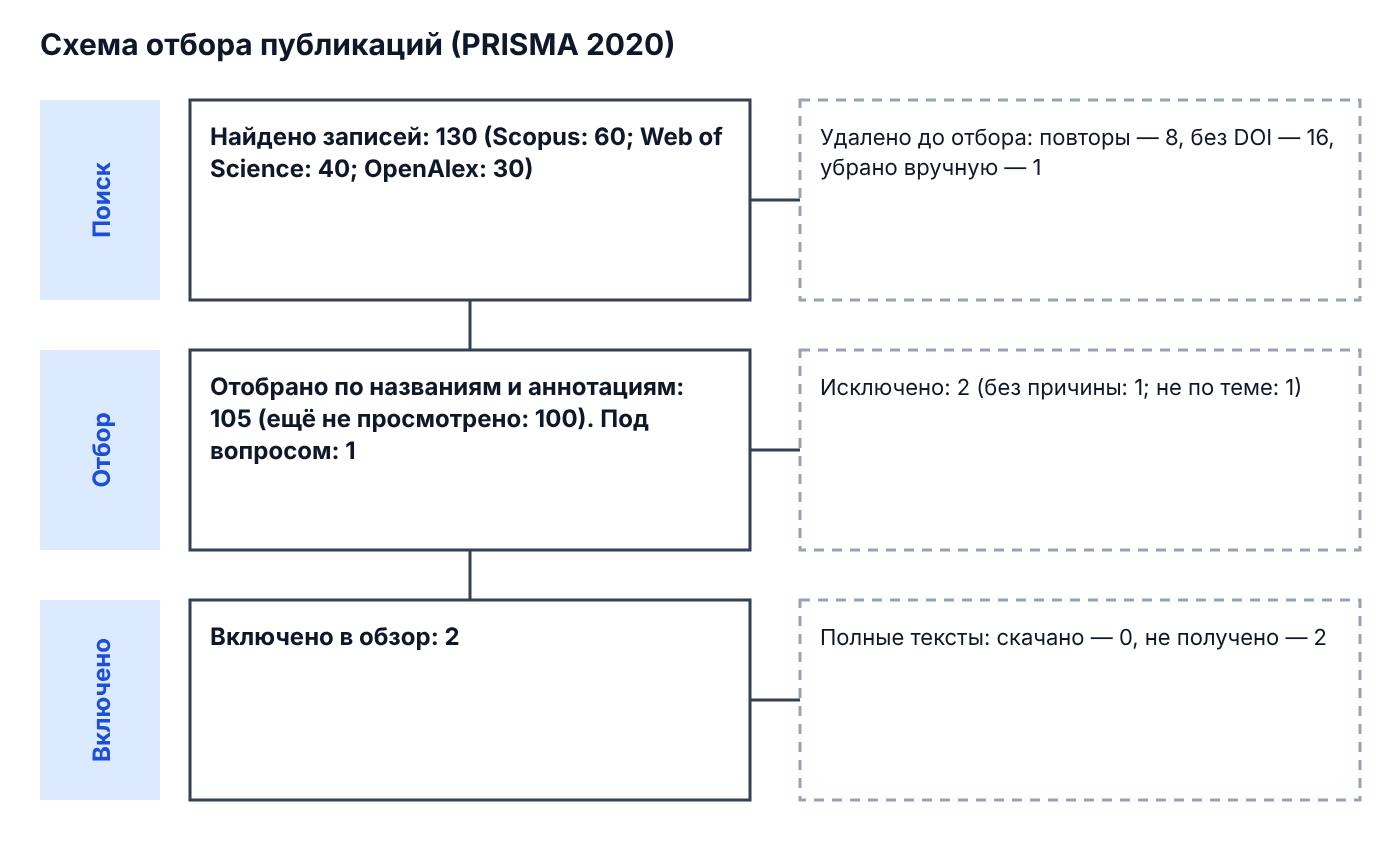
Схема PRISMA. Программа накапливает необходимые данные по мере работы: — количество записей, найденных в каждой базе; — число дубликатов и записей без DOI, а также количество удалённых вручную; — число статей, исключённых при отборе, и причины исключения; — количество скачанных полных текстов и публикаций, которые не удалось получить.
В результате формируется упрощённая схема по образцу PRISMA 2020. Она отображается на экране и доступна в текстовом виде и как изображение PNG. На снимке ниже использованы тестовые данные.
ИИ-помощник — необязательная возможность
Все описанные функции работают без ИИ. Если нужен помощник, можно подключить его с собственным ключом одного из сервисов: Perplexity, ChatGPT, Claude, GigaChat или YandexGPT. Ключ хранится только на вашем компьютере, оплату запросов взимает непосредственно сервис, а программа показывает сумму расходов.
Возможности помощника:
-
Подбор поисковых слов. Он преобразует тему, описанную своими словами, в 2–4 понятия и предлагает для каждого до шести английских синонимов. Результат сразу помещается в поле ключевых слов в формате, описанном на шаге 1.
-
Предварительный отбор. Помощник анализирует аннотации пакетами по 10 и рекомендует один из вариантов — «подходит», «под вопросом» или «не подходит» — с объяснением. Рекомендация не меняет решение об отборе, пока вы сами её не примете.
-
Перевод названия и аннотации на язык интерфейса.
-
Создание таблицы статей для Excel. Помощник читает текст загруженных PDF или аннотации, если полных текстов нет, и заполняет столбцы. По умолчанию указываются объект, метод, условия и основные результаты; состав столбцов можно изменить.
-
Подготовка плана обзора: помощник предлагает 4–8 разделов, распределяет по ним отобранные публикации и отмечает пробелы в литературе. Это черновой план, а не готовый обзор.
Сервису передаются тема, названия и аннотации статей, а при создании таблицы — также текст PDF без списка литературы.
Как всё устроено
Несколько технических подробностей для тех, кому интересно устройство программы:
-
Python 3.13 входит в комплект: для Windows используется официальная сборка CPython из NuGet, для Mac — сборки python-build-standalone под Apple silicon и Intel. Дополнительная установка не требуется: достаточно распаковать архив в любую папку.
-
Интерфейс программы представляет собой HTML-страницу. Её предоставляет локальный сервер на 127.0.0.1, а каждый запрос проверяется по токену. Страница открывается в Edge в режиме приложения.
-
Ключи API хранятся в профиле пользователя Windows. В интерфейсе отображаются только последние четыре символа, в журналы ключи не записываются.
-
Каждое изменение проходит сборку и проверку в GitHub Actions на Windows и macOS: проверяются распаковка, запуск, тесты, автообновление и браузер. Контрольная сумма архива SHA-256 опубликована на странице релиза.
Ограничения
-
Поддерживаются Windows 10 и 11. Версия для Mac находится в бета-стадии: она автоматически собирается и проверяется, однако отзывов реальных пользователей пока немного. При первом запуске на Mac потребуется выбрать «Всё равно открыть» в настройках безопасности, поскольку у программы нет подписи Apple.
-
У программы нет цифровой подписи, поэтому при первом запуске Windows SmartScreen предупредит о неизвестном издателе. Исходный код доступен на GitHub, а целостность архива можно проверить по контрольной сумме.
-
Скачать можно только полные тексты, доступные по подписке вашей организации. Для работы со Scopus API также необходим организационный доступ.
-
Аннотации доступны не для всех публикаций; об ограничениях для Elsevier рассказано выше.
-
ИИ может ошибаться как при подборе синонимов, так и при предварительном отборе, поэтому окончательное решение остаётся за вами.
-
Лицензия разрешает бесплатно пользоваться программой, делиться официальным архивом и изменять программу для собственных нужд. Продавать её или распространять изменённые версии без разрешения автора нельзя. Таким образом, код открыт для просмотра, но не является open source в строгом смысле.
Попробовать
Скачать программу: https://github.com/solzeworot‑commits/article‑downloader. Архив для Windows занимает около 55 МБ, для Mac — около 140 МБ; инструкция размещена на странице релиза. Задать вопрос или сообщить об ошибке можно в чате Telegram https://t.me/ArticleDownloaderChat или через Issues на GitHub.
Буду рад узнать в комментариях, какие этапы подготовки обзора литературы отнимают у вас больше всего времени и каких баз данных или издательств вам не хватает.
Похожие статьи
 ИИ лишит человечество работы? Или мы опять что-то упустили? Часть 2
 Учёные предупредили о необратимом ущербе криосфере при потеплении свыше 1,5 °C
 Камерофоны взяли верх: почему моя зеркалка пылится на полке
 Клеточный автомат на микросхемах малой интеграции. Часть 1 — Изобретая велосипед
 Не ИИ обесценил сеньоров — это сделали ваши собеседования
 Симуляция показала, что жизнь не так уж сильно повлияла на развитие Земли
 Учёные выяснили причину минутных пульсаций энергосетей по всему миру
 Как дискуссия о безопасности ИИ переросла в спор об открытом исходном коде