Клодизмы. Часть 2. Зачем нужен тезис и как получить от нейросети ясный текст
В первой части я рассмотрел клодизмы — характерные ошибки, возникающие у Claude при создании связного текста, — и выделил десять их классов по механизму происхождения. Вторая часть посвящена тезису: главной мысли, которую текст должен передать читателю. Без неё клодизмы расползаются по тексту как тараканы, а простая замена неудачных слов не спасает. Когда тезис сформулирован, модель может соотносить с ним каждое предложение — как при написании, так и при редактировании.
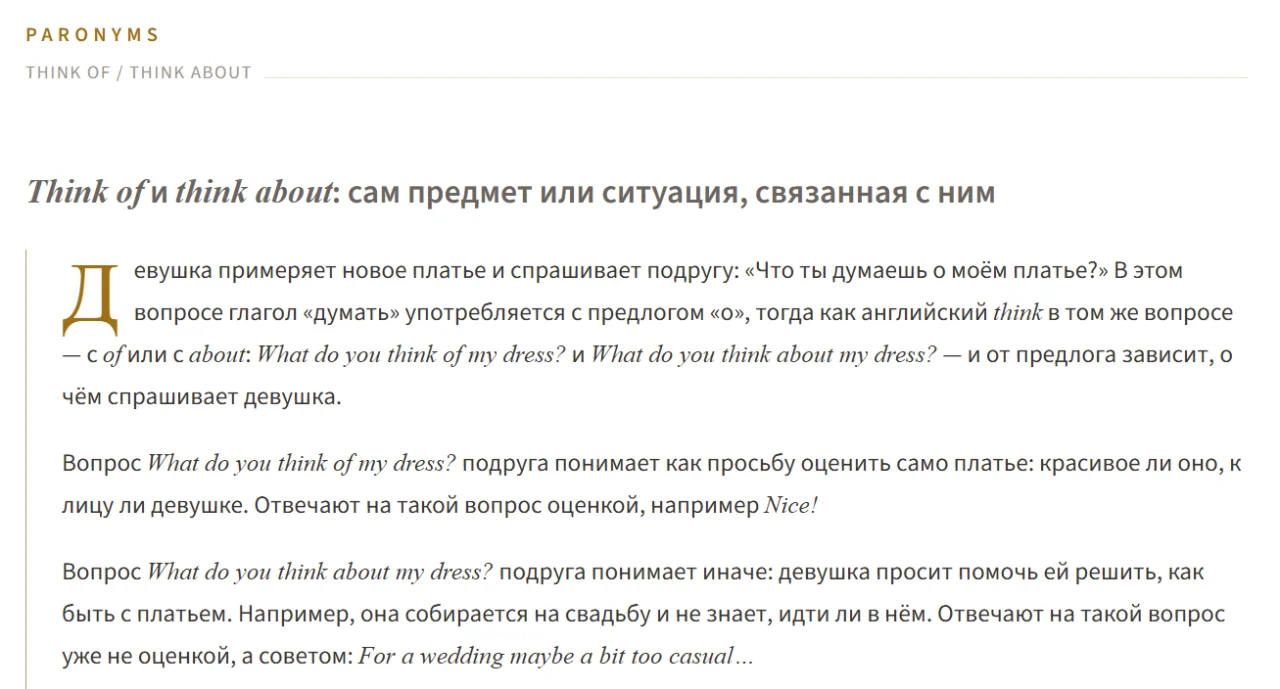
Для разбора я взял первый вариант преамбулы к упражнению «Think of / think about» на сайте e-repa.ru. Преамбулой я называю вводное объяснение, которое ученик читает перед выполнением заданий.
Почему без тезиса получается усреднённый текст
Роль тезиса становится заметной, если сопоставить ответ модели на конкретный вопрос с текстом по заданию «напиши про…». Для языковой модели запрос служит началом текста, а ответ — его наиболее вероятным продолжением. Она продолжает запрос по образцу похожих начал, встречавшихся в обучающих данных.
После вопроса «Что такое X?» или «Чем X отличается от Y?» обычно следует ответ определённого типа: определение либо объяснение различия. Сам вопрос задаёт главную мысль: ответ должен раскрыть именно то, о чём спрашивают. Поэтому ответ в чате, как правило, получается связным, а при наличии точных сведений в обучающих данных — ещё и точным.
После команды «Напиши про X» может появиться любой текст с упоминанием X: статья, эссе, публикация, обзор или учебный материал. Задание не определяет главную мысль, поэтому модель выдаёт усреднённую версию таких текстов — то, что чаще всего говорится об X. У каждого исходного текста была собственная мысль, но при усреднении она исчезает.
Это похоже на разговор с прохожим. Если спросить: «Как пройти к вокзалу?», он назовёт маршрут, и его ответ будет подчинён вопросу. Если же попросить: «Расскажите о городе», можно услышать то, что говорят о множестве городов: старый центр, набережная, летом здесь красиво. Такие общие замечания подошли бы сотне разных мест.
Тем, кто работал с диффузионными моделями, эта разница знакома по генерации изображений. Модель создаёт картинку по текстовому описанию — промпту. На просьбу «нарисуй котика» она выдаёт усреднённого котика из чекпоинта, то есть сохранённого состояния обученной модели. Если же указать породу, окрас, позу, освещение и ракурс, шансов получить нужное изображение гораздо больше. Для языковой модели задание «Напиши преамбулу к упражнению на think of и think about» подобно просьбе нарисовать котика, а тезис играет роль породы, позы и освещения.
Как выглядела преамбула без тезиса
Первую преамбулу модель написала по заданию, в котором были указаны только тема и стиль: подготовить вводный текст в стиле инструкции для телеграм-постов и разобрать пару What do you think of my dress? и What do you think about my dress?. Тезиса в задании не было, и модель опиралась на форму. Из указания о стиле она извлекла композиционный шаблон — сценка, минимальная пара, нарастание, вывод, абзац с термином — и распределила материал по его частям. Каждый абзац занимал отведённое ему место, но не развивал предыдущий, поэтому связи между ними не возникло. При этом лингвистическое обоснование у модели имелось: в том же диалоге автор разобрал различие предлогов, и задания к упражнению модель строила на основе этого разбора. Но опираться на него при написании преамбулы ей не поручили, и она последовала шаблону.
Абзацы преамбулы существовали обособленно. Сначала приводилась пара вопросов о платье, отличавшихся только предлогом. Затем появлялся второй пример, не связанный с первым. После него следовала этимология about, хотя читателю было непонятно, зачем она нужна: вопрос о том, почему именно about передаёт ситуацию, связанную с предметом, в тексте не ставился.
Одно и то же понятие в разных абзацах называлось по-разному. Ситуация, связанная с предметом, превращалась то в «утрату», то во «взвешивание» — всего для неё нашлось пять обозначений. Читатель не мог понять, речь идёт об одном понятии или о пяти.
Хуже того, одно предложение сводило на нет различие, ради которого и была написана преамбула. В нём утверждалось, что во многих предложениях подходят оба предлога и выбор показывает лишь то, что для говорящего важнее. А тремя предложениями ниже ученику предлагалось определить смысл по контексту. Если первое утверждение верно, выполнить такое задание невозможно.
Каждый из этих фрагментов отражал распространённые рассуждения о предлогах. Но проверить их модели было не по чему: у текста не существовало главной мысли, которой подчинялись бы все абзацы.
Почему заменой слов проблему не решить
Обычный способ править текст модели — указать на неудачное слово и попросить подобрать другое. С первым вариантом преамбулы это не помогло. В одном абзаце описывалось условие, при котором допустимы оба предлога, и по моим замечаниям модель трижды переписывала одно и то же место. Сначала условие звучало так: «Если контекст допускает оба понимания». Что именно понимается двумя способами, не уточнялось, а способность понимать приписывалась контексту, хотя понимает человек. Затем модель предложила: «Если по контексту нельзя определить, о чём думает говорящий». Так английское think объяснялось через русское «думать о» — то есть через ту самую трудность, которую преамбула должна была разобрать. Лишь в третьем варианте появилось «что имеет в виду говорящий» — формулировка, на которой держится тезис.
Каждый раз модель выбирала первое подходящее по смыслу выражение, но оно снова уводило текст от нужной мысли. К этой мысли её возвращал я; самой модели было не с чем сверять поправки, поскольку тезис нигде не был сформулирован. Поэтому правку такого текста нужно начинать не с неудачного слова, а с тезиса.
Как тезис стал смысловой рамкой и преодолел корпусный перехват
Лингвистическое обоснование было доступно модели ещё при написании первой преамбулы. Однако оно находилось в контексте наравне с прочей информацией, и модель не проверяла по нему свои предложения. Смысловой рамкой — основой для построения каждого предложения — тезис стал лишь после того, как его явно записали и начали переписывать преамбулу с опорой на его формулировки: «говорящий имеет в виду», «сам предмет», «ситуация, связанная с предметом». Неудачные места больше не латали заменой отдельных слов, а переписывали так, чтобы они развивали тезис.
Особенно важной рамка оказалась там, где модель обращалась к привычным корпусным формулировкам. Разбирая задания упражнения, она объявила обороты come to think of it и didn’t think much of this film исключениями. Вместо анализа модель назвала их «устойчивым сочетанием» и «лексикализованным значением», а два задания сочла неестественными, полагаясь на чутьё. Это и есть корпусный перехват: там, где требуется разбор, модель ставит привычный для подобных случаев ярлык, который подменяет собой объяснение.
Я преодолел перехват, предложив модели двигаться в обратном направлении: не от оборота к ярлыку, а от предлога к значению существительного. Нагляднее всего это видно на вводной паре преамбулы. В вопросе What do you think of my dress? «платье» означает сам предмет: девушка просит подругу оценить платье. В вопросе What do you think about my dress? под «платьем» подразумевается связанная с ним ситуация: стоит ли идти в нём на свадьбу. С of существительное используется в прямом значении, с about — метонимически: предметом названа ситуация вокруг него. После этого ярлыки «устойчивое сочетание» и «лексикализованное значение» модели не понадобились: каждое употребление объяснялось через значение существительного после предлога.
Тезис стал также критерием отбора примеров. Придуманную пару из первой версии модель заменила примерами из живой речи, разыскивая их по заданному признаку: одно существительное с обоими предлогами. Так нашлась статья психолога о расставании, в которой рядом встречаются It’s okay to think of him sometimes и constantly thinking about him. В первом случае him обозначает самого человека, которого иногда вспоминают. Во втором — всё, что с ним связано: отношения, расставание, прошлое и несбывшиеся возможности. Этот разбор вместе с примерами внесли в базу знаний по think of / think about, чтобы при следующей работе над темой модель начинала с них, а не с корпуса.
Вывод: модель должна стать соавтором тезиса
Разбор одной преамбулы позволяет сделать следующий вывод: клодизмы пяти классов почти не возникают, когда модель последовательно опирается на лингвистически корректный тезис. Например: of — маркер прямого значения, about — переносного, метонимического. При этом важно, каким путём модель пришла к тезису. Он не был навязан пользовательским промптом: модель сформулировала выводы сама в ходе логического рассуждения.
Когда промпт жёстко предписывает тезис и запрещает от него отступать, модель сопротивляется всему, что не совпадает с содержанием её корпуса. Тезис, противоречащий корпусу, она размывает или заменяет привычной корпусной формулировкой. Клодизмы появляются вновь: формально тезис в промпте присутствует, но модель с ним не сверяется.
Речь идёт о следующих классах:
-
частотная подстановка: вместо первого близкого по смыслу слова модель использует на месте забракованного выражения термин из тезиса;
-
псевдообъяснение: вместо корпусных ярлыков «устойчивое сочетание» и «лексикализованное значение» модель определяет по предлогу, что обозначает существительное;
-
нарушение тема-рематической прогрессии: каждый абзац развивает тезис, а не просто занимает место в шаблоне;
-
вторичная ошибка правки: одно понятие на протяжении всего текста обозначается теми же словами, что и в тезисе, а не пятью разными способами;
-
конфабуляция: модель не сочиняет примеры под правило, а ищет их в живой речи, руководствуясь тезисом.
Главное условие — диалог пользователя с моделью, в котором она сама убеждается в тезисе и становится его соавтором. Если тезис лишь передан в промпте, он остаётся для модели одним из текстов контекста, и корпус оказывается сильнее. Если же модель пришла к нему сама, он становится смысловой рамкой для построения каждого предложения.
Как построить диалог, чтобы модель стала соавтором тезиса
Лингвистическое обоснование я готовлю заранее, но оставляю его для себя. Модели я предлагаю не готовый тезис, а материал и вопросы, добиваясь того, чтобы она вывела тезис самостоятельно. Порядок работы следующий:
-
Материал вместо тезиса. Модель получает пару, в которой одно существительное употребляется с обоими предлогами, например What do you think of my dress? и What do you think about my dress?, а также вопрос: что обозначает существительное после of и что — после about?
-
Возврат к анализу. Если модель прибегает к корпусным ярлыкам — «устойчивое сочетание», «лексикализованное значение», — я не предлагаю готовый ответ, а возвращаю её к анализу: от предлога к тому, что обозначает существительное. Именно так модель перестала считать исключениями обороты, которые первоначально назвала устойчивыми.
-
Формулировка модели. Модель записывает тезис своими словами, а я сопоставляю его со своим обоснованием. Если они расходятся, разбор продолжается на новом материале до тех пор, пока расхождение не исчезнет.
-
Закрепление. Согласованный тезис, разбор и найденные примеры заносятся в тематическую базу знаний. Дальше модель пишет текст в рамках этого тезиса, и правка строится на той же основе.
Так тезис перестаёт быть для модели чужой формулировкой в контексте: она сама к нему пришла и сверяет с ним каждое предложение. О классах клодизмов, заметных на уровне слова и фразы, пойдёт речь в третьей части.
Похожие статьи
 Зачем учёным использовать большие языковые модели
 Клодизмы. Часть 1: классификация ошибок языковой модели в связном тексте
 Выведение масс кварков и лептонов: развитие подхода Койде
 «Сбер» вновь у отметки 300: в чём суть новой стратегии и доверяют ли ей инвесторы
 Учёные предположили, что Вселенная может быть в два раза старше прежних оценок
 Почему большинство кошек не любят прикосновения к животу, лапам и хвосту?
 Кубик Рубика возвращается на родину: его производство возобновят в Венгрии
 Сборка генома из ридов на пангеномном графе с помощью открытого ПО