Как устроены современные ИИ-сервисы изнутри: KV-кэш, батчинг, квантизация и «железо»
Итак, вы отправляете запрос через веб-интерфейс или приложение. В этот миг зарождается его путь к развернутому и релевантному ответу. На этом маршруте сообщение последовательно преодолевает множество изолированных контуров, каждый из которых решает узкоспециализированную задачу. Давайте детально изучим этот механизм.
Всем привет! На связи Сергей Ковалёв, продакт-менеджер направления Выделенные серверы в Selectel. Сегодня мы препарируем аппаратную и программную архитектуру ИИ-платформ, которыми ежедневно пользуются маркетологи, саппорт, эйчары и эксперты из самых разных сфер. Поговорим о том, почему современный искусственный интеллект — это не просто передовая LLM, автономный агент и мощные GPU с колоссальным объемом VRAM, но и интеллектуальные балансировщики, API-шлюзы, NGINX, высокоскоростные интерконнекты вроде NVLink и масса сопутствующих инфраструктурных элементов. Все технические подробности ждут вас далее.
Точки входа в ИИ-экосистему
Вы вводите текст в поле ввода и нажимаете клавишу ввода — в этот момент запускается каскад проверок. Прежде чем ваш запрос попадет в поле зрения нейросети, ему предстоит пройти строгий барьер валидации.
Первым рубежом обороны выступает API Gateway. Он считывает метаданные и служебные заголовки: вашу цифровую подпись, валидность токена доступа и контекст отправки. Шлюз за миллисекунды верифицирует ключи аутентификации, проверяет квоты на исчерпание лимитов, статус учетной записи и корректность выбранной языковой модели. При малейшем несоответствии Gateway отсекает запрос на уровне шлюза, возвращая ошибку клиенту, минуя вычислительный клатер. Таким образом, шлюз выполняет роль интеллектуального фильтра.
Подобный фильтр критически важен с точки зрения экономики инфраструктуры. Обращение к инференсу нейросети сжигает колоссальное количество ресурсов дорогостоящих GPU, поэтому мгновенная отбраковка некорректных или спам-запросов сохраняет вычислительную мощность.
Далее валидный запрос нужно направить к целевой модели. У ведущих игроков рынка экосистем моделей множество, и на этом этапе шлюз сопоставляет ваш выбор с текущей нагрузкой, активируя ручной пресет или режим «Авто». Затем балансировщик трафика вычисляет наименее загруженный кластер серверов, где развернута требуемая модель, и перенаправляет пакет туда. Управление потоками миллионов параллельных запросов требует филигранной балансировки, исключающей образование «узких мест».
С лингвистическими моделями все сложнее, чем с классическими веб-приложениями: время обработки одного запроса может составлять как доли секунды, так и десятки секунд в зависимости от объема генерации. Поэтому стандартные метрики открытых соединений здесь не работают — балансировщик анализирует актуальное число активных генераций и глубину очередей на каждом узле.
Третий ключевой элемент — Rate Limiter (ограничитель частоты запросов). Он пресекает попытки отдельного пользователя монополизировать вычислительные мощности платформы. Держать счетчики локально на каком-то одном сервере бессмысленно — систему легко обмануть, распределяя запросы по разным машинам. Поэтому квоты хранятся в распределенном оперативной памяти хранилище, доступном всем узлам кластера одновременно. Эталонным инструментом для таких задач традиционно выступает Redis.
Лимитирование ведется как по количеству вызовов, так и по токенам. К примеру, экосистема Anthropic оперирует тремя независимыми счетчиками: запросы в минуту (RPM), входящие токены в минуту (ITPM) и исходящие токены в минуту (OTPM). Токенная тарификация отражает реальную нагрузку точнее, ведь массивный текстовый блок требует больше ресурсов, чем короткая реплика. При исчерпании лимита сервер возвращает HTTP-код 429 с указанием тайм-аута до следующей попытки.
На практике API Gateway, балансировщики и Rate Limiter строятся на базе проверенных решений вроде NGINX и Envoy либо кастомизируются силами инженеров компании. Так, корпорация OpenAI активно задействует Envoy в своей сетевой архитектуре. На этом этапе графические ускорители еще не задействованы: вполне хватает классических x86-серверов (например, от вендоров Dell, HPE или Supermicro). Подобное железо для маршрутизации и фильтрации трафика можно арендовать и в Selectel — производительность будет сопоставима с инфраструктурой техногигантов, разница лишь в масштабе кластера. Отличный пример — сервер на базе 16-ядерного процессора AMD EPYC™ 9135 с поддержкой высокоскоростной памяти DDR5 ECC Reg.
Подобная оптимизация сетевого слоя напрямую выгодна конечным потребителям: чем меньше накладных расходов несет провайдер, тем ниже итоговая стоимость конечного цифрового продукта.
Контекст и оперативная память диалога
Балансировщик успешно доставил сообщение до свободного вычислительного узла. Однако сама по себе нейросеть «амнезична» — она не сохраняет состояние предыдущих реплик. Чтобы диалог выглядел непрерывным, задействуется подсистема контекстного менеджмента. Она архивирует историю беседы и с каждым новым сообщением передает модели всю языковую цепочку с нулевой отметки. Благодаря этому модель воспринимает диалог целостно и генерирует релевантный ответ.
Контекстное окно (фактически — «рабочая память» нейросети) — это предельный объем текстовых данных, который модель способна удерживать в фокусе внимания одновременно. Сюда входят пользовательские запросы, сгенерированные ответы, прикрепленные документы и системные промпты. Измеряется этот объем в токенах — минимальных смысловых фрагментах слова, сопоставимых с несколькими символами.
Отсюда вытекает фундаментальное ограничение: чем продолжительнее ваша беседа, тем больше токенов приходится обрабатывать на каждой итерации. Каждый последующий шаг инференса объективно обходится дороже и требует больше времени.
Сама история переписки персистентно хранится в традиционных реляционных базах данных, поверх которых развертываются высокопроизводительные кэш-слои в оперативной памяти для молниеносного доступа. В качестве иллюстрации масштаба можно привести архитектуру хранения Habitat от OpenAI. Цифры поражают воображение: свыше 70 миллионов транзакций в секунду, более миллиарда активных пользователей еженедельно, почти 40 географических регионов и более 500 петабайт данных. При этом объем внутренних обращений к хранилищу многократно превосходит количество пользовательских реплик, ведь одно действие порождает лавину запросов к БД, обеспечивая бесшовный пользовательский опыт.
Инференс в нейронной сети
Миновав шлюз, балансировщик и контекстный слой, запрос наконец поступает в саму языковую модель. И здесь начинается самое технологичное волшебство.
Жизненный цикл любой генеративной модели распадается на две фазы. Первая — обучение (Training): нейросети скармливают гигантские массивы текстов для тонкой настройки внутренних весов. Этот процесс растягивается на месяцы и поглощает астрономические вычислительные ресурсы. Вторая фаза — инференс (Inference), то есть этап непосредственной обработки запросов пользователей.
Концептуально модель можно представить в виде колоссальной математической функции с триллионами настраиваемых коэффициентов (у флагманских решений их число исчисляется астрономическими цифрами). Эти коэффициенты называются параметрами. Они подбираются в процессе обучения так, чтобы при подаче входящего текста формула выдавала максимально вероятное и осмысленное продолжение. «Под капотом» происходят непрерывные матричные умножения, повторяющиеся миллиарды раз.
Алгоритм работы выглядит следующим образом:
-
Текстовая строка токенизируется — разбивается на фрагменты, каждому из которых присваивается уникальный числовой индекс. К примеру, слово «нейросеть» может разложиться на морфемы «нейро» и «сеть».
-
Каждый токен преобразуется в многомерный вектор, математически описывающий его семантическое наполнение. Близкие по смыслу слова оказываются соседями в векторном пространстве: векторы «короля» и «королевы» будут расположены близко друг к другу, в то время как «автомобиль» окажется на значительном удалении.
-
Архитектура должна учитывать порядок слов: поскольку модель обрабатывает всю последовательность токенов параллельно, ей чуждо естественное понимание очередности. Для решения этой проблемы к векторам добавляются позиционные эмбеддинги (числовые маркеры порядкового номера).
-
Включается механизм внимания (Attention). Он вычисляет семантические связи между всеми элементами текста. В предложении «он взял ключи и открыл ими замок» механизм безошибочно сопоставляет местоимение «ими» с ключами. При этом анализ ведется сразу через множество «головокружительных» проекций — голов внимания, где одна отвечает за грамматические конструкции, а другая — за глубокие смысловые взаимосвязи.
-
Промежуточные результаты проходят через слои нормализации и активации, после чего весь цикл циклично повторяется на следующем глубоком слое модели, в финале выбирая наиболее вероятный следующий токен.
Затем процедура повторяется для каждого нового токена по цепочке. Ответ собирается итеративно, из-за чего в интерфейсе чата текст визуально «допечатывается» на глазах пользователя.
Трансформер (Transformer) — это фундаментальная нейросетевая архитектура, в основе которой лежит механизм внимания (attention). Он дает модели возможность при расчете каждого слова одновременно оценивать всю совокупность текстового контекста, вычленяя наиболее значимые для понимания смысла связи.
Всю эту колоссальную вычислительную нагрузку берут на себя GPU — графические ускорители. Архитектура GPU оптимизирована под одновременную работу десятков тысяч компактных вычислительных ядер. В решении последовательных задач они уступают центральным процессорам (CPU), но при параллельном выполнении миллиардов примитивных операций им нет равных. Матричные умножения как раз идеально ложатся на эту парадигму массового параллелизма, столь необходимую ИИ.
Графические чипы монтируются в серверные шасси, а те объединяются в масштабные дата-центры. Для обработки миллионов запросов в режиме реального времени требуются тысячи подобных стоек. Энергетическая и вычислительная эффективность этой связки напрямую определяет себестоимость и скорость работы сервиса.
Аппаратное обеспечение и хранение модели
В процессе инференса веса модели постоянно находятся в видеопамяти графических ускорителей. Флагманская модель с триллионом параметров требует от 0,5 до 2 терабайт VRAM. Точный объем зависит от формата хранения коэффициентов и степени их компрессии (квантования). Для понимания масштаба: объем RAM типичного домашнего ПК редко превышает 128 ГБ, а смартфона — 12 ГБ.
Какой объем терабайт способен уместить один передовой сервер? Как правило, устройства этого класса несут на борту восемь GPU. Например, в серверных узлах на базе NVIDIA® B300™ каждый чип располагает 288 ГБ памяти, что в сумме дает впечатляющие 2,3 ТБ VRAM. На рынке стоимость такого сервера сегодня исчисляется десятками миллионов рублей, а его пиковое энергопотребление достигает 18 кВт.
Следующий технологический уровень — серверная стойка, спроектированная как единый гиперкомпьютер. В архитектуре NVIDIA® GB300 NVL72™ объединены 72 графических и 36 центральных процессоров: суммарный объем видеопамяти в такой стойке достигает 20 ТБ, а энергопотребление приближается к 140 кВт. Стоимость подобного комплекса примерно на порядок превышает цену одиночного сервера B300™.
Внутри систем класса NVL72 чипы объединены проприетарной шиной NVLink с пропускной способностью до 130 ТБ/с. Между собой стойки связываются специализированной сетью InfiniBand, обеспечивающей скорость до 800 Гбит/с на каждый GPU. Стандартные дата-центровые сети здесь неэффективны: поскольку массивные модели распределены по множеству графических чипов, узлы вынуждены обмениваться промежуточными тензорами на каждой микроитерации вычислений.
Оставшаяся после загрузки модели видеопамять не простаивает — она выделяется под хранение промежуточных состояний (KV-каша) для всех параллельных сессий пользователей, обрабатываемых данной копией модели. Разумеется, одной копии недостаточно для обслуживания миллионов клиентов. Модель реплицируется на сотни серверов и стоек, функционирующих автономно, а балансировщик первого уровня распределяет входящий трафик между ними.
Физически эти комплексы размещаются в дата-центрах — гигантских промышленных объектах с рядами стоек, километрами оптоволокна, промышленными чиллерами, системами бесперебойного питания, дизель-генераторами и автоматическими установками пожаротушения. Отдельного упоминания заслуживает терморегуляция. Тепловыделение ИИ-серверов столь велико, что стандартного воздушного охлаждения уже недостаточно — операторы переходят на системы жидкостного охлаждения (СЖО) и иммерсионные ванны, где серверы погружаются в диэлектрическую жидкость.
Инфраструктура под обучение и под инференс проектируется по совершенно разным принципам. Для обучения критически важен гигантский кластер тесно связанных серверов, в то время как инференс можно успешно масштабировать на разрозненных парках GPU-серверов.
Специфика процесса обучения модели:
-
Единая монолитная модель удерживает все вычислительные узлы занятыми неделями и месяцами;
-
Решающее значение имеет суммарная вычислительная мощность и задержки в межчиповых интерконнектах;
-
При аппаратном сбое процесс останавливается и откатывается к последней контрольной точке (checkpoint);
-
Характерна ровная, круглосуточная утилизация мощностей без резких скачков.
Особенности инференс-нагрузки:
-
Миллионы коротких, стохастических и независимых запросов;
-
Ключевыми метриками выступают задержка ответа (Time-to-First-Token) и экономика токена;
-
При сбое узла транзакции бесшовно перенаправляются на резервные реплики;
-
Нагрузка имеет выраженные суточные пики, требующие гибкого лимитирования.
Инвестиции в аппаратную базу поражают воображение. Так, в 2025 году OpenAI развернули суперкомпьютерный кластер GB300 на базе 64 стоек NVIDIA® GB300 NVL72™, задействующий свыше 4 600 графических ускорителей.
А в мае 2026 года компания Anthropic заключила соглашение об аренде дата-центра Colossus 1 у SpaceX, объединяющего более 220 тысяч чипов NVIDIA.
Четкой границы между железом для обучения и инференса пока нет — архитектуры GPU универсальны. Однако производители уже анонсируют специализированные линейки чипов, строго заточенные под конкретные задачи.
Кэширование и методы оптимизации
Очевидно, что эксплуатация языковых моделей — баснословно дорогое удовольствие. Поэтому инженеры изобрели изощренные алгоритмические оптимизации, исключающие избыточные вычисления.
Яркий пример — KV-кэш. Когда модель генерирует ответ токен за токеном, ей приходится учитывать всю предысторию диалога. Для каждого обработанного токена механизм внимания рассчитывает служебные матрицы ключей и значений (Key и Value). Чтобы не пересчитывать эти тензоры заново на каждом шаге, модель кэширует их в VRAM, дописывая лишь новые элементы. Платой за прирост скорости становится потребление памяти: чем длиннее диалог, тем больше объем кэша. Это главная причина жестких лимитов контекстных окон и удорожания длинных сессий.
KV-кэш — это специализированное хранилище промежуточных матриц внимания (ключей и значений) для ранее обработанных токенов. Оно выполняет роль быстрой оперативной памяти контекста.
Еще один мощный инструмент экономии — батчинг. Суть метода в том, чтобы объединять запросы от разных пользователей в единые пакеты (батчи) и обрабатывать их параллельно. GPU демонстрирует максимальную утилизацию вычислительных блоков именно на больших объемах данных.
Батчинг (Batching) — это процесс агрегации независимых пользовательских запросов в единый пакет, проходящий через модель за один проход. Веса нейросети загружаются из VRAM единожды и применяются сразу ко всем элементам пакета. Это кратно повышает эффективность утилизации ядер и снижает себестоимость обработки токена. Обратная сторона медали — микрозадержка отправки, пока формируется батч.
Третий эффективный трюк — квантование (Quantization). Этот метод снижает прецизионность хранения весов модели. Изначально параметры кодируются числами с высокой точностью (например, 16 бит), занимающими много памяти. При квантовании их округляют до меньшей разрядности — 8 или даже 4 бит. Модель сжимается в разы, начинает работать быстрее, но это может незначительно сказываться на точности ответов. Аналогией служит уменьшение разрешения фотографии: файл весит меньше, а визуальные потери минимальны. Квантование позволяет развернуть более мощную модель на имеющемся «железе», экономя дорогие ресурсы GPU.
Именно из-за квантования вес идентичной по структуре модели может варьироваться от 0,5 до 2 ТБ: триллион параметров в 4-битном формате займет около 0,5 ТБ, а в 16-битном — уже все 2 ТБ.
Квантование — это процедура снижения разрядности математической точности параметров модели. Модель начинает занимать в разы меньше памяти и демонстрирует высокую скорость работы, однако платой становится микропотеря качества генерации, пропорциональная степени сжатия.
Сочетание батчинга и квантования позволяет облачным провайдерам кратно повышать эффективность инфраструктуры.

ИИ‑роутер — доступ к 400+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Мониторинг, отказоустойчивость и SRE
Состояние ИИ-сервисов круглосуточно контролируют автоматизированные комплексы телеметрии и дежурные инженеры. Они отслеживают латентность (Time-to-First-Token), уровень ошибок, пропускную способность сетевых интерконнектов и статус каждого отдельного GPU. При деградации параметров какого-либо узла оркестратор автоматически выводит его из пула обслуживания. В кластерах OpenAI, например, сбойный узел изолируется от новых задач в автоматическом режиме. Это и есть подлинная отказоустойчивость. Золотым стандартом облачной индустрии считается доступность на уровне «четырех девяток» (99,99%), что допускает суммарный простой не более 52 минут за год.
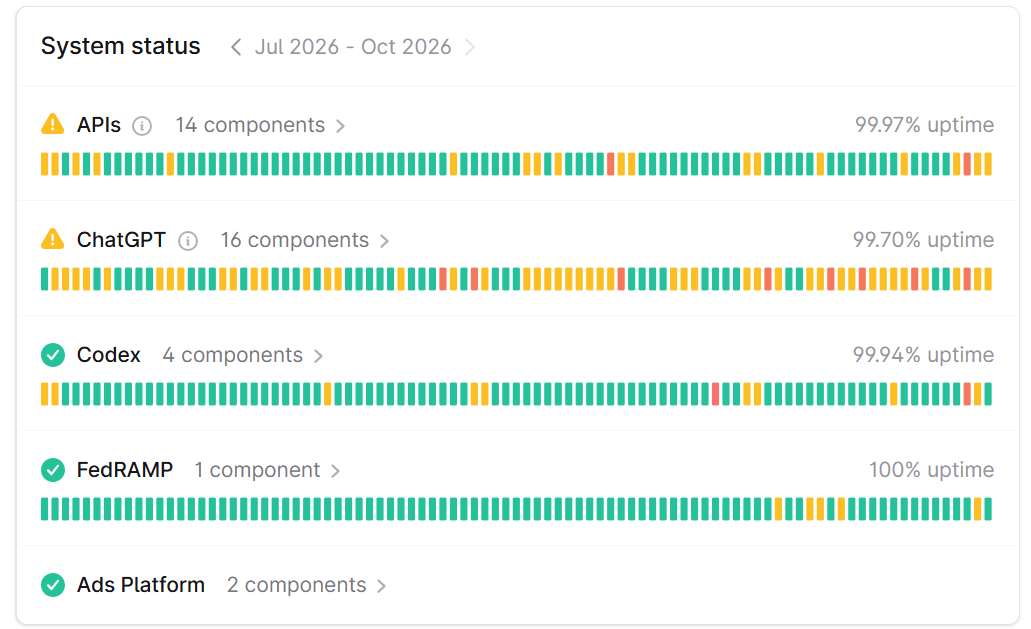
Генеративные ИИ-платформы пока не дотягивают до этой планки. Официальный статус-трекер OpenAI зафиксировал доступность ChatGPT на уровне 99,70% (для API показатель выше — 99,97%). А у Claude 29 сентября 2026 года произошел сбой длительностью 59 минут — один этот инцидент исчерпал годовой лимит простоя для концепции четырех девяток.
Мы имеем дело с молодыми, взрывными продуктами, которые удваивают масштабы ежегодно и функционируют на пределе возможностей сложнейшего железа. Архитектура изначально проектируется с допущением, что какой-то компонент выходит из строя прямо сейчас: мультирегиональное резервирование, множество реплик моделей и мгновенный failover-переход. Именно такой подход позволяет делать сервисы стабильными, минимизируя для конечного пользователя любые задержки.
Заключение
За каждой лаконичной строкой в окне чата скрывается многоуровневая инженерная экосистема из шести ключевых контуров: шлюз валидации, персистентное хранение контекста, нейросетевое ядро, реплицированные кластеры серверов, алгоритмы оптимизации и системы непрерывного мониторинга. Фундаментом этой пирамиды выступает аппаратное обеспечение. Именно от него зависит то, с чем мы сталкиваемся ежедневно: скорость отклика, лимиты сессий и общая доступность сервиса.
Похожие статьи
 Показаны живые фото центральной ступени лунной ракеты Artemis III
 Землю накроет магнитная буря
 В Китае зафиксирован заметный рост цен на трёхлетние iPhone 15 Pro Max
 Как сделать из Xiaomi iPhone: на Redmi K90 Pro Max запустили iOS 17
 iQOO выпустила безопасные пауэрбанки на 20 000 мА·ч со встроенным кабелем и экраном
 Представлен iQOO Neo 12 за $630: Snapdragon 8 Elite Gen 5 без перегрева, батарея 9000 мАч и камера Sony
 Сроки затопления МКС могут сдвинуть на 2032 год
 Необычная Arctic Fox Super Mouse получила экран почти размером с первый iPhone